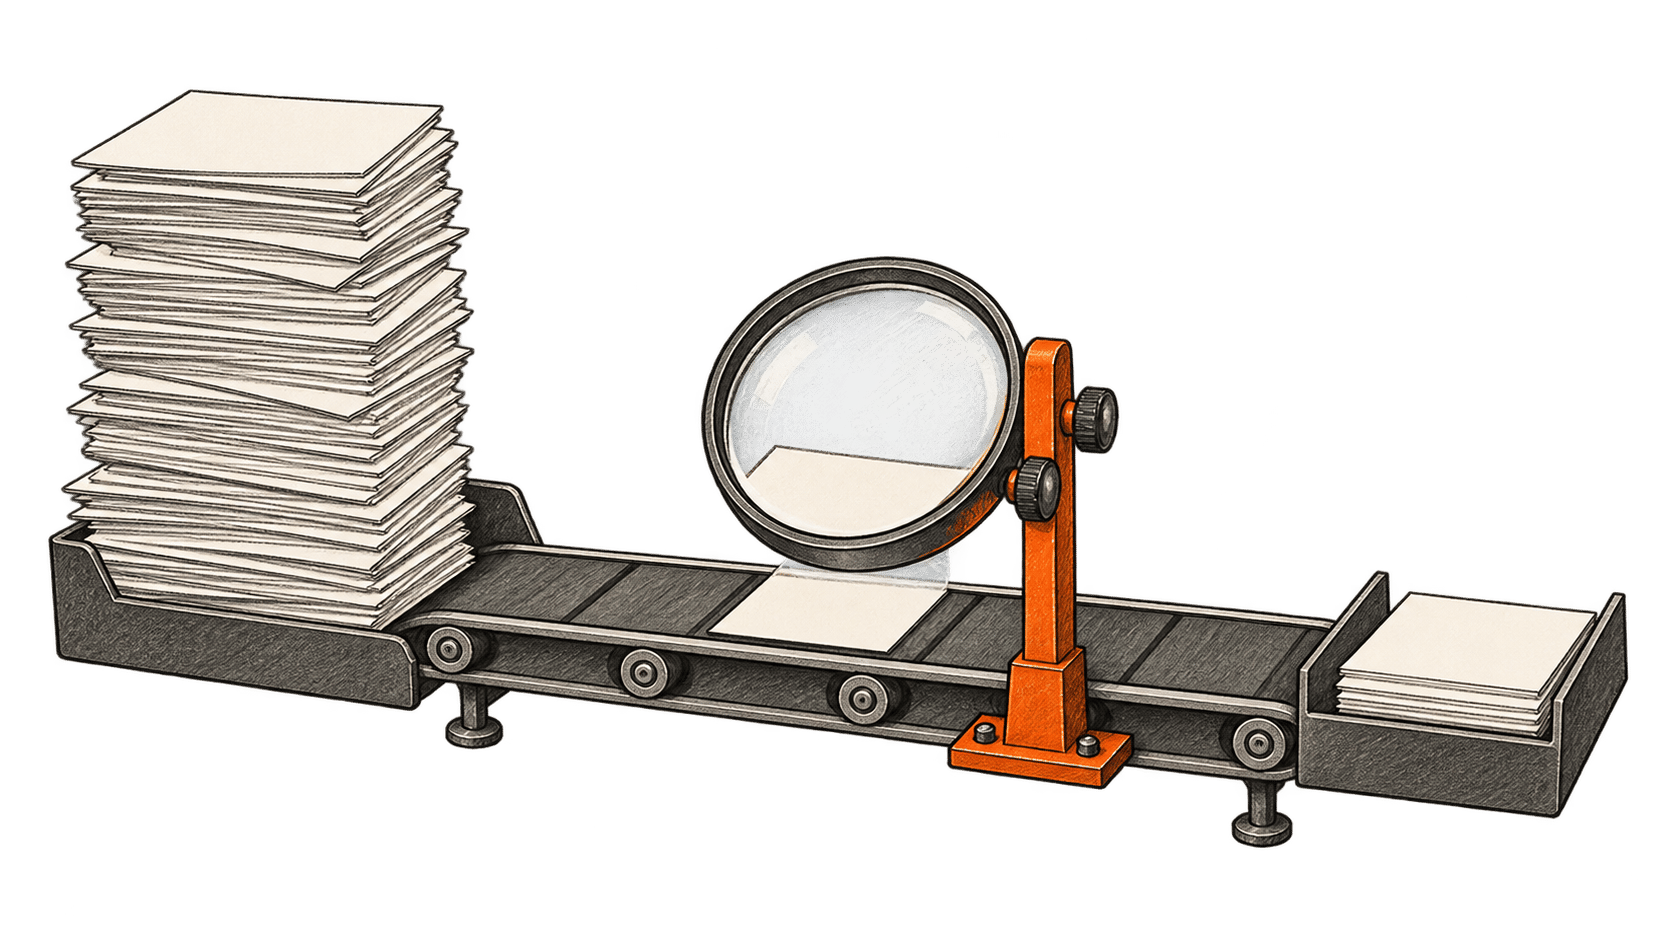
قد ينهي وكيل برمجة بالذكاء الاصطناعي تصحيحًا بينما لا تزال الفحوص الخاصة بالتصحيح السابق جارية. وهذا يخلق تمييزًا محرجًا للمدير الهندسي: أنتج الفريق شيفرات أكثر، لكن العميل لم يتلق شيئًا بعد.
وتقدم Linear حالة مفيدة. ففي رواية هندسية نُشرت في 21 سبتمبر، أفاد مفّيز أمجد بأن مجموعات الاختبار تضاعفت أربع مرات تقريبًا منذ بداية 2026، بينما انخفض انتظار طلبات السحب في التكامل المستمر من أكثر من ست دقائق إلى ما يزيد قليلًا على خمس. كما انخفض وقت المشغّل لكل اختبار إلى النصف تقريبًا. وهذه تحسينات منفصلة؛ فالرقم الأخير لا يعني أن فاتورة CI الإجمالية انخفضت إلى النصف. وتعزو Linear ازدياد الضغط على التحقق إلى التطوير بمساعدة الوكلاء، لكن روايتها ليست تجربة مضبوطة تثبت أثر الذكاء الاصطناعي في الإنتاجية. الرواية الهندسية لـLinear.
يشغّل التكامل المستمر، أو CI، فحوصًا آلية على تغييرات برمجية مقترحة. ويقع بين تصحيح يبدو معقولًا وتغيير يستعد الفريق لقبوله. وحين يزيد الذكاء الاصطناعي إنتاج التصحيحات، تصبح سعة الفحص مسألة أعمال: ما مقدار العمل المفيد الذي تستطيع المؤسسة استيعابه بأمان؟
نرى أن على المديرين إظهار ثلاث نتائج معًا: زمن الحصول على ملاحظات موثوقة، وإجمالي العمل الحاسوبي، وموثوقية التغييرات المنشورة. فالإجابة الأسرع لا تفيد إلا إذا فهم الفريق ما الذي تثبته.
قد يتطلب الانتظار الأقصر عملًا أكثر
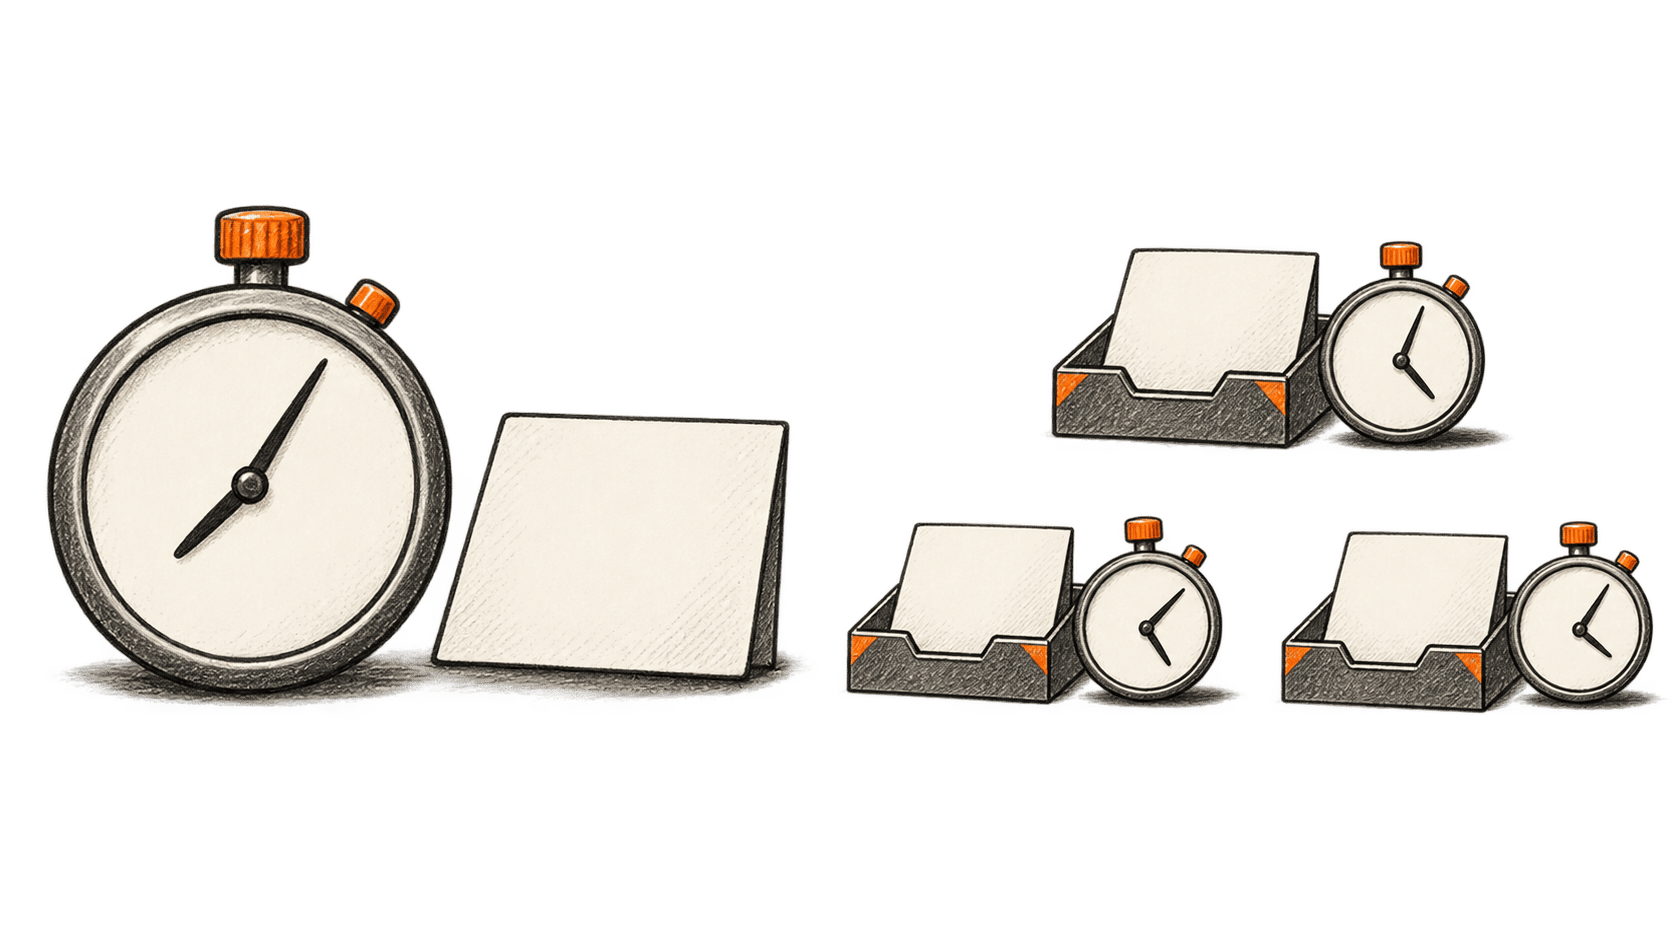
تخيل مجموعة اختبارات تتطلب اثنتي عشرة دقيقة من العمل على جهاز واحد. قد يؤدي تقسيمها بالتساوي بين أربعة أجهزة إلى إنهائها في ثلاث دقائق. ويفترض المثال الافتراضي توازنًا مثاليًا ويتجاهل كل ما عداه؛ لكن الأجهزة تظل تنفذ اثنتي عشرة دقيقة من العمل إجمالًا.
والآن أضف دقيقة إعداد لكل جهاز. يستغرق الإصدار ذو الأجهزة الأربعة أربع دقائق ويستهلك ست عشرة دقيقة مشغّل، فيما يستغرق الإصدار على جهاز واحد ثلاث عشرة دقيقة ويستهلك ثلاث عشرة دقيقة مشغّل. يتحسن زمن الانتظار كثيرًا فيما يرتفع استهلاك الأجهزة الإجمالي. وتعتمد الرسوم الفعلية أيضًا على أنواع المشغلات والأسعار وقواعد الفوترة.
ويهم هذا التمييز حين تحتفي لوحة المعلومات بشريط أخضر أقصر. فشراء قدرة متوازية هو شراء ملاحظات أبكر، وربما بتكلفة إضافية. وقد تكون هذه مقايضة ممتازة إذا أزالت قيدًا حقيقيًا، لكن تبريرها يصعب حين ينتظر التغيير المكتمل ساعات لمراجع متاح.
وينبغي أن يتجاوز التحليل تشغيل CI واحدًا. فقد يستهلك التصحيح الذي يؤدي إلى تعديلات متكررة وإعادات تشغيل وجولة ثانية من المراجعة عملًا أكبر بكثير مما يوحي به أسرع تشغيل منفرد. احسب المحاولات اللازمة لقبول التغيير، بما فيها المحاولات المتروكة، وإلا فقد يخفي مسار يبدو فعالًا عملية تطوير مكلفة.
كما أن كل دقيقة انتظار لا تعادل تكلفة عمل. فالمطور الذي يبدأ مهمة نافعة أخرى أثناء تشغيل الفحوص لم يخسر بالضرورة تلك الفترة كاملة. لكن المقاطعات المتكررة والعودة إلى عمل غير مكتمل قد تضر. ويتطلب قياس ذلك رصد طريقة عمل الفريق بدل ضرب الدقائق المنقضية في الرواتب.
تقدم الأبحاث صورة مختلطة
يعرض تحليل DORA الصادر في مارس 2026 مجموعتين منفصلتين من الأدلة. فقد ربط بحث 2025 بين زيادة اعتماد الذكاء الاصطناعي وزيادة إنتاجية تسليم البرمجيات، وكذلك زيادة عدم الاستقرار. وعلى نحو منفصل، حلل باحثون 1110 إجابة مفتوحة لمهندسي Google جُمعت في الربع الثالث من 2025. ووصف المهندسون المساعدة في إعداد المسودات ومهام أخرى إلى جانب عبء التحقق. والدراسة النوعية الداخلية ليست مجتمعًا إحصائيًا مماثلًا لعلاقة DORA الأوسع، ولا تثبت أي منهما أن الذكاء الاصطناعي سبب مشكلات إصدار فريق بعينه. تحليل DORA ومنهجيته.
وتوجد أدلة تجريبية أقوى ذات نطاق أضيق. ففي دراسة عشوائية أجرتها METR في يوليو 2025، وُزعت 246 مهمة على 16 مطورًا خبيرًا لمشروعات مفتوحة المصدر يعملون في مستودعات مألوفة. واستغرق الإنجاز وقتًا أطول بنسبة 19% عند السماح بأدوات الذكاء الاصطناعي المتاحة في أوائل 2025، مع أن المشاركين اعتقدوا أن الذكاء الاصطناعي ساعدهم على العمل أسرع. وتتعلق النتيجة بهؤلاء المطورين والمهام والأدوات، ولا تحسم قيمة كل وكيل برمجة متاح اليوم. التجربة الأصلية لـMETR.
وفي فبراير 2026، قالت METR إن متابعتها أفضت إلى تقدير غير موثوق لتأثيرات الإنتاجية الحالية. فقد صار المطورون يرفضون العمل من دون ذكاء اصطناعي أو يختارون المهام التي يقدمونها؛ كما عقدت الوكلاء المتزامنة قياس الوقت. واعتبر الباحثون تسارعًا أكبر أمرًا محتملًا، لكنهم قالوا إن البيانات تقدم دليلًا ضعيفًا فقط على حجمه. وسيكون تكرار رقم التباطؤ القديم من دون هذا التحفظ مضللًا للقراء. متابعة METR.
وتبرر هذه الدراسات للمدير موقفًا عمليًا: احتفظ بالأدوات النافعة، وافحص آثارها، وقاوم تحويل الحماس أو الشك إلى قاعدة عامة للتوظيف. فقد يستفيد الفريق كثيرًا في فئة من العمل ويخسر وقتًا في أخرى. وينبغي لعملية التسليم أن تكشف هذا الفرق.
عالج كل قيد بعلاجه الخاص
قبل شراء قدرة إضافية لـCI، ارسم مسار تغيير واحد من أول تصحيح مقترح إلى الإنتاج. وافصل العمل الجاري عن العمل المنتظر. وحدد الفحص الذي يؤخر القرار فعلًا، والمراجع الذي يلزم انتباهه، وشروط الإصدار التي تظل قائمة بعده.
وغالبًا ما يكفي سجل توقيت بسيط لكشف الاستثمار الخاطئ. فإذا وقع معظم التأخير قبل بدء المراجعة، فلن يحل تقليص ثوانٍ من الاختبارات المشكلة. وإذا كان المراجعون ينتظرون مرارًا فحصًا طويلًا مطلوبًا، فتحسين ذلك الفحص له غرض مباشر. وإذا كانت الإخفاقات تظهر أساسًا بعد النشر، فينبغي للفريق فحص ما يفوته التحقق.
ويوضح تخزين الاعتماديات المؤقت سبب ضرورة قياس تحسين مألوف. توثق GitHub التخزين المؤقت وسيلةً لإعادة استخدام الملفات المكلفة في إنشائها مجددًا على مشغلات نظيفة. لكنها تذكر أيضًا وجوب قدرة المهام على إعادة إنشاء الملفات أو تنزيلها حين يتعذر العثور على نسخة مخزنة. ولذلك ينبغي تقييم سلوك التخزين عند النجاح والإخفاق معًا. وثائق GitHub للتخزين المؤقت للاعتماديات.
والسؤال المفيد للمدير هو مدى قابلية الملاحظات للتنبؤ. فقد يتزامن متوسط ممتاز مع انتظار عرضي طويل بما يكفي لتعطيل الإصدار. تتبع الطرف البطيء من التوزيع، وميز بين إخفاق اختبار وفشل تنزيل أو نفاد المشغلات؛ فلكل منها استجابة مختلفة.
وتمنح الملاحظات الموثوقة والسريعة الأشخاص والوكلاء فرصة أبكر لتصحيح الأخطاء. وقد يفيد تحسين هذه البنية التحتية المشتركة أنواعًا كثيرة من التطوير، بما فيها التغييرات المكتوبة من دون ذكاء اصطناعي. وهذا سبب لتمويلها حتى مع تغير أدوات البرمجة المختارة.
الاختبارات الأسرع ما زالت مطالبة باكتشاف الأخطاء
تغير بعض تحسينات الأداء ظروف تشغيل الاختبار، وهذا يستحق تدقيقًا أكبر من مجرد زيادة سرعة المعالج.
تعزل أداة الاختبار Vitest، المخصصة لـJavaScript وTypeScript، ملفات الاختبار افتراضيًا حتى لا تؤثر حالة ملف في ملف آخر. وتصف وثائقها تعطيلًا انتقائيًا للعزل في الاختبارات المناسبة، مع تحديد حالات مثل حالة الوحدة القابلة للتغيير والمتغيرات العامة المعدلة والتبعيات الأخرى أسبابًا للإبقاء عليه. وبالتالي، قد يغير إعداد يقلل زمن التحضير حدود صحة الاختبار. إرشادات العزل في Vitest.
استخدمت Linear نهج الاشتراك لتشارك الحالة، وأضافت التنظيف وأبقت العزل للملفات التي لم تستطع نقلها بأمان. واعتمد مكسب الأداء على تحديد الاختبارات التي يمكنها مشاركة البيئة بأمان. تنفيذ Linear.
وثمة تحدٍ منفصل حين يكتب الوكيل التغيير واختباراته معًا. تخيل قاعدة خصم تنطبق على الاشتراكات السنوية وحدها؛ فقد ينفذها الوكيل خطأً على الخطط الشهرية أيضًا، ثم يكتب اختبارات تؤكد تفسيره هو. وسيثبت اجتياز تلك الاختبارات التوافق مع الخطأ.
ويحتاج المراجع إلى أدلة تستند إلى مرجع خارج ذلك التنفيذ: المتطلب المتفق عليه وأمثلة السلوك المقصود والحالات التي ينبغي أن تفشل. وقد تفيد مطالبة الوكيل بمزيد من الاختبارات، لكن كبر عددها وحده لا يبين أن سوء فهم المتطلب قد اختُبر. وتتمثل مسؤولية الإنسان هنا في تحديد ما ينبغي للبرنامج فعله وما إذا كانت الأدلة تجيب عن ذلك السؤال.
وتخاطر الفرق التي تكافئ حجم الاختبارات دون فحص ما تثبته بمنح المراجعين مواد أكثر وثقة أقل. وينبغي للمدير إتاحة وقت لهذا الفحص عند إسناد العمل، بدل معاملته تأخيرًا غير مفسر بعد انتهاء الوكيل.
قِس التغيير الذي يصل إلى العملاء
تقدم مقاييس التسليم لدى DORA فحصًا لاحقًا مفيدًا. وتشمل الزمن من اعتماد الشيفرة إلى الإنتاج، وتواتر النشر، والتعافي بعد إخفاق النشر، ونسبة عمليات النشر التي تتطلب تدخلًا فوريًا، ونسبة ما يمثل إعادة عمل غير مخططة مرتبطة بحادث. وهذه تصف نتائج التسليم التي تتجاوز اجتياز الاختبار. تعريفات مقاييس DORA.
وبالنسبة إلى فريق يحقق في سير عمل البرمجة بالذكاء الاصطناعي، نقرن هذه النتائج بسجل تشخيصي موجز:
- الملاحظات: الزمن المنقضي حتى الفحوص المطلوبة، بما فيها التشغيلات البطيئة وانتظار السعة.
- الاستهلاك: إجمالي عمل المشغلات والمحاولات المتكررة المرتبطة بتغيير مقبول.
- المراجعة: زمن انتظار الانتباه والتعديلات الجوهرية المطلوبة وسبب كل تعديل.
- أثر العميل: هل قدم التغيير المنشور السلوك المقصود وهل احتاج إلى عمل تصحيحي.
استخدم السجل لفحص سير عمل بعينه. فلا ينبغي التعامل مع تعديل صغير للوثائق وترحيل قاعدة بيانات كوحدتين متطابقتين للإنتاجية. وقارن، حيث أمكن، أعمالًا متشابهة بمرور الوقت وسجل التغييرات الأخرى، مثل مزوّد مشغلات جديد أو عملية إصدار منقحة. ولا يثبت التحسن المتزامن مع اعتماد الذكاء الاصطناعي أنه سببه.
ويستطيع المديرون عندها اتخاذ قرار ملموس: تمويل القيد الذي يمنع وصول تغييرات نافعة إلى العملاء بثقة كافية. وقد يعني ذلك أحيانًا قدرة حاسوبية أكبر، وأحيانًا متطلبات أوضح أو اختبارات أفضل أو وقت مراجعة كافيًا لفهم المقترحات الواردة بالفعل.