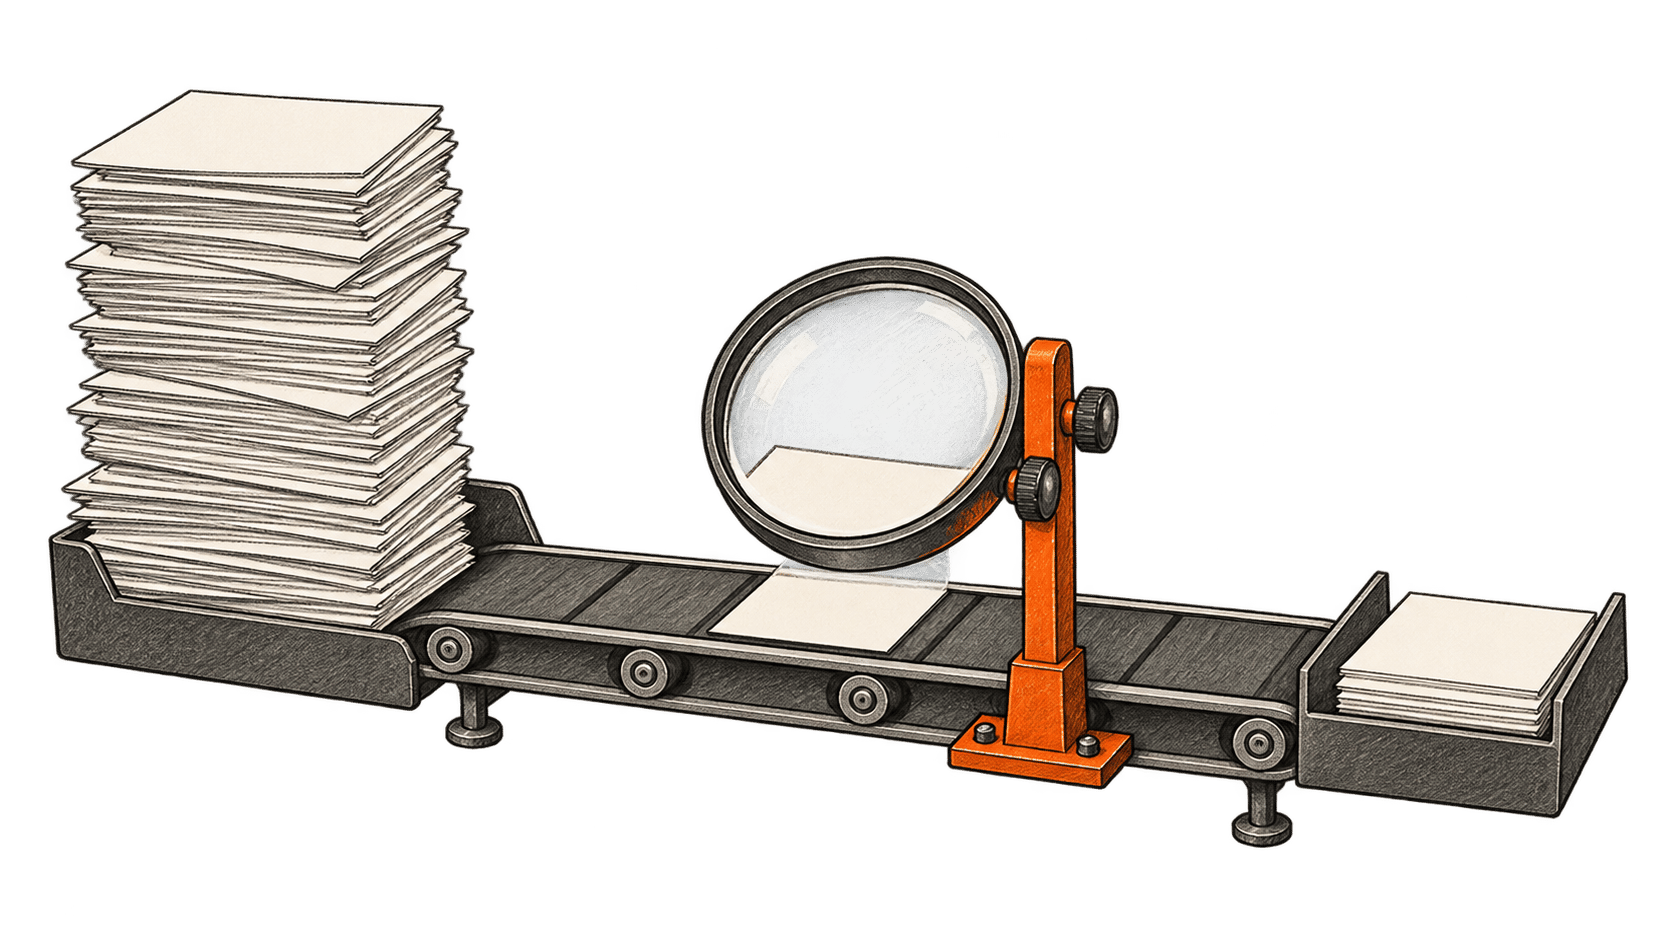
AI کوڈنگ معاون ایک پیچ مکمل کر سکتا ہے جبکہ اس سے پہلے والے پیچ کی جانچیں ابھی چل رہی ہوں۔ انجینئرنگ منتظم کے لیے اس سے ایک مشکل فرق پیدا ہوتا ہے: ٹیم نے زیادہ کوڈ تیار کیا، مگر صارف کو ابھی کچھ نہیں ملا۔
Linear ایک مفید مثال پیش کرتا ہے۔ 21 ستمبر کے انجینئرنگ بیان میں Mufeez Amjad بتاتے ہیں کہ 2026 کے آغاز سے اس کے ٹیسٹ سوئٹس تقریباً چار گنا ہو گئے، جبکہ مسلسل انضمام (CI) پر پل ریکویسٹ کے انتظار کا وقت چھ منٹ سے زیادہ سے گھٹ کر پانچ منٹ سے کچھ زیادہ رہ گیا۔ فی ٹیسٹ رنر کا وقت تقریباً آدھا ہوا۔ یہ الگ الگ بہتریاں ہیں؛ آخری عدد کا مطلب یہ نہیں کہ CI کا کل بل آدھا ہو گیا۔ Linear توثیق پر بڑھتے دباؤ کو معاون کی مدد سے ہونے والی ترقی سے منسوب کرتا ہے، مگر اس کا بیان AI کے پیداواری اثر کا تعین کرنے والا کنٹرولڈ تجربہ نہیں۔ Linear کا انجینئرنگ بیان.
مسلسل انضمام، یا CI، مجوزہ سافٹ ویئر تبدیلیوں پر خودکار جانچیں چلاتا ہے۔ یہ قابلِ عمل دکھائی دینے والے پیچ اور اس تبدیلی کے درمیان ہوتا ہے جسے ٹیم قبول کرنے کے لیے تیار ہو۔ جب AI کوڈنگ سے پیچ کی رسد بڑھتی ہے تو جانچ کی یہ گنجائش کاروباری سوال بن جاتی ہے: ادارہ کتنا مفید کام محفوظ طریقے سے سنبھال سکتا ہے؟
ہماری رائے میں منتظمین کو تین نتائج ایک ساتھ نمایاں کرنے چاہییں: قابلِ اعتماد رائے ملنے تک کا وقت، کمپیوٹنگ کا مجموعی کام اور جاری شدہ تبدیلیوں کا اعتبار۔ تیز جواب تبھی مفید ہے جب ٹیم سمجھے کہ اس جواب سے کیا ثابت ہوتا ہے۔
انتظار گھٹانے کے لیے کام بڑھ سکتا ہے
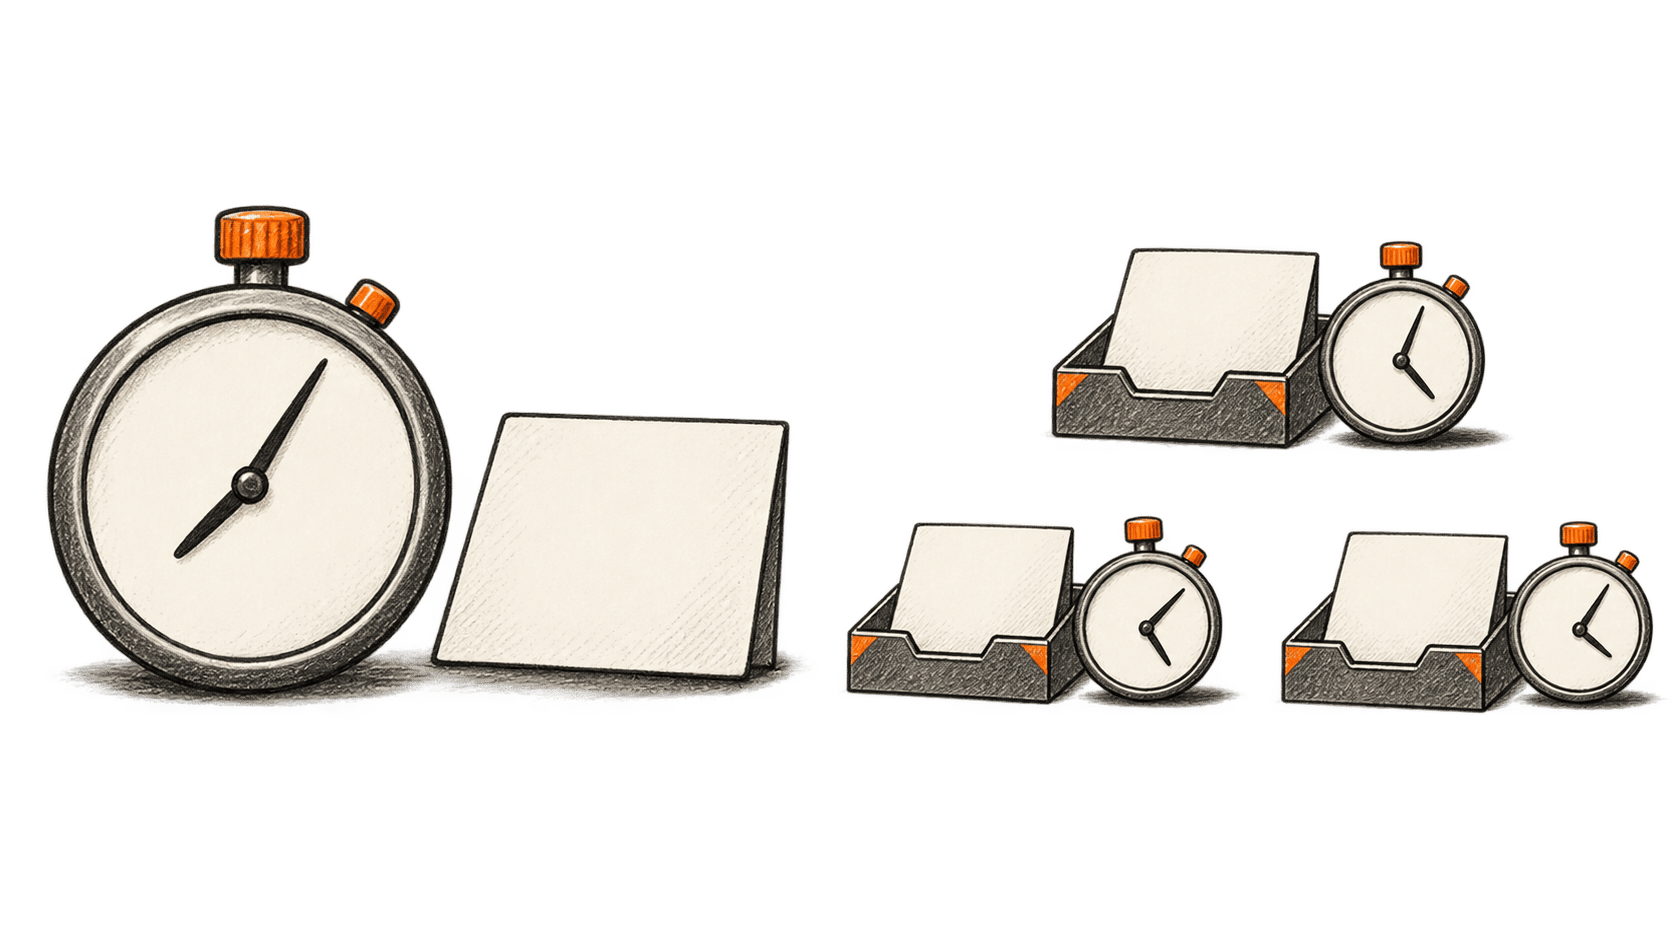
بارہ منٹ کا ٹیسٹ سوٹ ایک مشین پر چلنے کا تصور کریں۔ اسے چار مشینوں میں برابر بانٹنے سے کام تین منٹ میں ختم ہو سکتا ہے۔ اس فرضی مثال میں کامل تقسیم مانی گئی ہے اور باقی ہر چیز کو نظر انداز کیا گیا ہے۔ مشینیں مجموعی طور پر پھر بھی بارہ منٹ کا کام کرتی ہیں۔
اب ہر مشین کی تیاری میں ایک منٹ لگائیں۔ چار مشینوں والا طریقہ کام چار منٹ میں ختم کرتا اور رنر کے سولہ منٹ استعمال کرتا ہے۔ ایک مشین والا طریقہ تیرہ منٹ لیتا اور رنر کے تیرہ منٹ استعمال کرتا ہے۔ انتظار کا وقت نمایاں طور پر کم ہوتا ہے جبکہ مشینوں کا مجموعی استعمال بڑھتا ہے۔ اصل بل رنر کی قسم، قیمتوں اور بلنگ کے قواعد پر بھی منحصر ہیں۔
جب ڈیش بورڈ سبز پٹی کے مختصر ہونے کا جشن منائے تو یہ فرق اہم ہے۔ متوازی گنجائش خریدنے والا منتظم پہلے رائے حاصل کرنے کے لیے ادائیگی کر رہا ہے، ممکن ہے اضافی لاگت کے ساتھ۔ اگر اس سے واقعی کوئی رکاوٹ دور ہو تو یہ بہترین سودا ہو سکتا ہے۔ لیکن اگر مکمل تبدیلی پھر دستیاب جائزہ کار کے لیے گھنٹوں منتظر رہے تو اس جواز کو پیش کرنا مشکل ہے۔
تجزیے کی اکائی ایک CI رن سے آگے ہونی چاہیے۔ ایسا پیچ جس کے بعد بار بار ترامیم، دوبارہ جانچیں اور جائزے کا دوسرا مرحلہ درکار ہو، اپنے تیز ترین انفرادی رن سے کہیں زیادہ کام لے سکتا ہے۔ تبدیلی قبول کرنے کے لیے درکار تمام کوششیں شمار کریں، جن میں ترک شدہ کوششیں بھی شامل ہیں۔ ورنہ بظاہر مؤثر پائپ لائن مہنگا ترقیاتی عمل چھپا سکتی ہے۔
نہ انتظار کا ہر منٹ اجرت کے برابر لاگت ہے۔ جانچ کے دوران دوسرا مفید کام شروع کرنے والا ڈویلپر لازماً پورا وقفہ ضائع نہیں کرتا۔ بار بار کی رکاوٹیں اور نامکمل کام کی طرف لوٹنا پھر بھی نقصان دے سکتا ہے۔ ان اثرات کو ناپنے کے لیے ٹیم کے کام کا مشاہدہ ضروری ہے، صرف گزرے ہوئے منٹوں کو تنخواہوں سے ضرب دینا کافی نہیں۔
تحقیق سے ملی جلی تصویر سامنے آتی ہے
DORA کا مارچ 2026 کا تجزیہ شواہد کے دو الگ مجموعے پیش کرتا ہے۔ اس کی 2025 کی تحقیق میں AI کے زیادہ استعمال کا تعلق سافٹ ویئر فراہمی کی زیادہ پیداوار اور زیادہ عدم استحکام، دونوں سے تھا۔ الگ سے، محققین نے 2025 کی تیسری سہ ماہی میں Google کے انجینئروں سے جمع کردہ 1,110 آزادانہ جوابات کا تجزیہ کیا۔ انجینئروں نے مسودے اور دوسرے کاموں میں مدد کے ساتھ توثیق کے اضافی بوجھ کا بھی ذکر کیا۔ یہ اندرونی معیاری نوعیت کی تحقیق، وسیع DORA تعلق کے پیچھے موجود آبادی کا مطالعہ نہیں تھی، اور ان میں سے کوئی بھی یہ ثابت نہیں کرتا کہ AI نے کسی خاص ٹیم کی ریلیز کے مسائل پیدا کیے۔ DORA کا تجزیہ اور طریقۂ کار.
اس سے زیادہ مضبوط تجرباتی ثبوت بھی ہے، مگر اس کا دائرہ محدود ہے۔ METR کے جولائی 2025 کے بے ترتیب مطالعے میں مانوس ریپوزٹریز پر کام کرنے والے 16 تجربہ کار اوپن سورس ڈویلپرز کو 246 کام دیے گئے۔ 2025 کے آغاز کے AI ٹولز کی اجازت کے ساتھ کام مکمل کرنے میں 19% زیادہ وقت لگا۔ اس کے باوجود شرکاء کا خیال تھا کہ AI نے انہیں تیزی سے کام کرنے میں مدد دی۔ یہ نتیجہ انہی ڈویلپرز، کاموں اور ٹولز سے متعلق ہے؛ آج دستیاب ہر کوڈنگ معاون کی قدر کا فیصلہ نہیں کرتا۔ METR کا اصل تجربہ.
فروری 2026 میں METR نے کہا کہ اس کا اگلا مطالعہ موجودہ پیداواری اثرات کا ناقابلِ اعتماد تخمینہ دے سکا۔ ڈویلپرز نے AI کے بغیر کام کرنے سے انکار یا جمع کرانے کے لیے کام خود چننا زیادہ شروع کیا؛ بیک وقت چلنے والے معاونین نے وقت کی پیمائش کو بھی پیچیدہ بنایا۔ محققین نے زیادہ تیزی ممکن سمجھی، مگر کہا کہ اس کے حجم کے بارے میں شواہد کمزور ہیں۔ اس وضاحت کے بغیر سست روی کا پرانا عدد دہرانا قارئین کو گمراہ کرے گا۔ METR کا اگلا مطالعہ.
منتظم کے لیے ان مطالعات سے ایک عملی مؤقف کی تائید ہوتی ہے: مفید ٹول رکھیں، ان کے اثرات کی جانچ کریں، اور جوش یا شکوک میں سے کسی کو بھی عملے کی تعداد کا عالمگیر فارمولا نہ بنائیں۔ ایک قسم کے کام میں ٹیم کو خاص فائدہ اور دوسرے میں وقت کا نقصان ہو سکتا ہے۔ فراہمی کے عمل سے یہ فرق ظاہر ہونا چاہیے۔
ہر رکاوٹ کا الگ حل کریں
زیادہ CI گنجائش خریدنے سے پہلے ایک تبدیلی کو اس کے پہلے مجوزہ پیچ سے پروڈکشن تک نقشے پر دکھائیں۔ چلنے والے کام کو انتظار کرنے والے کام سے الگ کریں۔ اس جانچ کی شناخت کریں جو واقعی فیصلے میں تاخیر کرتی ہے، اس جائزہ کار کی جس کی توجہ درکار ہے، اور ریلیز کی ان شرائط کی جو اس کے بعد بھی باقی رہتی ہیں۔
وقت کا سادہ ریکارڈ اکثر غلط سرمایہ کاری کو بے نقاب کرنے کے لیے کافی ہوتا ہے۔ اگر زیادہ تر تاخیر جائزہ شروع ہونے سے پہلے ہو تو ٹیسٹوں سے سیکنڈ بچانے سے مسئلہ حل نہیں ہوگا۔ اگر جائزہ کار بار بار طویل لازمی جانچ کا انتظار کریں تو اسے بہتر بنانے کا واضح مقصد ہے۔ اگر ناکامیاں زیادہ تر تعیناتی کے بعد آئیں تو ٹیم کو دیکھنا ہوگا کہ توثیق کیا پکڑ نہیں رہی۔
انحصارات کی کیشنگ دکھاتی ہے کہ معروف بہتری کو ناپنا کیوں چاہیے۔ GitHub کی دستاویزات کے مطابق کیشنگ صاف رنرز پر دوبارہ بنانا مہنگی فائلیں دوبارہ استعمال کرنے کا طریقہ ہے۔ وہ یہ بھی کہتی ہیں کہ کیش دستیاب نہ ہو تو کاموں کو ان فائلوں کو دوبارہ بنانا یا ڈاؤن لوڈ کرنا ممکن ہونا چاہیے۔ اس لیے کیش کی کارکردگی کو کیش ہٹ اور کیش مس، دونوں صورتوں پر جانچیں۔ GitHub کی انحصار کی کیشنگ سے متعلق دستاویزات.
منتظم کے لیے مفید سوال یہ ہے کہ رائے کتنی قابلِ پیش گوئی ہوتی ہے۔ اوسط بہترین ہو تب بھی کبھی کبھار کا انتظار ریلیز میں خلل ڈالنے کے لیے کافی طویل ہو سکتا ہے۔ تقسیم کے سست ترین حصے کو ناپیں، اور جائز ٹیسٹ کی ناکامی کو ڈاؤن لوڈ کی ناکامی یا رنر کی گنجائش ختم ہونے سے الگ رکھیں۔ ہر ایک کا حل مختلف ہے۔
قابلِ اعتماد اور بروقت رائے لوگوں اور معاونین دونوں کو غلطی درست کرنے کا موقع جلد دیتی ہے۔ اس مشترکہ بنیادی ڈھانچے کو بہتر بنانے سے AI کے بغیر لکھی گئی تبدیلیوں سمیت کئی طرح کے ترقیاتی کاموں کو فائدہ ہو سکتا ہے۔ اس لیے کوڈنگ ٹولز کا انتخاب بدلنے کے باوجود منتظمین اسے مالی مدد دینے کا جواز رکھتے ہیں۔
تیز ٹیسٹوں میں بھی غلطیاں پکڑنی چاہییں
کارکردگی کی کچھ تبدیلیاں ٹیسٹ چلنے کے حالات بدل دیتی ہیں۔ اس لیے ان کی جانچ تیز پروسیسر کے مقابلے میں زیادہ باریک بینی سے ہونی چاہیے۔
JavaScript اور TypeScript کی ٹیسٹنگ کے ٹول Vitest میں طے شدہ طور پر ہر ٹیسٹ فائل الگ تھلگ چلتی ہے تاکہ ایک فائل کی حالت دوسری کو متاثر نہ کرے۔ اس کی دستاویزات موزوں ٹیسٹوں کے لیے الگ تھلگ رکھنے کی شرط منتخب طور پر ہٹانے کا طریقہ بتاتی ہیں، جبکہ قابلِ تغیر ماڈیول حالت، بدلے ہوئے گلوبلز اور دوسرے انحصارات کو اسے برقرار رکھنے کی وجہ قرار دیتی ہیں۔ اس لیے تیاری کا وقت گھٹانے والی ترتیب درستی کی حد بھی بدل سکتی ہے۔ Vitest کی الگ تھلگ رکھنے سے متعلق رہنمائی.
Linear نے مشترکہ حالت کے لیے اختیاری طریقہ اپنایا، صفائی شامل کی اور ان فائلوں کو الگ تھلگ ہی رکھا جنہیں محفوظ طور پر منتقل نہیں کیا جا سکتا تھا۔ اس کی کارکردگی کا فائدہ اس فیصلے پر منحصر تھا کہ کون سے ٹیسٹ وہ ماحول محفوظ طور پر بانٹ سکتے ہیں۔ Linear کا نفاذ.
جب کوئی معاون تبدیلی اور اس کے ٹیسٹ دونوں لکھتا ہے تو ایک الگ چیلنج بھی پیدا ہوتا ہے۔ سالانہ رکنیتوں پر لاگو رعایتی ضابطے کی فرضی مثال لیں۔ معاون غلطی سے اسے ماہانہ منصوبوں پر بھی لاگو کر سکتا ہے، پھر اپنے ہی مطلب کی توثیق کرنے والے ٹیسٹ لکھ سکتا ہے۔ ان ٹیسٹوں کا پاس ہونا غلطی کے ساتھ مطابقت ثابت کرے گا۔
جائزہ کار کو اس نفاذ سے باہر کے شواہد درکار ہیں: متفقہ تقاضا، مطلوبہ برتاؤ کی مثالیں اور وہ صورتیں جنہیں ناکام ہونا چاہیے۔ معاون سے مزید ٹیسٹ لکھوانا مدد دے سکتا ہے، مگر صرف ٹیسٹوں کی زیادہ تعداد یہ نہیں دکھاتی کہ غلط سمجھے گئے تقاضے کو چیلنج کیا گیا ہے۔ یہاں انسان کی ذمہ داری یہ طے کرنا ہے کہ سافٹ ویئر کو کیا کرنا چاہیے اور شواہد واقعی اسی سوال کا جواب دیتے ہیں یا نہیں۔
جو ٹیمیں یہ دیکھے بغیر ٹیسٹوں کی تعداد کو انعام دیتی ہیں کہ ٹیسٹ کیا ثابت کرتے ہیں، وہ جائزہ کاروں کو زیادہ مواد اور کم اعتماد دے سکتی ہیں۔ کام سونپتے وقت منتظم کو اس جانچ کے لیے وقت رکھنا چاہیے، نہ کہ معاون کا کام ختم ہونے کے بعد اسے بے وجہ تاخیر سمجھنا چاہیے۔
صارفین تک پہنچنے والی تبدیلی ناپیں
DORA کے سافٹ ویئر فراہمی کے پیمانے اگلے مرحلے کی مفید جانچ فراہم کرتے ہیں۔ ان میں کمٹ شدہ کوڈ سے پروڈکشن تک کا وقت، تعیناتیوں کی تعداد، ناکام تعیناتی کے بعد بحالی، ان تعیناتیوں کا تناسب جن میں فوری مداخلت درکار ہو، اور غیر منصوبہ بند واقعے سے متعلق دوبارہ کام والی تعیناتیوں کا تناسب شامل ہیں۔ یہ محض ٹیسٹ پاس ہونے سے آگے فراہمی کے نتائج بیان کرتے ہیں۔ DORA کے پیمانوں کی تعریفیں.
AI کوڈنگ ورک فلو کی جانچ کرنے والی ٹیم کے لیے ہم ان نتائج کے ساتھ ایک مختصر تشخیصی ریکارڈ رکھیں گے:
- رائے: مطلوبہ جانچوں تک گزرنے والا وقت، جس میں سست رنز اور گنجائش کے انتظار کا وقت بھی شامل ہو۔
- استعمال: قبول شدہ تبدیلی سے وابستہ مجموعی رنر کام اور بار بار کی گئی کوششیں۔
- جائزہ: توجہ کے انتظار کا وقت، مانگی گئی بڑی ترامیم اور ہر ترمیم کی وجہ۔
- صارف پر اثر: جاری شدہ تبدیلی نے مطلوبہ برتاؤ دیا یا نہیں، اور اصلاحی کام درکار ہوا یا نہیں۔
کسی خاص ورک فلو کی جانچ کے لیے یہ ریکارڈ استعمال کریں۔ دستاویز میں معمولی ترمیم اور ڈیٹابیس مائیگریشن کو پیداوار کی ایک جیسی اکائیاں نہیں سمجھنا چاہیے۔ جہاں ممکن ہو، وقت کے ساتھ ملتے جلتے کام کا موازنہ کریں اور دوسری تبدیلیاں بھی درج کریں، مثلاً نیا رنر فراہم کنندہ یا ریلیز کے عمل میں ترمیم۔ AI کے استعمال کے ساتھ بہتری آنا اس کی وجہ ثابت نہیں کرتا۔
اس کے بعد منتظم ایک ٹھوس انتخاب کر سکتے ہیں: اس رکاوٹ کو مالی مدد دیں جو مفید تبدیلیاں مناسب اعتماد کے ساتھ صارفین تک پہنچنے سے روکتی ہے۔ کبھی اس کا مطلب زیادہ کمپیوٹنگ گنجائش ہوگا۔ کبھی اس کا مطلب واضح تر تقاضے، بہتر ٹیسٹ یا پہلے ہی موصول ہونے والی تجاویز کو سمجھنے کے لیے تجربہ کار جائزہ کاروں کا کافی وقت ہوگا۔