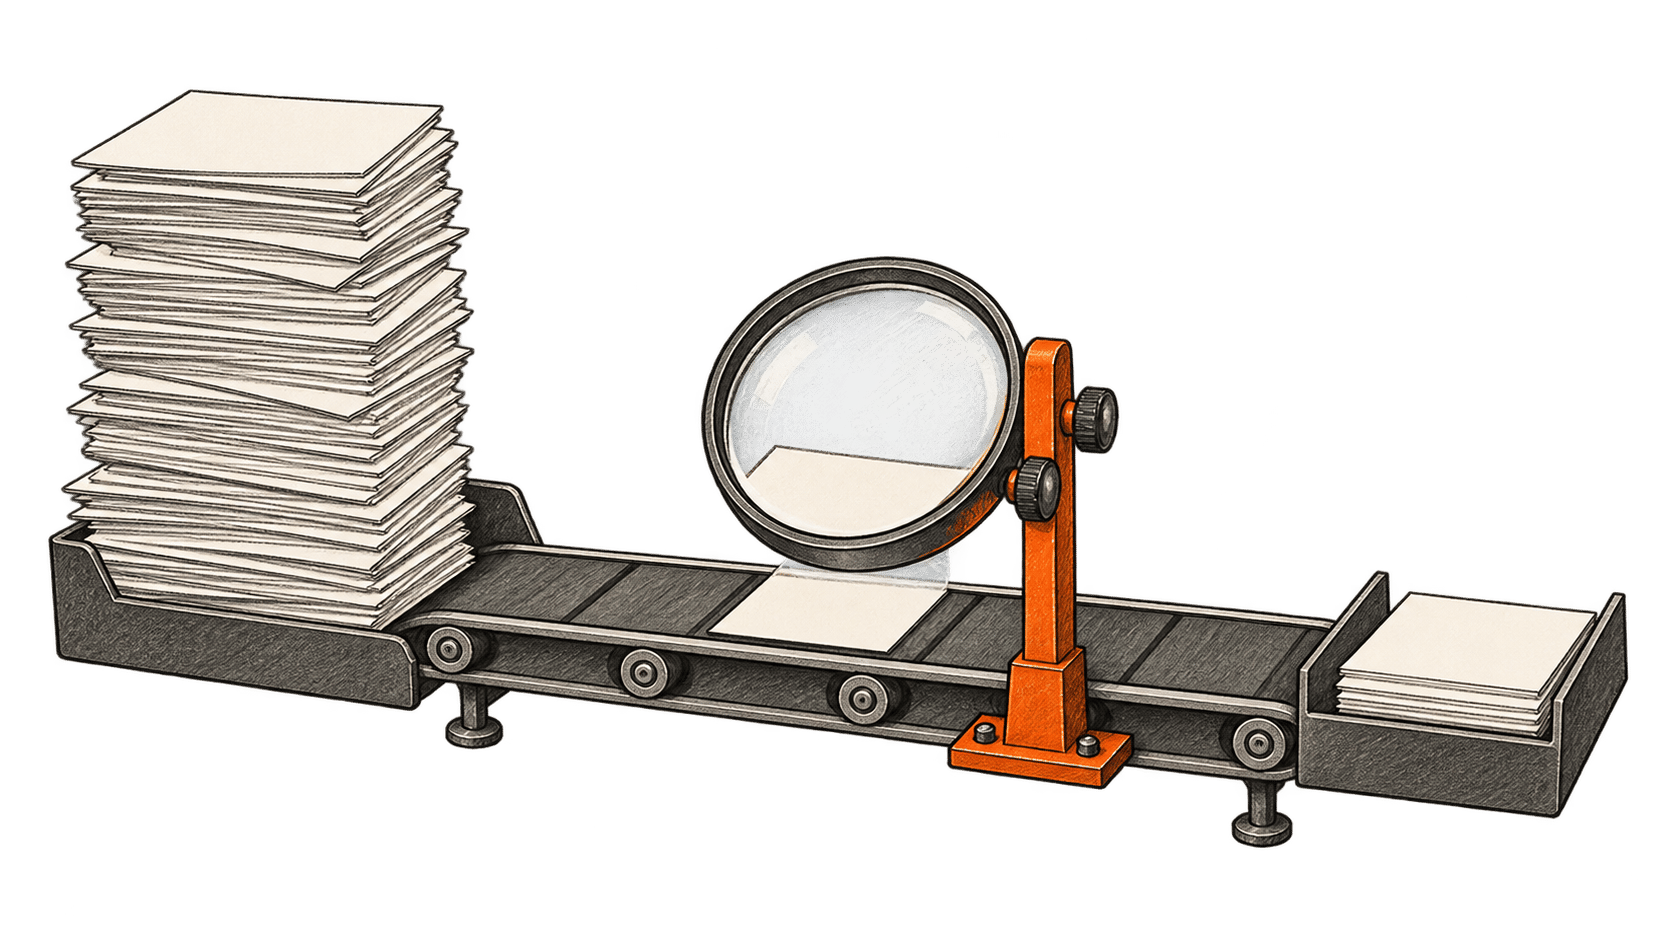
AI coding agent আগের patch-এর পরীক্ষা চলতে থাকতেই নতুন patch শেষ করতে পারে। প্রকৌশল ব্যবস্থাপকের কাছে এতে অস্বস্তিকর পার্থক্য তৈরি হয়: দল আরও code বানিয়েছে, কিন্তু গ্রাহকের কাছে এখনো কিছু পৌঁছায়নি।
Linear একটি কাজে লাগার মতো উদাহরণ। ২১ সেপ্টেম্বরের প্রকৌশল-সংক্রান্ত বিবরণে Mufeez Amjad জানান, ২০২৬ সালের শুরু থেকে তাদের test suite-এর সংখ্যা প্রায় চার গুণ হয়েছে, আর continuous integration-এ pull request-এর অপেক্ষা ছয় মিনিটেরও বেশি থেকে কমে পাঁচ মিনিটের একটু বেশি হয়েছে। প্রতি পরীক্ষায় runner-এর সময় মোটামুটি অর্ধেক হয়েছে। এগুলো আলাদা উন্নতি; শেষের সংখ্যাটি দিয়ে মোট CI বিল অর্ধেক হয়েছে—এমন বোঝায় না। Linear যাচাইয়ের ওপর বাড়তি চাপকে agent-সহায়তায় উন্নয়নের সঙ্গে যুক্ত করেছে, তবে তাদের বিবরণ নিয়ন্ত্রিত পরীক্ষা নয় যা AI-এর উৎপাদনশীলতার প্রভাব প্রতিষ্ঠা করে। Linear-এর প্রকৌশল-বিবরণ.
Continuous integration, বা CI, প্রস্তাবিত সফটওয়্যার পরিবর্তনে স্বয়ংক্রিয় পরীক্ষা চালায়। সম্ভাব্য patch আর দল গ্রহণ করতে প্রস্তুত এমন পরিবর্তনের মাঝখানে এটি থাকে। AI coding-এ patch-এর জোগান বাড়লে যাচাইয়ের এই সক্ষমতা ব্যবসার বিষয় হয়ে ওঠে: প্রতিষ্ঠান নিরাপদে কতটা কার্যকর কাজ গ্রহণ করতে পারে?
আমাদের মতে, ব্যবস্থাপকদের তিনটি ফল একসঙ্গে দৃশ্যমান করা উচিত: বিশ্বাসযোগ্য প্রতিক্রিয়া পেতে সময়, মোট গণনামূলক কাজ এবং প্রকাশিত পরিবর্তনের নির্ভরযোগ্যতা। দ্রুত উত্তর তখনই মূল্যবান, যখন দল জানে উত্তরটি আসলে কী প্রতিষ্ঠা করে।
অপেক্ষা কমলেও কাজ বাড়তে পারে
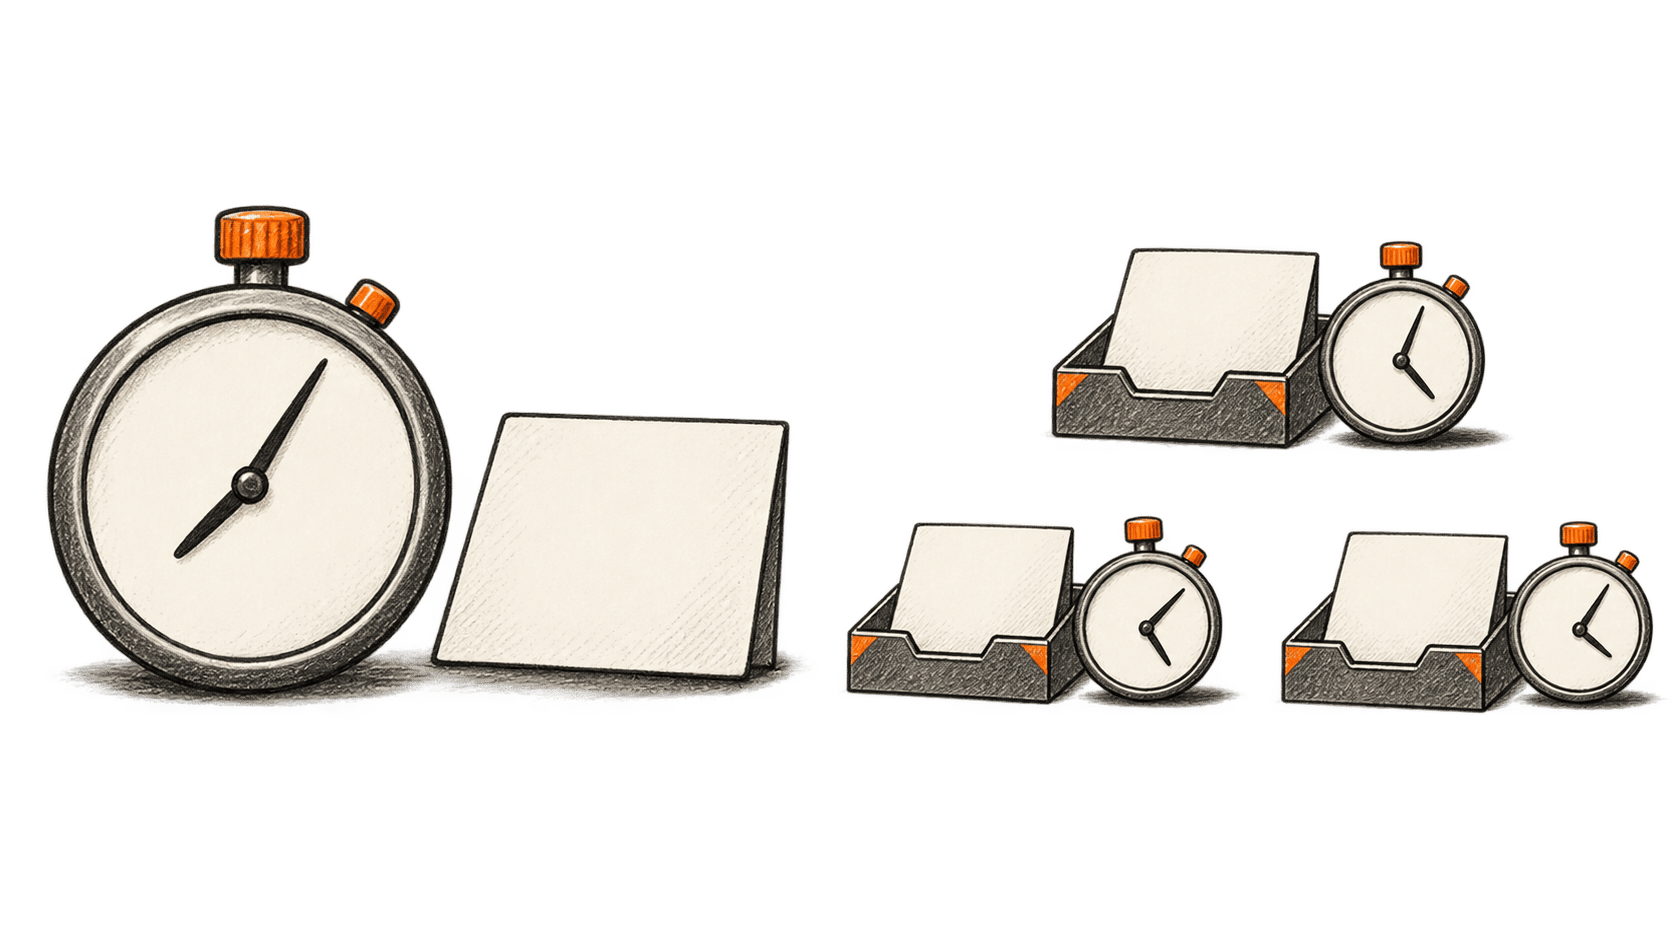
ধরা যাক, একটি test suite-এর কাজ এক যন্ত্রে করতে বারো মিনিট লাগে। কাজটি সমানভাবে চার যন্ত্রে ভাগ করলে তিন মিনিটে শেষ হতে পারে। এই কাল্পনিক উদাহরণে নিখুঁত ভারসাম্য ধরা হয়েছে এবং অন্য সবকিছু বাদ। তবু যন্ত্রগুলো মিলিয়ে মোট বারো মিনিটের কাজই করে।
এবার প্রতিটি যন্ত্র তৈরিতে এক মিনিট লাগে ধরুন। চার যন্ত্রের সংস্করণ শেষ হতে চার মিনিট লাগে এবং মোট runner-সময় হয় ষোলো মিনিট। একটি যন্ত্রে সংস্করণটি শেষ হতে তেরো মিনিট লাগে এবং খরচ হয় তেরো runner-minute। অপেক্ষার সময় অনেক কমলেও সব যন্ত্রের মোট ব্যবহার বাড়ে। বাস্তব বিল runner-এর ধরন, দাম ও বিলিং-নিয়মের ওপরও নির্ভর করে।
ড্যাশবোর্ডে ছোট সবুজ bar দেখে উচ্ছ্বসিত হলে এই পার্থক্য জরুরি। সমান্তরাল সক্ষমতা কেনা মানে আগেভাগে প্রতিক্রিয়া পাওয়া কেনা—সম্ভবত বাড়তি খরচে। সত্যিকারের সীমাবদ্ধতা সরালে এই বিনিময় চমৎকার হতে পারে। কিন্তু পরিবর্তন শেষ হওয়ার পর পর্যালোচক পাওয়ার জন্য ঘণ্টার পর ঘণ্টা অপেক্ষা করলে তা ন্যায্যতা দেওয়া কঠিন।
বিশ্লেষণের একক একটি CI run-এ থামা উচিত নয়। কোনো patch-এ বারবার সংশোধন, পুনঃপরীক্ষা ও দ্বিতীয় দফার পর্যালোচনা লাগলে, তার দ্রুততম একক run দেখে যতটা মনে হয় মোট কাজ তার চেয়ে অনেক বেশি হতে পারে। পরিত্যক্ত চেষ্টাসহ পরিবর্তন গ্রহণে যতগুলো চেষ্টা দরকার, সব গুনুন। নইলে দক্ষ দেখানো pipeline ব্যয়বহুল উন্নয়নপ্রক্রিয়া আড়াল করতে পারে।
অপেক্ষার প্রতিটি মিনিটের শ্রম-ব্যয়ও এক নয়। পরীক্ষা চলার সময় developer আরেকটি কার্যকর কাজ শুরু করলে পুরো বিরতিটি যে নষ্ট হয়েছে এমন নয়। তবে বারবার বাধা এবং অসমাপ্ত কাজে ফিরে আসা ক্ষতিকর হতে পারে। এ প্রভাব মাপতে শুধু কেটে যাওয়া মিনিটকে বেতনের সঙ্গে গুণ না করে দল কীভাবে কাজ করে তা দেখতে হবে।
গবেষণায় মিশ্র চিত্র দেখা যায়
মার্চ ২০২৬-এর DORA বিশ্লেষণে দুইটি আলাদা প্রমাণধারা রয়েছে। ২০২৫ সালের গবেষণায় AI ব্যবহারের হার বেশি হলে সফটওয়্যার সরবরাহের গতি যেমন বাড়তে দেখা গেছে, তেমনি অস্থিতিশীলতাও বেড়েছে। আলাদাভাবে, গবেষকেরা ২০২৫ সালের তৃতীয় প্রান্তিকে সংগ্রহ করা Google প্রকৌশলীদের ১,১১০টি মুক্ত-উত্তর বিশ্লেষণ করেছেন। প্রকৌশলীরা খসড়া ও অন্যান্য কাজে সহায়তার পাশাপাশি যাচাইয়ে বাড়তি কাজের কথাও বলেছেন। বৃহত্তর DORA-র সম্পর্কের পেছনের জনসমষ্টি এই অভ্যন্তরীণ গুণগত গবেষণার জনসমষ্টি নয়; কোনোটিই প্রমাণ করে না যে AI নির্দিষ্ট কোনো দলের release সমস্যার কারণ। DORA-র বিশ্লেষণ ও পদ্ধতি.
এর চেয়ে সীমিত পরিসরে আরও শক্তিশালী পরীক্ষামূলক প্রমাণ আছে। METR-এর ২০২৫ সালের জুলাইয়ের randomised study-তে পরিচিত repository-তে কাজ করা ১৬ জন অভিজ্ঞ open-source developer-কে ২৪৬টি কাজ দেওয়া হয়। ২০২৫ সালের শুরুর দিকের AI সরঞ্জাম ব্যবহারের অনুমতি থাকলে কাজ শেষ হতে ১৯% বেশি সময় লেগেছিল। অংশগ্রহণকারীরা তবু মনে করেছিলেন, AI তাঁদের কাজে গতি দিয়েছে। ফলটি ওই developer, কাজ ও সরঞ্জাম নিয়ে; আজ উপলভ্য সব coding agent-এর মূল্য স্থির করে না। METR-এর মূল পরীক্ষা.
২০২৬ সালের ফেব্রুয়ারিতে METR জানায়, তাদের পরবর্তী পরীক্ষায় বর্তমান উৎপাদনশীলতার প্রভাবের নির্ভরযোগ্য হিসাব মেলেনি। developer-রা AI ছাড়া কাজ প্রত্যাখ্যান করতে বা কোন কাজ জমা দেবেন তা বেছে নিতে থাকায়, concurrent agent-ও সময় মাপা জটিল করেছিল। গবেষকেরা আরও ত্বরান্বিত হওয়া সম্ভব বলে মনে করলেও, তার মাত্রা সম্পর্কে উপাত্তে দুর্বল প্রমাণ পেয়েছেন। এ সতর্কতা বাদ দিয়ে আগের ধীরগতির সংখ্যাটি বলা পাঠককে ভুল পথে চালাবে। METR-এর অনুসরণী গবেষণা.
ব্যবস্থাপকদের জন্য এ গবেষণাগুলো ব্যবহারিক অবস্থান নেওয়ার ভিত্তি দেয়: কার্যকর সরঞ্জাম রাখুন, তার প্রভাব অনুসন্ধান করুন এবং উৎসাহ বা সন্দেহ—কোনোটাকেই সবার জন্য এক নিয়োগ-সূত্র বানাবেন না। এক ধরনের কাজে দল অনেক লাভবান, অন্য ধরনের কাজে সময় হারাতে পারে। সরবরাহ-প্রক্রিয়ায় এ পার্থক্য দৃশ্যমান হওয়া দরকার।
প্রতিটি সীমাবদ্ধতার জন্য আলাদা সমাধান দিন
আরও CI সক্ষমতা কেনার আগে একটি পরিবর্তনের প্রথম প্রস্তাবিত patch থেকে production-এ পৌঁছানো পর্যন্ত পথচিত্র বানান। যে কাজ চলে এবং যে কাজ অপেক্ষা করে—আলাদা করুন। সিদ্ধান্ত আটকে রাখা প্রকৃত পরীক্ষাটি, মনোযোগ দরকার এমন পর্যালোচক এবং এরপরও যে release-শর্ত থাকে তা চিহ্নিত করুন।
সহজ একটি সময়ের নথিই ভুল বিনিয়োগ প্রকাশের জন্য প্রায়ই যথেষ্ট। পর্যালোচনা শুরু হওয়ার আগেই যদি বেশির ভাগ দেরি হয়, পরীক্ষার সময় কয়েক সেকেন্ড কমিয়ে তা মিটবে না। পর্যালোচকেরা যদি দীর্ঘ বাধ্যতামূলক পরীক্ষার অপেক্ষায় থাকেন, তবে পরীক্ষাটির উন্নতির সরাসরি উদ্দেশ্য আছে। প্রকাশের পরই যদি প্রধান ব্যর্থতা দেখা দেয়, যাচাইয়ে কী বাদ পড়ে তা দলকে পরীক্ষা করতে হবে।
dependency cache একটি পরিচিত optimization কেন মেপে দেখা দরকার, তা দেখায়। পরিষ্কার runner-এ আবার তৈরি করতে ব্যয়বহুল ফাইল পুনর্ব্যবহার করার উপায় হিসেবে GitHub caching নথিভুক্ত করেছে। cache না থাকলেও job যেন ওই ফাইল তৈরি বা ডাউনলোড করতে পারে, সেটিও তারা বলে। তাই cache hit ও miss—দুই অবস্থায় আচরণ মূল্যায়ন করতে হবে। GitHub-এর dependency-caching নথি.
ব্যবস্থাপকের জন্য কার্যকর প্রশ্ন হলো, প্রতিক্রিয়া কতটা পূর্বানুমেয় হচ্ছে। গড় সময় চমৎকার হলেও কখনো কখনো দীর্ঘ অপেক্ষায় release বিঘ্নিত হতে পারে। বণ্টনের ধীরতম দিকটিও মাপুন এবং বৈধ পরীক্ষায় ব্যর্থতা, download ব্যর্থতা ও runner ফুরিয়ে যাওয়া আলাদা করুন। প্রতিটির সমাধান ভিন্ন।
নির্ভরযোগ্য, দ্রুত প্রতিক্রিয়া মানুষ ও agent—দুই পক্ষকেই ভুল আগেভাগে সংশোধনের সুযোগ দেয়। এই ভাগ করা অবকাঠামোর উন্নতি AI ছাড়া লেখা পরিবর্তনসহ বহু ধরনের উন্নয়নকাজে কাজে লাগতে পারে। coding tool-এর পছন্দ বদলালেও ব্যবস্থাপকদের জন্য এতে বিনিয়োগের যুক্তি থাকে।
দ্রুত পরীক্ষা হলেও ভুল ধরতে হবে
কর্মক্ষমতা বাড়ানোর কিছু পরিবর্তনে পরীক্ষা চলার শর্ত বদলে যায়। দ্রুততর processor ব্যবহারের চেয়ে তাতে বেশি খুঁটিয়ে নজর দেওয়া দরকার।
JavaScript ও TypeScript পরীক্ষার সরঞ্জাম Vitest default হিসেবে test file-গুলো আলাদা রাখে, যাতে একটি file-এর অবস্থা অন্যটিকে প্রভাবিত না করে। উপযুক্ত পরীক্ষায় বেছে বেছে isolation বাদ দেওয়ার কথা তাদের নথিতে আছে; তবে বদলানো যায় এমন module state, পরিবর্তিত global variable ও অন্য নির্ভরতার ক্ষেত্রে isolation রাখার কারণও জানানো হয়েছে। ফলে প্রস্তুতির সময় কমানো setting-টি সঠিকতার একটি সীমাও বদলে দিতে পারে। Vitest-এর isolation নির্দেশনা.
ভাগ করা state-এর জন্য Linear opt-in পদ্ধতি ব্যবহার করেছে, cleanup যোগ করেছে এবং নিরাপদে সরানো যায় না এমন file-এ isolation রেখেছে। কোন test নিরাপদে একই environment ভাগ করতে পারে তা ঠিক করার ওপরই তাদের কর্মদক্ষতার উন্নতি নির্ভর করেছে। Linear-এর বাস্তবায়ন.
agent যখন একই সঙ্গে পরিবর্তন ও তার test লেখে, তখন আলাদা চ্যালেঞ্জ তৈরি হয়। ধরা যাক, বার্ষিক subscription-এ ছাড় প্রযোজ্য এমন একটি কাল্পনিক নিয়ম। agent ভুল করে মাসিক plan-এও সেটি প্রয়োগ করল, তারপর নিজের ব্যাখ্যাকে সমর্থন করে test লিখল। test পাস করলেই ভুলটির সঙ্গে সামঞ্জস্য প্রমাণ হবে।
পর্যালোচকের দরকার ওই বাস্তবায়নের বাইরের ভিত্তির প্রমাণ: সম্মত শর্ত, প্রত্যাশিত আচরণের উদাহরণ এবং কোন ঘটনাগুলো ব্যর্থ হওয়া উচিত। agent-কে আরও test লিখতে বললে লাভ হতে পারে, কিন্তু test-এর সংখ্যা বেশি হলেই ভুল বোঝা শর্তকে প্রশ্ন করা হয়েছে—তা বোঝায় না। সফটওয়্যারটির কী করা উচিত ঠিক করা এবং প্রমাণ সেই প্রশ্নের উত্তর দেয় কি না দেখা মানুষের দায়িত্ব।
test-এর পরিমাণের পুরস্কার দিয়ে test আসলে কী প্রতিষ্ঠা করে তা না দেখলে, দল পর্যালোচকের সামনে আরও উপকরণ রেখে আস্থা কমিয়ে দিতে পারে। agent কাজ শেষ করার পরে ব্যাখ্যাতীত দেরি হিসেবে না দেখে, কাজ ভাগ করার সময়ই ব্যবস্থাপকের এ পর্যালোচনার জন্য সময় রাখা উচিত।
গ্রাহকের কাছে পৌঁছানো পরিবর্তন মাপুন
DORA-র সরবরাহ-সংক্রান্ত মাপকাঠি downstream-এর কার্যকর যাচাই দেয়। এর মধ্যে আছে code commit থেকে production পর্যন্ত সময়, deployment-এর হার, ব্যর্থ deployment-এর পরে পুনরুদ্ধার, অবিলম্বে হস্তক্ষেপ লাগা deployment-এর অনুপাত এবং অপরিকল্পিত incident-জনিত পুনঃকাজের অনুপাত। পাস করা test run-এর বাইরের সরবরাহ-ফল এগুলো বর্ণনা করে। DORA-র মাপকাঠির সংজ্ঞা.
AI coding কর্মপ্রবাহ খতিয়ে দেখা দলের জন্য আমরা ওই ফলের সঙ্গে ছোট একটি অনুসন্ধানী নথি রাখব:
- প্রতিক্রিয়া: ধীর run এবং সক্ষমতার অপেক্ষাসহ প্রয়োজনীয় পরীক্ষা পেতে কেটে যাওয়া সময়।
- ব্যবহার: গৃহীত পরিবর্তনের সঙ্গে যুক্ত runner-এর মোট কাজ এবং পুনরাবৃত্ত চেষ্টা।
- পর্যালোচনা: মনোযোগের অপেক্ষায় থাকা সময়, চাওয়া বড় সংশোধন এবং প্রতিটির কারণ।
- গ্রাহকের ওপর প্রভাব: প্রকাশিত পরিবর্তনে কাঙ্ক্ষিত আচরণ এসেছে কি না এবং সংশোধনমূলক কাজ লেগেছে কি না।
নির্দিষ্ট কর্মপ্রবাহ অনুসন্ধানে এ নথি ব্যবহার করুন। নথির ছোটখাটো সম্পাদনা এবং database migration-কে উৎপাদনশীলতার বিনিমেয় একক ভাবা উচিত নয়। সম্ভব হলে সময়ের সঙ্গে তুলনাযোগ্য কাজ তুলনা করুন এবং runner provider বা release প্রক্রিয়া বদলের মতো অন্যান্য পরিবর্তন লিখে রাখুন। AI গ্রহণের পাশাপাশি উন্নতি ঘটলেই তার কারণ প্রমাণিত হয় না।
এরপর ব্যবস্থাপকেরা নির্দিষ্ট সিদ্ধান্ত নিতে পারেন: যথেষ্ট আস্থাসহ উপযোগী পরিবর্তন গ্রাহকের কাছে পৌঁছাতে যে সীমাবদ্ধতা বাধা দেয়, তাতে বিনিয়োগ করুন। কখনো তার মানে হবে আরও গণনাশক্তি। কখনো স্পষ্টতর শর্ত, ভালো test বা আসা প্রস্তাবগুলো বোঝার জন্য অভিজ্ঞ পর্যালোচকের পর্যাপ্ত সময়।