Um agente de programação com IA pode concluir uma correção enquanto as verificações da correção anterior ainda estão a decorrer. Para um gestor de engenharia, isso cria uma distinção incómoda: a equipa produziu mais código, mas o cliente ainda não recebeu nada.
A Linear oferece um caso útil. Num relato de engenharia de 21 de setembro, Mufeez Amjad diz que as suas baterias de testes quase quadruplicaram desde o início de 2026, enquanto o tempo de espera dos pedidos de integração pela integração contínua caiu de mais de seis minutos para pouco mais de cinco. O tempo de execução por teste diminuiu aproximadamente para metade. São melhorias distintas; o último valor não significa que a fatura total de integração contínua também tenha diminuído para metade. A Linear atribui a pressão crescente sobre a validação ao desenvolvimento assistido por agentes, mas o seu relato não é uma experiência controlada que demonstre o efeito da IA na produtividade. Relato de engenharia da Linear.
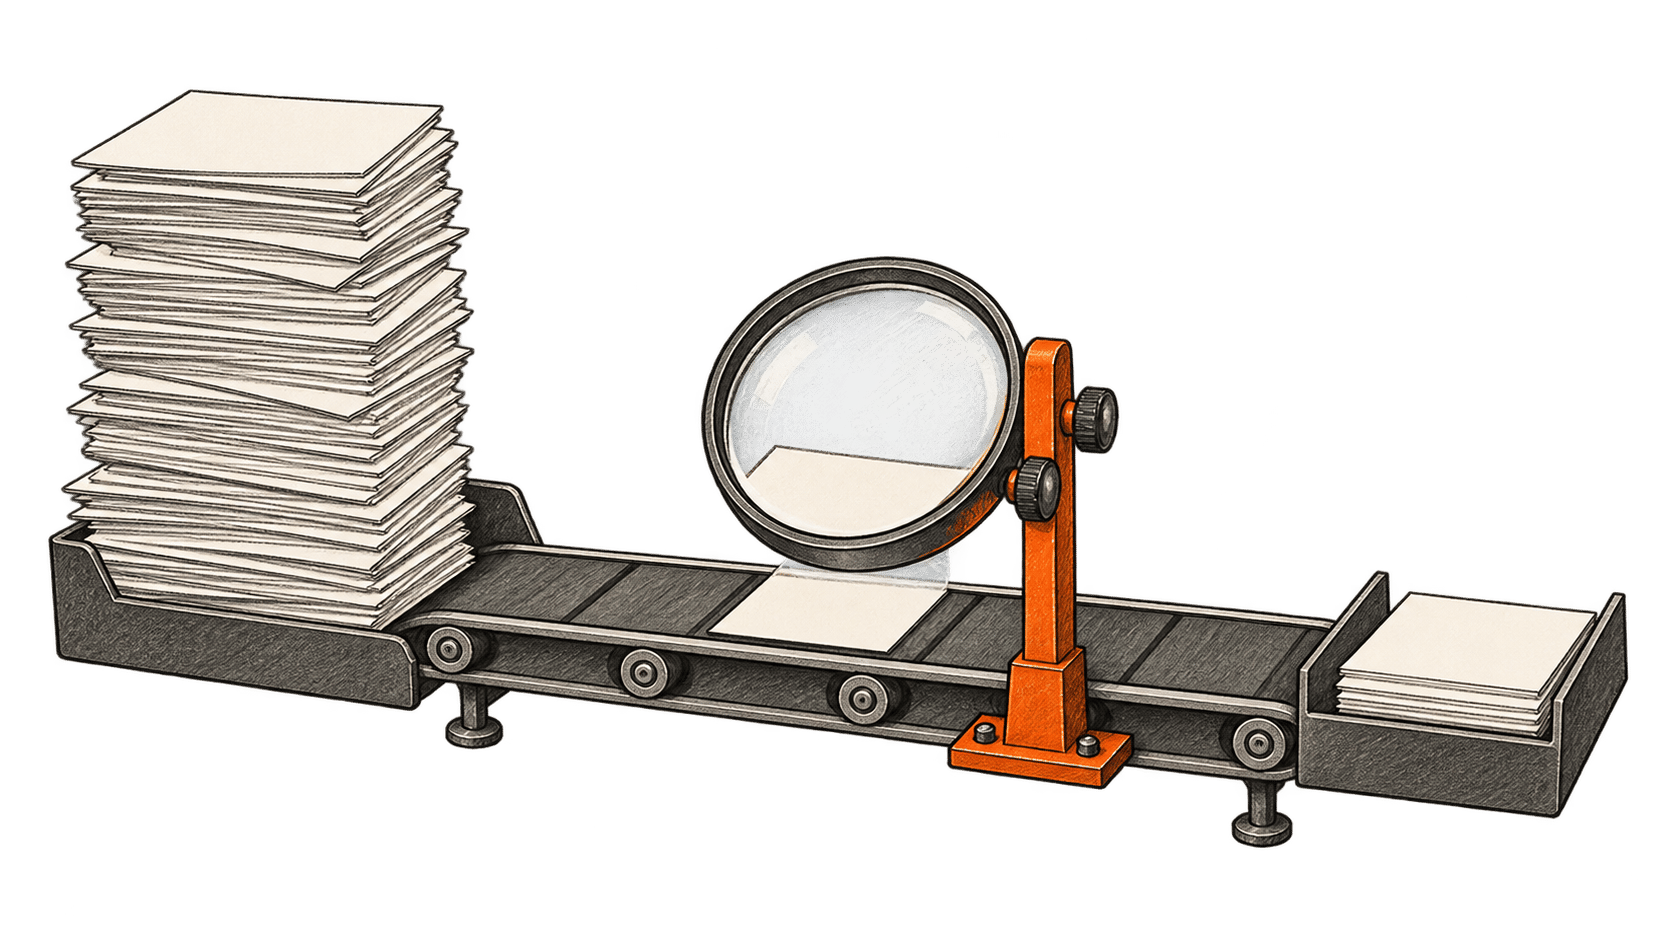
A integração contínua, ou CI, executa verificações automatizadas nas alterações de software propostas. É a etapa entre uma correção plausível e uma alteração que a equipa está disposta a aceitar. Quando a programação com IA aumenta a quantidade de correções, a capacidade de verificação torna-se uma questão empresarial: quanto trabalho útil pode a organização absorver em segurança?
Na nossa opinião, os gestores devem acompanhar em conjunto três resultados: o tempo até obter feedback fiável, o volume total de computação e a fiabilidade das alterações lançadas. Uma resposta mais rápida só tem valor se a equipa compreender o que essa resposta demonstra.
Uma espera mais curta pode implicar mais trabalho
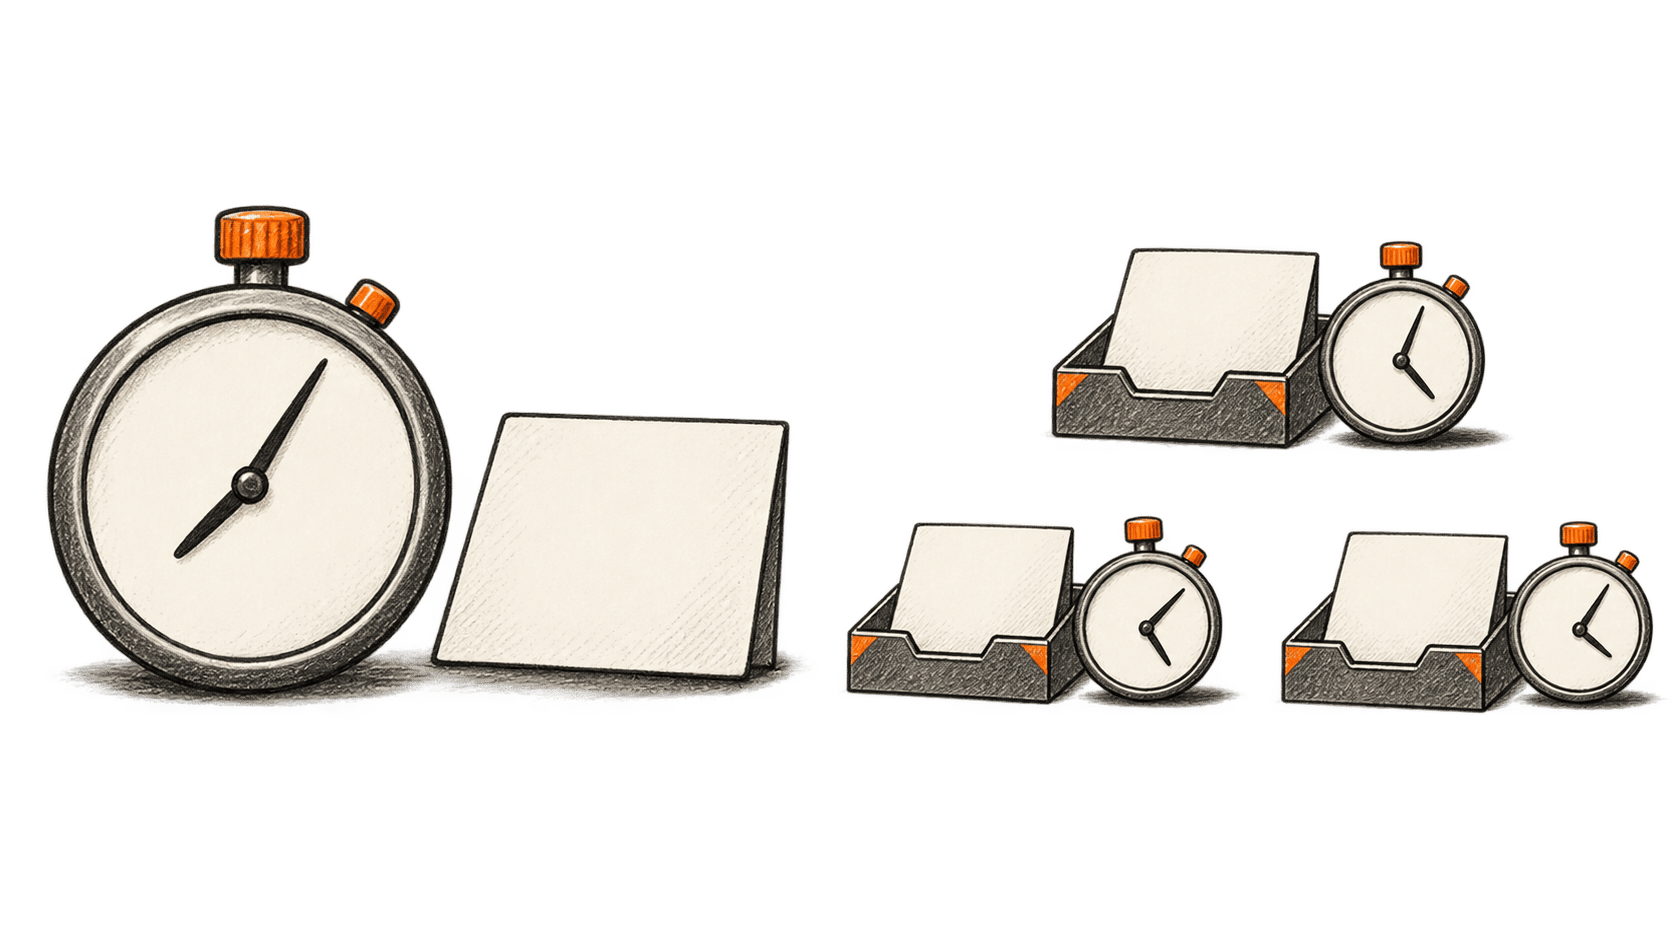
Imagine-se uma bateria de testes que exige doze minutos de trabalho numa máquina. Dividi-la equitativamente por quatro máquinas poderia reduzir o tempo de conclusão para três minutos. Este exemplo hipotético pressupõe uma distribuição perfeita e ignora todos os restantes fatores. As máquinas continuam a executar doze minutos de trabalho no total.
Acrescente-se agora um minuto de preparação para cada máquina. A versão com quatro máquinas demora quatro minutos a concluir e consome dezasseis minutos de executor. A versão com uma máquina demora treze minutos e consome treze minutos de executor. O tempo de espera melhora bastante, enquanto aumenta o consumo total das máquinas. Os custos efetivos também dependem dos tipos de executor, dos preços e das regras de faturação.
Esta distinção importa quando um painel apresenta com orgulho uma barra verde mais curta. Ao comprar capacidade de processamento em paralelo, o gestor está a pagar para obter feedback mais cedo, possivelmente a um custo adicional. Pode ser uma excelente troca se eliminar um constrangimento real. É mais difícil de justificar quando a alteração concluída fica depois horas à espera de um revisor disponível.
A análise deve ir além de uma única execução da CI. Uma correção que exige revisões repetidas, novas execuções e uma segunda ronda de revisão pode consumir muito mais trabalho do que sugere a execução individual mais rápida. Conte as tentativas necessárias para aceitar uma alteração, incluindo as abandonadas. Caso contrário, um fluxo de integração aparentemente eficiente pode ocultar um processo de desenvolvimento dispendioso.
Nem todos os minutos de espera representam o mesmo custo de mão de obra. Um programador que comece outra tarefa útil enquanto decorrem as verificações não perdeu necessariamente todo esse tempo. As interrupções repetidas e a necessidade de voltar a um trabalho inacabado podem, ainda assim, prejudicar. Para medir esses efeitos, é preciso observar a forma como a equipa trabalha, em vez de multiplicar os minutos decorridos pelos salários.
A investigação aponta para um quadro misto
A análise da DORA, publicada em março de 2026, apresenta dois conjuntos de provas distintos. A investigação de 2025 associou uma maior adoção da IA tanto a uma maior produtividade na entrega de software como a uma maior instabilidade. Separadamente, investigadores analisaram 1110 respostas abertas de engenheiros da Google, recolhidas no terceiro trimestre de 2025. Os engenheiros descreveram a ajuda na redação e noutras tarefas, bem como o esforço adicional de verificação. O estudo qualitativo interno não corresponde à população abrangida pela associação mais ampla da DORA, e nenhum dos dois demonstra que a IA tenha causado problemas nas versões lançadas por uma equipa específica. Análise e metodologia da DORA.
Há também provas experimentais mais sólidas, mas com âmbito mais restrito. No estudo aleatorizado de julho de 2025 da METR, foram atribuídas 246 tarefas a 16 programadores experientes de projetos de código aberto que trabalhavam em repositórios familiares. Com ferramentas de IA do início de 2025, demoraram mais 19% a concluir as tarefas. Apesar disso, os participantes acreditavam que a IA os tinha ajudado a trabalhar mais depressa. A conclusão diz respeito a esses programadores, tarefas e ferramentas; não determina o valor de todos os agentes de programação disponíveis atualmente. Experiência original da METR.
Em fevereiro de 2026, a METR afirmou que o estudo de seguimento produziu uma estimativa pouco fiável dos efeitos atuais na produtividade. Cada vez mais, os programadores recusavam trabalho sem IA ou escolhiam que tarefas submeter; além disso, a utilização de agentes em paralelo complicava a medição do tempo. Os investigadores consideraram plausível uma maior aceleração, mas disseram que os dados só forneciam provas fracas sobre a sua dimensão. Repetir a antiga conclusão de abrandamento sem esta ressalva induziria os leitores em erro. Estudo de seguimento da METR.
Para um gestor, estes estudos justificam uma abordagem prática: manter as ferramentas úteis, analisar os seus efeitos e evitar transformar o entusiasmo ou o ceticismo numa fórmula universal para gerir pessoal. Uma equipa pode beneficiar bastante num tipo de trabalho e perder tempo noutro. O seu processo de entrega tem de revelar essa diferença.
Dê a cada constrangimento uma resposta própria
Antes de comprar mais capacidade de CI, acompanhe uma alteração desde a primeira correção proposta até à produção. Separe o trabalho que está a decorrer do que está à espera. Identifique a verificação que realmente atrasa uma decisão, o revisor de que depende a atenção e as condições de lançamento que ainda têm de ser cumpridas.
Basta, muitas vezes, um registo simples dos tempos para detetar um investimento mal direcionado. Se a maior parte do atraso ocorrer antes do início da revisão, reduzir alguns segundos aos testes não resolverá o problema. Se os revisores tiverem de esperar repetidamente por uma verificação obrigatória demorada, melhorá-la terá uma finalidade direta. Se as falhas ocorrerem sobretudo depois da implementação, a equipa precisa de analisar o que os testes não detetam.
A colocação de dependências em cache mostra por que razão uma otimização conhecida exige medição. A documentação do GitHub descreve a cache como uma forma de reutilizar ficheiros cuja recriação em executores limpos é dispendiosa. Também diz que as tarefas têm de conseguir recriar ou descarregar esses ficheiros quando a cache não está disponível. Por isso, o comportamento da cache deve ser avaliado tanto quando há correspondência como quando não há. Documentação do GitHub sobre a cache de dependências.
Para o gestor, a questão útil é saber quão previsível se torna o feedback. Uma média excelente pode coexistir com esperas ocasionais suficientemente longas para perturbar uma versão. Acompanhe a cauda mais lenta da distribuição e distinga uma falha legítima nos testes de uma falha de descarregamento ou de um executor sem capacidade. Cada problema exige uma resposta diferente.
Um feedback fiável e rápido permite que as pessoas e os agentes corrijam erros mais cedo. Melhorar essa infraestrutura partilhada pode beneficiar muitos tipos de desenvolvimento, incluindo alterações escritas sem IA. Isso dá aos gestores motivos para a financiar mesmo que mudem as ferramentas de programação escolhidas.
Testes mais rápidos continuam a ter de detetar erros
Algumas alterações de desempenho modificam as condições em que um teste é executado. Isso exige mais escrutínio do que simplesmente usar um processador mais rápido.
O Vitest, uma ferramenta de testes para JavaScript e TypeScript, isola por predefinição os ficheiros de teste para impedir que o estado de um ficheiro afete outro. A documentação descreve a desativação seletiva do isolamento para testes adequados e identifica o estado mutável dos módulos, as variáveis globais alteradas e outras dependências como motivos para o manter. Uma definição que reduz o tempo de preparação pode, assim, alterar uma fronteira de correção. Orientações do Vitest sobre isolamento.
A Linear optou por permitir partilha de estado de forma explícita, acrescentou rotinas de limpeza e manteve o isolamento nos ficheiros que não podia alterar em segurança. O ganho de desempenho dependeu de decidir que testes podiam partilhar esse ambiente sem riscos. Implementação da Linear.
Há outro desafio quando um agente escreve tanto uma alteração como os respetivos testes. Considere-se uma regra hipotética de descontos que se aplica apenas a subscrições anuais. O agente poderia implementá-la por engano também para planos mensais e, depois, escrever testes que confirmassem a sua própria interpretação. A aprovação desses testes demonstraria coerência com o erro.
Um revisor precisa de provas baseadas em elementos externos a essa implementação: o requisito acordado, exemplos do comportamento pretendido e casos que devem falhar. Pedir ao agente mais testes pode ajudar, mas uma quantidade maior de testes não demonstra, por si só, que se tenha contestado uma interpretação errada do requisito. Cabe à pessoa decidir o que o software deve fazer e se as provas respondem a essa questão.
As equipas que recompensam o volume de testes sem analisar o que demonstram arriscam-se a dar aos revisores mais material e menos confiança. O gestor deve reservar tempo para essa análise ao atribuir o trabalho, em vez de a tratar como um atraso inexplicável depois de o agente terminar.
Meça a alteração que chega aos clientes
As métricas de entrega da DORA oferecem uma verificação útil a jusante. Incluem o tempo entre a integração do código e a entrada em produção, a frequência das implementações, a recuperação após uma implementação falhada, a proporção de implementações que exigem uma intervenção imediata e a proporção correspondente a retrabalho não planeado relacionado com incidentes. Descrevem resultados de entrega que vão além de um teste aprovado. Definições de métricas da DORA.
Para uma equipa que analisa o seu fluxo de programação com IA, associaríamos esses resultados a um pequeno registo de diagnóstico:
- Feedback: tempo decorrido até às verificações obrigatórias, incluindo execuções lentas e esperas por capacidade.
- Consumo: trabalho total dos executores e tentativas repetidas associadas a uma alteração aceite.
- Revisão: tempo à espera de atenção, revisões substanciais pedidas e motivo de cada revisão.
- Impacto no cliente: se a alteração publicada produziu o comportamento pretendido e exigiu trabalho corretivo.
Use o registo para analisar um fluxo de trabalho específico. Uma pequena alteração à documentação e uma migração de base de dados não são unidades de produtividade equivalentes. Sempre que possível, compare trabalho semelhante ao longo do tempo e registe outras mudanças, como um novo fornecedor de executores ou um processo de lançamento revisto. Uma melhoria que coincida com a adoção de IA não demonstra que esta foi a sua causa.
Os gestores podem então fazer uma escolha concreta: financiar o constrangimento que impede alterações úteis de chegarem aos clientes com confiança suficiente. Por vezes, isso significa mais capacidade de computação. Noutros casos, significa requisitos mais claros, testes melhores ou tempo de revisão suficiente para compreender as propostas que já estão a chegar.