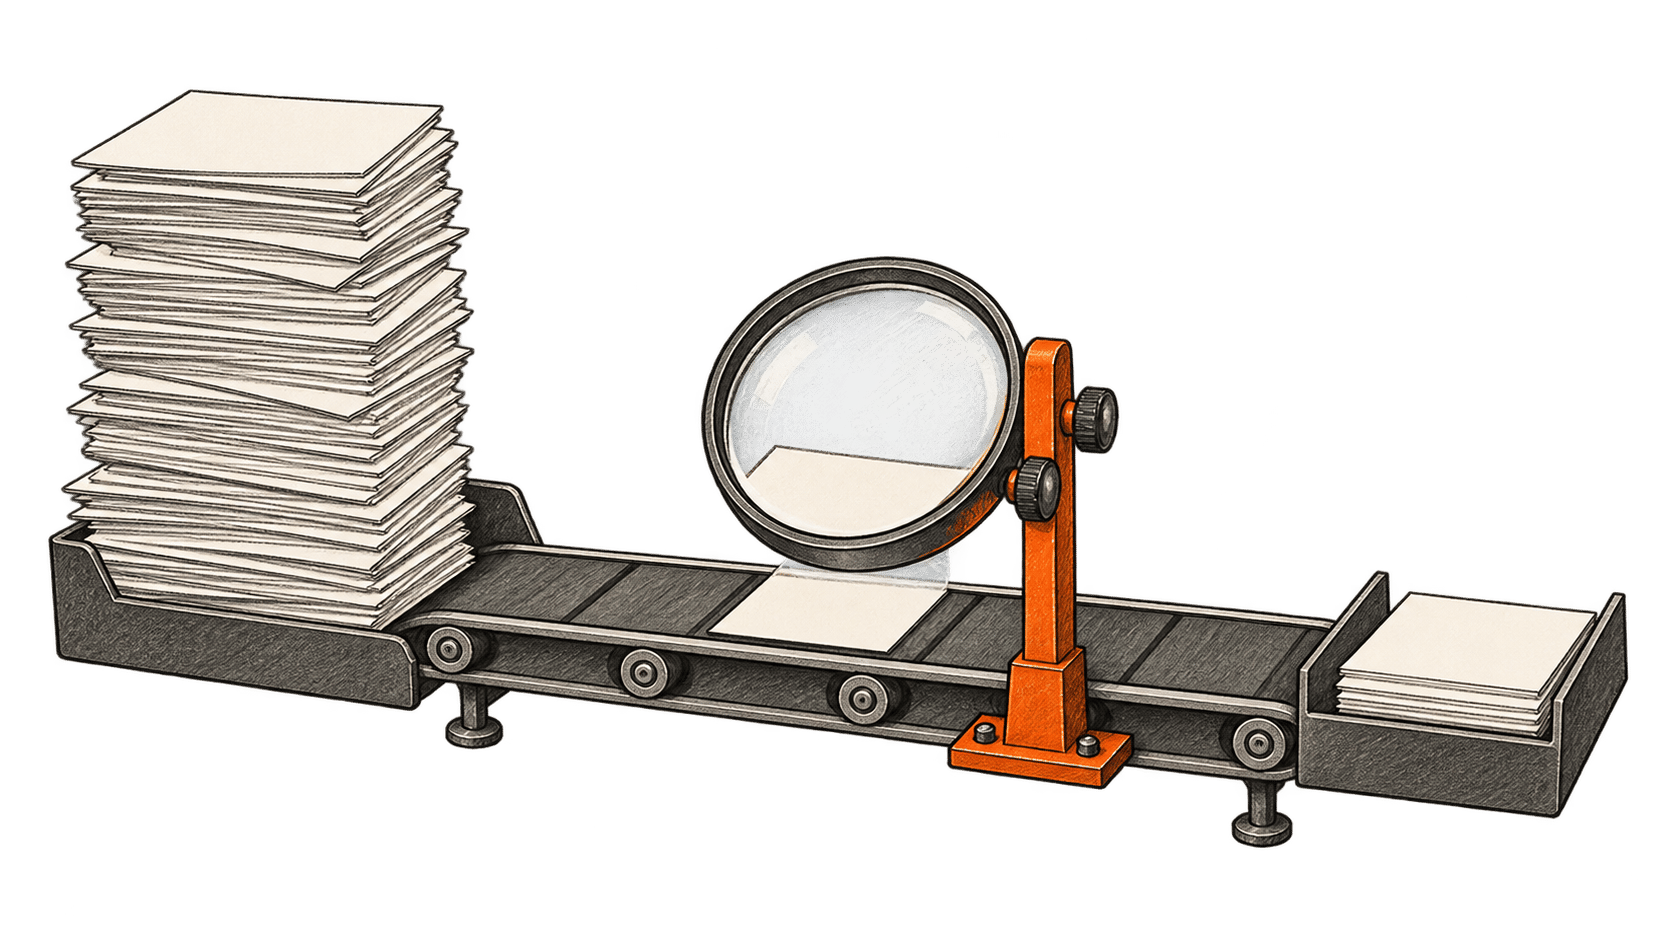
Um agente de programação com IA pode terminar um patch enquanto as verificações do patch anterior ainda estão em execução. Para um gestor de engenharia, isso cria uma distinção incômoda: a equipe produziu mais código, mas o cliente ainda não recebeu nada.
A Linear oferece um caso útil. Em um relato de engenharia publicado em 21 de setembro, Mufeez Amjad informa que suas suítes de testes quase quadruplicaram desde o início de 2026, enquanto a espera por pull requests na integração contínua caiu de mais de seis minutos para pouco mais de cinco. O tempo de execução por teste caiu aproximadamente pela metade. Essas são melhorias distintas; o último número não significa que a conta total de CI caiu pela metade. A Linear atribui a agentes de programação o aumento da pressão sobre a validação, mas seu relato não é um experimento controlado que comprove o efeito da IA na produtividade. Relato de engenharia da Linear.
A integração contínua, ou CI, executa verificações automatizadas em mudanças de software propostas. Ela fica entre um patch plausível e uma alteração que a equipe está disposta a aceitar. Quando a programação com IA aumenta o volume de patches, essa capacidade de verificação se torna uma questão de negócio: quanto trabalho útil a organização consegue absorver com segurança?
Na nossa avaliação, os gestores devem acompanhar juntos três resultados: o tempo até obter um feedback confiável, o volume total de computação e a confiabilidade das mudanças lançadas. Uma resposta mais rápida só tem valor se a equipe entender o que ela comprova.
A espera pode diminuir e o trabalho aumentar
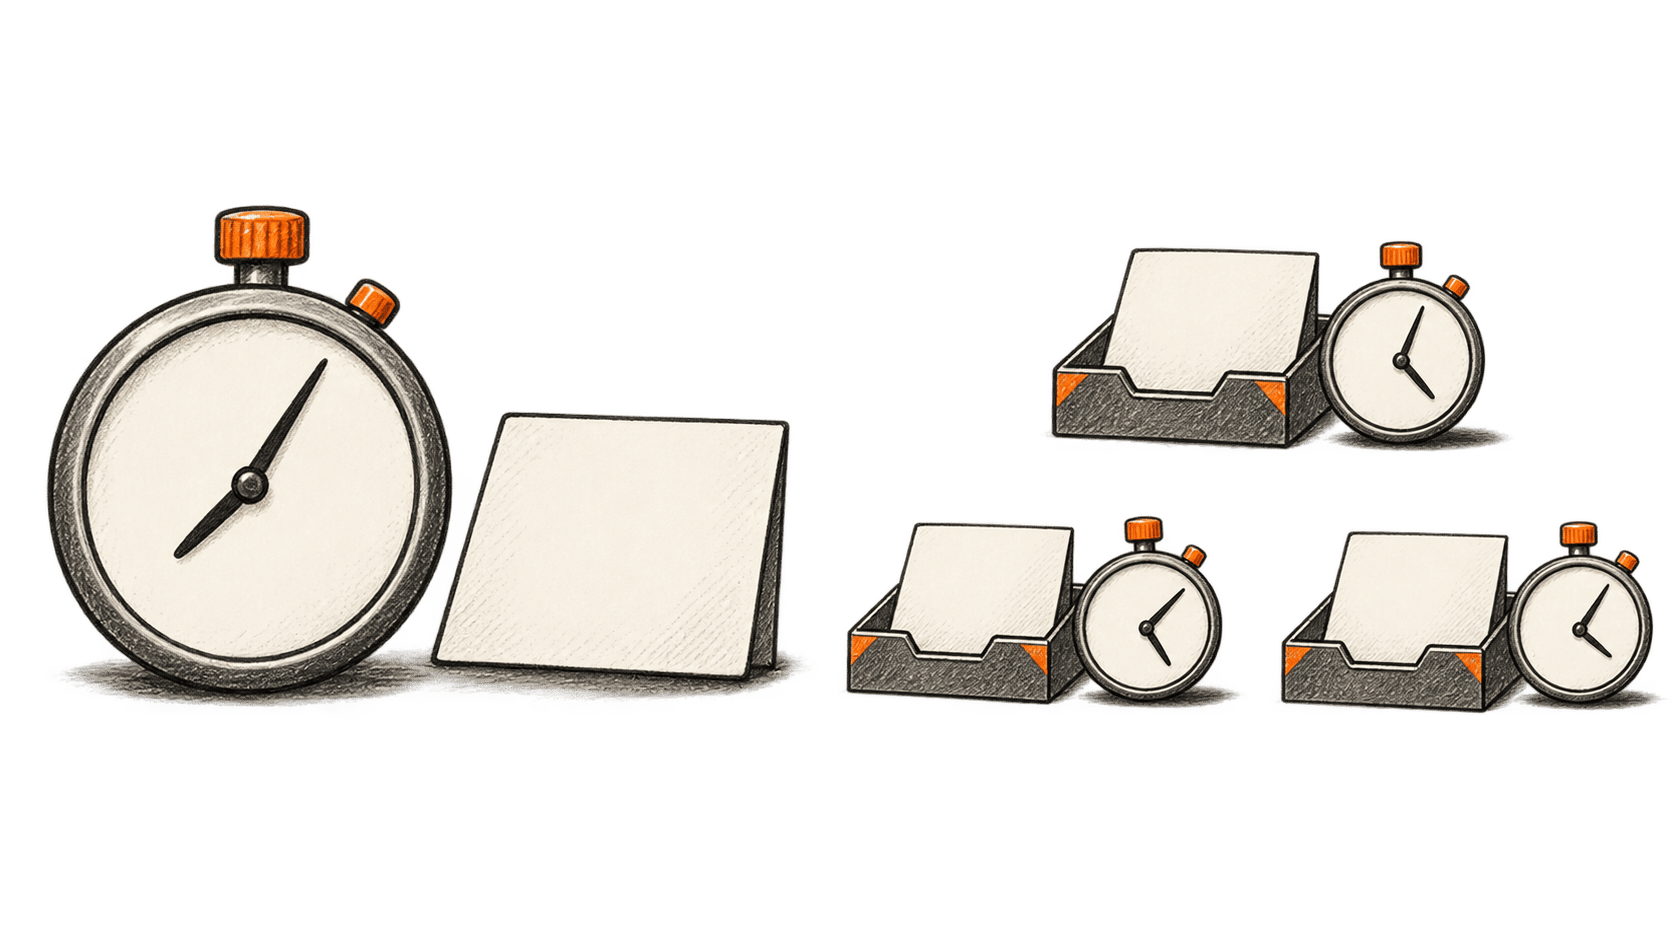
Imagine uma suíte de testes que exige doze minutos de trabalho em uma máquina. Dividi-la igualmente entre quatro máquinas poderia concluir esse trabalho em três minutos. Esse exemplo hipotético pressupõe uma distribuição perfeita e ignora todo o restante. No total, as máquinas ainda trabalham por doze minutos.
Agora, considere um minuto de preparação para cada máquina. A versão com quatro máquinas leva quatro minutos para terminar e consome dezesseis minutos de executor. A versão com uma máquina leva treze minutos e consome treze minutos de executor. O tempo de espera melhora bastante enquanto o consumo agregado das máquinas aumenta. O custo real também depende dos tipos de executor, dos preços e das regras de cobrança.
Essa distinção importa quando um painel comemora uma barra verde mais curta. Ao comprar capacidade paralela, o gestor está pagando por um feedback antecipado, possivelmente a um custo adicional. Pode ser uma ótima escolha se eliminar uma restrição real. É mais difícil justificá-la quando a mudança concluída ainda passa horas aguardando um revisor disponível.
A unidade de análise deve ir além de uma única execução da CI. Um patch que provoca revisões repetidas, novas execuções e uma segunda rodada de análise pode consumir muito mais trabalho do que indica sua execução individual mais rápida. Conte as tentativas necessárias para aceitar uma mudança, inclusive as abandonadas. Caso contrário, um fluxo aparentemente eficiente pode esconder um processo de desenvolvimento caro.
Nem todo minuto de espera equivale a um minuto de custo de mão de obra. Um desenvolvedor que começa outra tarefa útil enquanto os testes rodam não necessariamente perdeu todo esse intervalo. Interrupções repetidas e a necessidade de voltar a um trabalho inacabado ainda podem prejudicar. Para medir esses efeitos, é preciso observar o modo de trabalho da equipe, em vez de multiplicar os minutos transcorridos pelos salários.
As pesquisas mostram um quadro misto
A análise da DORA, publicada em março de 2026, relata dois conjuntos distintos de evidências. A pesquisa de 2025 associou maior adoção de IA tanto a mais volume de entrega de software quanto a maior instabilidade. Em separado, pesquisadores analisaram 1.110 respostas abertas de engenheiros do Google, coletadas no terceiro trimestre de 2025. Os engenheiros relataram ajuda na elaboração de rascunhos e em outras tarefas, mas também mais trabalho de verificação. Esse estudo qualitativo interno não é a população por trás da associação mais ampla da DORA, e nenhum dos dois comprova que a IA causou problemas nos lançamentos de uma equipe específica. Análise e metodologia da DORA.
Também há evidências experimentais mais robustas, porém de escopo mais restrito. Em um estudo randomizado publicado em julho de 2025, a METR distribuiu 246 tarefas entre 16 desenvolvedores experientes de código aberto que trabalhavam em repositórios que já conheciam. Com as ferramentas de IA do início de 2025, os participantes levaram 19% mais tempo para concluir as tarefas. Mesmo assim, acreditavam que a IA os havia ajudado a trabalhar mais rápido. Essa conclusão diz respeito àqueles desenvolvedores, tarefas e ferramentas; ela não determina o valor de todos os agentes de programação disponíveis hoje. Experimento original da METR.
Em fevereiro de 2026, a METR informou que seu estudo de acompanhamento produziu uma estimativa pouco confiável dos efeitos atuais na produtividade. Os desenvolvedores passaram a recusar com mais frequência trabalhos sem IA ou a escolher quais tarefas enviar; agentes simultâneos também dificultaram a medição do tempo. Os pesquisadores consideraram plausível uma aceleração maior, mas disseram que os dados ofereciam poucas evidências sobre sua dimensão. Repetir o antigo resultado de desaceleração sem essa ressalva induziria os leitores ao erro. Estudo de acompanhamento da METR.
Para um gestor, esses estudos justificam uma postura prática: mantenha as ferramentas úteis, investigue seus efeitos e resista a transformar tanto o entusiasmo quanto o ceticismo em uma fórmula universal de dimensionamento da equipe. Uma equipe pode ganhar muito tempo em uma categoria de trabalho e perdê-lo em outra. O processo de entrega precisa revelar essa diferença.
Dê a cada restrição uma solução própria
Antes de comprar mais capacidade de CI, acompanhe uma mudança desde o primeiro patch proposto até a produção. Separe o trabalho em execução daquele que está aguardando. Identifique qual verificação realmente atrasa uma decisão, de quem depende a revisão e quais condições ainda precisam ser cumpridas antes do lançamento.
Um registro simples de tempo costuma bastar para revelar um investimento equivocado. Se a maior parte do atraso ocorre antes do início da revisão, reduzir segundos nos testes não resolverá o problema. Se os revisores esperam repetidamente por uma verificação longa e obrigatória, melhorá-la tem um propósito direto. Se as falhas surgem sobretudo após a implantação, a equipe precisa examinar o que as validações deixam passar.
O cache de dependências ilustra por que uma otimização conhecida precisa ser medida. A documentação do GitHub descreve o cache como uma forma de reutilizar arquivos que custam caro para recriar em executores limpos. Ela também diz que os trabalhos devem conseguir recriar ou baixar esses arquivos quando o cache não estiver disponível. Portanto, o comportamento do cache deve ser avaliado tanto em casos de acerto quanto de falha. Documentação do GitHub sobre cache de dependências.
Para o gestor, a pergunta útil é quão previsível o feedback se torna. Uma ótima média pode coexistir com esperas ocasionais longas o bastante para interromper um lançamento. Acompanhe a cauda mais lenta da distribuição e diferencie uma falha legítima no teste de um download malsucedido ou de um executor esgotado. Cada situação exige uma resposta diferente.
Um feedback confiável e rápido dá às pessoas e aos agentes uma oportunidade mais cedo para corrigir erros. Melhorar essa infraestrutura compartilhada pode beneficiar muitos tipos de desenvolvimento, inclusive mudanças escritas sem IA. Isso dá aos gestores um motivo para financiá-la mesmo que as ferramentas de programação escolhidas mudem.
Testes mais rápidos ainda precisam detectar erros
Algumas mudanças de desempenho alteram as condições em que um teste é executado. Isso exige mais atenção do que simplesmente trocar por um processador mais rápido.
O Vitest, uma ferramenta de testes para JavaScript e TypeScript, isola por padrão os arquivos de teste para impedir que o estado de um arquivo afete outro. Sua documentação descreve como desativar seletivamente o isolamento em testes apropriados e também aponta o estado mutável de módulos, variáveis globais modificadas e outras dependências como motivos para mantê-lo. Assim, uma configuração que reduz o tempo de preparação também pode alterar os limites de correção do teste. Orientações do Vitest sobre isolamento.
A Linear adotou uma abordagem opcional para o compartilhamento de estado, acrescentou rotinas de limpeza e manteve o isolamento nos arquivos que não era seguro migrar. Seu ganho de desempenho dependeu de decidir quais testes poderiam compartilhar esse ambiente com segurança. Implementação da Linear.
Há um desafio distinto quando um agente escreve tanto uma alteração quanto os testes dela. Imagine uma regra hipotética de desconto válida apenas para assinaturas anuais. O agente poderia implementá-la por engano também nos planos mensais e, em seguida, escrever testes que confirmassem sua própria interpretação. A aprovação nesses testes demonstraria apenas consistência com o erro.
O revisor precisa de evidências independentes daquela implementação: o requisito acordado, exemplos do comportamento pretendido e casos que deveriam falhar. Pedir mais testes a um agente pode ajudar, mas aumentar a quantidade de testes, por si só, não demonstra que uma interpretação equivocada do requisito foi questionada. Cabe às pessoas decidir o que o software deve fazer e se as evidências respondem a essa pergunta.
Equipes que recompensam o volume de testes sem analisar o que eles comprovam correm o risco de dar aos revisores mais material e menos confiança. Ao atribuir o trabalho, o gestor deve reservar tempo para essa análise em vez de tratá-la como um atraso inexplicado após o agente terminar.
Meça a mudança que chega aos clientes
As métricas de entrega da DORA oferecem uma verificação útil posterior. Elas incluem o tempo entre o commit do código e a entrada em produção, a frequência de implantação, o tempo de recuperação após uma implantação malsucedida, a proporção de implantações que exige intervenção imediata e a proporção de retrabalho não planejado relacionado a incidentes. Esses indicadores descrevem resultados de entrega que vão além de uma execução de testes aprovada. Definições das métricas da DORA.
Para uma equipe que investiga seu fluxo de trabalho de programação com IA, combinaríamos esses resultados com um pequeno registro de diagnóstico:
- Feedback: tempo transcorrido até a conclusão das verificações obrigatórias, incluindo execuções lentas e espera por capacidade.
- Consumo: trabalho agregado dos executores e tentativas repetidas associadas a uma mudança aceita.
- Revisão: tempo de espera por atenção, revisões substanciais solicitadas e motivo de cada uma.
- Impacto para o cliente: se a mudança lançada produziu o comportamento pretendido e exigiu trabalho corretivo.
Use o registro para investigar um fluxo específico. Uma pequena alteração na documentação e uma migração de banco de dados não são unidades de produtividade equivalentes. Sempre que possível, compare trabalhos semelhantes ao longo do tempo e registre outras mudanças, como a adoção de outro provedor de executores ou um processo de lançamento revisado. Uma melhoria simultânea à adoção de IA não comprova que ela foi a causa.
Os gestores podem então fazer uma escolha concreta: financiar a restrição que impede mudanças úteis de chegar aos clientes com um grau adequado de confiança. Às vezes isso exigirá mais capacidade computacional. Em outras situações, serão necessários requisitos mais claros, testes melhores ou tempo suficiente de revisão por pessoas experientes para entender as propostas que já estão chegando.