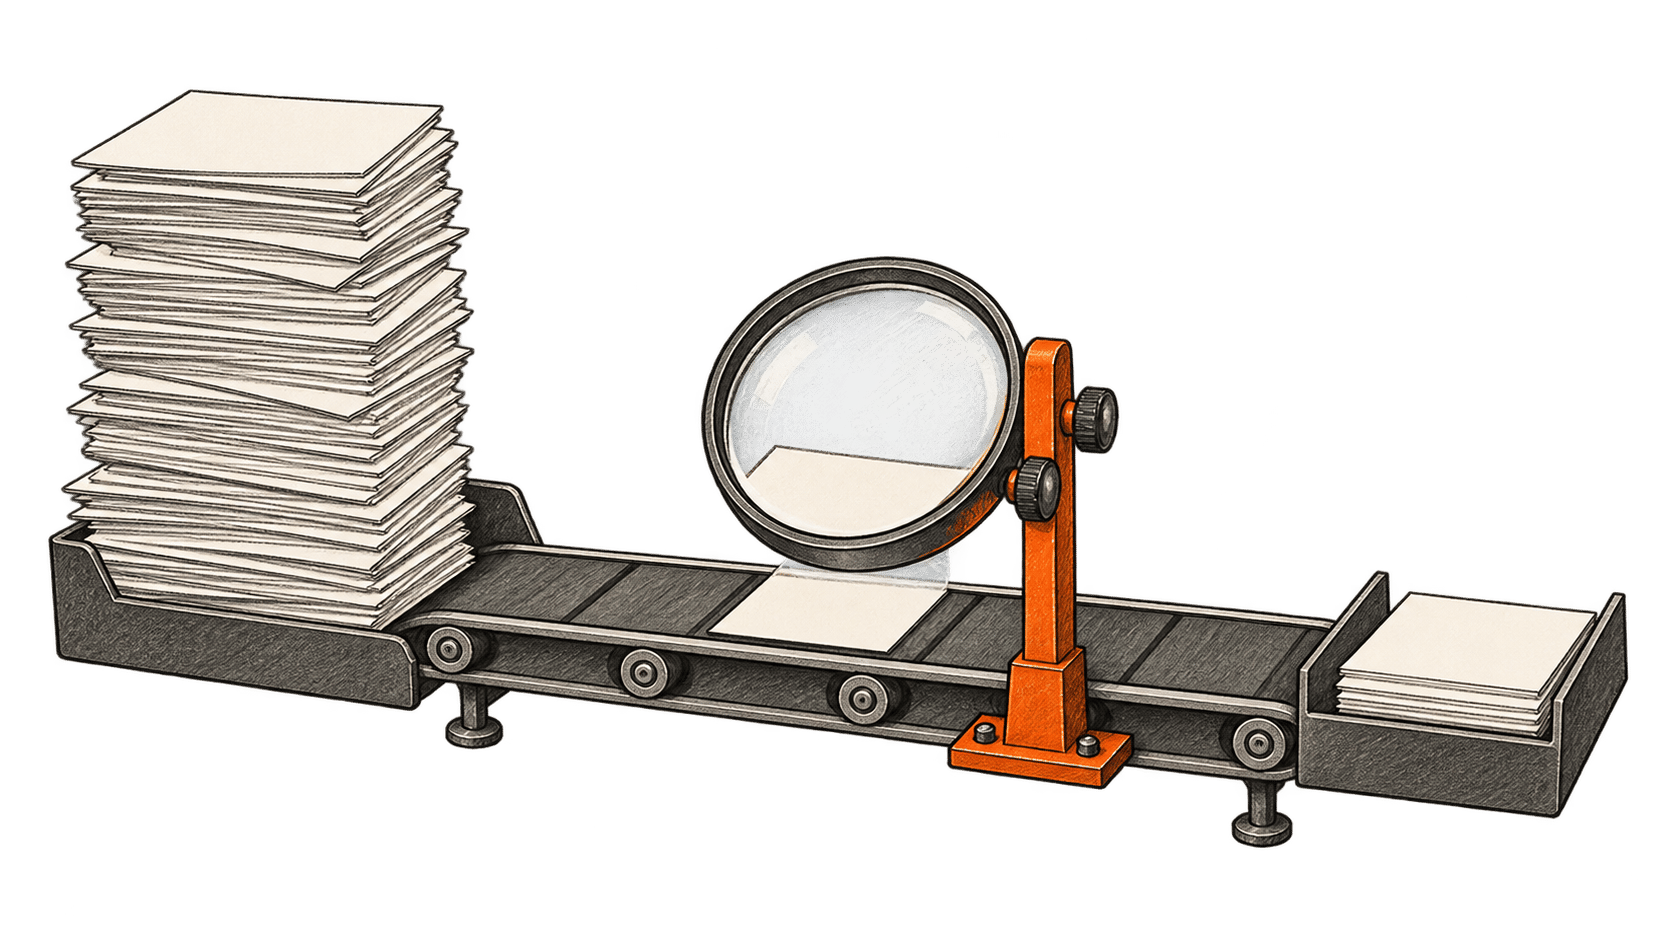
AI 程式碼代理可能已經完成一個修補程式,但上一個修補程式的檢查還在執行。對工程主管而言,這會形成一個棘手落差:團隊寫出了更多程式碼,顧客卻還沒有收到任何成果。
Linear 提供了一個值得參考的案例。工程師 Mufeez Amjad 在 9 月 21 日發布的工程實務文章中指出,從 2026 年初至今,Linear 的測試套件數量近乎增加四倍,但拉取要求等待持續整合(CI)的時間,從六分鐘以上縮短至略多於五分鐘。每項測試的執行器時間大約減半。這是不同的改善;最後一項數據不代表 CI 總帳單也減半。Linear 將驗證工作的壓力增加歸因於代理輔助開發,但該文並非用來證明 AI 生產力效果的受控實驗。Linear 的工程實務文章。
持續整合(CI)會對提議中的軟體變更執行自動檢查,是從「修補程式看似可行」到「團隊願意接受」之間的重要關卡。AI 程式碼開發增加修補程式的供應量後,檢查能力就成了企業必須面對的問題:組織能安全吸收多少有用工作?
我們認為,主管應同步掌握三種結果:取得可信回饋所需的時間、總運算工作量,以及發布變更的可靠性。更快得到答案固然有價值,但前提是團隊清楚了解這個答案究竟證明了什麼。
縮短等待時間,可能代表做了更多工作
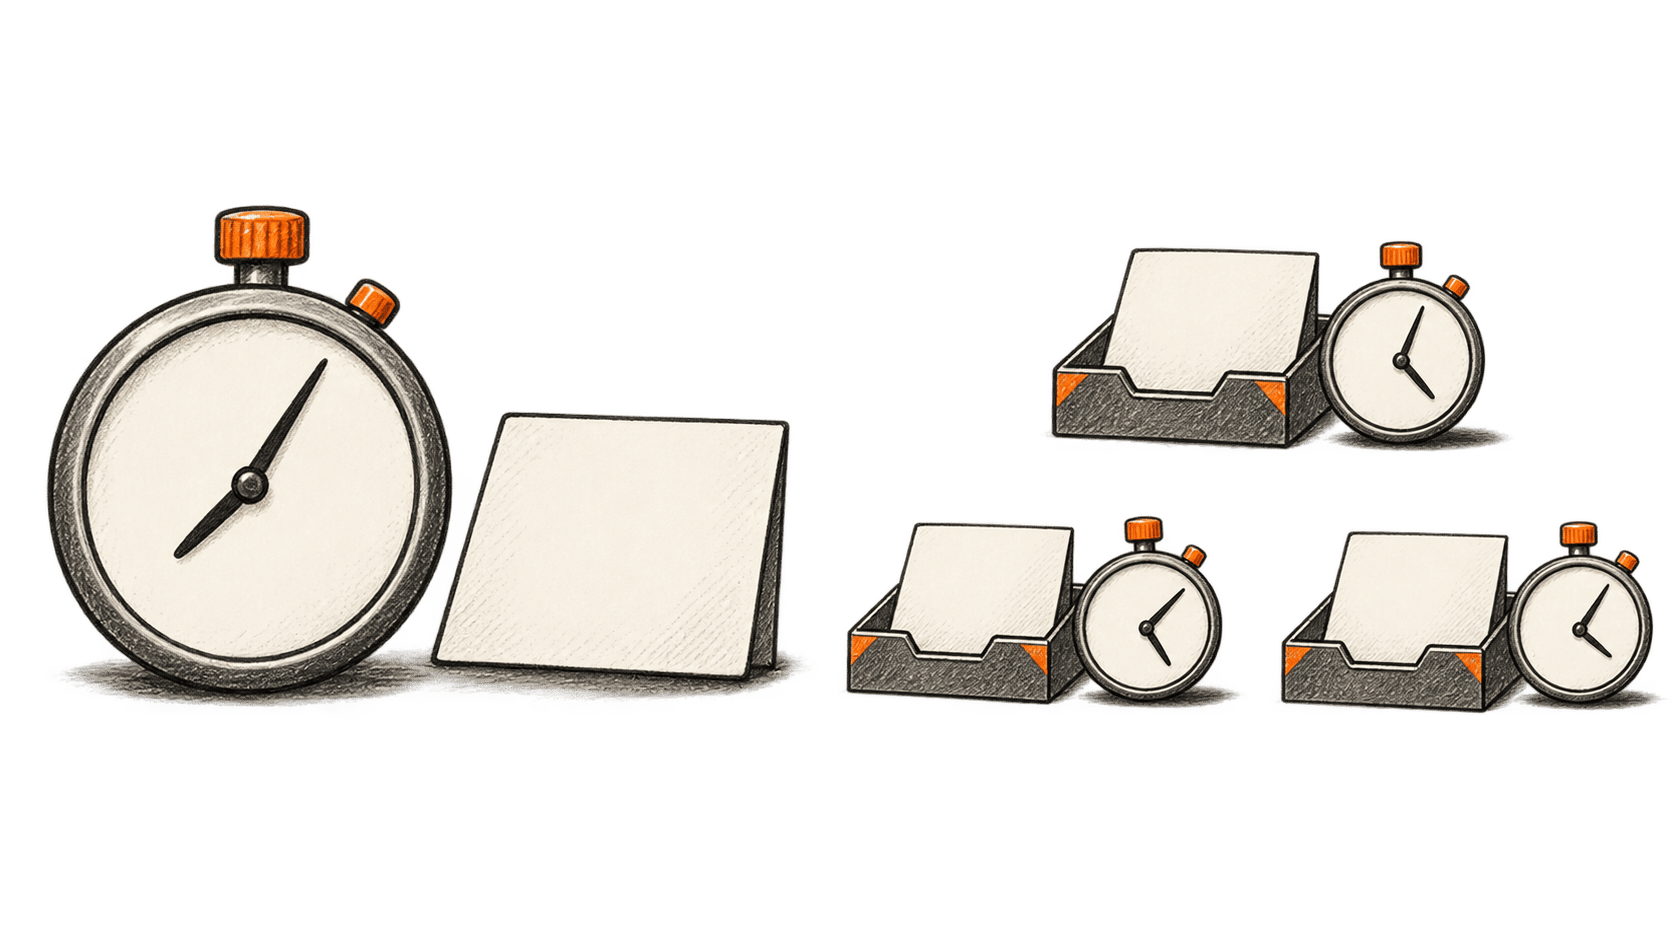
假設一套測試在單一機器上需要執行十二分鐘。若將工作平均拆給四台機器,理想情況下三分鐘就能完成。這個假設忽略所有其他因素,也假定工作能完美平衡;四台機器實際執行的總工作量仍是十二分鐘。
再假設每台機器都需要一分鐘準備時間。四台機器的版本會在四分鐘後完成,總共消耗十六個執行器分鐘;單機版本則需十三分鐘,消耗十三個執行器分鐘。等待時間大幅縮短,但機器總用量增加。實際費用還取決於執行器類型、價格與計費規則。
當儀表板以一條縮短的綠色進度條慶祝改善時,這項差異就很重要。主管添購平行運算能力,買到的是提早取得回饋的機會,也可能付出額外成本。若它能解除真正的瓶頸,這筆交換可能非常值得;但若完成的變更接著還要等上好幾個小時才有審查者處理,就較難說明這項投資的合理性。
分析單位不應只限於單次 CI 執行。一個修補程式若觸發多次修訂、重跑,以及第二輪審查,所耗費的總工作可能遠高於它最快一次執行所顯示的數字。應統計變更獲准前需要嘗試幾次,也包括最後放棄的嘗試。否則,看似有效率的管線可能掩蓋昂貴的開發流程。
等待的每一分鐘也不等於同樣的人工成本。開發者在檢查執行時開始另一項有用工作,不代表整段時間都浪費了。但反覆受到打斷、再回頭接續未完成工作,仍可能造成負擔。要衡量這些影響,必須觀察團隊實際如何工作,而不是把經過的分鐘數乘上薪資。
研究呈現的結果並不單一
DORA 在 2026 年 3 月的分析,整理了兩類不同證據。其 2025 年研究發現,AI 採用率提高與軟體交付吞吐量增加、交付不穩定性上升兩者都有關聯。另一方面,研究者分析 Google 工程師在 2025 年第三季提交的 1,110 份開放式回覆;工程師提到 AI 協助起草與執行其他任務,同時也帶來驗證工作的額外負擔。這項 Google 內部質性研究,並非 DORA 整體關聯分析所涵蓋的同一批對象;兩者都無法證明 AI 導致了某支團隊的特定發布問題。DORA 的分析與研究方法。
此外,也有範圍較窄、但實驗設計更嚴謹的證據。METR 在 2025 年 7 月進行隨機分派研究,讓 246 項任務由 16 位資深開源開發者在熟悉的程式碼庫中完成。允許使用 2025 年初期的 AI 工具後,任務完成時間反而增加 19%。儘管如此,參與者仍認為 AI 幫助他們加快工作。這項結果只適用於該研究中的開發者、任務與工具,無法判斷目前所有程式碼代理的價值。METR 原始實驗。
2026 年 2 月,METR 表示後續研究無法可靠估算目前的生產力影響。開發者愈來愈常拒絕不允許使用 AI 的工作,或自行選擇要提交哪些任務;多個代理同時執行,也讓時間測量更複雜。研究者認為生產力提高的可能性增加,但現有資料對提升幅度僅提供微弱證據。若不加上這項限制說明,直接重複早期研究的效率下降數字會誤導讀者。METR 後續研究。
這些研究支持主管採取務實作法:保留有用工具、調查其影響,不要把熱情或懷疑變成適用所有情況的人力公式。團隊在某類工作上可能獲益良多,在另一類工作上則可能耗費更多時間。交付流程必須能看出這項差異。
針對每個瓶頸採取不同解方
購買更多 CI 容量前,先追蹤某項變更從第一版修補程式到正式上線的完整歷程。區分實際執行的工作與等待中的工作,找出真正延誤決策的檢查項目、必須投入時間的審查者,以及後續仍須符合的發布條件。
一份簡單的時間紀錄,往往就足以揭露錯誤的投資方向。若大部分延誤發生在審查開始前,測試快幾秒也無法解決問題;若審查者一再等候耗時的必要檢查,改善該檢查就有明確目的;若問題多半在部署後出現,團隊便應檢視現有驗證漏掉了什麼。
相依套件快取說明了為何熟悉的最佳化仍須測量。GitHub 文件指出,快取可重用在乾淨執行器上重新建立成本高昂的檔案;文件也說明,快取無法使用時,工作仍須能重新產生或下載這些檔案。因此,應同時評估快取命中與未命中的情況。GitHub 相依套件快取文件。
對主管而言,重要的是回饋時間是否更可預測。平均表現優異,仍可能伴隨足以打亂發布時程的偶發長時間等待。應追蹤耗時分布的尾端,並區分真正的測試失敗、下載失敗與執行器耗盡;不同原因需要不同處理方式。
可靠且及時的回饋,能讓人與代理都更早有機會修正錯誤。改善這套共同基礎設施,可使各類開發工作受益,包括沒有使用 AI 撰寫的變更。即使程式碼工具不斷變動,這仍是主管值得投資的理由。
測試更快,也必須確實抓出錯誤
有些效能調整會改變測試執行時的條件,這比換上更快的處理器更值得仔細檢視。
JavaScript 與 TypeScript 測試工具 Vitest 預設會隔離各測試檔案,避免一個檔案的狀態影響另一個檔案。文件說明,在適合的測試中可選擇性取消隔離,同時也列出需要保留隔離的原因,例如可變的模組狀態、遭修改的全域變數及其他相依關係。因此,縮短準備時間的設定,也可能改變正確性保障的邊界。Vitest 隔離設定指引。
Linear 採取選擇加入的共享狀態方式,加入清理機制,並保留無法安全移轉的檔案之隔離。能否提升效能,取決於先判定哪些測試可以安全地共用環境。Linear 的實作方式。
當代理同時撰寫變更和測試時,還會出現另一項挑戰。假設有一項折扣規則,只適用於年度訂閱。代理可能誤把規則套用到月繳方案,接著又撰寫一套測試來確認自己的解讀。測試通過,只能證明程式碼與這項錯誤解讀一致。
審查者需要以實作之外的依據來檢驗成果,包括雙方同意的需求、預期行為範例,以及理應失敗的情況。請代理增加測試可能有幫助,但測試數量增加本身,並不能證明有人已質疑遭誤解的需求。人仍有責任決定軟體應如何運作,以及證據是否回答了這個問題。
若團隊只獎勵測試數量,卻不檢視測試究竟證明了什麼,審查者可能收到更多材料,信心反而更低。主管應在分派工作時預留檢查時間,而不是把這件事當成代理完成後才冒出的不明延誤。
衡量真正交付給顧客的變更
DORA 的交付指標可作為檢查下游成效的參考,包括程式碼提交至正式環境所需時間、部署頻率、部署失敗後的恢復時間、需要立即介入的部署比例,以及因非預期事故而返工的部署比例。這些指標衡量的是超越測試通過與否的交付結果。DORA 指標定義。
團隊若想調查 AI 程式碼開發流程,可搭配一份精簡的診斷紀錄,一併檢視下列結果:
- 回饋:完成必要檢查所經過的時間,包括耗時較長的執行,以及等待可用容量的時間。
- 耗用:已接受變更所消耗的執行器總工作量,以及相關的重複嘗試。
- 審查:等待審查者處理的時間、要求重大修訂的次數,以及各項修訂的原因。
- 顧客影響:發布的變更是否實現預期行為,以及是否需要補救工作。
使用這份紀錄來調查特定工作流程。小型文件修改與資料庫遷移不能視為相同的生產力單位。可行時,應長期比較性質相近的工作,同時記錄執行器供應商或發布流程調整等其他變化。AI 採用期間同時出現的改善,並不能證明改善是由 AI 造成。
主管因此可以做出具體決策:為真正阻礙變更以足夠把握交付給顧客的瓶頸投入資源。有時需要更多運算容量;有時則需要更清楚的需求、更完善的測試,或足夠的資深審查時間,才能理解目前送來的提案。