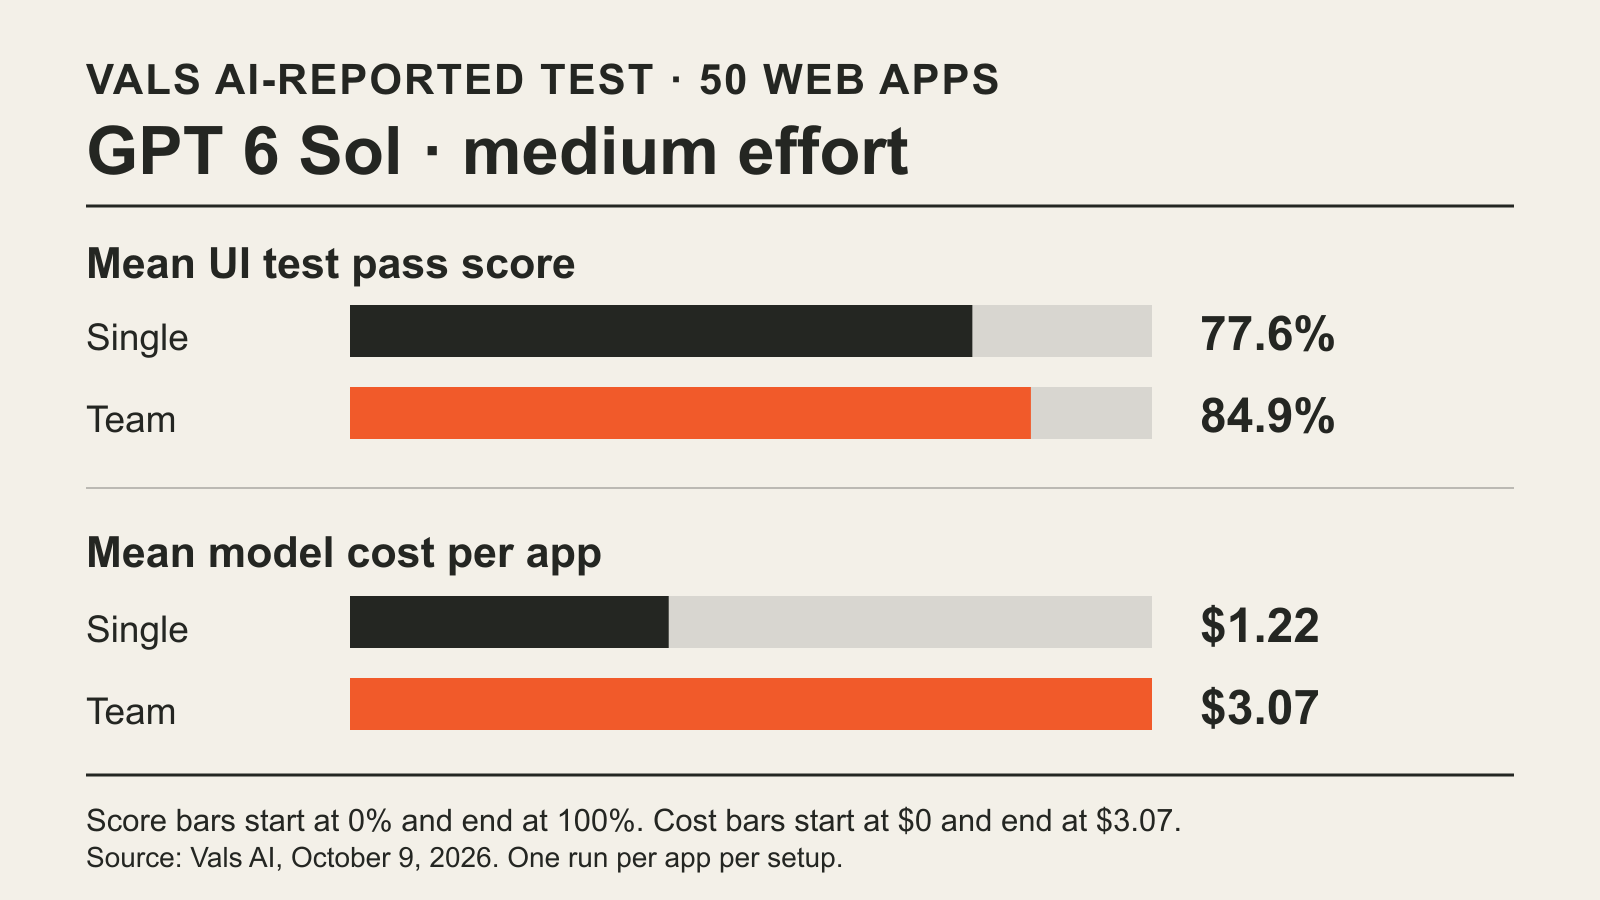
ساعد إسناد زملاء إلى وكيل برمجة في مقارنة واحدة من أربع مقارنات مقترنة في دراسة Vals AI الصادرة في 9 أكتوبر دراسة Vals AI لـ Vibe Code Bench بتاريخ 9 أكتوبر. اجتاز فريق GPT 6 Sol بجهد استدلال متوسط 84.9% من اختبارات التطبيقات في المعيار، مقابل 77.6% لوكيل Sol منفرد. وبلغ متوسط تكلفة زيادة 7.3 نقاط مئوية $3.07 بدلاً من $1.22 لكل تطبيق. وأفادت Vals بفاصل 95% من 2.3 إلى 12.4 نقطة لهذه الزيادة، وبقيمة p قدرها 0.005 للاختبار المقترن. ولم يظهر فرق دال إحصائياً في الدرجة في أي من المقارنات الثلاث الأخرى بين الفريق والوكيل المنفرد.
تقدم النتيجة للمطورين سؤالاً أدق عن الميزانية من مجرد التساؤل عما إذا كانت الفرق «أفضل». ففي مجموعة إنشاء تطبيقات الويب هذه، حقق Sol بجهد متوسط تحسناً قابلاً للقياس في الجودة مقابل نحو $1.85 إضافية لكل تطبيق، مع زمن وسيط يكاد يكون مماثلاً. أما الجهد الأعلى، وClaude Opus 5.5 عند مستويي الجهد كليهما، فلم يثبت أن الإنفاق الإضافي على الفريق حسّن الدرجة في هذا الاختبار.
التغيير الأبرز
- ما الذي تغير: قارنت Vals وكلاء البرمجة المنفردين بالفرق في مهام تطبيقات الويب الخمسين نفسها وعند مستويين للاستدلال. وكان Sol بجهد متوسط وحده هو الذي حقق زيادة فريقية ذات دلالة إحصائية في الدرجة.
- لماذا يهم ذلك: كلف إعداد الفريق الفائز 2.5 مرة أكثر لكل تطبيق؛ أما الفرق الأخرى فكلفت من 1.8 إلى 5.1 مرة أكثر من دون مكسب دال في الدرجة. وينبغي أن يدخل تصميم الفريق وإعدادات النموذج في قرار شراء واحد.
- ما الذي ينبغي متابعته: قد تكشف عمليات التشغيل المتكررة والاختبارات على مهام برمجية أخرى ما إذا كان المكسب موثوقاً خارج هذه التطبيقات المحددة. وقد شغلت الدراسة كل إعداد مرة واحدة فقط.
ما الذي قاسَته عمليات التشغيل الثماني
طلبت Vals من GPT 6 Sol وClaude Opus 5.5 إنشاء 50 تطبيق ويب كاملاً استناداً إلى مواصفات المنتجات. ونُشرت التطبيقات باستخدام Docker Compose، ثم قيّمتها وكلاء متصفح نفذت اختبارات واجهة المستخدم. والدرجة المنشورة هي متوسط حصة الاختبارات التي اجتازها كل تطبيق. منهجية المعيار تذكر أن مواصفات كل تطبيق تتضمن من 20 إلى 60 اختباراً آلياً، وأن الاختبار الفردي يُعد ناجحاً إذا نجح ما لا يقل عن 90% من خطواته.
لكل نموذج، قارنت Vals وكيلاً منفرداً بقائد يمكنه تفويض العمل بالتزامن إلى خمسة وكلاء فرعيين كحد أقصى، عند جهدي الاستدلال المتوسط والأقصى. كما تلقى القادة توجيهاً إضافياً لتقسيم العمل وتفويضه ودمجه والتحقق منه. وظل موجه المهمة وبيئة العزل والمقيّم ثابتة داخل كل مقارنة نموذجية. وأنشأ كل واحد من الإعدادات الثمانية التطبيقات الخمسين مرة واحدة.
النموذج والجهد | الدرجة المنفردة | درجة الفريق | متوسط الكلفة لكل تطبيق: منفرد → فريق | الزمن الوسيط: منفرد → فريق |
|---|---|---|---|---|
GPT 6 Sol، متوسط | 77.6% | 84.9% | $1.22 → $3.07 | 12.4 → 11.9 دقيقة |
GPT 6 Sol، أقصى | 89.0% | 90.4% | $4.82 → $8.54 | 38.4 → 27.6 دقيقة |
Claude Opus 5.5، متوسط | 91.5% | 91.2% | $4.08 → $9.10 | 20.3 → 26.6 دقيقة |
Claude Opus 5.5، أقصى | 89.8% | 93.2% | $23.77 → $122 | 74.7 → 174.1 دقيقة |
هذه متوسطات كلفة النماذج لبناء تطبيق واحد وفق Vals، وليست أسعار اشتراك أو كلفة لكل اختبار واجهة ناجح. والأزمنة هي الوسيط للوقت الفعلي المنقضي، لذا تلخص الكلفة والمدة في كل صف جانبيْن مختلفين من عمليات التشغيل الخمسين. ويتضمن متوسط فريق Opus ذي الجهد الأقصى عملية واحدة انتهت مهلتها؛ وقدّرت Vals كلفتها بنحو $189 استناداً إلى عدد الرموز.
لماذا تعتمد النتيجة على الإعداد
قارنت Vals كل فريق بالوكيل المنفرد المطابق على التطبيقات نفسها باستخدام اختبار t مقترن. وحقق فريق Sol ذي الجهد الأقصى 1.4 نقطة، بفاصل 95% من −1.7 إلى 4.5 نقطة. أما فريق Opus ذي الجهد المتوسط فكانت درجته أقل بـ0.3 نقطة، بفاصل من −3.2 إلى 2.5؛ وحقق فريق الجهد الأقصى 3.4 نقطة، بفاصل من −1.4 إلى 8.3. وتشمل هذه الفواصل احتمال عدم وجود مكسب. وهي لا تثبت أن الفرق لا تساعد مطلقاً في هذه الإعدادات، لكن التجربة لم تثبت مكسباً.
وكان جهد الاستدلال خياراً آخر اختُبر مع Sol. فقد رفعت زيادة جهد وكيل Sol المنفرد من المتوسط إلى الأقصى درجته من 77.6% إلى 89.0%، وهو ما أفادت Vals بأنه ذو دلالة إحصائية. وكلف الوكيل المنفرد ذو الجهد الأقصى $4.82 لكل تطبيق، بوقت وسيط قدره 38.4 دقيقة، مقابل $3.07 و11.9 دقيقة للفريق ذي الجهد المتوسط. ولم يكن فرق الدرجة البالغ 4.1 نقاط بين الإعدادين دالاً إحصائياً (p = 0.08). وتتيح هذه الأرقام للمطور رؤية المفاضلة المقاسة بين السعر والوقت من دون افتراض أن إعداداً بعينه سيفوز في مشروع جديد.
اختلفت الفرق أيضاً في توزيع وقتها. وتقول Vals إن قائد Sol فوّض العمل مبكراً واختبر التطبيق المجمع بنفسه. وأنهى فريقه ذو الجهد الأقصى العمل في وسيط قدره 27.6 دقيقة، مقابل 38.4 دقيقة للوكيل المنفرد. أما قادة Opus فكانوا يميلون إلى صياغة عقد مشترك والتفويض على دفعات. وعند الجهد الأقصى استغرق الفريق وسيطاً قدره 174.1 دقيقة، مقابل 74.7 للوكيل المنفرد، وكلف نحو خمسة أمثال التكلفة لكل تطبيق. وتعزو Vals جانباً كبيراً من الفاتورة الإضافية إلى رموز الإدخال المخزنة مؤقتاً في سياقات الوكلاء الفرعيين المنفصلة.
إلى أي مدى يمكن تعميم هذه النتيجة
تعكس فواصل الدلالة الاختلاف بين التطبيقات الخمسين، لا التباين بين المحاولات المتكررة للتطبيق نفسه. وقد تغير عملية تشغيل أخرى المقارنة. كما تلقت عمليات الفرق توجيهاً إضافياً بالتفويض، لذا قاست التجربة مزيج الفريق والتعليمات. واستخدم Sol واجهة OpenAI Agents API، بينما استخدم Opus Claude Code؛ ولذلك تخلط مقارنة الدرجات بين النماذج أيضاً بين بيئات تشغيل مختلفة. وتفترض تقديرات Vals لتكلفة Sol أن استخدام الرموز المبلغ عنه يشمل الوكلاء الفرعيين، ولا تحتسب أي سعر أعلى محتمَل للطلبات التي تتجاوز عتبة السياق الطويل، إذ لم تتوفر بيانات الاستخدام على مستوى الطلب.
تدعم الدراسة قراراً محدود النطاق: عند بناء تطبيقات متكاملة مشابهة بهذه الإعدادات، أظهر فريق Sol ذي الجهد المتوسط مكسباً قابلاً للقياس بتكلفة أعلى، بينما لم تظهر الفرق الأخرى مكسباً موثوقاً في الدرجة. ولا تحسم الدراسة ما إذا كانت الفرق مجدية لقاعدة شيفرة أخرى أو نموذج مختلف أو سير عمل يقسم المهمة ويفحصها بطريقة أخرى. راجعت BIG CHANGE منشور Vals وطريقته المنشورة، لكنها لم تشغل المعيار أو تكرره.


