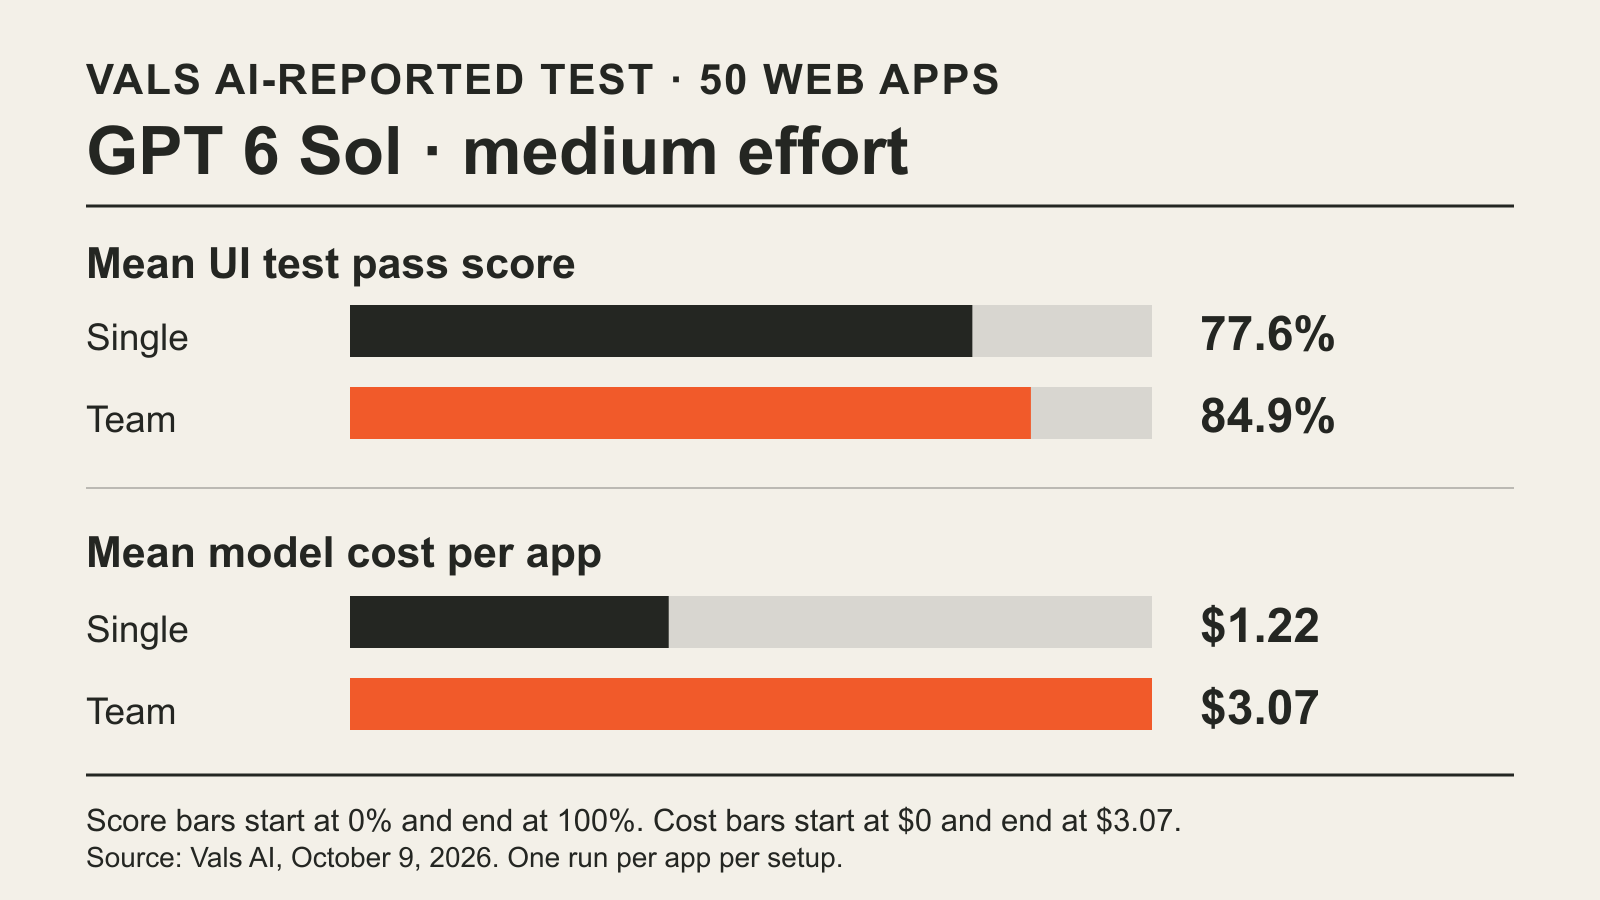
Vals AI च्या 9 ऑक्टोबरच्या अभ्यासात चार जुळवलेल्या तुलनांपैकी एका तुलनेत कोडिंग एजंटला सहकारी दिल्याने मदत झाली Vals AI चा 9 ऑक्टोबरचा Vibe Code Bench अभ्यास. मध्यम तर्क-प्रयत्न असलेल्या GPT 6 Sol संघाने बेंचमार्कमधील 84.9% अॅप-चाचण्या उत्तीर्ण केल्या; एकट्या Sol एजंटने 77.6% उत्तीर्ण केल्या. 7.3 टक्के-बिंदूंच्या या वाढीचा सरासरी खर्च प्रति अॅप $1.22 ऐवजी $3.07 होता. या वाढीसाठी 95% अंतर 2.3 ते 12.4 गुण आणि जुळवलेल्या चाचणीचे p-value 0.005 असल्याचे Vals ने नोंदवले. उरलेल्या तीन संघ-विरुद्ध-एकटा एजंट तुलनांमध्ये गुणांचा सांख्यिकीयदृष्ट्या महत्त्वाचा फरक दिसला नाही.
संघ “चांगले” आहेत का, एवढेच विचारण्यापेक्षा हा निकाल विकासकांना अधिक नेमका अर्थसंकल्पीय प्रश्न देतो. या वेब-अॅप बांधणींमध्ये मध्यम प्रयत्नाच्या Sol ने प्रति अॅप सुमारे $1.85 अधिक खर्चात मोजता येईल अशी गुणवत्ता-वाढ दिली आणि मध्यम वेळ जवळपास तितकाच राहिला. अधिक प्रयत्नात, तसेच Claude Opus 5.5 च्या दोन्ही प्रयत्न-पातळ्यांवर, संघावरील अतिरिक्त खर्चामुळे या चाचणीत गुण सुधारल्याचे सिद्ध झाले नाही.
मोठा बदल
- काय बदलले: Vals ने त्याच 50 वेब-अॅप कामांवर आणि तर्काच्या दोन पातळ्यांवर एकट्या कोडिंग एजंटची संघांशी तुलना केली. मध्यम प्रयत्नाचा Sol यालाच संघाच्या गुणांत सांख्यिकीयदृष्ट्या महत्त्वाची वाढ मिळाली.
- हे महत्त्वाचे का: विजयी संघ-मांडणीचा प्रति-अॅप खर्च 2.5 पट होता; इतर संघांचा खर्च 1.8 ते 5.1 पट होता, पण गुणांत महत्त्वाची वाढ नव्हती. संघाची रचना आणि मॉडेलची मांडणी हे एकाच खरेदी-निर्णयाचे भाग आहेत.
- काय पाहावे: पुनरावृत्तीचे रन आणि इतर सॉफ्टवेअर कामांवरील चाचण्या या विशिष्ट अॅप्सपलीकडे ही वाढ विश्वासार्ह आहे का ते दाखवू शकतात. या अभ्यासात प्रत्येक मांडणी एकदाच चालवली.
आठ रनमध्ये काय मोजले
Vals ने GPT 6 Sol आणि Claude Opus 5.5 यांना उत्पादन-तपशीलांवरून 50 पूर्ण वेब-अॅप्स बनवण्यास सांगितले. Docker Compose वापरून अॅप्स तैनात केली आणि ब्राउझर एजंटांनी वापरकर्ता-इंटरफेस चाचण्या घेऊन गुण दिले. नोंदवलेला गुण म्हणजे प्रत्येक अॅपच्या उत्तीर्ण चाचण्यांचे सरासरी प्रमाण. बेंचमार्कची पद्धत सांगते की प्रत्येक अॅप-तपशीलात 20 ते 60 स्वयंचलित चाचण्या असतात आणि एखादी चाचणी तेव्हाच उत्तीर्ण ठरते जेव्हा तिच्या किमान 90% पायऱ्या यशस्वी होतात.
प्रत्येक मॉडेलसाठी Vals ने एकट्या एजंटची तुलना अशा प्रमुखाशी केली, जो मध्यम आणि कमाल तर्क-प्रयत्न अशा दोन्ही पातळ्यांवर एकाच वेळी जास्तीत जास्त पाच उप-एजंटांकडे काम सोपवू शकत होता. काम विभागणे, सोपवणे, एकत्रित करणे आणि पडताळणे अशी अतिरिक्त सूचना प्रमुखांना दिली. प्रत्येक मॉडेल-तुलनेत कामाचा प्रॉम्प्ट, सँडबॉक्स आणि गुणांकनकर्ता समान ठेवला. आठही संरचनांनी 50 पैकी प्रत्येक अॅप एकदा बांधले.
मॉडेल आणि प्रयत्न | एकट्या एजंटचा गुण | संघाचा गुण | प्रति अॅप सरासरी खर्च: एकटा → संघ | मध्यम कालावधी: एकटा → संघ |
|---|---|---|---|---|
GPT 6 Sol, मध्यम | 77.6% | 84.9% | $1.22 → $3.07 | 12.4 → 11.9 मिनिटे |
GPT 6 Sol, कमाल | 89.0% | 90.4% | $4.82 → $8.54 | 38.4 → 27.6 मिनिटे |
Claude Opus 5.5, मध्यम | 91.5% | 91.2% | $4.08 → $9.10 | 20.3 → 26.6 मिनिटे |
Claude Opus 5.5, कमाल | 89.8% | 93.2% | $23.77 → $122 | 74.7 → 174.1 मिनिटे |
हे एका अॅप-बांधणीसाठी Vals ने मोजलेले मॉडेलचे सरासरी खर्च आहेत; सदस्यता-किंमत किंवा यशस्वी UI चाचणीमागचा खर्च नाही. कालावधी हा भिंतीवरील घड्याळानुसार वेळेचा मध्यक आहे, त्यामुळे प्रत्येक ओळीतील खर्च आणि वेळ 50 रनचे वेगवेगळे सारांश दाखवतात. कमाल प्रयत्नाच्या Opus संघाच्या सरासरीत वेळ संपलेला एक रन समाविष्ट आहे; टोकनसंख्येवरून Vals ने त्याचा खर्च सुमारे $189 मोजला.
निकाल मांडणीवर का अवलंबून आहे
Vals ने जुळवलेली t-चाचणी वापरून प्रत्येक संघाची त्याच अॅप्सवरील संबंधित एकट्या एजंटशी तुलना केली. कमाल प्रयत्नाच्या Sol संघाला 1.4 गुणांची वाढ मिळाली; 95% अंतर −1.7 ते 4.5 गुण होते. मध्यम प्रयत्नाच्या Opus संघाचा गुण 0.3 ने कमी होता; अंतर −3.2 ते 2.5 होते. कमाल प्रयत्नाच्या संघाला 3.4 गुणांची वाढ मिळाली; अंतर −1.4 ते 8.3 होते. या अंतरांत शून्य वाढही समाविष्ट आहे. या संरचनांना संघ कधीच मदत करत नाहीत असे ते सिद्ध करत नाहीत; मात्र या प्रयोगात वाढ सिद्ध झाली नाही.
Sol साठी तर्क-प्रयत्न हा आणखी एक तपासलेला पर्याय होता. एकट्या Sol एजंटचा प्रयत्न मध्यमावरून कमाल केल्यावर त्याचा गुण 77.6% वरून 89.0% झाला; Vals ने ही वाढ सांख्यिकीयदृष्ट्या महत्त्वाची म्हटली. त्या कमाल-प्रयत्नाच्या एकट्या एजंटचा खर्च प्रति अॅप $4.82 आणि कालावधीचा मध्यक 38.4 मिनिटे होता; मध्यम-प्रयत्नाच्या संघासाठी ते $3.07 आणि 11.9 मिनिटे होते. या दोन संरचनांतील 4.1 गुणांचा फरक सांख्यिकीयदृष्ट्या महत्त्वाचा नव्हता (p = 0.08). नवीन प्रकल्पात एखादी संरचना नक्की जिंकेल असे न मानता विकासकांना मोजलेली किंमत-वेळ अदलाबदल हे आकडे दाखवतात.
संघांनी वेळही वेगवेगळ्या प्रकारे वापरला. Vals नुसार Sol च्या प्रमुखाने लवकर काम सोपवले आणि एकत्र केलेले अॅप स्वतः तपासले. कमाल-प्रयत्नाच्या त्याच्या संघाने 27.6 मिनिटांच्या मध्यम कालावधीत काम पूर्ण केले; एकट्या एजंटला 38.4 मिनिटे लागली. Opus चे प्रमुख सामायिक करार लिहून टप्प्याटप्प्याने काम देत. कमाल प्रयत्नात संघाला मध्यम 174.1 मिनिटे लागली, एकट्या एजंटला 74.7 मिनिटे, आणि प्रति अॅप खर्च सुमारे पाच पट होता. अतिरिक्त बिलाचा मोठा भाग उप-एजंटांच्या स्वतंत्र संदर्भांत साठवलेल्या इनपुट टोकनांमुळे असल्याचे Vals मानते.
या निष्कर्षाचा आवाका किती
महत्त्वाच्या अंतरांत 50 अॅप्समधील फरक दिसतात; त्याच अॅपच्या पुनरावृत्ती प्रयत्नांतील बदल नव्हे. दुसरा रन तुलना बदलू शकतो. संघांना काम सोपवण्याची अतिरिक्त सूचनाही मिळाली होती, त्यामुळे प्रयोगात संघ आणि सूचना यांची संयुक्त मांडणी मोजली गेली. Sol ने OpenAI Agents API आणि Opus ने Claude Code वापरले; मॉडेलमधील गुणतुलनेत वेगवेगळे harness देखील मिसळतात. Sol च्या खर्च-अंदाजांत नोंदवलेल्या टोकन-वापरात उप-एजंटांचा समावेश आहे असे Vals गृहीत धरते; विनंती-पातळीवरील वापर उपलब्ध नसल्याने दीर्घ-संदर्भ मर्यादा ओलांडणाऱ्या विनंत्यांचा संभाव्य जास्त दर यात धरलेला नाही.
हा अभ्यास मर्यादित निर्णयाला आधार देतो: या संरचनांनी तत्सम पूर्ण-स्टॅक अॅप्स बांधताना मध्यम-प्रयत्नाच्या Sol संघाने जास्त खर्चात मोजता येईल अशी वाढ दाखवली, तर इतर संघांनी विश्वासार्ह गुण-वाढ दाखवली नाही. दुसऱ्या कोडबेसमध्ये, दुसऱ्या मॉडेलसह किंवा काम वेगळ्या प्रकारे विभागणाऱ्या व तपासणाऱ्या कार्यप्रवाहात संघ फायदेशीर ठरतील का, हे यातून ठरत नाही. BIG CHANGE ने Vals ची प्रकाशित पोस्ट आणि पद्धत तपासली; त्याने बेंचमार्क चालवला किंवा पुन्हा तयार केला नाही.


