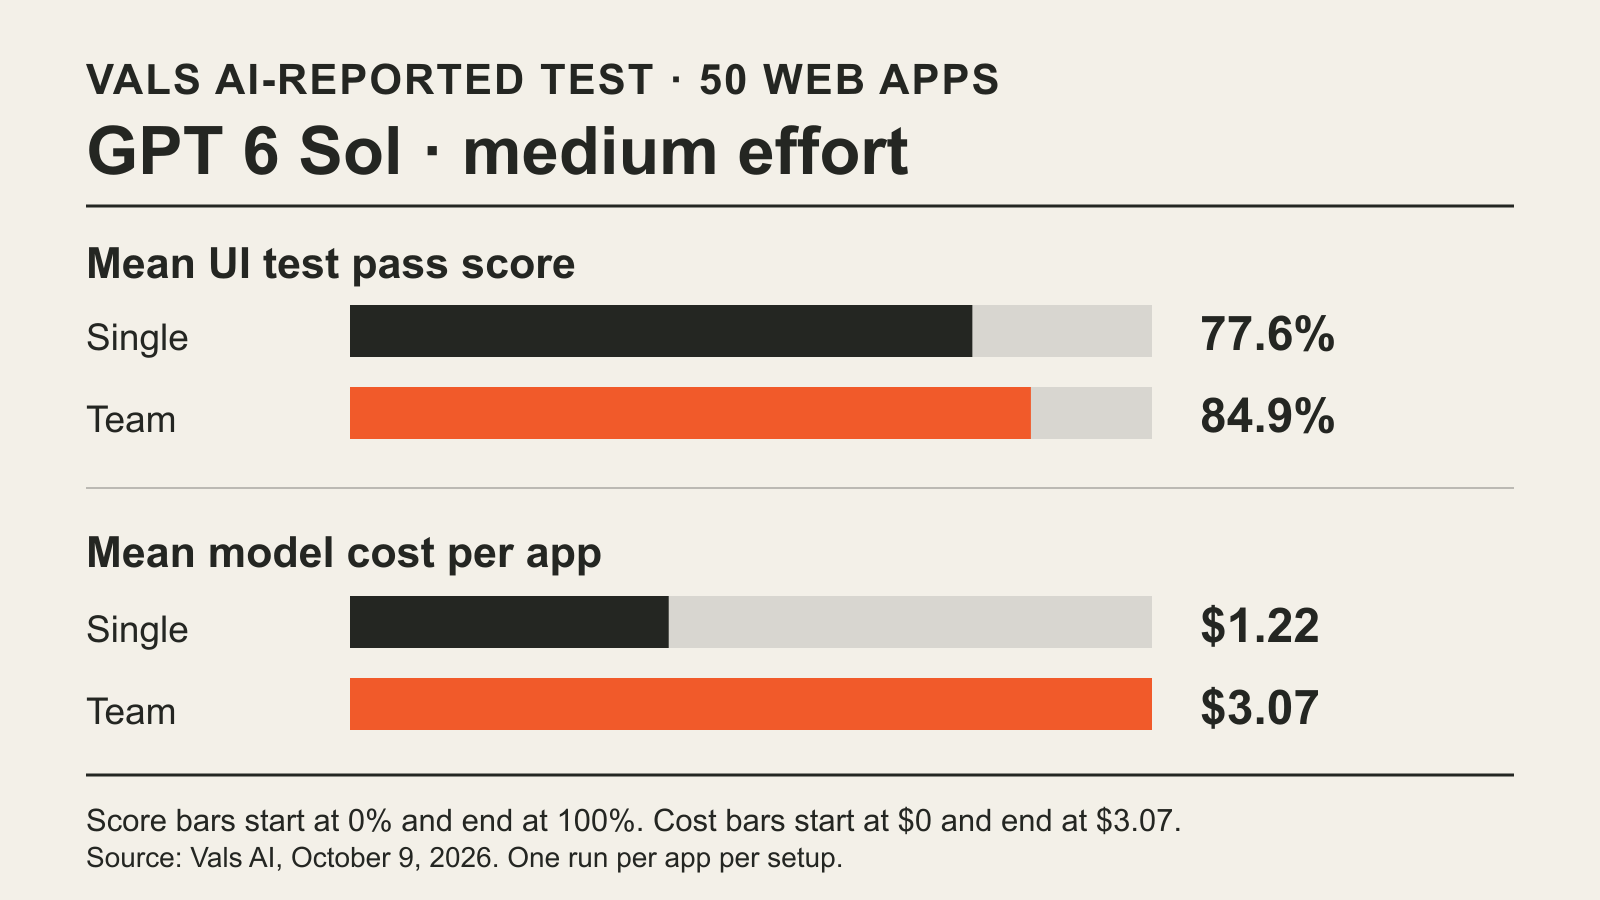
В исследовании Vals AI от 9 октября команда помогла агенту-программисту в одном из четырёх парных сравнений Исследование Vibe Code Bench от Vals AI, 9 октября. Команда GPT 6 Sol со средним усилием рассуждения прошла 84,9% тестов приложений в бенчмарке против 77,6% у одиночного агента Sol. Прирост на 7,3 процентного пункта обходился в среднем в $3,07 вместо $1,22 за приложение. Vals сообщила 95%-й интервал от 2,3 до 12,4 пункта для этого прироста и p-значение парного теста 0,005. В остальных трёх сравнениях команды с одиночным агентом статистически значимой разницы в баллах не было.
Этот результат задаёт разработчикам более точный бюджетный вопрос, чем вопрос о том, «лучше» ли команды. В этой серии веб-приложений Sol со средним усилием обеспечил измеримый прирост качества примерно за дополнительные $1,85 на приложение при почти таком же медианном времени. При более высоком усилии, а также с Claude Opus 5.5 на обоих уровнях усилий, дополнительные расходы на команды не подтвердили улучшения баллов в этом тесте.
Главное изменение
- Что изменилось: Vals сравнила одиночных агентов-программистов и команды на одних и тех же 50 задачах по созданию веб-приложений при двух уровнях рассуждения. Только Sol со средним усилием показал статистически значимый командный прирост баллов.
- Почему это важно: Победившая командная конфигурация стоила в 2,5 раза дороже на приложение; другие команды обходились в 1,8–5,1 раза дороже без значимого прироста баллов. Проектирование команды и настройки модели относятся к одному решению о покупке.
- За чем следить: Повторные запуски и тесты на других программных задачах могут показать, сохраняется ли прирост за пределами этих конкретных приложений. В этом исследовании каждую конфигурацию запускали один раз.
Что измеряли восемь запусков
Vals попросила GPT 6 Sol и Claude Opus 5.5 создать 50 полноценных веб-приложений по спецификациям продукта. Приложения развернули с Docker Compose и оценили браузерные агенты, выполнявшие тесты интерфейса. Опубликованный балл — средняя доля тестов каждого приложения, завершившихся успешно. Методика бенчмарка указывает, что спецификация каждого приложения включает от 20 до 60 автоматизированных тестов, а отдельный тест считается пройденным, если успешно выполнено не менее 90% его шагов.
Для каждой модели Vals сравнила одиночного агента с ведущим агентом, который мог одновременно делегировать работу максимум пяти субагентам при среднем и максимальном усилии рассуждения. Ведущим также добавили инструкцию разделять, делегировать, интегрировать и проверять работу. Внутри каждого сравнения модели промпт задачи, песочница и оценщик оставались одинаковыми. Каждая из восьми конфигураций по одному разу создала каждое из 50 приложений.
Модель и усилие | Балл одиночного агента | Балл команды | Средняя стоимость приложения: один агент → команда | Медианное время: один агент → команда |
|---|---|---|---|---|
GPT 6 Sol, среднее | 77,6% | 84,9% | $1,22 → $3,07 | 12,4 → 11,9 мин |
GPT 6 Sol, максимальное | 89,0% | 90,4% | $4,82 → $8,54 | 38,4 → 27,6 мин |
Claude Opus 5.5, среднее | 91,5% | 91,2% | $4,08 → $9,10 | 20,3 → 26,6 мин |
Claude Opus 5.5, максимальное | 89,8% | 93,2% | $23,77 → $122 | 74,7 → 174,1 мин |
Это средние расходы моделей Vals на одну сборку приложения, а не стоимость подписки или успешного UI-теста. Время — медиана по часам, поэтому стоимость и длительность в строке по-разному суммируют 50 запусков. Среднее команды Opus с максимальным усилием включает один запуск, превысивший лимит времени; Vals оценила его стоимость примерно в $189 по числу токенов.
Почему результат зависит от конфигурации
Vals сравнила каждую команду с соответствующим одиночным агентом на тех же приложениях с помощью парного t-теста. Команда Sol с максимальным усилием прибавила 1,4 пункта; 95%-й интервал составил от −1,7 до 4,5. Команда Opus со средним усилием набрала на 0,3 пункта меньше при интервале от −3,2 до 2,5; с максимальным усилием она прибавила 3,4 пункта при интервале от −1,4 до 8,3. Эти интервалы включают отсутствие прироста. Они не доказывают, что команды никогда не помогают в этих конфигурациях, но эксперимент не подтвердил прироста.
Для Sol отдельно проверяли и уровень усилий рассуждения. При повышении усилия одиночного агента Sol со среднего до максимального балл вырос с 77,6% до 89,0%; Vals сообщает, что рост статистически значим. Такой одиночный агент с максимальным усилием стоил $4,82 за приложение и работал медианные 38,4 минуты против $3,07 и 11,9 минуты у команды со средним усилием. Разница в 4,1 пункта между этими конфигурациями не была статистически значимой (p = 0,08). Эти цифры показывают разработчику измеренный компромисс цены и времени, не предполагая, что одна конфигурация победит в новом проекте.
Команды по-разному распределяли и время. По словам Vals, ведущий агент Sol рано делегировал работу и сам тестировал собранное приложение. Команда с максимальным усилием завершала работу за медианные 27,6 минуты против 38,4 у одиночного агента. Ведущие Opus обычно писали общий контракт и делегировали этапами. При максимальном усилии команда тратила медианные 174,1 минуты против 74,7 у одиночного агента и обходилась примерно в пять раз дороже на приложение. Vals связывает значительную часть доплаты с закэшированными входными токенами в отдельных контекстах субагентов.
Насколько далеко можно распространить вывод
Интервалы значимости отражают различия между 50 приложениями, а не разброс повторных попыток на одном приложении. Другой запуск может изменить сравнение. Командам также добавили инструкцию делегировать, поэтому эксперимент измерял сочетание команды и этой инструкции. Sol использовала OpenAI Agents API, а Opus — Claude Code; сравнение оценок моделей также смешивает разные среды исполнения. Оценки стоимости Sol от Vals предполагают, что заявленное использование токенов включает субагентов, и не учитывают возможное повышение цены запросов выше порога длинного контекста, поскольку данных по использованию на уровне запроса не было.
Исследование поддерживает ограниченное решение: при создании похожих full-stack приложений с этими конфигурациями команда Sol со средним усилием показала измеримый прирост за более высокую стоимость, а другие команды не показали надёжного прироста баллов. Оно не отвечает на вопрос, окупаются ли команды на другой кодовой базе, с другой моделью или в рабочем процессе с иным способом разделения и проверки задач. BIG CHANGE изучила опубликованный материал Vals и его методику, но не запускала и не воспроизводила бенчмарк.


