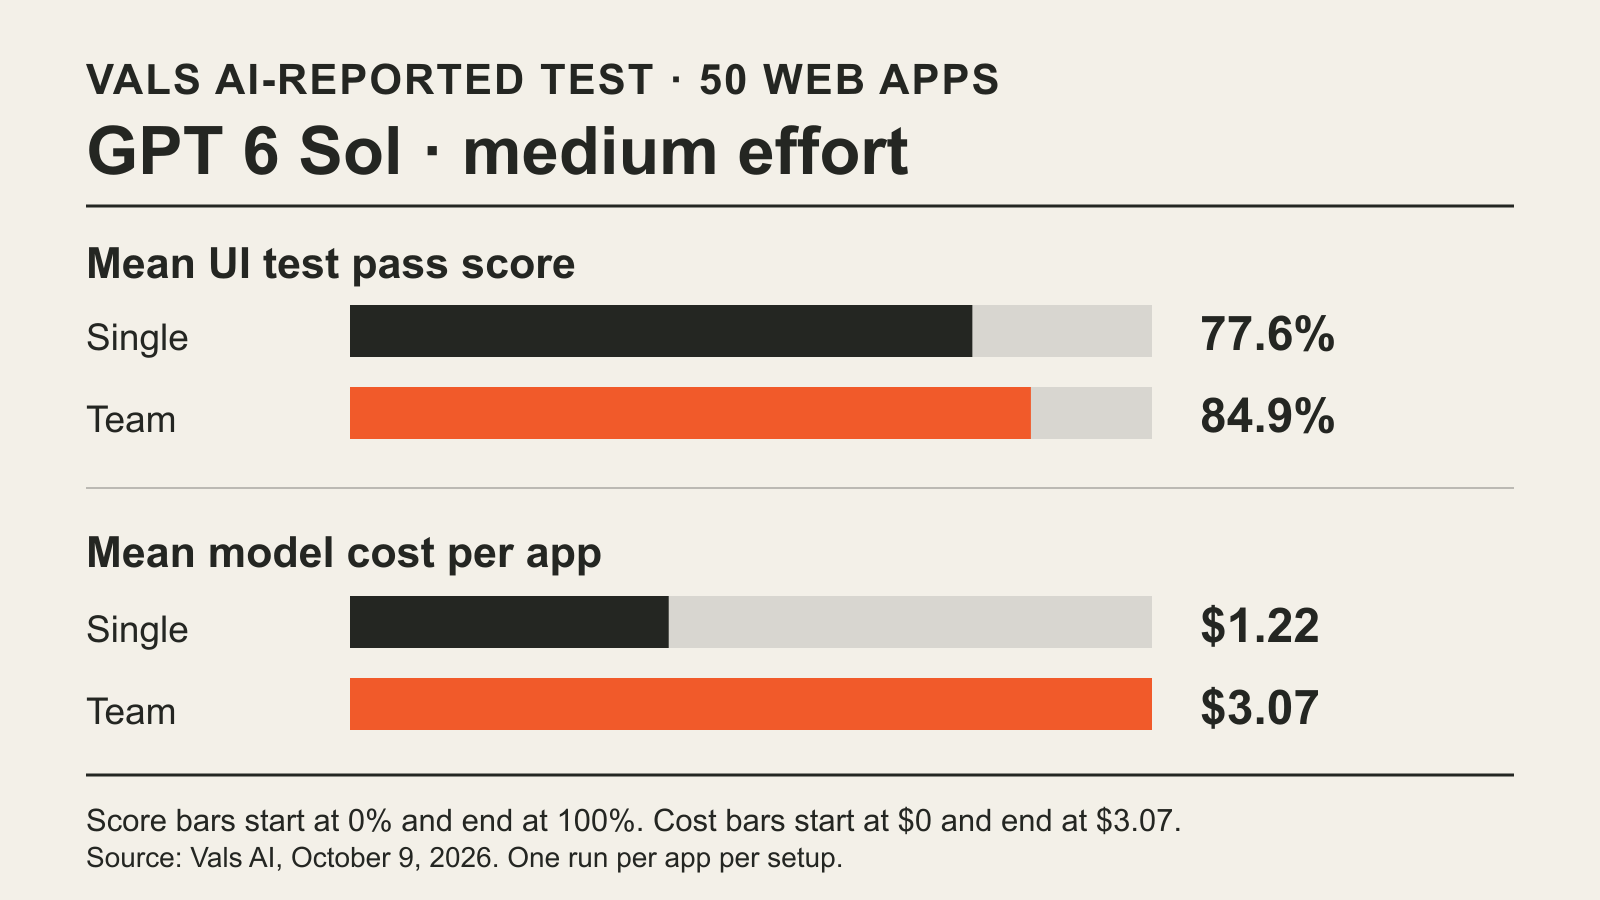
Dar colegas a um agente de programação ajudou numa das quatro comparações emparelhadas do estudo da Vals AI de 9 de outubro Estudo Vibe Code Bench da Vals AI de 9 de outubro. Uma equipa GPT 6 Sol com esforço de raciocínio médio passou 84,9% dos testes de aplicações do benchmark, contra 77,6% de um agente Sol individual. O ganho de 7,3 pontos percentuais custou, em média, 3,07 USD em vez de 1,22 USD por aplicação. A Vals indicou um intervalo de 95% de 2,3 a 12,4 pontos para esse ganho e um valor p de 0,005 no teste emparelhado. Nenhuma das outras três comparações entre equipa e agente individual revelou uma diferença estatisticamente significativa na pontuação.
O resultado dá aos programadores uma pergunta orçamental mais precisa do que saber se as equipas são «melhores». Neste conjunto de construções de aplicações Web, o Sol com esforço médio proporcionou um ganho de qualidade mensurável por cerca de mais 1,85 USD por aplicação, com um tempo mediano quase igual. Com maior esforço, e com Claude Opus 5.5 em qualquer dos níveis, o gasto adicional da equipa não demonstrou uma melhoria da pontuação neste teste.
A grande mudança
- O que mudou: A Vals comparou agentes de programação individuais com equipas nas mesmas 50 tarefas de aplicações Web, em dois níveis de raciocínio. Só o Sol com esforço médio obteve um ganho estatisticamente significativo na pontuação da equipa.
- Porque é importante: A configuração da equipa vencedora custou 2,5 vezes mais por aplicação; as outras equipas custaram entre 1,8 e 5,1 vezes mais sem um ganho significativo na pontuação. O desenho da equipa e as definições do modelo fazem parte da mesma decisão de compra.
- O que acompanhar: Execuções repetidas e testes noutras tarefas de software poderão mostrar se o ganho é fiável para além destas aplicações específicas. Neste estudo, cada configuração foi executada apenas uma vez.
O que mediram as oito execuções
A Vals pediu a GPT 6 Sol e Claude Opus 5.5 que criassem 50 aplicações Web completas a partir de especificações de produto. As aplicações foram implementadas com Docker Compose e avaliadas por agentes de browser que executaram testes de interface. A pontuação comunicada é a proporção média de testes de cada aplicação que passou. O método do benchmark indica que cada especificação de aplicação inclui 20 a 60 testes automatizados e que um teste individual é considerado aprovado quando pelo menos 90% dos seus passos têm êxito.
Para cada modelo, a Vals comparou um agente individual com um líder que podia delegar simultaneamente em até cinco subagentes, tanto com esforço médio como máximo. Os líderes também receberam a instrução adicional de dividir, delegar, integrar e verificar o trabalho. O prompt da tarefa, a sandbox e o avaliador mantiveram-se iguais em cada comparação de modelo. Cada uma das oito configurações construiu cada uma das 50 aplicações uma vez.
Modelo e esforço | Pontuação individual | Pontuação da equipa | Custo médio por aplicação: individual → equipa | Tempo mediano: individual → equipa |
|---|---|---|---|---|
GPT 6 Sol, médio | 77,6% | 84,9% | 1,22 USD → 3,07 USD | 12,4 → 11,9 min |
GPT 6 Sol, máximo | 89,0% | 90,4% | 4,82 USD → 8,54 USD | 38,4 → 27,6 min |
Claude Opus 5.5, médio | 91,5% | 91,2% | 4,08 USD → 9,10 USD | 20,3 → 26,6 min |
Claude Opus 5.5, máximo | 89,8% | 93,2% | 23,77 USD → 122 USD | 74,7 → 174,1 min |
São os custos médios dos modelos da Vals para construir uma aplicação, não preços de subscrição nem custos por teste de interface aprovado. Os tempos são medianas de relógio, pelo que o custo e o tempo de cada linha resumem aspetos diferentes das 50 execuções. A média da equipa Opus com esforço máximo inclui uma execução que excedeu o tempo limite, cujo custo de cerca de 189 USD a Vals estimou a partir da contagem de tokens.
Porque o resultado depende da configuração
A Vals comparou cada equipa com o agente individual correspondente nas mesmas aplicações através de um teste t emparelhado. A equipa Sol com esforço máximo ganhou 1,4 pontos, com um intervalo de 95% entre −1,7 e 4,5 pontos. A equipa Opus com esforço médio obteve uma pontuação 0,3 pontos inferior, com um intervalo de −3,2 a 2,5; com esforço máximo ganhou 3,4 pontos, com um intervalo de −1,4 a 8,3. Estes intervalos incluem a ausência de ganho. Não provam que as equipas nunca ajudem essas configurações, mas esta experiência não demonstrou um ganho.
Para o Sol, o esforço de raciocínio foi outra opção testada. Aumentar o esforço de um agente Sol individual de médio para máximo elevou a pontuação de 77,6% para 89,0%, o que a Vals considera estatisticamente significativo. Esse agente individual com esforço máximo custou 4,82 USD por aplicação e teve um tempo mediano de 38,4 minutos, contra 3,07 USD e 11,9 minutos para a equipa com esforço médio. A diferença de 4,1 pontos entre estas duas configurações não foi estatisticamente significativa (p = 0,08). Estes valores permitem ao programador avaliar a troca medida entre preço e tempo sem presumir que uma configuração vencerá num novo projeto.
As equipas também distribuíram o tempo de forma diferente. Segundo a Vals, o líder Sol delegou cedo e testou a aplicação montada. A equipa com esforço máximo terminou em 27,6 minutos de tempo mediano, contra 38,4 para o agente individual. Os líderes Opus tendiam a redigir um contrato partilhado e a delegar por fases. Com esforço máximo, a equipa demorou uma mediana de 174,1 minutos, contra 74,7 para o agente individual, e custou cerca de cinco vezes mais por aplicação. A Vals atribui grande parte da fatura adicional aos tokens de entrada em cache nos contextos separados dos subagentes.
Até onde se pode levar esta conclusão
Os intervalos de significância refletem diferenças entre as 50 aplicações, não variações entre tentativas repetidas na mesma aplicação. Uma execução diferente poderia alterar a comparação. As execuções das equipas também receberam a instrução adicional de delegar, pelo que a experiência mediu a configuração combinada de equipa e instrução. O Sol usou a OpenAI Agents API e o Opus usou Claude Code; as comparações de pontuação entre modelos também misturam diferentes harnesses. As estimativas de custo do Sol da Vals presumem que o uso de tokens comunicado inclui os subagentes e não contabilizam qualquer preço superior em pedidos acima do limite de contexto longo, porque não havia dados de utilização ao nível do pedido.
O estudo sustenta uma decisão limitada: ao construir aplicações full-stack semelhantes com estas configurações, uma equipa Sol de esforço médio mostrou um ganho mensurável a um custo superior, enquanto as outras equipas não mostraram um ganho fiável na pontuação. Não permite determinar se as equipas compensam noutra base de código, com outro modelo ou num fluxo de trabalho que divida e verifique a tarefa de outra forma. A BIG CHANGE analisou o artigo publicado pela Vals e o respetivo método; não executou nem replicou o benchmark.


