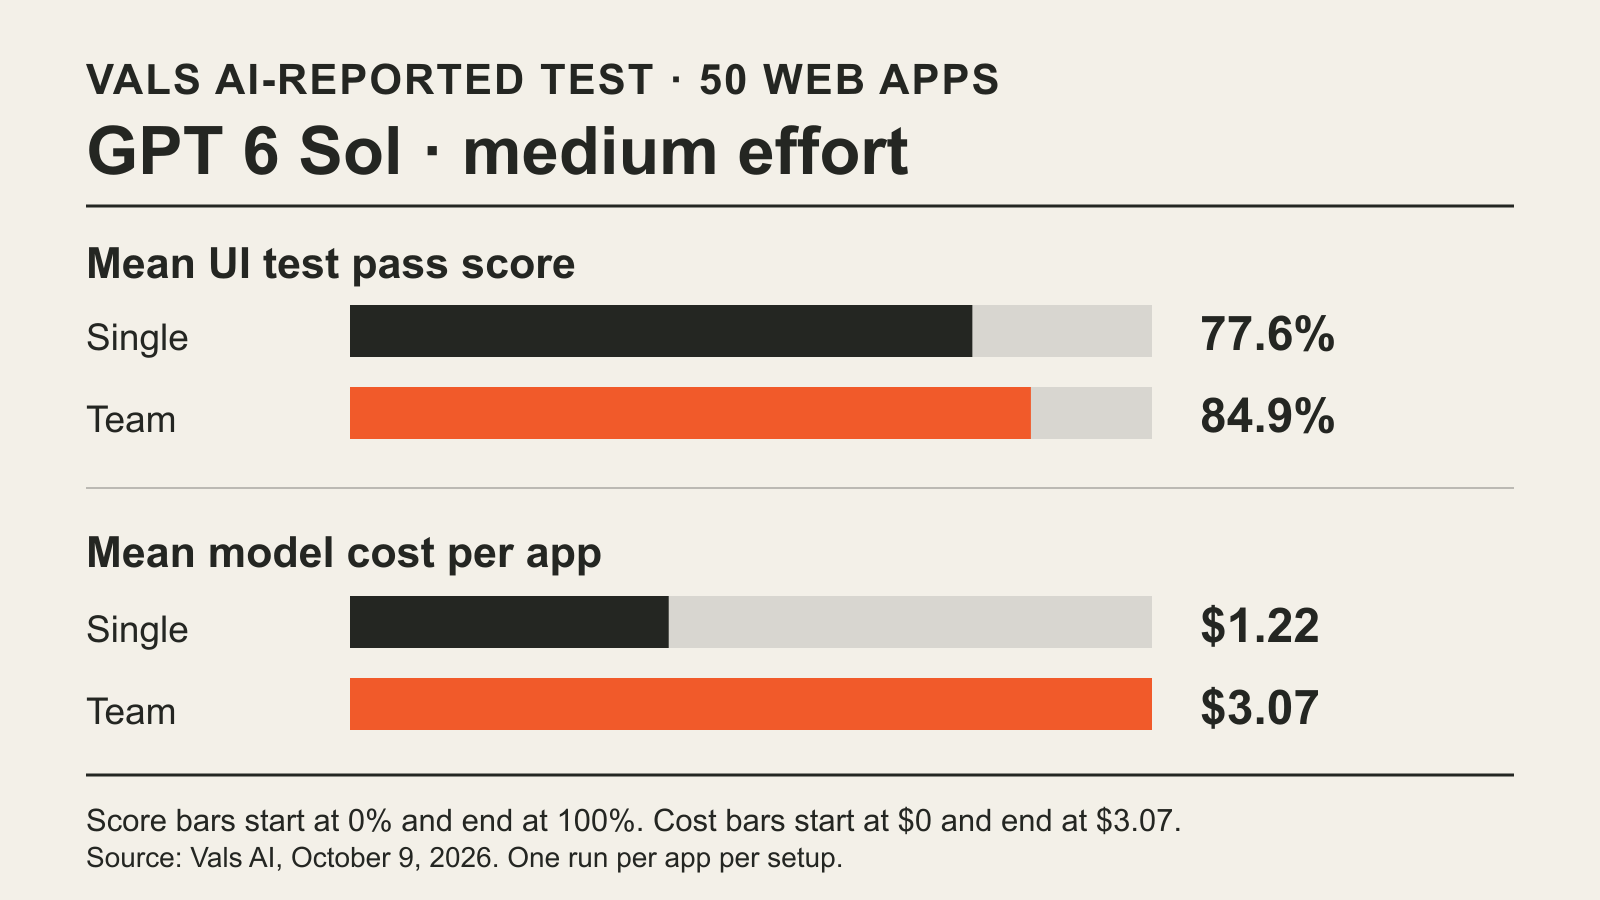
En el estudio de Vibe Code Bench de Vals AI, publicado el 9 de octubre. Un equipo de GPT 6 Sol con esfuerzo de razonamiento medio aprobó el 84,9 % de las pruebas de aplicaciones del benchmark, frente al 77,6 % de un agente Sol individual. La mejora de 7,3 puntos porcentuales costó un promedio de 3,07 $ en vez de 1,22 $ por aplicación. Vals informó un intervalo del 95 % de 2,3 a 12,4 puntos para esa mejora y un valor p de 0,005 en la prueba emparejada. Ninguna de las otras tres comparaciones entre equipo y agente individual mostró una diferencia de puntuación estadísticamente significativa.
El resultado ofrece a los desarrolladores una pregunta presupuestaria más precisa que si los equipos son «mejores». En este conjunto de desarrollos web, Sol con esfuerzo medio consiguió una mejora de calidad medible por unos 1,85 $ más por aplicación, con un tiempo mediano casi igual. Con mayor esfuerzo, y con Claude Opus 5.5 en cualquiera de los niveles, el gasto adicional en equipos no estableció una mejora de puntuación en esta prueba.
El gran cambio
- Qué cambió: Vals midió agentes de programación individuales frente a equipos en las mismas 50 tareas de aplicaciones web y con dos niveles de razonamiento. Solo Sol con esfuerzo medio tuvo una mejora estadísticamente significativa en la puntuación del equipo.
- Por qué importa: La configuración de equipo ganadora costó 2,5 veces más por aplicación; los otros equipos costaron entre 1,8 y 5,1 veces más sin una mejora significativa en la puntuación. El diseño del equipo y los ajustes del modelo forman parte de una misma decisión de compra.
- Qué observar: Repetir las ejecuciones y probar otras tareas de software podría indicar si la mejora se mantiene más allá de estas aplicaciones concretas. En este estudio, cada configuración se ejecutó una sola vez.
Qué midieron las ocho ejecuciones
Vals pidió a GPT 6 Sol y Claude Opus 5.5 que crearan 50 aplicaciones web completas a partir de especificaciones de producto. Las aplicaciones se desplegaron con Docker Compose y las puntuaron agentes de navegador que realizaron pruebas de interfaz. La puntuación publicada es la proporción promedio de pruebas de cada aplicación que se aprobaron. El método del benchmark indica que cada especificación de aplicación incluye entre 20 y 60 pruebas automatizadas, y que una prueba se considera aprobada cuando al menos el 90 % de sus pasos se completa correctamente.
Para cada modelo, Vals comparó un agente individual con un líder que podía delegar simultáneamente en hasta cinco subagentes, tanto con esfuerzo medio como máximo. Los líderes recibieron además la instrucción de dividir, delegar, integrar y verificar el trabajo. La indicación de la tarea, el entorno aislado y el evaluador se mantuvieron iguales en cada comparación de modelo. Cada una de las ocho configuraciones creó cada una de las 50 aplicaciones una vez.
Modelo y esfuerzo | Puntuación individual | Puntuación del equipo | Costo medio por aplicación: individual → equipo | Tiempo mediano: individual → equipo |
|---|---|---|---|---|
GPT 6 Sol, medio | 77,6 % | 84,9 % | 1,22 $ → 3,07 $ | 12,4 → 11,9 min |
GPT 6 Sol, máximo | 89,0 % | 90,4 % | 4,82 $ → 8,54 $ | 38,4 → 27,6 min |
Claude Opus 5.5, medio | 91,5 % | 91,2 % | 4,08 $ → 9,10 $ | 20,3 → 26,6 min |
Claude Opus 5.5, máximo | 89,8 % | 93,2 % | 23,77 $ → 122 $ | 74,7 → 174,1 min |
Son los costos medios de Vals para los modelos por desarrollo de aplicación, no precios de suscripción ni costos por prueba de interfaz aprobada. Los tiempos son medianas de tiempo transcurrido, por lo que el costo y el tiempo de cada fila resumen aspectos distintos de las 50 ejecuciones. El promedio del equipo Opus con esfuerzo máximo incluye una ejecución que agotó el tiempo, cuyo costo aproximado de 189 $ Vals estimó a partir del uso de tokens.
Por qué el resultado depende de la configuración
Vals comparó cada equipo con su agente individual equivalente en las mismas aplicaciones mediante una prueba t emparejada. El equipo Sol de esfuerzo máximo ganó 1,4 puntos, con un intervalo del 95 % de −1,7 a 4,5 puntos. El equipo Opus de esfuerzo medio obtuvo una puntuación 0,3 puntos menor, con un intervalo de −3,2 a 2,5; con esfuerzo máximo ganó 3,4 puntos, con un intervalo de −1,4 a 8,3. Esos intervalos incluyen la ausencia de mejora. No demuestran que los equipos nunca ayuden en esas configuraciones, pero este experimento no estableció una mejora.
En Sol, el esfuerzo de razonamiento fue otra opción evaluada. Subir un agente Sol individual de esfuerzo medio a máximo elevó su puntuación del 77,6 % al 89,0 %, algo que Vals considera estadísticamente significativo. Ese agente individual de esfuerzo máximo costó 4,82 $ por aplicación y tuvo un tiempo mediano de 38,4 minutos, frente a 3,07 $ y 11,9 minutos del equipo de esfuerzo medio. La diferencia de 4,1 puntos entre esas dos configuraciones no fue estadísticamente significativa (p = 0,08). Estas cifras permiten ver el intercambio medido entre precio y tiempo sin suponer que una configuración ganará en un nuevo proyecto.
Los equipos también distribuyeron su tiempo de manera distinta. Según Vals, el líder de Sol delegaba pronto y probaba por sí mismo la aplicación ensamblada. Su equipo de esfuerzo máximo terminó en una mediana de 27,6 minutos, frente a 38,4 del agente individual. Los líderes de Opus tendían a redactar un contrato compartido y delegar por etapas. Con esfuerzo máximo, el equipo tardó una mediana de 174,1 minutos, frente a 74,7 del agente individual, y costó unas cinco veces más por aplicación. Vals atribuye buena parte de la factura adicional a tokens de entrada almacenados en caché dentro de los contextos separados de los subagentes.
Hasta dónde llega este hallazgo
Los intervalos de significación reflejan diferencias entre las 50 aplicaciones, no variaciones entre intentos repetidos de una misma aplicación. Otra ejecución podría cambiar la comparación. Los equipos también recibieron la instrucción adicional de delegar, por lo que el experimento midió la combinación del equipo y esa instrucción. Sol utilizó la API OpenAI Agents y Opus utilizó Claude Code; las comparaciones de puntuación entre modelos también mezclan distintos entornos de ejecución. Las estimaciones de costo de Sol de Vals suponen que el uso de tokens informado incluye a los subagentes y no contemplan un posible precio mayor para solicitudes que superan el umbral de contexto largo, porque no había datos de uso por solicitud.
El estudio respalda una decisión acotada: al crear aplicaciones full-stack similares con estas configuraciones, un equipo Sol de esfuerzo medio mostró una mejora medible a mayor costo, mientras que los demás equipos no mostraron una mejora fiable en la puntuación. No permite resolver si los equipos compensan en otra base de código, con otro modelo o en un flujo de trabajo que divida y compruebe el trabajo de otra manera. BIG CHANGE revisó la publicación de Vals y su método; no ejecutó ni replicó el benchmark.


