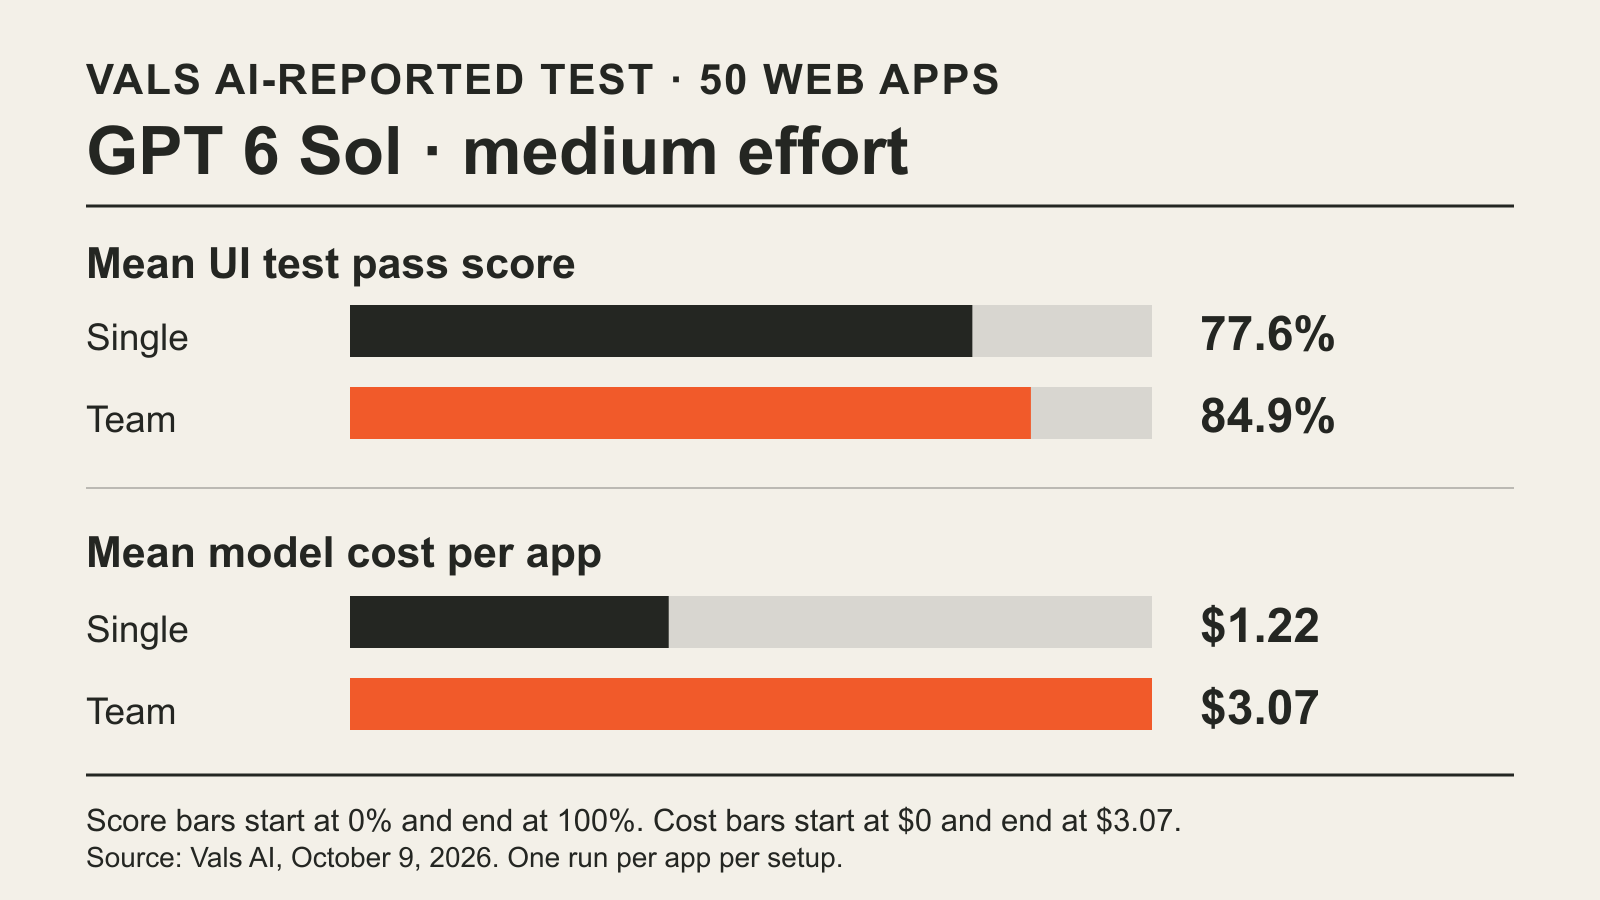
Давање сарадника агенту за програмирање помогло је у једном од четири упарена поређења у Vals AI студији од 9. октобра Vals AI студија Vibe Code Bench од 9. октобра. Тим GPT 6 Sol са средњим напором резоновања прошао је 84,9% тестова апликација у бенцхмарку, наспрам 77,6% за самостални Sol агент. Добитак од 7,3 процентна поена коштао је просечно 3,07 USD уместо 1,22 USD по апликацији. Vals је пријавио интервал поузданости од 95% од 2,3 до 12,4 поена за тај добитак и п-вредност упареног теста од 0,005. Ниједно од преостала три поређења тима и самосталног агента није показало статистички значајну разлику у резултату.
Резултат програмерима даје конкретније буџетско питање од тога да ли су тимови „бољи“. У овом скупу израда веб-апликација, Sol са средњим напором донео је мерљиво побољшање квалитета за око 1,85 USD више по апликацији, уз готово исто медијално време. При већем напору, као и за Claude Opus 5.5 на оба нивоа напора, додатна потрошња на тим није доказала побољшање резултата у овом тесту.
Велика промена
- Шта се променило: Vals је мерио самосталне агенте за програмирање наспрам тимова на истих 50 задатака за веб-апликације и при два нивоа резоновања. Само Sol са средњим напором остварио је статистички значајан тимски добитак у резултату.
- Зашто је важно: Победничка поставка тима коштала је 2,5 пута више по апликацији; остали тимови коштали су 1,8 до 5,1 пута више без значајног добитка у резултату. Дизајн тима и подешавања модела део су исте одлуке о куповини.
- Шта пратити: Понављања и тестови на другим софтверским задацима могли би да покажу да ли је добитак поуздан и ван ових конкретних апликација. У овој студији свака поставка покренута је једном.
Шта је мерено у осам покретања
Vals је тражио од GPT 6 Sol и Claude Opus 5.5 да направе 50 комплетних веб-апликација на основу спецификација производа. Апликације су постављене помоћу Docker Compose, а оцењивали су их броwсер агенти кроз тестове корисничког интерфејса. Пријављени резултат је просечан удео тестова сваке апликације који су прошли. Метод бенцхмарка наводи да свака спецификација апликације има 20 до 60 аутоматизованих тестова, а појединачни тест се рачуна као положен када успе најмање 90% његових корака.
За сваки модел Vals је упоредио самосталног агента са вођом који је могао истовремено да делегира посао на највише пет подагената, и при средњем и при максималном напору резоновања. Вође су добиле и додатно упутство да поделе, делегирају, интегришу и провере рад. Промпт задатка, сандбоx и оцењивач били су исти у сваком поређењу модела. Свака од осам конфигурација направила је сваку од 50 апликација једном.
Модел и напор | Резултат самосталног агента | Резултат тима | Просечан трошак по апликацији: самостално → тим | Медијално трајање: самостално → тим |
|---|---|---|---|---|
GPT 6 Sol, средњи | 77,6% | 84,9% | 1,22 USD → 3,07 USD | 12,4 → 11,9 мин |
GPT 6 Sol, максимални | 89,0% | 90,4% | 4,82 USD → 8,54 USD | 38,4 → 27,6 мин |
Claude Opus 5.5, средњи | 91,5% | 91,2% | 4,08 USD → 9,10 USD | 20,3 → 26,6 мин |
Claude Opus 5.5, максимални | 89,8% | 93,2% | 23,77 USD → 122 USD | 74,7 → 174,1 мин |
То су Valsови просечни трошкови модела за израду једне апликације, а не претплате нити трошкови по успешном UI тесту. Времена су медијане стварног трајања, па трошак и време у једном реду представљају различите сажетке 50 покретања. Просек тима Opus са максималним напором укључује једно покретање које је истекло; Vals је његов трошак проценио на око 189 USD на основу броја токена.
Зашто резултат зависи од поставке
Vals је упоредио сваки тим са одговарајућим самосталним агентом на истим апликацијама користећи упарени т-тест. Тим Sol са максималним напором добио је 1,4 поена, уз интервал од 95% од −1,7 до 4,5 поена. Тим Opus са средњим напором постигао је резултат нижи за 0,3 поена, уз интервал од −3,2 до 2,5; тим са максималним напором добио је 3,4 поена, уз интервал од −1,4 до 8,3. Ти интервали обухватају и нулти добитак. Они не доказују да тимови никада не помажу тим конфигурацијама, али овај експеримент није утврдио добитак.
Код Sol-а је напор резоновања био још један тестирани избор. Повећање напора самосталног Sol агента са средњег на максимални подигло је резултат са 77,6% на 89,0%, што Vals наводи као статистички значајно. Тај самостални агент са максималним напором коштао је 4,82 USD по апликацији и имао медијално трајање од 38,4 минута, наспрам 3,07 USD и 11,9 минута за тим са средњим напором. Разлика од 4,1 поен између те две конфигурације није била статистички значајна (п = 0,08). Бројеви показују програмеру измерену размену трошка и времена без претпоставке да ће нека конфигурација победити на новом пројекту.
Тимови су различито распоређивали и своје време. Vals наводи да је Sol вођа рано делегирао посао и сам тестирао састављену апликацију. Тим са максималним напором завршио је за медијалних 27,6 минута, наспрам 38,4 за самосталног агента. Вође Opus-а углавном су писале заједнички уговор и делегирале у таласима. При максималном напору тиму је требало медијалних 174,1 минута, наспрам 74,7 за самосталног агента, а коштао је око пет пута више по апликацији. Vals велики део додатног рачуна приписује кешираним улазним токенима у одвојеним контекстима подагената.
Колико далеко овај налаз важи
Интервали статистичке значајности одражавају разлике међу 50 апликација, а не варијације међу поновљеним покушајима на истој апликацији. Друго покретање могло би да промени поређење. Тимови су добили и додатно упутство за делегирање, па је експеримент мерио комбинацију тима и упутства. Sol је користио OpenAI Agents API, а Opus Claude Code; поређења резултата међу моделима зато укључују и различите харнесс-е. Valsове процене трошка за Sol претпостављају да пријављена употреба токена укључује подагенте и не рачунају евентуалну вишу цену захтева преко прага за дуги контекст, јер подаци о употреби по захтеву нису били доступни.
Студија подржава ограничен закључак: при изради сличних фулл-стацк апликација са овим конфигурацијама, тим Sol са средњим напором показао је мерљив добитак уз виши трошак, док остали тимови нису показали поуздан добитак у резултату. Не може да утврди да ли се тимови исплате на другој кодној бази, уз други модел или у току рада који другачије дели и проверава посао. BIG CHANGE је прегледао објављени текст Vals-а и његов метод; није изводио нити поновио бенцхмарк.


