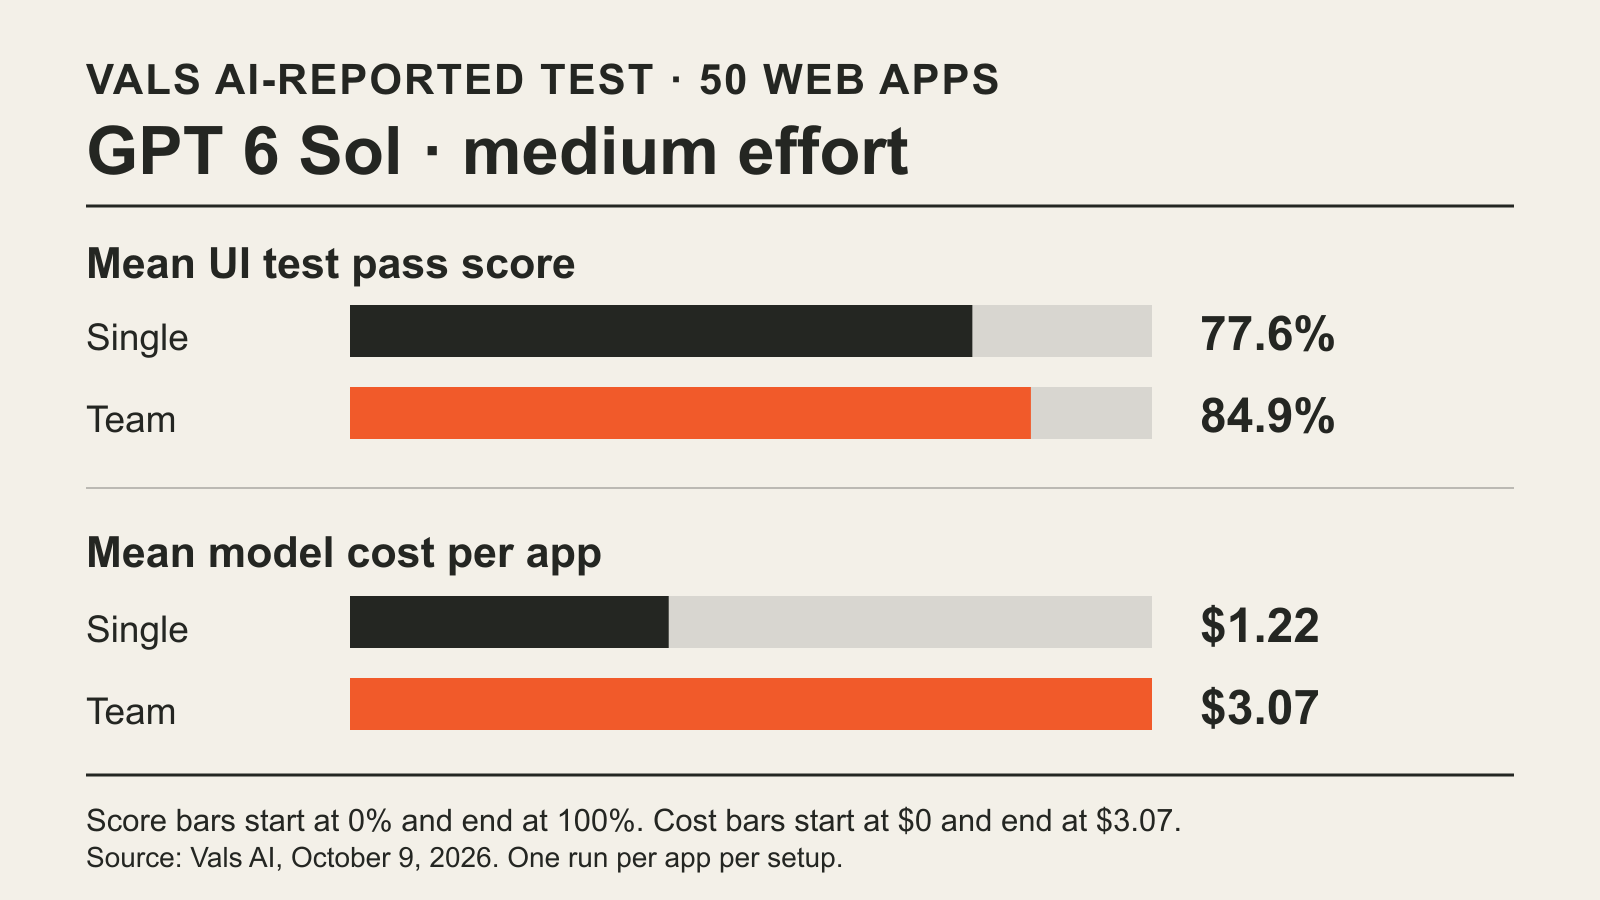
Davanje saradnika agentu za programiranje pomoglo je u jednom od četiri uparena poređenja u Vals AI studiji od 9. oktobra Vals AI studija Vibe Code Bench od 9. oktobra. Tim GPT 6 Sol sa srednjim naporom rezonovanja prošao je 84,9% testova aplikacija u benchmarku, naspram 77,6% za samostalni Sol agent. Dobitak od 7,3 procentna poena koštao je prosečno 3,07 USD umesto 1,22 USD po aplikaciji. Vals je prijavio interval pouzdanosti od 95% od 2,3 do 12,4 poena za taj dobitak i p-vrednost uparenog testa od 0,005. Nijedno od preostala tri poređenja tima i samostalnog agenta nije pokazalo statistički značajnu razliku u rezultatu.
Rezultat programerima daje konkretnije budžetsko pitanje od toga da li su timovi „bolji“. U ovom skupu izrada veb-aplikacija, Sol sa srednjim naporom doneo je merljivo poboljšanje kvaliteta za oko 1,85 USD više po aplikaciji, uz gotovo isto medijalno vreme. Pri većem naporu, kao i za Claude Opus 5.5 na oba nivoa napora, dodatna potrošnja na tim nije dokazala poboljšanje rezultata u ovom testu.
Velika promena
- Šta se promenilo: Vals je merio samostalne agente za programiranje naspram timova na istih 50 zadataka za veb-aplikacije i pri dva nivoa rezonovanja. Samo Sol sa srednjim naporom ostvario je statistički značajan timski dobitak u rezultatu.
- Zašto je važno: Pobednička postavka tima koštala je 2,5 puta više po aplikaciji; ostali timovi koštali su 1,8 do 5,1 puta više bez značajnog dobitka u rezultatu. Dizajn tima i podešavanja modela deo su iste odluke o kupovini.
- Šta pratiti: Ponavljanja i testovi na drugim softverskim zadacima mogli bi da pokažu da li je dobitak pouzdan i van ovih konkretnih aplikacija. U ovoj studiji svaka postavka pokrenuta je jednom.
Šta je mereno u osam pokretanja
Vals je tražio od GPT 6 Sol i Claude Opus 5.5 da naprave 50 kompletnih veb-aplikacija na osnovu specifikacija proizvoda. Aplikacije su postavljene pomoću Docker Compose, a ocenjivali su ih browser agenti kroz testove korisničkog interfejsa. Prijavljeni rezultat je prosečan udeo testova svake aplikacije koji su prošli. Metod benchmarka navodi da svaka specifikacija aplikacije ima 20 do 60 automatizovanih testova, a pojedinačni test se računa kao položen kada uspe najmanje 90% njegovih koraka.
Za svaki model Vals je uporedio samostalnog agenta sa vođom koji je mogao istovremeno da delegira posao na najviše pet podagenata, i pri srednjem i pri maksimalnom naporu rezonovanja. Vođe su dobile i dodatno uputstvo da podele, delegiraju, integrišu i provere rad. Prompt zadatka, sandbox i ocenjivač bili su isti u svakom poređenju modela. Svaka od osam konfiguracija napravila je svaku od 50 aplikacija jednom.
Model i napor | Rezultat samostalnog agenta | Rezultat tima | Prosečan trošak po aplikaciji: samostalno → tim | Medijalno trajanje: samostalno → tim |
|---|---|---|---|---|
GPT 6 Sol, srednji | 77,6% | 84,9% | 1,22 USD → 3,07 USD | 12,4 → 11,9 min |
GPT 6 Sol, maksimalni | 89,0% | 90,4% | 4,82 USD → 8,54 USD | 38,4 → 27,6 min |
Claude Opus 5.5, srednji | 91,5% | 91,2% | 4,08 USD → 9,10 USD | 20,3 → 26,6 min |
Claude Opus 5.5, maksimalni | 89,8% | 93,2% | 23,77 USD → 122 USD | 74,7 → 174,1 min |
To su Valsovi prosečni troškovi modela za izradu jedne aplikacije, a ne pretplate niti troškovi po uspešnom UI testu. Vremena su medijane stvarnog trajanja, pa trošak i vreme u jednom redu predstavljaju različite sažetke 50 pokretanja. Prosek tima Opus sa maksimalnim naporom uključuje jedno pokretanje koje je isteklo; Vals je njegov trošak procenio na oko 189 USD na osnovu broja tokena.
Zašto rezultat zavisi od postavke
Vals je uporedio svaki tim sa odgovarajućim samostalnim agentom na istim aplikacijama koristeći upareni t-test. Tim Sol sa maksimalnim naporom dobio je 1,4 poena, uz interval od 95% od −1,7 do 4,5 poena. Tim Opus sa srednjim naporom postigao je rezultat niži za 0,3 poena, uz interval od −3,2 do 2,5; tim sa maksimalnim naporom dobio je 3,4 poena, uz interval od −1,4 do 8,3. Ti intervali obuhvataju i nulti dobitak. Oni ne dokazuju da timovi nikada ne pomažu tim konfiguracijama, ali ovaj eksperiment nije utvrdio dobitak.
Kod Sol-a je napor rezonovanja bio još jedan testirani izbor. Povećanje napora samostalnog Sol agenta sa srednjeg na maksimalni podiglo je rezultat sa 77,6% na 89,0%, što Vals navodi kao statistički značajno. Taj samostalni agent sa maksimalnim naporom koštao je 4,82 USD po aplikaciji i imao medijalno trajanje od 38,4 minuta, naspram 3,07 USD i 11,9 minuta za tim sa srednjim naporom. Razlika od 4,1 poen između te dve konfiguracije nije bila statistički značajna (p = 0,08). Brojevi pokazuju programeru izmerenu razmenu troška i vremena bez pretpostavke da će neka konfiguracija pobediti na novom projektu.
Timovi su različito raspoređivali i svoje vreme. Vals navodi da je Sol vođa rano delegirao posao i sam testirao sastavljenu aplikaciju. Tim sa maksimalnim naporom završio je za medijalnih 27,6 minuta, naspram 38,4 za samostalnog agenta. Vođe Opus-a uglavnom su pisale zajednički ugovor i delegirale u talasima. Pri maksimalnom naporu timu je trebalo medijalnih 174,1 minuta, naspram 74,7 za samostalnog agenta, a koštao je oko pet puta više po aplikaciji. Vals veliki deo dodatnog računa pripisuje keširanim ulaznim tokenima u odvojenim kontekstima podagenata.
Koliko daleko ovaj nalaz važi
Intervali statističke značajnosti odražavaju razlike među 50 aplikacija, a ne varijacije među ponovljenim pokušajima na istoj aplikaciji. Drugo pokretanje moglo bi da promeni poređenje. Timovi su dobili i dodatno uputstvo za delegiranje, pa je eksperiment merio kombinaciju tima i uputstva. Sol je koristio OpenAI Agents API, a Opus Claude Code; poređenja rezultata među modelima zato uključuju i različite harness-e. Valsove procene troška za Sol pretpostavljaju da prijavljena upotreba tokena uključuje podagente i ne računaju eventualnu višu cenu zahteva preko praga za dugi kontekst, jer podaci o upotrebi po zahtevu nisu bili dostupni.
Studija podržava ograničen zaključak: pri izradi sličnih full-stack aplikacija sa ovim konfiguracijama, tim Sol sa srednjim naporom pokazao je merljiv dobitak uz viši trošak, dok ostali timovi nisu pokazali pouzdan dobitak u rezultatu. Ne može da utvrdi da li se timovi isplate na drugoj kodnoj bazi, uz drugi model ili u toku rada koji drugačije deli i proverava posao. BIG CHANGE je pregledao objavljeni tekst Vals-a i njegov metod; nije izvodio niti ponovio benchmark.


