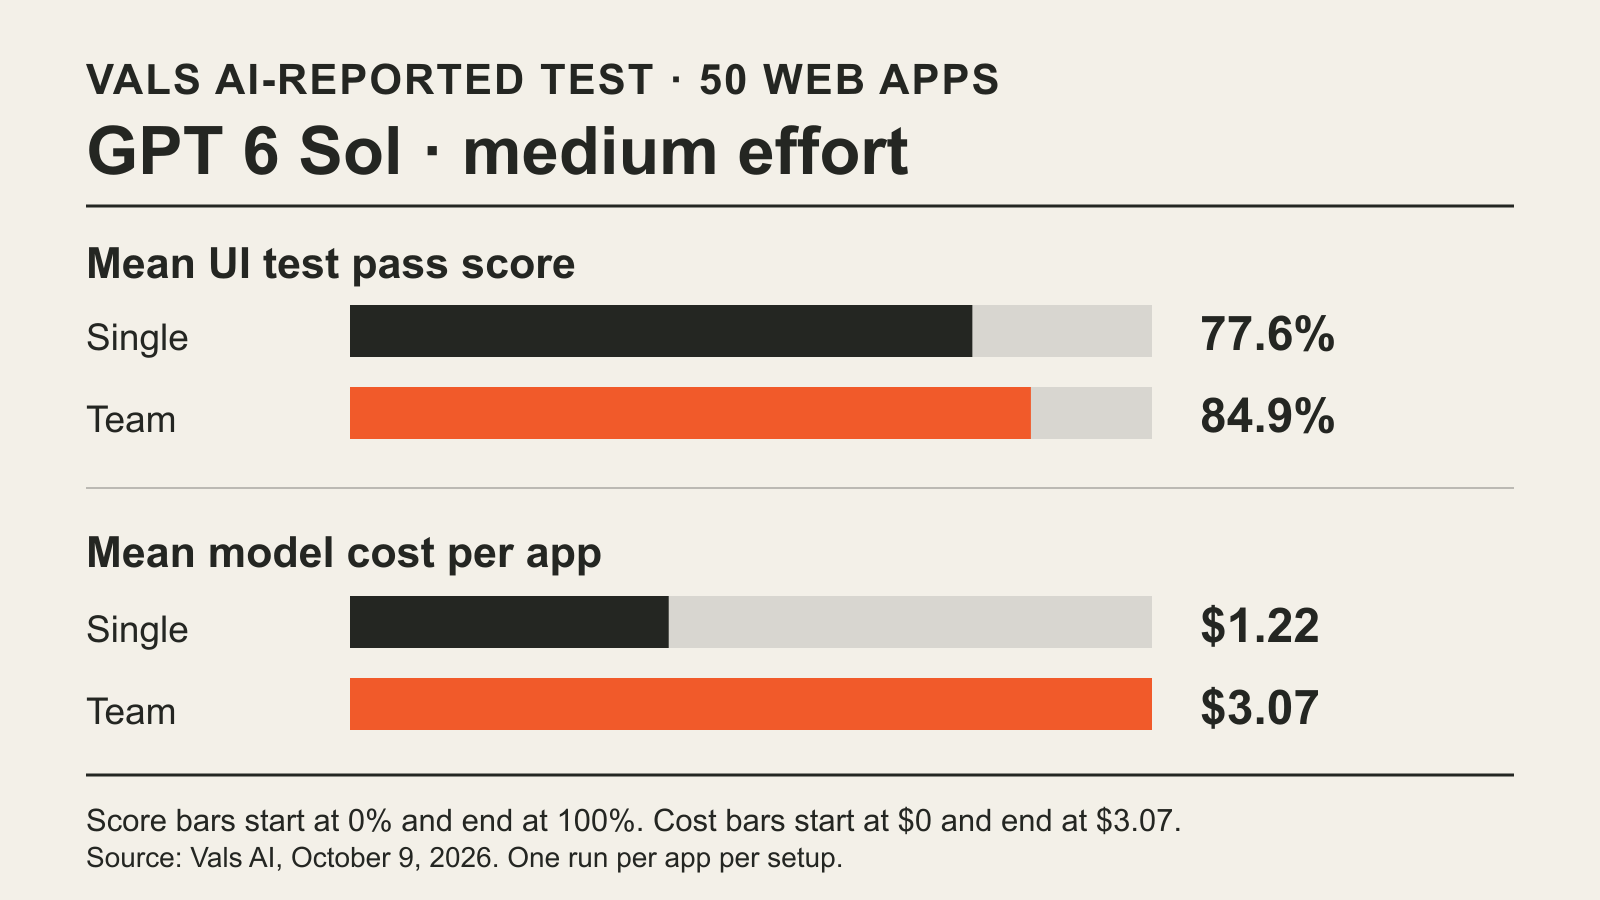
Vals AI-এর 9 অক্টোবরের গবেষণায় চারটি জোড়া তুলনার একটিতে কোডিং এজেন্টকে সতীর্থ দেওয়া সহায়ক হয়েছিল Vals AI-এর 9 অক্টোবরের Vibe Code Bench গবেষণা। মাঝারি যুক্তি-প্রচেষ্টার GPT 6 Sol দল বেঞ্চমার্কের 84.9% অ্যাপ পরীক্ষা পাস করেছে, যেখানে একক Sol এজেন্ট পাস করেছে 77.6%। 7.3 শতাংশ-পয়েন্টের এই উন্নতিতে প্রতি অ্যাপে গড়ে $1.22-এর বদলে $3.07 খরচ হয়েছে। Vals এই উন্নতির 95% ব্যবধান 2.3 থেকে 12.4 পয়েন্ট এবং জোড়া পরীক্ষার p-value 0.005 জানিয়েছে। বাকি তিনটি দল-বনাম-একক-এজেন্ট তুলনায় স্কোরের পরিসংখ্যানগতভাবে তাৎপর্যপূর্ণ পার্থক্য দেখা যায়নি।
দল “ভালো” কি না—এমন প্রশ্নের চেয়ে ফলটি ডেভেলপারদের আরও নির্দিষ্ট বাজেটের প্রশ্ন দেয়। এই ওয়েব-অ্যাপ নির্মাণগুলিতে মাঝারি প্রচেষ্টার Sol প্রতি অ্যাপে প্রায় $1.85 বেশি খরচে পরিমাপযোগ্য মানোন্নয়ন এনেছে, অথচ মধ্যম সময় প্রায় একই ছিল। বেশি প্রচেষ্টায়, এবং Claude Opus 5.5-এর উভয় প্রচেষ্টা-স্তরেই, এই পরীক্ষায় দলের অতিরিক্ত খরচে স্কোর বাড়ে—এমন প্রমাণ মেলেনি।
বড় পরিবর্তন
- কী বদলেছে: Vals একই 50টি ওয়েব-অ্যাপ কাজ এবং যুক্তির দুটি স্তরে একক কোডিং এজেন্টের সঙ্গে দলকে তুলনা করেছে। মাঝারি প্রচেষ্টার Sol-ই দলের স্কোরে পরিসংখ্যানগতভাবে তাৎপর্যপূর্ণ উন্নতি পেয়েছে।
- কেন গুরুত্বপূর্ণ: বিজয়ী দল-সেটআপে প্রতি অ্যাপে খরচ ছিল 2.5 গুণ; অন্য দলগুলিতে খরচ 1.8 থেকে 5.1 গুণ হলেও স্কোরে তাৎপর্যপূর্ণ উন্নতি হয়নি। দলের নকশা এবং মডেলের সেটিং একই ক্রয়-সিদ্ধান্তের অংশ।
- কী লক্ষ্য রাখবেন: বারবার চালানো এবং অন্য সফটওয়্যার কাজে পরীক্ষা করলে এই নির্দিষ্ট অ্যাপগুলির বাইরেও উন্নতিটি নির্ভরযোগ্য কি না বোঝা যেতে পারে। এই গবেষণায় প্রতিটি সেটআপ একবারই চালানো হয়েছিল।
আটটি রান কী মেপেছিল
Vals GPT 6 Sol ও Claude Opus 5.5-কে পণ্যের স্পেসিফিকেশন থেকে 50টি সম্পূর্ণ ওয়েব অ্যাপ বানাতে বলেছিল। অ্যাপগুলি Docker Compose দিয়ে স্থাপন করা হয় এবং ব্রাউজার এজেন্ট ব্যবহারকারী-ইন্টারফেস পরীক্ষা চালিয়ে সেগুলিকে স্কোর দেয়। প্রকাশিত স্কোর হলো প্রতিটি অ্যাপের পরীক্ষাগুলির পাসের গড় অনুপাত। বেঞ্চমার্কের পদ্ধতি বলছে, প্রতিটি অ্যাপ স্পেসিফিকেশনে 20 থেকে 60টি স্বয়ংক্রিয় পরীক্ষা থাকে, আর কোনো পরীক্ষা পাস বলে গণ্য হয় যখন তার অন্তত 90% ধাপ সফল হয়।
প্রতিটি মডেলের ক্ষেত্রে Vals একক এজেন্টের সঙ্গে এমন এক লিডকে তুলনা করেছে, যে মাঝারি ও সর্বোচ্চ যুক্তি-প্রচেষ্টা—দুই ক্ষেত্রেই একসঙ্গে সর্বোচ্চ পাঁচটি সাবএজেন্টকে কাজ দিতে পারত। লিডদের কাজ ভাগ করা, অর্পণ করা, একত্র করা ও যাচাই করার অতিরিক্ত নির্দেশও দেওয়া হয়েছিল। প্রতিটি মডেল-তুলনায় কাজের প্রম্পট, স্যান্ডবক্স এবং মূল্যায়নকারী একই রাখা হয়। আটটি কনফিগারেশনের প্রতিটি 50টি অ্যাপ একবার করে তৈরি করেছে।
মডেল ও প্রচেষ্টা | একক স্কোর | দলের স্কোর | প্রতি অ্যাপে গড় খরচ: একক → দল | মধ্যম রানটাইম: একক → দল |
|---|---|---|---|---|
GPT 6 Sol, মাঝারি | 77.6% | 84.9% | $1.22 → $3.07 | 12.4 → 11.9 মিনিট |
GPT 6 Sol, সর্বোচ্চ | 89.0% | 90.4% | $4.82 → $8.54 | 38.4 → 27.6 মিনিট |
Claude Opus 5.5, মাঝারি | 91.5% | 91.2% | $4.08 → $9.10 | 20.3 → 26.6 মিনিট |
Claude Opus 5.5, সর্বোচ্চ | 89.8% | 93.2% | $23.77 → $122 | 74.7 → 174.1 মিনিট |
এগুলি একটি অ্যাপ তৈরিতে মডেলের গড় খরচ—সাবস্ক্রিপশনের মূল্য বা সফল UI পরীক্ষাপ্রতি খরচ নয়। রানটাইম হলো দেয়াল-ঘড়ির সময়ের মধ্যক, তাই প্রতিটি সারির খরচ ও সময় 50টি রানের আলাদা সারাংশ। সর্বোচ্চ প্রচেষ্টার Opus দলের গড়ে একটি সময়সীমা-পেরোনো রান রয়েছে; Vals টোকেনের সংখ্যা থেকে সেটির খরচ প্রায় $189 ধরেছে।
সেটআপের ওপর ফল নির্ভর করে কেন
Vals জোড়া t-পরীক্ষা ব্যবহার করে প্রতিটি দলকে একই অ্যাপে তার উপযুক্ত একক এজেন্টের সঙ্গে তুলনা করেছে। সর্বোচ্চ প্রচেষ্টার Sol দল 1.4 পয়েন্ট এগিয়েছে, 95% ব্যবধান −1.7 থেকে 4.5 পয়েন্ট। মাঝারি প্রচেষ্টার Opus দলের স্কোর 0.3 পয়েন্ট কম ছিল, ব্যবধান −3.2 থেকে 2.5; সর্বোচ্চ প্রচেষ্টার দল 3.4 পয়েন্ট এগিয়েছে, ব্যবধান −1.4 থেকে 8.3। এসব ব্যবধানে কোনো উন্নতি না হওয়ার সম্ভাবনাও রয়েছে। এগুলি প্রমাণ করে না যে ওই কনফিগারেশনে দল কখনো সাহায্য করে না, তবে এই পরীক্ষায় উন্নতি প্রতিষ্ঠিত হয়নি।
Sol-এর ক্ষেত্রে যুক্তি-প্রচেষ্টাও ছিল পরীক্ষিত আরেকটি পছন্দ। একক Sol এজেন্টের প্রচেষ্টা মাঝারি থেকে সর্বোচ্চে বাড়ালে স্কোর 77.6% থেকে 89.0% হয়; Vals এটিকে পরিসংখ্যানগতভাবে তাৎপর্যপূর্ণ বলেছে। সর্বোচ্চ প্রচেষ্টার সেই একক এজেন্টে প্রতি অ্যাপে $4.82 খরচ এবং 38.4 মিনিট মধ্যম রানটাইম ছিল; মাঝারি প্রচেষ্টার দলে তা ছিল $3.07 ও 11.9 মিনিট। এই দুই কনফিগারেশনের 4.1 পয়েন্ট স্কোর-পার্থক্য পরিসংখ্যানগতভাবে তাৎপর্যপূর্ণ ছিল না (p = 0.08)। নতুন প্রকল্পে কোনো সেটআপ জিতবেই ধরে না নিয়ে এই সংখ্যা ডেভেলপারদের মাপা মূল্য-সময়ের বিনিময় দেখতে দেয়।
দলগুলি সময়ও আলাদাভাবে ব্যবহার করেছে। Vals জানায়, Sol-এর লিড শুরুতেই কাজ অর্পণ করে এবং জোড়া লাগানো অ্যাপটি নিজে পরীক্ষা করেছিল। সর্বোচ্চ প্রচেষ্টার দলটি 27.6 মিনিট মধ্যম সময়ে শেষ করে, একক এজেন্টের 38.4 মিনিটের তুলনায়। Opus-এর লিডরা সাধারণত একটি যৌথ চুক্তি লিখে ধাপে ধাপে কাজ দিত। সর্বোচ্চ প্রচেষ্টায় দলের মধ্যম সময় ছিল 174.1 মিনিট, একক এজেন্টের 74.7 মিনিট; প্রতি অ্যাপে খরচ ছিল প্রায় পাঁচ গুণ। Vals অতিরিক্ত বিলের বড় অংশ সাবএজেন্টদের পৃথক প্রসঙ্গে ক্যাশ করা ইনপুট টোকেনের কারণে বলে মনে করে।
এই ফল কত দূর পর্যন্ত প্রযোজ্য
তাৎপর্য-সংক্রান্ত ব্যবধান 50টি অ্যাপের পার্থক্য দেখায়, একই অ্যাপে পুনরাবৃত্ত চেষ্টার ওঠানামা নয়। আরেকটি রান তুলনাটি বদলে দিতে পারে। দলগুলিকে কাজ অর্পণের অতিরিক্ত নির্দেশও দেওয়া হয়েছিল, তাই পরীক্ষায় দল ও নির্দেশের সম্মিলিত সেটআপ মাপা হয়েছে। Sol OpenAI Agents API এবং Opus Claude Code ব্যবহার করেছে; মডেলগুলির স্কোর তুলনায় আলাদা harness-ও মিশেছে। Sol-এর খরচের Vals-অনুমান ধরে নেয় যে জানানো টোকেন ব্যবহারে সাবএজেন্ট অন্তর্ভুক্ত, এবং দীর্ঘ-প্রসঙ্গ সীমা পেরোনো অনুরোধের সম্ভাব্য বেশি মূল্য ধরে না, কারণ অনুরোধ-স্তরের ব্যবহার-তথ্য ছিল না।
গবেষণাটি একটি সীমিত সিদ্ধান্তকে সমর্থন করে: এই কনফিগারেশনে একই ধরনের ফুল-স্ট্যাক অ্যাপ বানালে বেশি খরচে মাঝারি প্রচেষ্টার Sol দল পরিমাপযোগ্য উন্নতি দেখিয়েছে, অন্য দলগুলি নির্ভরযোগ্য স্কোর-উন্নতি দেখায়নি। অন্য কোডবেস, অন্য মডেল বা কাজ ভাগ ও যাচাইয়ের ভিন্ন পদ্ধতির কর্মপ্রবাহে দলগুলি লাভজনক কি না, তা এটি মীমাংসা করে না। BIG CHANGE Vals-এর প্রকাশিত পোস্ট ও পদ্ধতি পর্যালোচনা করেছে; বেঞ্চমার্ক চালায়নি বা পুনরাবৃত্তি করেনি।


