仮想の職場を使った研究で、知識労働者189人は、同じ基盤言語モデルを使うAIアシスタントに異なる評価と金銭的報酬を与えた。チューリヒ大学の研究者が10月14日に公開した説明によると、人間に似たアバターは卓上ロボットより多くの信頼、貢献への評価、金銭を得た。JohanというアバターはJohannaより多くの金銭を得たが、研究者はその違いを性別だけでは説明できないと注意を促している。
この結果は、仮想現実で行った統制された課題に関するものだ。参加者は協働のたびに最大4スイスフランを配分し、残りを自分で受け取ることができた。人への賃金、AIの価格、職場全体へのアバター導入の影響を測定したものではない。
大きな変化
- 何が変わったのか: アシスタントの言語モデルと対話の処理過程を同じに保ち、参加者が接する形態を変えた研究が行われた。そこで使われた特定の人間に似たアバターは、卓上ロボットより高い評価と報酬を得た。
- なぜ重要なのか: 背後のシステムが同じでも、AIアシスタントの見せ方は、人々がその貢献を判断し報酬を与える方法に影響しうる。設計者は、最も好意的な評価を得た形態が、働く人の好む形態だとは決めつけられない。
- 今後の注目点: アバターの特徴をより体系的に変え、使用期間を長くした研究によって、性別の手がかり、知覚された人間らしさ、その他のデザイン要素を切り分けられる可能性がある。この実験は、そうした要因が通常の仕事でどう作用するかを明らかにするものではない。
同じアシスタントを異なる形態で
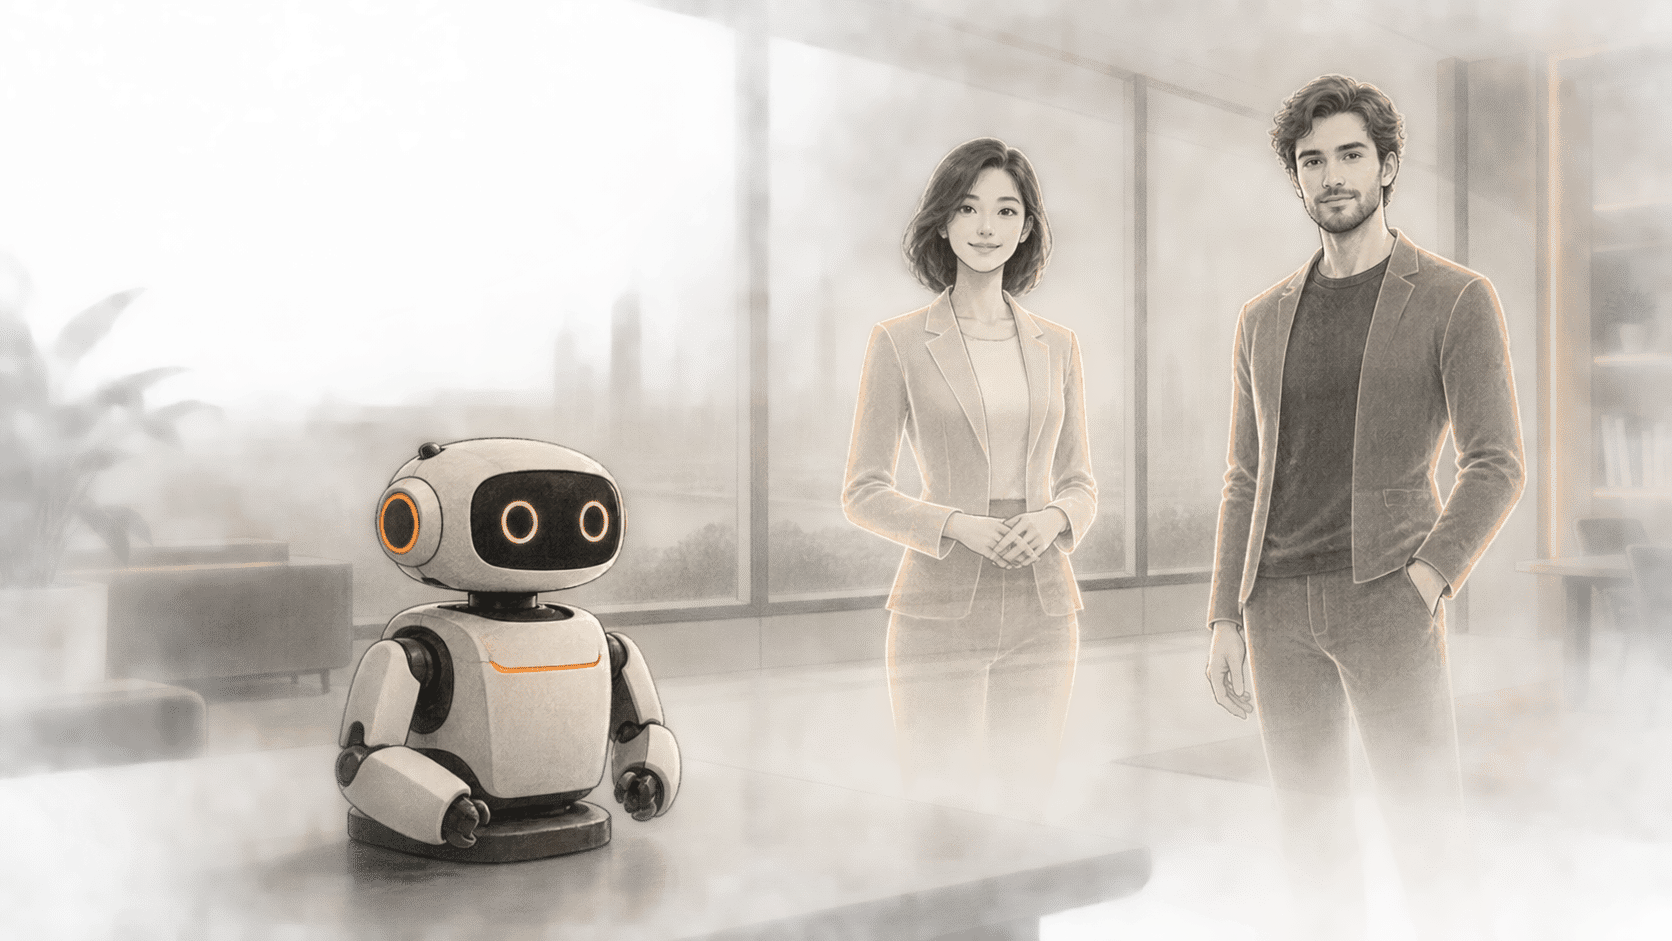
参加者は職場の話題について、テキストチャット、卓上ロボット、そしてJohanかJohannaのどちらかと、3ラウンドにわたってアイデアを出し合った。後者の二つは、男性と女性の外見で提示された、人間に似た仮想アシスタントだ。研究者によると、4種類の表現はいずれも同じ大規模言語モデルと対話処理過程を使っていた。各ラウンドの後、参加者は人間らしさ、信頼、貢献への評価を回答し、4フランの報酬の一部をアシスタントに配分できた。研究チームは34人にも聞き取りを行った。
著者らの報告によると、二つの人間に似たアバターは、卓上ロボットより人間らしいと評価され、多くの信頼、貢献への評価、報酬を得た。報告された比較では、この差は統計的に有意だった。聞き取りでは、アバターはより親しみやすい、同僚に近いと表現されることがあり、その印象を自分の評価や報酬と結びつける人もいた。一方で、聞き取りからは、人間に似たアシスタントを明確に好む傾向は見られなかった。多くの参加者は、明らかに人間ではない外見のものをむしろ使いたいと述べた。
この食い違いは、職場向けAIの設計者にとって有用だ。課題の直後に得る評価と、将来使う際の好みについての回答は、異なる問いに答えている。研究は、今回の特定のデザインでは両者が必ずしも同じ方向に動かないことを示している。AIアシスタントの普遍的に好まれる外見を特定したわけではない。
JohanとJohannaの結果から言えること
各参加者は、人間に似た二つのアバターのうち一つだけに接したため、JohanとJohannaの比較は異なる参加者間で行われた。Johanは人間らしさをより高く評価され、より多くの金銭を配分された。著者らによると、信頼や貢献への評価には、二つのアバター間で統計的に有意な差はなかった。
聞き取りに答えた多くの人は、アシスタントの性別が自分の判断に影響すべきではないと述べ、性別のないアシスタントを好む人も多かった。このような回答と測定された報酬差は並存するが、金銭の配分が異なった理由を証明するものではない。研究者が説明するように、この研究で使ったのは男性の外見のアバター一つと女性の外見のアバター一つだった。二つは知覚された人間らしさにも違いがあり、それぞれのデザインの他の特徴が影響した可能性もある。効果を性別に帰属させるには、複数のアバターを使い、これらの手がかりを独立に変えて調べる必要がある。
一般に公開された論文の記録には、2026年の学会研究とDOIが示されている。BIG CHANGEはACMや大学のリポジトリから全文を入手できなかった。そのため本記事は、統計表を改めて検証したものではなく、著者らが公開した説明に基づく。BIG CHANGEは論文全文から報酬額や効果量を独自に確認できなかった。
以前のジェンダーバイアス監査に関するBIG CHANGEの記事は、AIモデルの回答の違いを調べていた。今回の実験は、同じ基盤アシスタントの表現の違いに人々がどう反応するかを扱う。二つの研究は、異なる結果指標を通じて、関連するバイアスの問いに取り組んでいる。
出典と参考資料
- 人間に似ていて男性?VRでの仕事におけるAIアシスタントのデザインと信頼・金銭的報酬との関係。チューリヒ大学ソフトウェア工学の人間的側面研究室のIsabelle Cuber、2026年10月14日。研究の設定、報告された比較、聞き取り、限界を研究者が説明している。この文章による説明には、数値による効果量や完全な統計表は含まれていない。
- 研究の出版記録。リムリック大学、2026年。論文の著者、学会での出版、DOI 10.1145/3829807.3829910を確認でき、要旨も掲載されている。方法や表を独自に検証するための全文にはアクセスできなかった。
- ジェンダーバイアス監査で10のAIモデルが大きく異なる回答を示す。BIG CHANGE、2026年10月2日。モデル出力の挙動に関する関連記事であり、参加者の評価と報酬を扱う今回の研究とは異なる。