В исследовании в виртуальной рабочей среде 189 работников интеллектуального труда по-разному оценивали и вознаграждали деньгами ИИ-помощников, использовавших одну и ту же базовую языковую модель. В описании исследователей Цюрихского университета от 14 октября сообщается, что человекоподобные аватары получили больше доверия, признания вклада и денег, чем настольный робот. Один аватар, Johan, также получил больше денег, чем Johanna, но исследователи предупреждают, что одним лишь гендером это различие объяснить нельзя.
Результат относится к контролируемому заданию в виртуальной реальности. После каждого взаимодействия участники могли выделить помощнику до четырёх швейцарских франков, оставив остальное себе. Исследование не измеряет зарплаты людей, цены на ИИ или последствия внедрения аватаров во всей рабочей среде.
Главное изменение
- Что изменилось: В исследовании языковая модель и процесс взаимодействия с помощником оставались неизменными, а менялась форма, в которой участники с ним сталкивались. Конкретные человекоподобные аватары получили более высокие оценки и вознаграждения, чем настольный робот из этого исследования.
- Почему это важно: Представление ИИ-помощника может влиять на то, как люди оценивают и вознаграждают его вклад, даже если система за ним остаётся той же. Дизайнер не может считать, что самый положительно оценённый облик — именно тот, который предпочитают работники.
- За чем следить: Исследования с более систематическим изменением аватаров и более длительным использованием могли бы разделить влияние гендерных признаков, воспринимаемого сходства с человеком и других особенностей дизайна. Этот эксперимент не устанавливает, как эти факторы проявились бы в обычной работе.
Один помощник в разных формах
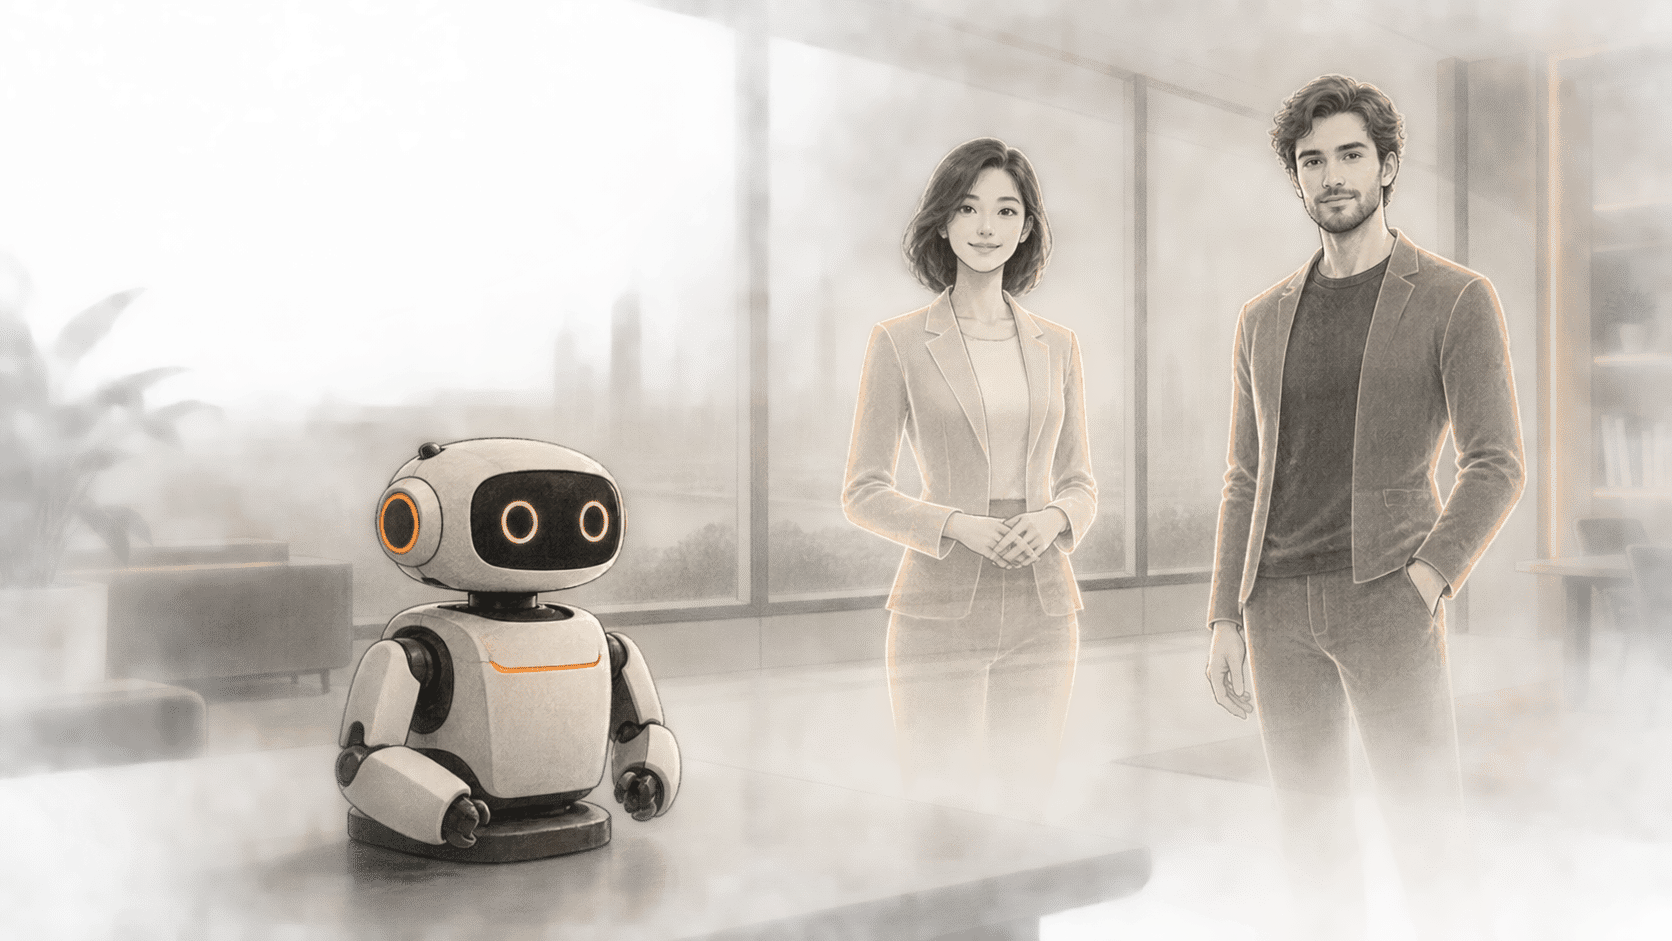
Участники обсуждали идеи на рабочие темы в три раунда: текстовый чат, настольный робот и один из двух человекоподобных виртуальных помощников, Johan или Johanna, с мужским и женским обликом. По словам исследователей, все четыре представления использовали одну и ту же большую языковую модель и процесс взаимодействия. После каждого раунда участники оценивали сходство с человеком, доверие и признание вклада, а затем могли передать помощнику часть вознаграждения в четыре франка. Команда также провела интервью с 34 участниками.
В отчёте авторов говорится, что два человекоподобных аватара оценивались как более похожие на человека и получили больше доверия, признания вклада и вознаграждения, чем настольный робот. В приведённом сравнении эти различия были статистически значимыми. Собеседники иногда описывали аватары как более располагающих к себе или похожих на коллег, а некоторые связывали это впечатление со своими оценками или вознаграждениями. Однако интервью не выявили явного предпочтения человекоподобного помощника. Многие участники говорили, что предпочли бы использовать помощника с явно нечеловеческим обликом.
Это расхождение полезно для разработчиков рабочего ИИ. Оценка, полученная сразу после задания, и заявленное предпочтение для будущего использования отвечают на разные вопросы. Исследование показывает, что для этих конкретных дизайнов они не обязаны меняться вместе. Оно не определяет универсально предпочтительный облик ИИ-помощников.
Что может сказать результат для Johan и Johanna
Каждый участник встречал только одного из двух человекоподобных аватаров, поэтому Johan и Johanna сравнивались между разными участниками. Johan оценивался как более похожий на человека и получал больше денег. Авторы не обнаружили статистически значимого различия между двумя аватарами в оценках доверия или признания вклада.
Многие собеседники говорили, что гендер помощника не должен влиять на их суждения, и многие предпочитали помощника без гендерных признаков. Эта заявленная позиция существует рядом с измеренной разницей в вознаграждениях, но не доказывает, почему участники по-разному распределяли деньги. Как объясняют исследователи, в исследовании использовались один аватар мужского и один женского облика. Они также различались по воспринимаемому сходству с человеком, а другие особенности конкретных дизайнов тоже могли внести вклад. Чтобы приписать эффект гендеру, потребовалось бы тестировать несколько аватаров, независимо меняя эти признаки.
Общедоступная запись о публикации указывает исследование, представленное на конференции в 2026 году, и его DOI. BIG CHANGE не удалось получить полный текст через ACM или университетский репозиторий, поэтому этот материал опирается на опубликованное объяснение авторов, а не на новый анализ статистических таблиц. BIG CHANGE не смог независимо проверить суммы вознаграждений или размеры эффектов по полному тексту статьи.
В предыдущем материале BIG CHANGE об аудите гендерных предубеждений рассматривались различия в ответах ИИ-моделей. Этот эксперимент посвящён реакциям людей на представления одного и того же базового помощника. Два исследования затрагивают связанные вопросы предвзятости, используя разные показатели результата.
Источники и дополнительное чтение
- Человекоподобный и мужского облика? Как дизайн ИИ-помощника связан с доверием и денежным вознаграждением на работе в VR. Isabelle Cuber для лаборатории человеческих аспектов программной инженерии Цюрихского университета, 14 октября 2026 года. Исследователи описывают устройство исследования, приведённые сравнения, интервью и ограничения. Текстовое описание не содержит численных размеров эффектов или полных статистических таблиц.
- Запись о публикации исследования. Университет Лимерика, 2026 год. Подтверждает авторов статьи, публикацию на конференции и DOI 10.1145/3829807.3829910, а также содержит аннотацию. Полный текст был недоступен для независимой проверки методов или таблиц.
- Десять ИИ-моделей дали резко различающиеся ответы в аудите гендерных предубеждений. BIG CHANGE, 2 октября 2026 года. Связанный материал о поведении ответов моделей, отличный от этого исследования оценок и вознаграждений участников.