
Un client modifie l’adresse d’une commande. Son message demande aussi un remboursement, mentionne un colis endommagé et laisse entendre que c’est la troisième fois qu’un problème survient. Transformer ce message en une réponse utile est une chose. Décider quels dossiers mettre à jour, quelle équipe doit intervenir et quelles actions nécessitent une autorisation en est une autre.
Jev, le modèle lancé en accès anticipé par TypeSafe AI le 15 septembre 2026, vise à prendre ce type de décisions. Il produit des réponses structurées et contraintes destinées aux logiciels. Ce lancement invite à se demander quelle part d’une application devrait dépendre d’une longue conversation avec un modèle généraliste. L’annonce de lancement de TypeSafe
L’argument est développé en détail dans l’entretien du 21 septembre entre Latent Space et Diogo Almeida, cofondateur et PDG de TypeSafe, animé par swyx. Nous avons examiné les sous-titres anglais complets de cette conversation de deux heures et vingt-deux minutes et vérifié la documentation du produit. Il s’agit d’une analyse de cet entretien et des informations publiques ; nous n’avons pas évalué Jev de manière indépendante. Voir l’entretien original
Selon notre lecture, la proposition la plus importante de Jev concerne l’unité d’automatisation. Une entreprise pourrait automatiser un jugement circonscrit dans un processus existant avant de pouvoir lui confier de manière responsable l’ensemble du processus. Si ce jugement devient assez peu coûteux pour être répété et assez clair pour être mesuré, les logiciels professionnels courants pourraient acquérir des capacités utiles sans transformer chaque interaction en séance de clavardage.
Cela aurait des conséquences pour les personnes qui conçoivent les processus de travail autant que pour celles qui les utilisent. Il faut toujours décider quelles actions sont autorisées, ce qui constitue une erreur et qui traite les exceptions. La qualité de ces décisions déterminera si cette approche produit des services fiables ou accélère simplement les erreurs.
Ce que TypeSafe a réellement lancé
L’interface documentée de Jev reçoit un état et un ensemble de questions typées. Elle repose sur trois primitives : Choice, qui sélectionne parmi des options définies ; Score, qui évalue selon une grille ; et Noul, qui exprime la probabilité d’un énoncé sur une échelle de zéro à un. Choice et Score renvoient des distributions et un champ de confiance. Noul ne comporte pas de champ de confiance distinct. Les questions peuvent porter sur le même état fourni tout en étant évaluées indépendamment. La documentation de l’interface TypeSafe
Dans une application de service à la clientèle, un développeur pourrait utiliser ces primitives pour distinguer une demande de changement d’adresse d’une annulation, évaluer le degré d’urgence et vérifier si un message contient des éléments attestant d’un dommage. Ce sont des exemples hypothétiques, et non des résultats d’un déploiement de Jev. L’application déciderait ensuite de la suite à donner aux réponses.
Cette séparation est utile, car interpréter et autoriser relèvent de responsabilités différentes. Une IA peut déduire qu’un client souhaite un remboursement. Elle ne devrait pas obtenir le droit de l’accorder simplement parce qu’elle est arrivée à cette conclusion. L’application peut vérifier la commande, faire respecter une limite de remboursement et demander une approbation si nécessaire.
TypeSafe appelle cette catégorie de modèles « System One », en référence à la pensée rapide et intuitive. Il faut comprendre ce nom comme une description du type de tâches visé. Il ne certifie pas une cognition semblable à celle d’un humain et n’établit pas de frontière nette entre tâches faciles et difficiles. Une question courte peut cacher un jugement complexe, surtout lorsque des informations nécessaires manquent.
Le changement d’ingénierie : de petites décisions qui peuvent être examinées
Almeida préconise la décomposition : poser des questions ciblées, puis combiner les réponses dans le code. Entretien, 1 h 03 min 02 s
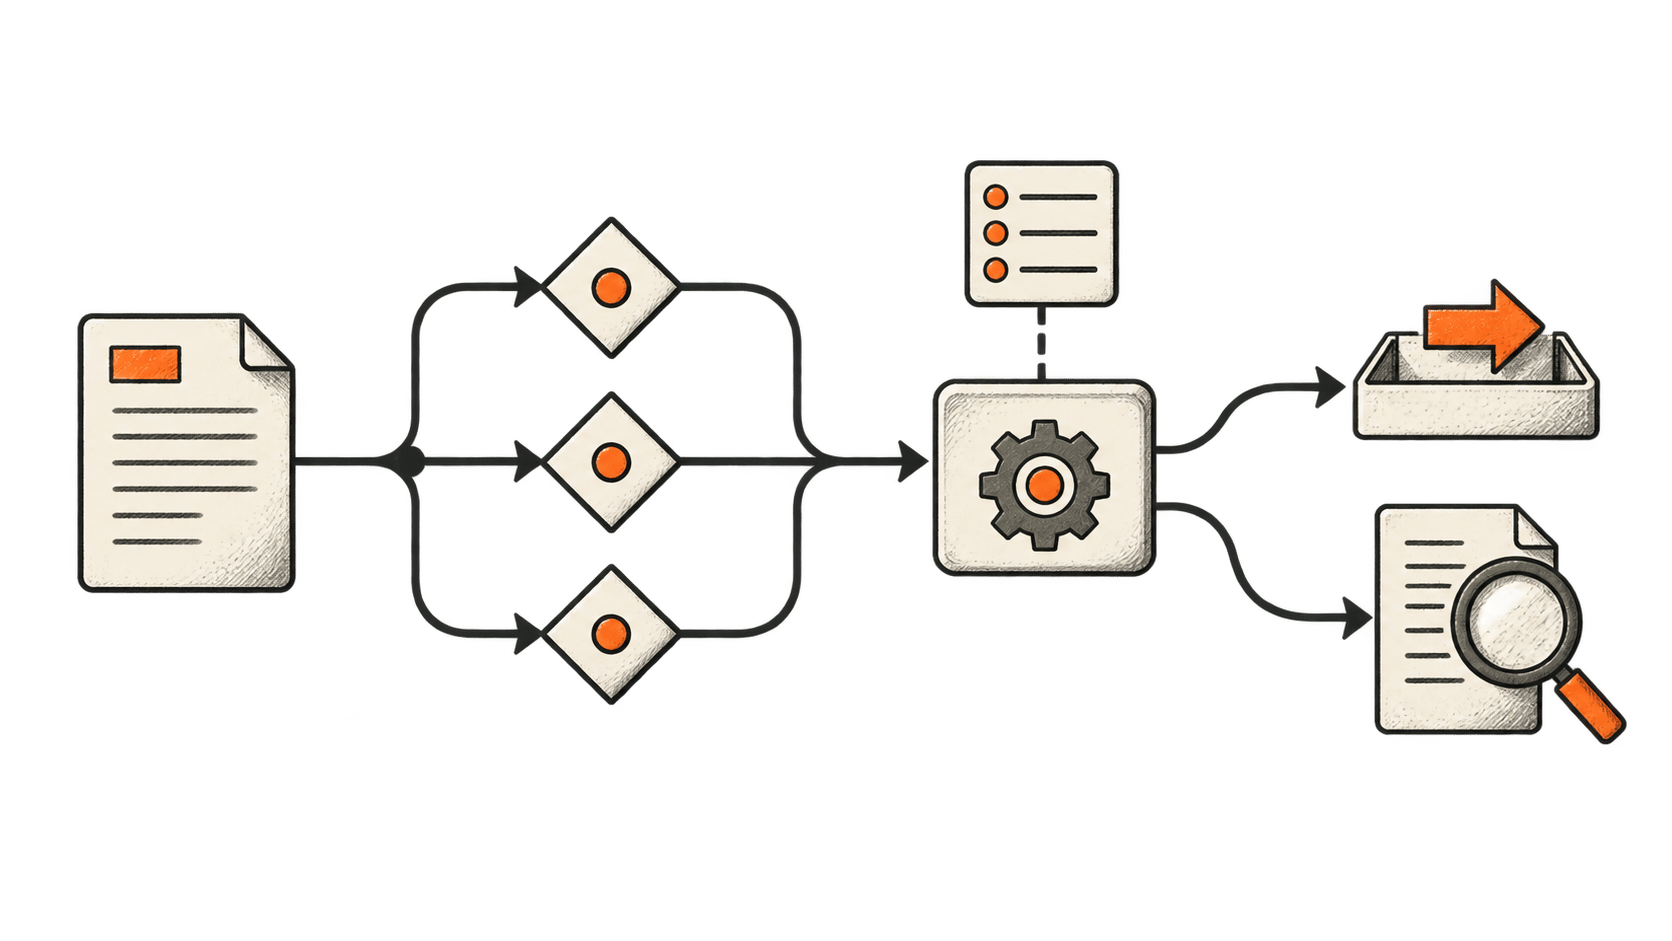
Reprenons l’exemple de la commande endommagée. Une seule consigne visant à traiter la réclamation dissimule plusieurs jugements dans une même réponse. Une conception plus vérifiable déterminerait séparément l’action demandée, si la commande peut être identifiée et si les éléments disponibles étayent la déclaration de dommage. Les règles de politique resteraient distinctes de ces jugements.
Une défaillance devient alors plus facile à examiner. Si le système oriente une demande de changement d’adresse vers l’équipe des retours, l’opérateur peut vérifier cette décision d’aiguillage. Si l’évaluation du dommage est erronée, ce composant peut être testé sur des cas antérieurs. Une modification de politique peut changer une règle explicite sans obliger l’équipe à réécrire une consigne générale et à espérer que le modèle l’interprète de façon cohérente.
Cette approche a aussi un coût. Plus il y a de composants, plus il faut d’interfaces à maintenir. Les questions peuvent omettre par inadvertance un contexte qui rendrait la réponse évidente. Deux jugements apparemment indépendants peuvent s’appuyer sur les mêmes éléments trompeurs. Un processus composé d’éléments acceptables pris séparément peut tout de même aboutir à un résultat inacceptable.
Les modèles documentés par TypeSafe prévoient notamment de poser plusieurs questions simultanément, de combiner des scores et d’orienter les cas incertains vers un traitement complémentaire. Ils décrivent des options d’architecture, et non la preuve qu’un processus client particulier peut fonctionner sans surveillance. Les modèles de TypeSafe
Il faut vérifier si la décomposition améliore à la fois le diagnostic et les résultats. Pouvoir expliquer quelle étape a échoué est utile. Le véritable argument commercial consiste à réduire la fréquence et les conséquences de ces défaillances.
Une réponse conforme peut tout de même être erronée
L’affirmation de lancement selon laquelle Jev « ne peut pas halluciner » doit être interprétée de façon très restreinte. TypeSafe rattache sa garantie au respect du schéma de sortie autorisé. Cela ne prouve pas qu’une réponse choisie soit vraie. Dans sa propre annonce, l’entreprise distingue les garanties liées au schéma de l’évaluation empirique. L’explication de TypeSafe sur la sûreté des types
Supposons qu’une application autorise les valeurs damaged, late et other. Renvoyer damaged est parfaitement conforme même si le colis était simplement en retard. Un modèle incapable d’inventer une quatrième catégorie peut tout de même choisir la mauvaise. Si la liste ne comprend pas une catégorie réellement nécessaire, le schéma lui-même devient une partie du problème.
Les sorties structurées sont également une approche d’ingénierie déjà établie. OpenAI a présenté les Structured Outputs contraintes par schéma en août 2024, en précisant explicitement qu’un modèle pouvait encore se tromper dans les valeurs renvoyées. Il faut donc évaluer Jev en fonction de sa combinaison particulière de qualité décisionnelle, de signalement de l’incertitude, de latence et de coût, au lieu de lui attribuer l’invention de toutes les sorties structurées par l’IA. L’annonce originale d’OpenAI et ses limites
Pour les acheteurs, cette distinction modifie le plan d’évaluation. Un test de schéma vérifie si un logiciel peut traiter une réponse. Un test factuel vérifie si la réponse concorde avec les éléments disponibles. Un test de politique détermine si l’action qui en découle est autorisée. Réussir l’un ne dispense pas de réussir les autres.
Le principal défi soulevé dans l’entretien concerne la calibration
À 1 h 09 min, Almeida rejette l’idée d’une calibration parfaite et reconnaît que les modèles commettent des erreurs. Entretien, 1 h 08 min 50 s
La calibration consiste à comparer les probabilités prédites aux résultats observés pour des groupes de prédictions. Un modèle peut être utile pour signaler son incertitude sans avoir raison dans chaque cas auquel il attribue une forte probabilité. L’introduction de TypeSafe maintient explicitement cette distinction. L’explication de TypeSafe sur la calibration
Le champ de confiance de l’API nécessite une autre distinction. Selon TypeSafe, il s’agit d’une statistique dérivée de la distribution des réponses. Ce champ n’équivaut pas à une probabilité mesurée indépendamment que la réponse choisie soit correcte. La documentation recommande de fixer des seuils adaptés à la tâche et à ses conséquences. La documentation de TypeSafe sur la confiance
Ce sont des considérations pratiques. Imaginons qu’un modèle d’aiguillage fonctionne bien sur des messages courts en anglais, mais peine à traiter de longues réclamations qui mêlent plusieurs demandes. Un score global unique peut masquer cette faiblesse. Une décision assortie d’un niveau de confiance élevé dans le groupe le plus difficile peut mériter davantage d’examen que le même chiffre affiché pour le groupe habituel.
Une équipe devrait donc évaluer les cas auxquels elle s’attend, notamment les informations manquantes, les formulations inhabituelles et les entrées délibérément déroutantes. Elle devrait examiner les erreurs par catégorie et comparer le coût d’un renvoi pour vérification à celui d’une action incorrecte. Les seuils deviennent alors des choix opérationnels étayés par des éléments concrets, plutôt que des chiffres repris d’une démonstration.
Les recherches sur la calibration sont bien antérieures à Jev. Un article de 2017 de Chuan Guo et de ses collègues, souvent cité, étudiait la mauvaise calibration des réseaux neuronaux modernes et les méthodes pour l’améliorer. Ces travaux éclairent le problème, mais ne valident pas le modèle de TypeSafe. On the Calibration of Modern Neural Networks
La fiabilité dépend aussi de ce qui se passe quand le service évolue
L’entretien distingue la robustesse du déterminisme et aborde la stabilité des versions sans promettre de prise en charge à long terme de manière générale. Entretien, 41 min 24 s et 49 min 40 s
Il s’agit de questions d’achat distinctes. Le déterminisme consiste à savoir si des entrées identiques produisent des sorties identiques. La robustesse indique si une modification sans importance, comme un identifiant de dossier différent, entraîne un changement de comportement déraisonnable. Un modèle pourrait répéter indéfiniment la même réponse erronée tout en restant déterministe. Il pourrait aussi varier légèrement alors que le processus de travail qui l’entoure demeure fiable.
Aucune de ces propriétés ne règle le risque lié au cycle de vie. Une entreprise doit savoir quelle version du modèle a produit une décision, si cette version restera disponible et comment une version de remplacement sera évaluée. Une amélioration des résultats obtenus lors des tests du fournisseur peut malgré tout modifier le comportement d’un processus client soigneusement ajusté.
La réponse raisonnable consiste à conserver des cas représentatifs, à enregistrer les versions et à comparer les remplaçants avant de migrer les tâches lourdes de conséquences. Il faut aussi prévoir une solution de repli : même un service de décision précis peut devenir indisponible. Si l’application ne peut ni suspendre le travail de façon sûre ni le rediriger, sa disponibilité devient, dans la pratique, un élément de la qualité de ses décisions.
C’est là qu’une API séduisante devient une dépendance opérationnelle. Les achats, la surveillance et la planification des migrations ne disparaissent pas lorsque le modèle devient plus rapide. On peut davantage les négliger parce que chaque appel semble si simple.
Pourquoi les chiffres de vitesse et de prix doivent être remis en contexte
Les principaux résultats de TypeSafe sur ses processus de travail font état d’améliorations maximales de 193,6 fois en vitesse et de 444,6 fois en coût. L’annonce précise qu’il s’agit des gains les plus élevés obtenus sur des processus conçus par l’entreprise. Les réponses de référence provenaient des estimations de probabilité d’autres modèles, et non de classifications de référence vérifiées indépendamment. L’entreprise avertit également que sa courte démonstration favorise Jev et qu’il reste à établir un tarif viable à long terme. Les réserves de TypeSafe sur son évaluation
Ces réserves doivent accompagner les chiffres. La concordance avec un modèle de référence peut être informative, mais elle mesure autre chose que l’exactitude par rapport à un dossier client dont l’issue est établie. Un processus conçu par un fournisseur peut éclairer les décisions d’un acheteur sans refléter la distribution des demandes de ce dernier.
La comparaison pertinente doit couvrir l’ensemble du travail : réunir le contexte, prendre des décisions, appliquer les règles, traiter les exceptions et se remettre des échecs. Un appel moins coûteux au modèle peut s’accompagner d’un coût total plus élevé s’il envoie trop de travail aux personnes chargées de la vérification. Un appel plus lent peut être rentable s’il évite des reprises coûteuses.
La latence doit également être mesurée depuis la région où se trouve réellement l’application. Une démonstration proche de l’infrastructure du service ne garantit pas la même expérience pour un utilisateur ailleurs. Les systèmes interactifs devraient examiner les requêtes lentes aussi bien que la moyenne ; pour les traitements en arrière-plan, le débit et le coût total peuvent compter davantage.
Le nom de Jev évoque l’idée selon laquelle les gains d’efficacité peuvent élargir la consommation. À l’échelle d’une entreprise, cela soulève une question budgétaire : quelles nouvelles décisions méritent désormais d’être évaluées, et lesquelles ne deviennent que suffisamment bon marché pour être évaluées sans nécessité ? Multiplier les appels au modèle n’est pas un résultat en soi.
Un autre objectif de recherche, dont les éléments probants restent incomplets
L’argument de recherche d’Almeida relie les données, le choix des tâches et le RLCD à sa critique de l’optimisation des préférences. Entretien, 7 min 23 s et 22 min 12 s
RLCD signifie « Reinforcement Learning for Calibrated Decisions » (apprentissage par renforcement pour des décisions calibrées). TypeSafe le présente comme un entraînement visant des décisions et des probabilités exploitables, par opposition aux méthodes fondées sur les préférences humaines et les récompenses vérifiables. C’est le descriptif de l’objectif fourni par l’entreprise. Il ne faut pas le confondre avec une vérification indépendante de l’ensemble de la méthode d’entraînement. L’introduction à l’IA de TypeSafe
La question plus générale mérite d’être étudiée même tant que la méthode est en cours d’évaluation : quel comportement l’objectif d’entraînement récompense-t-il ? Un modèle optimisé pour produire une explication convaincante peut être agréable à utiliser sans présenter son incertitude sous une forme exploitable par du code. Une interface axée sur la décision peut faciliter le traitement de l’incertitude, mais ses sorties doivent toujours être confrontées à la réalité par des vérifications externes.
TypeSafe relie cette préoccupation à la réduction de la diversité des réponses : l’optimisation des préférences peut concentrer les sorties probables sur celles que les utilisateurs récompensent. C’est l’explication d’un mode de défaillance proposée par l’entreprise, et non la preuve que tout modèle entraîné à partir de préférences est inutilisable pour prendre des décisions. L’analyse de TypeSafe sur l’optimisation des préférences
Le parcours d’Almeida rend cet argument particulièrement intéressant. Il est coauteur de l’article sur InstructGPT, qui étudiait l’entraînement de modèles de langage à suivre des instructions à l’aide de retours humains. Cette contribution est vérifiable ; les affirmations générales sur les erreurs de tous les laboratoires relèvent d’un autre ordre. L’article sur InstructGPT
Ses objections aux dépenses de préentraînement et à la création de nouveaux laboratoires sans objectif défini s’inscrivent dans le même argument sur le choix de tâches utiles. Entretien, 1 h 49 min 32 s et 2 h 03 min 10 s
Pour un acheteur, la leçon pertinente est de demander ce que le produit peut accomplir dans un processus défini. Le parcours de recherche, les dépenses de calcul et une architecture distinctive peuvent expliquer comment une entreprise a développé son offre. Ils ne démontrent pas la rentabilité de son déploiement dans l’activité d’une autre entreprise.
L’entretien aborde également le départ d’Almeida d’OpenAI, la difficulté des premiers déploiements et la croissance portée par les développeurs. Entretien, 1 h 31 min 27 s et 1 h 56 min 48 s
Ces témoignages éclairent les priorités de l’entreprise. Ils ne constituent pas des preuves auditées d’adoption. Une plateforme pour développeurs devrait finalement être jugée selon la durabilité et l’utilité des charges de travail, ainsi que selon l’assistance fournie lorsque celles-ci échouent. L’enthousiasme qui suit un lancement justifie une enquête, mais ne remplace pas ces résultats.
Les logiciels existants pourraient gagner davantage qu’une nouvelle fenêtre de clavardage
Almeida prévoit des produits SaaS plus performants et une IA qui s’efface à l’arrière-plan. Entretien, 1 h 19 min 57 s
C’est une piste crédible à explorer : les logiciels comportent déjà des étapes où un jugement utile pourrait influer sur la suite. Une application de planification pourrait repérer une demande ambiguë avant une réservation. Une archive multimédia pourrait classer des documents pour un chercheur. Un service d’assistance pourrait distinguer une mise à jour ordinaire d’une réclamation nécessitant une intervention. Ce sont des conceptions possibles, pas des déploiements de Jev rapportés.
L’interface pourrait à peine changer. Les utilisateurs remarqueraient moins d’erreurs, moins de classifications répétitives ou une attente réduite avant que la bonne personne intervienne. Les entreprises qui comprennent déjà un processus et savent y intégrer de meilleures décisions pourraient en tirer un avantage commercial.
Les éditeurs de logiciels existants resteraient confrontés à la concurrence. Si le même jugement devient accessible à de nombreux développeurs, l’appel au modèle à lui seul ne constitue guère un facteur de différenciation. Le produit qui l’entoure doit fournir un accès utile aux données, une conception d’interaction réfléchie et un moyen fiable de mener le travail à son terme.
Les affirmations sur l’emploi exigent davantage de prudence. Réduire l’effort nécessaire pour une tâche peut modifier les effectifs, accroître le volume de services ou déplacer le travail vers les cas exceptionnels. Ces résultats dépendent de l’organisation et de la demande pour son service. Ni un entretien ni un lancement en accès anticipé ne permettent d’établir que des emplois seront protégés, supprimés ou créés en quantité donnée.
Pour la vue d’ensemble sectorielle de BIG CHANGE, le fait mesurable est la disponibilité d’une autre approche de l’automatisation des décisions. L’adoption à grande échelle, les gains de productivité et les effets sur le marché du travail sont des questions ultérieures qui nécessitent d’autres éléments probants.
Données inexploitées, logiciels en temps réel et limites d’une démonstration
L’entretien aborde les données stockées, les applications interactives, la vérification et les démonstrations d’utilisation d’un ordinateur. Entretien, 1 h 34 min 50 s
Chaque catégorie appelle une évaluation différente. Un traitement d’archives peut tolérer un certain délai, mais doit prévoir l’échantillonnage des résultats et leur traçabilité jusqu’aux dossiers d’origine. Une interface en temps réel doit répondre de manière prévisible. Un vérificateur chargé d’évaluer un autre modèle doit être testé sur les erreurs que celui-ci commet réellement, y compris les cas où les deux systèmes partagent la même erreur.
Pour utiliser un ordinateur, choisir une action n’est qu’une partie du système. Il faut aussi représenter correctement l’interface, disposer d’un moyen d’exécuter l’action et vérifier que le changement attendu s’est produit. Une démonstration soignée peut établir qu’une séquence a réussi une fois ; une automatisation fiable nécessite des essais répétés et une capacité à reprendre après des interruptions.
La même prudence s’applique aux jeux. Un personnage piloté par un modèle pourrait réagir à un état plus riche, tandis que le moteur du jeu continuerait de déterminer les actions possibles. L’amélioration du jeu dépendrait de la réactivité, de la cohérence et de la conception de l’expérience. Ajouter une inférence à chaque image ne rendrait pas automatiquement un jeu plus intéressant.
Ces distinctions évitent une erreur de catégorie : il faut reconnaître la contribution d’un composant utile pour le rôle qu’il remplit, sans lui attribuer toutes les capacités de l’application plus large dans laquelle il s’inscrit.
L’entretien évoque les possibilités de l’ajustement fin, de la vision et d’autres formes de modèles. Entretien, 1 h 10 min 27 s et 1 h 26 min 23 s
Une discussion sur la feuille de route ne doit pas devenir une dépendance dans le plan de lancement. Concevez le système autour de l’interface disponible, repérez les fonctions qu’un composant distinct doit fournir et évaluez chaque nouvelle capacité lorsqu’elle sera réellement disponible. Vous pourrez ainsi tirer parti d’améliorations futures sans présenter des hypothèses comme des fonctions du produit.
Les agents de programmation pourraient répartir le travail autrement
Almeida propose de réduire le coût de la gestion de l’état et de partager le contexte entre agents de programmation, au-delà d’une boucle reposant sur un seul modèle. Entretien, 1 h 40 min 17 s et 2 h 09 min 29 s
Une architecture possible confierait à un modèle de programmation performant l’élaboration d’une modification, à des appels décisionnels plus modestes le classement des fichiers pertinents et à un logiciel classique la gestion des tâches qui en résultent. Un processus d’examen distinct pourrait vérifier le correctif final. Il s’agit d’une proposition de conception, et non d’une recommandation évaluée par comparaison ou de la preuve que Jev remplace déjà un agent de programmation existant.
L’aspect séduisant est la sélection du contexte. Si une sous-tâche ne nécessite qu’une interface et quelques contraintes, lui transmettre toute une conversation peut être inutile. Des fiches de tâche explicites faciliteraient l’identification des faits pertinents, des décisions déjà prises et des modifications encore en attente.
Le danger est de confondre une proposition de coordination avec une garantie de gestion simultanée. Deux agents peuvent tous deux croire qu’ils doivent modifier un fichier. Un modèle probabiliste ne doit pas remplacer les mécanismes logiciels qui empêchent les écritures conflictuelles. Les autorisations, les vérifications de version et les verrous doivent toujours garantir le résultat.
De même, retrouver à moindre coût les travaux antérieurs pourrait améliorer la gestion de la mémoire sans résoudre tous les problèmes désignés par l’expression « apprentissage continu ». Se souvenir d’une tentative précédente, comprendre pourquoi elle a échoué et s’adapter de manière fiable à une nouvelle situation sont des capacités distinctes. Une évaluation convaincante porterait sur les tâches achevées, les régressions, les conflits et les interventions humaines, et ne se limiterait pas à compter les agents ou les appels.
La sécurité se propage dans tout le système ; elle ne disparaît pas
Almeida privilégie les contrôles de sécurité au niveau de l’application plutôt que les refus du modèle ; swyx le pousse à examiner les conséquences. Entretien, 13 min 11 s et 1 h 42 min 29 s
Il existe un véritable problème de conception : une application sans surveillance doit gérer les situations où une dépendance refuse une requête, échoue ou renvoie un résultat incertain. Il lui faut une procédure explicite. Ce constat ne détermine pas à lui seul où chaque mesure de protection devrait se situer.
Une application doit appliquer les autorisations d’accès même si un modèle identifie correctement l’action visée. Une demande de suppression d’un dossier peut être parfaitement comprise tout en restant non autorisée. Une requête peut aussi être techniquement valide et enfreindre la politique de l’opérateur. Le service de décision ne peut répondre de manière responsable à ces questions sans le contexte approprié, et l’application doit conserver la maîtrise de l’action.
Intégrer davantage de décisions dans les logiciels rend donc d’autant plus important de définir les limites avant le déploiement. Les équipes doivent déterminer les éléments nécessaires, les opérations qui doivent rester réversibles et la manière dont une personne peut contester ou corriger un résultat. Supprimer une interaction gênante avec le modèle ne suffit pas à démontrer que le système tout entier est sûr.
Qu’est-ce qui démontrerait un changement majeur ?
Le lancement permet de mener une expérience clairement définie. Choisissez un processus circonscrit dont le résultat est observable. Documentez son fonctionnement actuel, notamment les erreurs et le temps que les personnes consacrent à les corriger. Testez une version fondée sur des décisions avec des cas représentatifs avant de lui donner le pouvoir d’agir.
Mesurez la proportion de cas correctement traités sans intervention, les erreurs qui échappent à la vérification, la charge de travail transmise aux personnes et le coût total par cas traité. Conservez les éléments d’origine afin qu’une personne puisse examiner les raisons de l’acceptation d’un résultat. Recommencez la comparaison lorsque le modèle, la politique ou la population d’entrées change.
Cette évaluation peut révéler que seule une partie du processus est prête. C’est un résultat utile. Automatiser la classification courante tout en confiant les cas ambigus à un opérateur expérimenté peut être intéressant sans justifier une autonomie plus large.
Le lancement de Jev et l’entretien d’Almeida avancent une hypothèse ambitieuse sur l’entrée de l’IA dans l’économie : des décisions répétées et circonscrites peuvent améliorer les logiciels dont les gens dépendent déjà. Les prochains éléments probants devraient provenir de systèmes qui exécutent ce travail au fil du temps, en tenant compte des erreurs et des exceptions. C’est ainsi qu’une architecture de modèle intéressante pourra se traduire par un changement que les lecteurs constateront réellement.


