
ایک گاہک آرڈر پر پتہ بدلتا ہے۔ پیغام میں رقم واپسی کی درخواست، خراب پارسل کا ذکر اور اشارہ بھی ہے کہ یہ تیسری بار کچھ غلط ہوا۔ اس پیغام کا مفید جواب تیار کرنا ایک کام ہے۔ یہ فیصلہ کرنا کہ کون سا ریکارڈ بدلے، کس ٹیم کو مداخلت کرنی چاہیے اور کن اقدامات کے لیے اجازت درکار ہے، الگ کام ہے۔
Jev، وہ ماڈل جسے TypeSafe AI نے 15 ستمبر 2026 کو ابتدائی رسائی میں متعارف کرایا، ایسے فیصلوں کو ہدف بناتا ہے۔ یہ سافٹ ویئر کے لیے محدود، منظم جوابات تیار کرتا ہے۔ اس اجرا سے یہ ازسرِنو سوچنے کی دعوت ملتی ہے کہ کسی ایپلی کیشن کو ہمہ مقصد ماڈل کے ساتھ طویل گفتگو پر کتنا انحصار کرنا چاہیے۔ TypeSafe کا اجرا کا اعلان
یہ دلیل Latent Space کے 21 ستمبر کے انٹرویو میں مکمل طور پر سامنے آتی ہے، جس میں TypeSafe کے شریک بانی اور CEO Diogo Almeida سے میزبان swyx نے بات کی۔ ہم نے دو گھنٹے 22 منٹ کی گفتگو کے مکمل انگریزی کیپشن دیکھے اور مصنوعات کی دستاویزات کی جانچ کی۔ یہ انٹرویو اور عوامی شواہد کا تجزیہ ہے؛ ہم نے Jev کا آزادانہ بینچ مارک نہیں کیا۔ اصل انٹرویو دیکھیں
ہماری قرأت میں Jev کی سب سے اہم تجویز خودکاری کی اکائی سے متعلق ہے۔ کوئی کمپنی پورے عمل کا اختیار ذمہ داری سے دینے سے پہلے، موجودہ عمل کے اندر ایک محدود فیصلے کو خودکار بنا سکتی ہے۔ اگر اس فیصلے کو بار بار دہرانا کافی سستا اور ناپنا کافی واضح ہو جائے تو مانوس کاروباری سافٹ ویئر مفید صلاحیتیں حاصل کر سکتا ہے، بغیر اس کے کہ ہر تعامل چیٹ بن جائے۔
اس سے کام کے طریقے بنانے والوں پر بھی اثر ہوگا اور استعمال کرنے والوں پر بھی۔ اب بھی کسی کو طے کرنا ہے کہ کون سے اقدامات مجاز ہیں، غلطی کسے کہیں گے اور مستثنیٰ معاملات سے کون نمٹے گا۔ ان فیصلوں کا معیار طے کرے گا کہ یہ طریقہ قابلِ اعتماد خدمت بناتا ہے یا صرف غلطیوں کی رفتار بڑھاتا ہے۔
TypeSafe نے حقیقتاً کیا جاری کیا
دستاویزی انٹرفیس میں Jev کو ایک حالت اور متعین اقسام کے سوالات دیے جاتے ہیں۔ اس کے تین بنیادی طریقے ہیں: Choice، جو مقررہ اختیارات میں سے چنتا ہے؛ Score، جو معیارنامے کے مطابق جانچتا ہے؛ اور Noul، جو کسی بیان کے احتمال کو صفر سے ایک کے پیمانے پر ظاہر کرتا ہے۔ Choice اور Score، احتمال کی تقسیم اور اعتماد کا خانہ لوٹاتے ہیں۔ Noul کے پاس اعتماد کا ایسا الگ خانہ نہیں۔ سوالات دی گئی حالت مشترک طور پر استعمال کر سکتے ہیں، مگر ان کا جائزہ الگ الگ لیا جا سکتا ہے۔ TypeSafe کے انٹرفیس کی دستاویزات
گاہک کی خدمت کی ایپلی کیشن میں ڈویلپر ان طریقوں سے پتہ بدلنے کی درخواست کو منسوخی سے الگ، عجلت کا اندازہ اور پیغام میں نقصان کے شواہد کی جانچ کر سکتا ہے۔ یہ فرضی مثالیں ہیں، Jev کی کسی تنصیب کے نتائج نہیں۔ ایپلی کیشن پھر طے کرے گی کہ جوابات کے ساتھ کیا کرنا ہے۔
یہ تقسیم مفید ہے کیونکہ مطلب اخذ کرنا اور اختیار رکھنا دو مختلف ذمہ داریاں ہیں۔ AI اندازہ لگا سکتا ہے کہ گاہک رقم واپسی چاہتا ہے۔ صرف اس نتیجے پر پہنچنے سے اسے رقم واپس کرنے کی اجازت نہیں ملنی چاہیے۔ ایپلی کیشن آرڈر کی جانچ، واپسی کی حد نافذ اور ضرورت کے مطابق منظوری طلب کر سکتی ہے۔
TypeSafe اس ماڈل زمرے کو System One کہتا ہے اور تیز، وجدانی سوچ کے تصور سے نام لیتا ہے۔ اس نام کو مطلوبہ کام کی وضاحت سمجھیں۔ یہ انسان جیسی ذہانت کی سند نہیں، نہ آسان اور مشکل کاموں کے درمیان صاف حد قائم کرتا ہے۔ مختصر سوال میں بھی پیچیدہ فیصلہ چھپا ہو سکتا ہے، خاص طور پر جب ضروری معلومات موجود نہ ہوں۔
انجینئرنگ کی تبدیلی چھوٹے، قابلِ معائنہ فیصلے ہیں
Almeida کام کو حصوں میں بانٹنے کی وکالت کرتے ہیں: محدود دائرے کے سوال پوچھیں، پھر کوڈ میں جوابات یکجا کریں۔ انٹرویو، 1:03:02
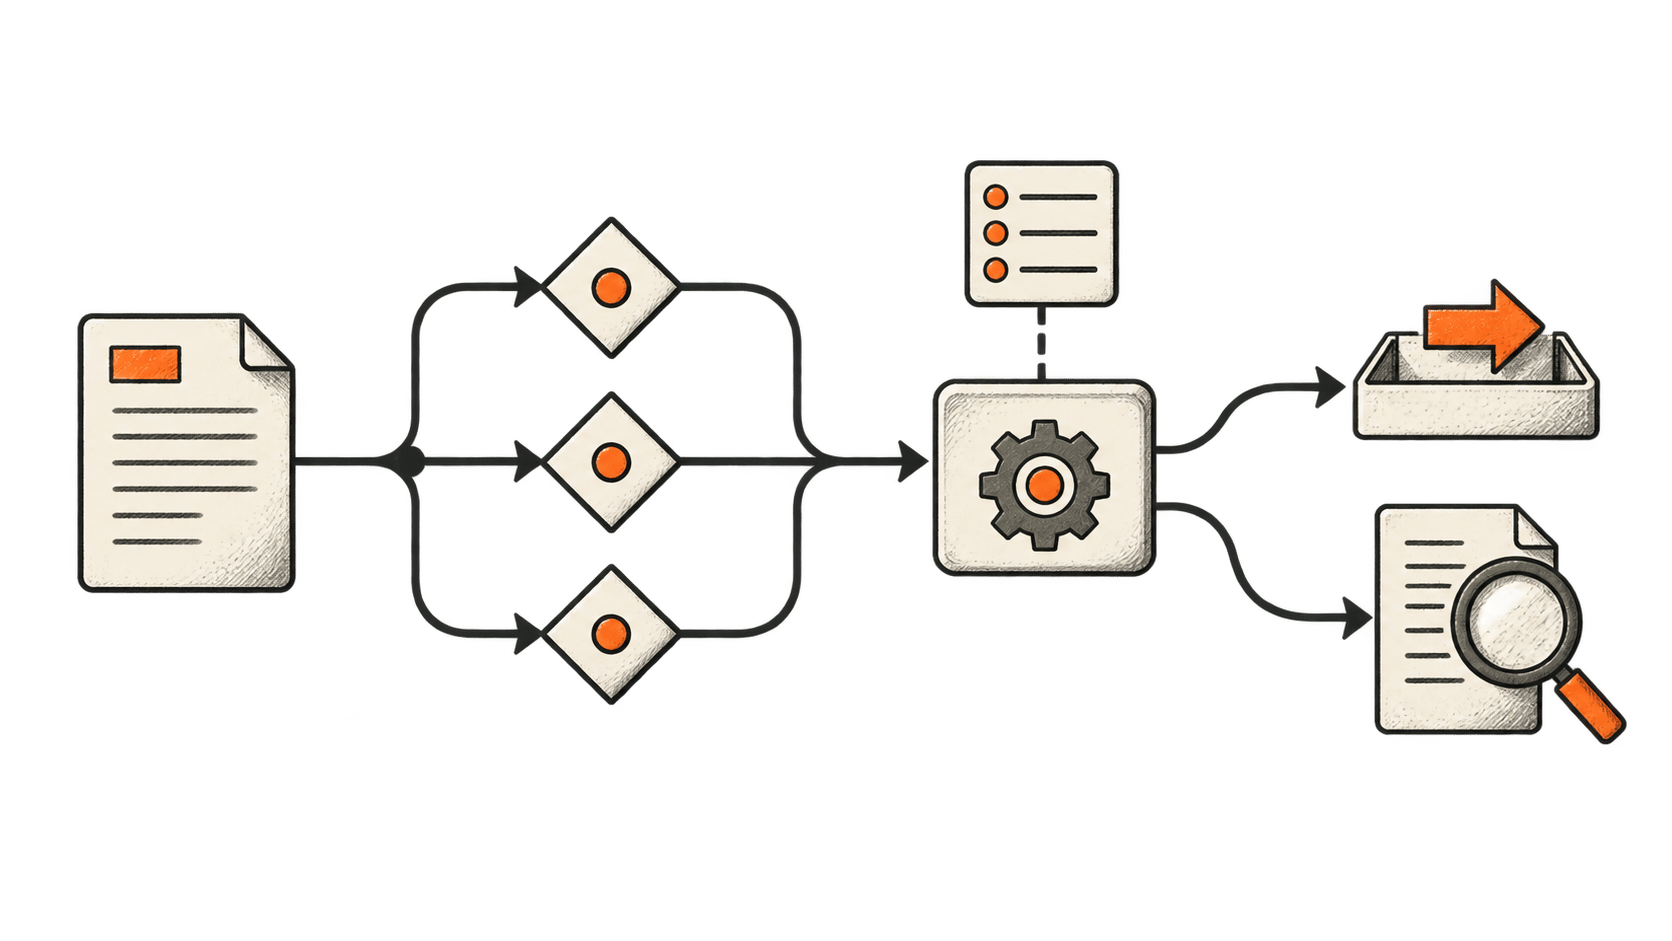
خراب آرڈر کی مثال دوبارہ دیکھیں۔ شکایت سنبھالنے کی ایک ہدایت کئی فیصلوں کو ایک جواب میں چھپا دیتی ہے۔ زیادہ قابلِ معائنہ ڈیزائن پہلے یہ طے کرے گا کہ کون سا اقدام مانگا گیا، آرڈر کی شناخت ہو سکتی ہے یا نہیں، اور دستیاب شواہد نقصان کے دعوے کی تائید کرتے ہیں یا نہیں۔ پالیسی کے قواعد ان فیصلوں سے باہر رکھے جائیں گے۔
اس سے ناکامی کی تحقیق آسان ہوتی ہے۔ اگر نظام پتہ بدلنے کی درخواست کو واپسیوں کی ٹیم کے پاس بھیج دے تو منتظم اس فیصلے کا جائزہ لے سکتا ہے۔ نقصان کا اندازہ غلط ہو تو اس جزو کو پچھلے معاملوں پر آزمایا جا سکتا ہے۔ پالیسی بدلنے کے لیے واضح قاعدہ بدلا جا سکتا ہے، بجائے اس کے کہ وسیع ہدایت دوبارہ لکھی جائے اور امید ہو کہ ماڈل ہر بار اسے یکساں سمجھے گا۔
اس کی لاگت بھی ہے۔ مزید اجزا کا مطلب ہے برقرار رکھنے کے لیے مزید انٹرفیس۔ سوال میں وہ سیاق رہ سکتا ہے جس سے جواب واضح ہو جاتا۔ بظاہر آزاد دو فیصلے ایک ہی گمراہ کن ثبوت پر منحصر ہو سکتے ہیں۔ انفرادی طور پر قابلِ قبول حصوں سے بنا طریقۂ کار پھر بھی ناقابلِ قبول نتیجہ دے سکتا ہے۔
TypeSafe کے دستاویزی نمونوں میں بیک وقت کئی سوال پوچھنا، اسکور ملانا اور غیر یقینی معاملوں کو مزید جانچ کے لیے بھیجنا شامل ہے۔ یہ نظامی ڈیزائن کے انتخاب بیان کرتے ہیں، کسی گاہک کے عمل کو بغیر نگرانی چلانے کے لیے تیار ہونے کا ثبوت نہیں۔ TypeSafe کے نمونے
مفید جانچ یہ ہے کہ کیا حصوں میں بانٹنے سے خرابی کی تشخیص اور نتیجہ دونوں بہتر ہوتے ہیں۔ ناکام مرحلہ سمجھا سکنا قیمتی ہے۔ کاروباری جواز، ان ناکامیوں کی تعداد اور اثر گھٹانے میں ہے۔
درست فارمیٹ کا جواب پھر بھی غلط ہو سکتا ہے
اجرا میں Jev کے «غلط معلومات نہیں گھڑنے» کے دعوے کو محدود معنی میں لینا چاہیے۔ TypeSafe اس ضمانت کو مجاز آؤٹ پٹ اسکیما سے مطابقت کے ساتھ جوڑتا ہے۔ اس سے منتخب جواب کی سچائی ثابت نہیں ہوتی۔ کمپنی کا اپنا اعلان بھی اسکیما کی ضمانت اور تجرباتی جانچ میں فرق کرتا ہے۔ TypeSafe کی ٹائپ سیفٹی کی وضاحت
فرض کریں ایپلی کیشن میں یہ اقدار مجاز ہوں: damaged، late اور other۔ جواب damaged بالکل درست فارمیٹ کا ہوگا، خواہ پارسل محض دیر سے پہنچا ہو۔ چوتھا زمرہ گھڑ نہ سکنے والا ماڈل پھر بھی غلط زمرہ چن سکتا ہے۔ اگر فہرست سے واقعی درکار زمرہ ہی خارج ہو تو مسئلے کا حصہ اسکیما بن جاتا ہے۔
منظم آؤٹ پٹ پہلے سے موجود انجینئرنگ طریقہ بھی ہے۔ OpenAI نے اگست 2024 میں اسکیما کی پابندی والے Structured Outputs متعارف کرائے اور واضح کیا کہ لوٹائی گئی اقدار کے اندر بھی ماڈل غلطی کر سکتا ہے۔ لہٰذا Jev کو اس کے مخصوص امتزاج—فیصلے کے معیار، غیر یقینی کی رپورٹنگ، تاخیر اور لاگت—پر پرکھنا چاہیے، نہ کہ اسے تمام منظم AI آؤٹ پٹ کا موجد قرار دینا چاہیے۔ OpenAI کا اصل اعلان اور حدود
خریداروں کے لیے یہ فرق جانچ کا منصوبہ بدلتا ہے۔ اسکیما کی آزمائش پوچھتی ہے کہ سافٹ ویئر جواب استعمال کر سکتا ہے یا نہیں۔ حقیقت کی آزمائش دیکھتی ہے کہ جواب شواہد سے میل کھاتا ہے یا نہیں۔ پالیسی کی آزمائش پوچھتی ہے کہ اس کے نتیجے میں کیا جانے والا اقدام مجاز ہے یا نہیں۔ ایک میں کامیابی باقی دونوں کی جگہ نہیں لیتی۔
انٹرویو کا سب سے اہم سوال انشانکن سے متعلق ہے
1:09 پر Almeida کامل انشانکن کے دعوے کو رد کرکے ماڈل کی غلطیاں تسلیم کرتے ہیں۔ انٹرویو، 1:08:50
انشانکن سے مراد یہ ہے کہ پیش گوئی کیے گئے احتمالات، پیش گوئیوں کے گروہوں میں دیکھے گئے نتائج سے کیسے میل کھاتے ہیں۔ ماڈل ہر زیادہ احتمال والے معاملے میں درست ہوئے بغیر غیر یقینی ظاہر کرنے میں مفید ہو سکتا ہے۔ TypeSafe کی بنیادی وضاحت یہ فرق واضح رکھتی ہے۔ TypeSafe کی انشانکن سے متعلق وضاحت
API کے اعتماد والے خانے کے بارے میں دوسرا فرق ضروری ہے۔ TypeSafe اسے جواب کی احتمالی تقسیم سے نکلا ہوا شماریہ قرار دیتا ہے۔ یہ اس آزادانہ طور پر ناپے گئے احتمال کے برابر نہیں کہ منتخب جواب درست ہے۔ دستاویزات کام اور اس کے نتائج کے مطابق حدیں چننے کی سفارش کرتی ہیں۔ TypeSafe کی اعتماد سے متعلق دستاویزات
یہ عملی خدشات ہیں۔ فرض کریں کوئی راستہ چننے والا ماڈل مختصر انگریزی پیغامات پر اچھا چلتا ہے مگر لمبی شکایتوں میں الجھ جاتا ہے جن میں کئی درخواستیں ملی ہوں۔ ایک مجموعی اسکور یہ کمزوری چھپا سکتا ہے۔ کمزور گروہ میں زیادہ اعتماد سے کیا گیا فیصلہ، مانوس گروہ کے اسی دکھائے گئے عدد سے زیادہ جانچ کا مستحق ہو سکتا ہے۔
ٹیم کو ان معاملوں کی جانچ کرنی چاہیے جن کی اسے توقع ہے، بشمول نامکمل معلومات، نامانوس عبارت اور دانستہ الجھانے والے اِن پٹ۔ اسے زمرے کے لحاظ سے غلطیاں دیکھنی اور کسی معاملے کو جائزے کے لیے بھیجنے کی لاگت کا غلط عمل کی لاگت سے موازنہ کرنا چاہیے۔ یوں حدیں مظاہرے سے نقل کردہ اعداد کے بجائے شواہد سے سہارے والے عملی فیصلے بنتی ہیں۔
انشانکن پر تحقیق Jev سے بہت پہلے شروع ہو چکی تھی۔ Chuan Guo اور ساتھیوں کے 2017 کے بڑے پیمانے پر حوالہ دیے گئے مقالے نے جدید نیورل نیٹ ورکس میں ناقص انشانکن اور اسے بہتر بنانے کے طریقوں کا جائزہ لیا۔ یہ کام مسئلے کا پس منظر دیتا ہے، TypeSafe کے ماڈل کی توثیق نہیں۔ جدید نیورل نیٹ ورکس کا انشانکن
خدمت بدلنے پر کیا ہوتا ہے، یہ بھی بھروسا مندی کا حصہ ہے
گفتگو میں مضبوطی اور یکسانیت میں فرق، اور عمومی طویل مدتی معاونت کے وعدے کے بغیر نسخوں کے استحکام پر بات کی گئی ہے۔ انٹرویو، 41:24 اور 49:40
یہ خریداری کے الگ الگ سوال ہیں۔ یکسانیت پوچھتی ہے کہ ایک جیسے اِن پٹ ہمیشہ ایک جیسے آؤٹ پٹ دیتے ہیں یا نہیں۔ مضبوطی پوچھتی ہے کہ کوئی غیر متعلق تبدیلی، مثلاً ریکارڈ کا دوسرا شناختی نمبر، برتاؤ میں غیر معقول فرق تو نہیں لاتی۔ ماڈل بار بار وہی غلط جواب دے کر یکساں ہو سکتا ہے۔ آس پاس کا طریقۂ کار قابلِ اعتماد رہتے ہوئے اس کے جواب میں معمولی فرق بھی ہو سکتا ہے۔
ان میں سے کوئی خاصیت زندگی کے دورانیے کا خطرہ حل نہیں کرتی۔ کاروبار کو جاننا چاہیے کہ فیصلہ ماڈل کے کس نسخے سے ہوا، وہ نسخہ دستیاب رہے گا یا نہیں اور متبادل کی جانچ کیسے ہوگی۔ فراہم کنندہ کے آزمائشی معیار پر بہتری بھی گاہک کے احتیاط سے ترتیب دیے گئے طریقۂ کار کا برتاؤ بدل سکتی ہے۔
مناسب ردعمل یہ ہے کہ نمائندہ مثالیں محفوظ رکھیں، نسخے درج کریں اور اہم کام منتقل کرنے سے پہلے متبادل کا موازنہ کریں۔ متبادل راستہ بھی اہم ہے: ورنہ درست فیصلہ خدمت بھی دستیاب نہ رہے۔ اگر ایپلی کیشن محفوظ طریقے سے رک یا کام کہیں اور بھیج نہ سکے تو عملی اعتبار سے دستیابی بھی فیصلے کے معیار کا حصہ بن جاتی ہے۔
یہی وہ مقام ہے جہاں پُرکشش API عملی انحصار بن جاتی ہے۔ خریداری، نگرانی اور منتقلی کی منصوبہ بندی، ماڈل تیز ہونے سے ختم نہیں ہوتی۔ ان کو نظر انداز کرنا آسان ہو جاتا ہے کیونکہ ہر انفرادی کال اتنی سادہ دکھائی دیتی ہے۔
رفتار اور قیمت کے اعداد کو سیاق کیوں چاہیے
TypeSafe کی سرخی میں نمایاں کیے گئے طریقۂ کار کے نتائج میں 193.6 گنا رفتار اور 444.6 گنا لاگت میں کمی شامل ہے۔ اعلان انہیں کمپنی کے تیار کردہ طریقوں سے ملنے والے انتہائی درجے کے فائدے کہتا ہے۔ معیاری جوابات آزادانہ طور پر تصدیق شدہ درست زمروں کے بجائے دوسرے ماڈلوں کے احتمالی تخمینوں سے آئے۔ کمپنی یہ بھی خبردار کرتی ہے کہ اس کا مختصر مظاہرہ Jev کے حق میں تھا اور پائیدار طویل مدتی قیمت ابھی طے ہونی ہے۔ TypeSafe کی جانچ کی شرائط
اعداد کے ساتھ یہ وضاحتیں بھی پیش ہونی چاہییں۔ کسی دوسرے ماڈل کے جواب سے مطابقت معلوماتی ہو سکتی ہے، مگر طے شدہ گاہک کے معاملے سے درستگی ناپنے سے مختلف ہے۔ فراہم کنندہ کا بنایا ہوا طریقۂ کار خریدار کے لیے مفید ہو سکتا ہے، لیکن ضروری نہیں کہ وہ اس خریدار کو ملنے والی درخواستوں کی تقسیم کی نمائندگی کرے۔
درست موازنہ میں پورا کام شامل ہونا چاہیے: سیاق اکٹھا کرنا، فیصلے کرنا، قواعد لگانا، استثنائی حالتیں سنبھالنا اور ناکامی سے بحال ہونا۔ سستا ماڈل کال پھر بھی مجموعی لاگت بڑھا سکتی ہے اگر بہت زیادہ کام جائزہ کاروں کو بھیج دے۔ اگر سست کال مہنگی دوبارہ محنت بچائے تو کم خرچ ثابت ہو سکتی ہے۔
تاخیر بھی ایپلی کیشن کے اصل خطے سے ناپنی چاہیے۔ خدمت کے بنیادی ڈھانچے کے قریب مظاہرہ، دوسری جگہ صارف کے تجربے کا وعدہ نہیں۔ متعامل نظام میں اوسط کے ساتھ سست درخواستیں بھی دیکھی جانی چاہییں؛ پس منظر کے کام میں رفتارِ ترسیل اور کل لاگت زیادہ اہم ہو سکتی ہیں۔
Jev کا نام اس خیال کی طرف اشارہ کرتا ہے کہ کارکردگی میں اضافہ استعمال بڑھا سکتا ہے۔ انفرادی کاروبار کے لیے بجٹ کا سوال یہ ہے: کون سے نئے فیصلے جانچنے کے قابل بنتے ہیں، اور کون سے صرف اتنے سستے ہو جاتے ہیں کہ بلا ضرورت جانچے جائیں؟ مزید ماڈل کالز بذاتِ خود نتیجہ نہیں۔
ایک مختلف تحقیقی مقصد، جس کے شواہد نامکمل ہیں
Almeida کی تحقیقی دلیل ڈیٹا، کام کے انتخاب اور RLCD کو ترجیحی بہتری پر تنقید سے جوڑتی ہے۔ انٹرویو، 7:23 اور 22:12
RLCD کا مخفف ہے Reinforcement Learning for Calibrated Decisions۔ TypeSafe اسے قابلِ استعمال فیصلوں اور احتمالات کی طرف تربیت کہتا ہے، جسے انسانی پسند اور قابلِ تصدیق انعام کے طریقوں سے الگ پیش کیا جاتا ہے۔ یہ تربیت کے مقصد سے متعلق کمپنی کا بیان ہے؛ مکمل طریقۂ تربیت کی آزادانہ توثیق نہیں۔ TypeSafe کی AI بنیادی وضاحت
طریقے کی جانچ جاری رہتے ہوئے بھی وسیع تر سوال اہم ہے: تربیتی مقصد کس رویے کو انعام دیتا ہے؟ قائل کرنے والی وضاحت کے لیے بہتر کیا گیا ماڈل استعمال میں خوشگوار ہو سکتا ہے، مگر شاید غیر یقینی کو اس صورت میں ظاہر نہ کرے جس پر کوڈ عمل کر سکے۔ فیصلہ مرکوز انٹرفیس غیر یقینی سنبھالنا آسان بنا سکتا ہے، پھر بھی آؤٹ پٹ کو حقیقت کے خلاف بیرونی جانچ درکار ہوگی۔
TypeSafe اس خدشے کو mode dropping سے جوڑتا ہے: ترجیحی بہتری ممکنہ آؤٹ پٹ کی وسعت کو ان جوابوں کی سمت سکیڑ سکتی ہے جنہیں لوگ انعام دیتے ہیں۔ یہ ناکامی کی ایک قسم کی کمپنی کی وضاحت ہے؛ یہ نتیجہ نہیں کہ ہر ترجیحی تربیت والا ماڈل فیصلے کرنے کے لیے ناقابلِ استعمال ہے۔ ترجیحی بہتری پر TypeSafe کی گفتگو
Almeida کا پس منظر اس دلیل کو خاص طور پر دلچسپ بناتا ہے۔ وہ InstructGPT مقالے کے شریک مصنف ہیں، جس میں انسانی رائے سے زبان کے ماڈل کو ہدایت پر چلانے کی تربیت کا مطالعہ ہوا۔ یہ تصنیف قابلِ تصدیق ہے؛ ہر تجربہ گاہ کیا غلط کرتی ہے اس بارے میں وسیع دعوے الگ معاملہ ہیں۔ InstructGPT کا مقالہ
پیشگی تربیت کے خرچ اور بے سمت نئی تجربہ گاہوں پر ان کے اعتراض بھی مفید کام چننے سے متعلق اسی دلیل کا حصہ ہیں۔ انٹرویو، 1:49:32 اور 2:03:10
خریدار کے لیے متعلقہ سبق یہ ہے کہ مخصوص عمل میں مصنوعات کے کام کے بارے میں پوچھے۔ تحقیقی پس منظر، کمپیوٹنگ کا خرچ اور منفرد ماڈل ساخت سمجھا سکتی ہے کہ کمپنی نے پیش کش کیسے بنائی۔ وہ کسی اور کے کاروبار میں اس کے استعمال کی معاشیات ثابت نہیں کر سکتے۔
انٹرویو میں Almeida کی OpenAI سے روانگی، ابتدائی طور پر صارفین حاصل کرنے کی مشکل اور ڈویلپرز کی مدد سے ترقی پر بھی گفتگو ہے۔ انٹرویو، 1:31:27 اور 1:56:48
یہ یادداشتیں کمپنی کی ترجیحات سمجھاتی ہیں، آڈٹ شدہ اختیار اپنانے کے شواہد نہیں۔ ڈویلپر پلیٹ فارم کا آخری فیصلہ مسلسل، مفید کام اور ناکامی کے وقت دی جانے والی مدد پر ہونا چاہیے۔ اجرا کے بعد جوش تحقیق کی وجہ ہے، ریکارڈ کا متبادل نہیں۔
نئی چیٹ کی نسبت موجودہ سافٹ ویئر کو زیادہ فائدہ ہو سکتا ہے
Almeida بہتر SaaS مصنوعات اور AI کے پس منظر میں چلے جانے کی توقع کرتے ہیں۔ انٹرویو، 1:19:57
یہ ایسی سمت ہے جس کی تحقیق معقول ہے، کیونکہ سافٹ ویئر میں پہلے ہی ایسی جگہیں ہیں جہاں مفید فیصلہ اگلا قدم بدل سکتا ہے۔ ملاقاتوں کی ایپ بکنگ سے پہلے مبہم درخواست پہچان سکتی ہے۔ میڈیا آرکائیو محقق کے لیے مواد ترتیب دے سکتا ہے۔ خدمت ڈیسک معمول کی تبدیلی اور توجہ چاہنے والی شکایت میں فرق کر سکتا ہے۔ یہ ممکنہ ڈیزائن ہیں، Jev کی رپورٹ شدہ تنصیبات نہیں۔
انٹرفیس میں شاید بہت کم تبدیلی ہو۔ صارف کم غلطیاں، بار بار کی درجہ بندی میں کمی یا درست شخص تک کم انتظار محسوس کریں گے۔ تجارتی فائدہ ان کمپنیوں کو مل سکتا ہے جو طریقۂ کار پہلے سے سمجھتی اور بہتر فیصلے اس میں شامل کر سکتی ہیں۔
موجودہ سافٹ ویئر کاروباروں کو پھر بھی مقابلے کا سامنا ہوگا۔ اگر وہی فیصلہ بہت سے ڈویلپرز کو دستیاب ہو تو صرف ماڈل کال امتیاز بہت کم دیتی ہے۔ اردگرد کی مصنوعات میں مفید ڈیٹا تک رسائی، سوچا سمجھا تعامل اور کام مکمل کرنے کا قابلِ اعتماد طریقہ درکار ہے۔
روزگار کے دعووں میں زیادہ احتیاط چاہیے۔ ایک کام کی محنت گھٹانے سے عملے کی تعداد بدل سکتی ہے، خدمت کا حجم بڑھ سکتا ہے یا کام استثنائی صورتوں کی طرف منتقل ہو سکتا ہے۔ نتیجہ ادارے اور اس کی خدمت کی طلب پر منحصر ہے۔ نہ انٹرویو، نہ ابتدائی رسائی والا اجرا ثابت کرتا ہے کہ کتنی ملازمتیں محفوظ، ختم یا پیدا ہوں گی۔
BIG CHANGE کے صنعتی جائزے کے لیے قابلِ پیمائش واقعہ فیصلوں کی خودکاری کے ایک اور طریقے کی دستیابی ہے۔ وسیع پیمانے پر اختیار اپنانا، پیداوار میں اضافہ اور روزگار پر اثر بعد کے سوال ہیں، جن کے لیے الگ شواہد درکار ہیں۔
پوشیدہ ڈیٹا، حقیقی وقت کا سافٹ ویئر اور مظاہرے کی حدود
انٹرویو میں محفوظ ڈیٹا، متعامل ایپلی کیشن، تصدیق اور کمپیوٹر استعمال کے مظاہروں پر بات ہے۔ انٹرویو، 1:34:50
ہر زمرہ الگ جانچ تجویز کرتا ہے۔ آرکائیو کی پراسیسنگ کچھ تاخیر سہہ سکتی ہے، مگر نتائج کے نمونے لینے اور انہیں اصل ریکارڈ تک پہنچانے کا منصوبہ چاہیے۔ فوری تعامل کو متوقع رفتار چاہیے۔ دوسرے ماڈل کو جانچنے والے آلے کو ان غلطیوں پر آزمایا جائے جو اس ماڈل سے حقیقتاً ہوتی ہیں، بشمول ایسے معاملے جہاں دونوں کا ایک ہی جواب غلط ہو۔
کمپیوٹر استعمال میں اقدام چننا نظام کا ایک ہی حصہ ہے۔ اسے انٹرفیس کی درست نمائندگی، اقدام کرنے کا طریقہ اور یہ جانچ درکار ہے کہ متوقع تبدیلی ہوئی یا نہیں۔ چمک دار مظاہرہ ثابت کر سکتا ہے کہ ایک بار ترتیب چل گئی؛ قابلِ اعتماد خودکاری کے لیے بار بار آزمائش اور رکاوٹوں سے بحالی چاہیے۔
کھیلوں پر بھی یہی احتیاط لاگو ہوتی ہے۔ ماڈل سے چلنے والا کردار مزید معلومات پر ردعمل دے سکتا ہے، جبکہ کھیل کا انجن یہ طے کرتا رہتا ہے کہ کون سے اقدامات ممکن ہیں۔ کھیل بہتر ہوا یا نہیں، یہ ردعمل کی رفتار، یکسانیت اور تجربے کے ڈیزائن پر منحصر ہے۔ ہر فریم میں استدلال شامل کرنے سے کھیل خودبخود دلچسپ نہیں ہوگا۔
یہ فرق زمرے کی غلطی سے بچاتے ہیں: جزو کو اس کے اصل کردار کا سہرا دیں، اردگرد کی پوری ایپلی کیشن کی ہر صلاحیت کا نہیں۔
انٹرویو میں fine-tuning، بصارت اور اضافی ماڈل ساختیں بطور امکان زیرِ بحث آتی ہیں۔ انٹرویو، 1:10:27 اور 1:26:23
روڈ میپ پر گفتگو کو اجرا کے منصوبے کا انحصار نہیں بنانا چاہیے۔ دستیاب انٹرفیس کے مطابق بنائیں، شناخت کریں کہ الگ جزو کو کیا فراہم کرنا ہے، اور نئی سہولت حقیقتاً آنے پر اسے جانچیں۔ اس طرح مستقبل کی بہتری سے فائدہ لینے کی گنجائش رہتی ہے، بغیر قیاس کو مصنوعات کی خصوصیت ظاہر کیے۔
کوڈنگ ایجنٹ کام مختلف انداز میں تقسیم کر سکتے ہیں
Almeida ایک ماڈل کے مسلسل چکر سے آگے، کوڈنگ ایجنٹوں کے لیے سستی حالت سنبھالنے اور مشترک سیاق کی تجویز دیتے ہیں۔ انٹرویو، 1:40:17 اور 2:09:29
ایک ممکنہ ساخت میں قابل ماڈل تبدیلی تیار کرے، چھوٹی فیصلہ کالیں متعلقہ فائلیں چھانٹیں اور معمول کا سافٹ ویئر نتیجے والے کام منظم کرے۔ الگ جائزہ کار آخری تبدیلی دیکھ سکتا ہے۔ یہ ڈیزائن کی تجویز ہے، بینچ مارک شدہ سفارش یا اس بات کا ثبوت نہیں کہ Jev پہلے ہی موجودہ کوڈنگ ایجنٹ کی جگہ لیتا ہے۔
پرکشش بات منتخب سیاق ہے۔ اگر ذیلی کام کے لیے ایک ہی انٹرفیس اور چند پابندیاں درکار ہوں تو پوری گفتگو بھیجنا ضیاع ہو سکتا ہے۔ واضح کام ریکارڈ سے یہ شناخت آسان ہوگی کہ کون سے حقائق اہم، کیا طے ہو چکا اور کون سی تبدیلی باقی ہے۔
خطرہ یہ ہے کہ ہم آہنگی کی تجویز کو بیک وقت محفوظ لکھنے کی ضمانت سمجھ لیا جائے۔ دو ایجنٹ بیک وقت فائل لکھنا چاہ سکتے ہیں۔ احتمالی ماڈل کو متضاد لکھائی روکنے والے سافٹ ویئر طریقوں کی جگہ نہیں لینا چاہیے۔ نتیجہ نافذ کرنے کے لیے اجازت، نسخہ جانچ اور لاک اب بھی درکار ہیں۔
اسی طرح پہلے کے کام کی سستی تلاش یادداشت کے انتظام کو بہتر بنا سکتی ہے، بغیر اس کے کہ مسلسل سیکھنے کہلانے والا ہر مسئلہ حل ہو جائے۔ پچھلی کوشش یاد رکھنا، اس کی ناکامی سمجھنا اور نئی صورتِ حال سے قابلِ اعتماد طور پر ہم آہنگ ہونا الگ صلاحیتیں ہیں۔ قائل کن جانچ میں مکمل کام، سابقہ صلاحیت کھونا، تنازعات اور انسانی مداخلت دیکھی جائے، صرف ایجنٹ یا کال نہ گنے جائیں۔
حفاظت پورے نظام میں حرکت کرتی ہے؛ غائب نہیں ہوتی
Almeida ماڈل کے انکار کے مقابلے میں ایپلی کیشن کی سطح کے حفاظتی کنٹرول کو ترجیح دیتے ہیں؛ swyx نتائج پر سوال اٹھاتے ہیں۔ انٹرویو، 13:11 اور 1:42:29
یہاں حقیقی ڈیزائن مسئلہ موجود ہے: غیر زیرِ نگرانی ایپلی کیشن کو اس وقت سے نمٹنا ہوگا جب کوئی انحصاری خدمت انکار کرے، ناکام ہو یا غیر یقینی جواب دے۔ اسے واضح ردعملی راستہ چاہیے۔ اس مشاہدے سے یہ طے نہیں ہوتا کہ ہر حفاظتی بندوبست کہاں ہونا چاہیے۔
ایپلی کیشن کو رسائی کی اجازت نافذ کرنی چاہیے، خواہ ماڈل مطلوبہ اقدام درست پہچان لے۔ ریکارڈ حذف کرنے کی درخواست پوری طرح سمجھی جا سکتی ہے مگر غیر مجاز ہو۔ ہدایت تکنیکی طور پر درست ہو مگر منتظم کی پالیسی توڑے۔ ذمہ داری سے جواب دینے کے لیے فیصلہ خدمت کو مناسب سیاق درکار ہے، اور اقدام کا کنٹرول ایپلی کیشن کے پاس رہنا چاہیے۔
لہٰذا سافٹ ویئر میں مزید فیصلے منتقل کرنے سے پہلے حدود متعین کرنے کی اہمیت بڑھتی ہے۔ ٹیموں کو طے کرنا ہوگا کہ کون سے شواہد درکار ہیں، کون سے عمل واپس پلٹ سکتے ہیں اور کوئی شخص نتیجے کو چیلنج یا درست کیسے کر سکتا ہے۔ ماڈل کے ساتھ ناگوار تعامل ہٹا دینا پورے نظام کے محفوظ ہونے کا کافی ثبوت نہیں۔
بڑی تبدیلی کیا ثابت کرے گی
یہ اجرا واضح تجربہ ممکن بناتا ہے۔ ایک محدود عمل چنیں جس کا نتیجہ دیکھا جا سکے۔ ریکارڈ کریں کہ آج وہ کیسے چلتا ہے، بشمول غلطیوں اور انہیں درست کرنے میں لوگوں کا وقت۔ نمائندہ معاملوں پر فیصلہ مرکوز طریقہ آزمائیں، اس سے پہلے کہ اسے اقدام کا اختیار ملے۔
درست طور پر بغیر مداخلت مکمل ہونے والے معاملوں کا تناسب، جائزے سے بچ جانے والی غلطیاں، لوگوں کے سپرد کام اور ہر مکمل معاملے کی کل لاگت ناپیں۔ اصل شواہد دستیاب رکھیں تاکہ جائزہ کار دیکھ سکے نتیجہ کیوں قبول ہوا۔ ماڈل، پالیسی یا اِن پٹ کی آبادی بدلنے پر موازنہ دہرائیں۔
اس جانچ سے پتا چل سکتا ہے کہ عمل کا صرف ایک حصہ تیار ہے۔ یہ مفید نتیجہ ہے۔ معمول کی درجہ بندی خودکار بنا کر مبہم معاملے تجربہ کار منتظم کے پاس رکھنا کارآمد ہو سکتا ہے، بغیر وسیع خودمختاری کو جائز ٹھہرائے۔
Jev کا اجرا اور Almeida کا انٹرویو AI کے معیشت میں داخل ہونے کے طریقے پر ایک پُرعزم مفروضہ پیش کرتے ہیں: بار بار دہرائے جانے والے محدود فیصلے پہلے سے زیرِ استعمال سافٹ ویئر کو زیادہ قابل بنا سکتے ہیں۔ اگلے شواہد ان نظاموں سے آنے چاہییں جو وقت کے ساتھ یہ کام کریں، اور حساب میں غلطیاں و استثنا بھی شامل ہوں۔ تب دلچسپ ماڈل ساخت ایسی تبدیلی بنے گی جسے قارئین واقعی دیکھ سکیں۔


