
एक ग्राहक ऑर्डर का पता बदलता है। संदेश में रिफ़ंड की माँग, पैकेज के नुक़सान का ज़िक्र और यह संकेत भी है कि तीसरी बार कुछ ग़लत हुआ है। उस संदेश का उपयोगी जवाब बनाना एक काम है। कौन-से रिकॉर्ड बदलें, किस टीम को दख़ल देना चाहिए और किन कार्रवाइयों के लिए अनुमति चाहिए—यह तय करना दूसरा।
15 सितंबर 2026 को शुरुआती पहुँच में आया TypeSafe AI का मॉडल Jev, ऐसे फ़ैसलों के लिए बनाया गया है। यह सॉफ़्टवेयर के लिए सीमित और संरचित जवाब देता है। इसका लॉन्च इस पर फिर सोचने का न्योता है कि किसी ऐप को सामान्य-उद्देश्य मॉडल से लंबी बातचीत पर कितना निर्भर होना चाहिए। TypeSafe की लॉन्च घोषणा
इस तर्क की पूरी चर्चा Latent Space के 21 सितंबर के साक्षात्कार में है, जिसमें TypeSafe के सह-संस्थापक और CEO Diogo Almeida से swyx ने बात की। हमने दो घंटे 22 मिनट की बातचीत के पूरे अंग्रेज़ी कैप्शन देखे और उत्पाद के दस्तावेज़ जाँचे। यह साक्षात्कार और सार्वजनिक प्रमाणों का विश्लेषण है; हमने Jev का स्वतंत्र बेंचमार्क नहीं किया। मूल साक्षात्कार देखें
हमारी समझ में Jev का सबसे अहम प्रस्ताव स्वचालन की इकाई से जुड़ा है। पूरी प्रक्रिया ज़िम्मेदारी से सौंप पाने से पहले कोई कंपनी मौजूदा प्रक्रिया में एक सीमित निर्णय स्वचालित कर सकती है। अगर निर्णय दोहराने लायक सस्ता और मापने लायक स्पष्ट हो जाए, तो हर संवाद को चैट सत्र बनाए बिना रोज़ का कारोबारी सॉफ़्टवेयर उपयोगी क्षमताएँ पा सकता है।
इसका असर कार्यप्रवाह बनाने वालों पर भी होगा और उनका इस्तेमाल करने वालों पर भी। किन कार्रवाइयों की अनुमति है, ग़लती किसे कहेंगे और अपवाद कौन सँभालेगा—यह अब भी किसी को तय करना होगा। इन फ़ैसलों की गुणवत्ता तय करेगी कि इस तरीके़ से भरोसेमंद सेवा बनेगी या ग़लतियाँ बस तेज़ी से होंगी।
TypeSafe ने वास्तव में क्या जारी किया
Jev के दस्तावेज़ों में दिए इंटरफ़ेस को एक स्थिति और टाइप किए गए सवालों का समूह मिलता है। इसके तीन मूल साधन हैं: Choice, जो दिए विकल्पों में से चुनता है; Score, जो मापदंड से मूल्यांकन करता है; और Noul, जो किसी कथन की संभावना शून्य से एक के पैमाने पर बताता है। Choice और Score संभाव्यता-वितरण तथा confidence फ़ील्ड देते हैं; Noul में अलग confidence फ़ील्ड नहीं। दिए गए state के कई सवाल साथ दिए जा सकते हैं, लेकिन उनका मूल्यांकन स्वतंत्र रूप से होता है। TypeSafe के इंटरफ़ेस दस्तावेज़
ग्राहक सेवा ऐप में डेवलपर इन साधनों से पता लगा सकता है कि अनुरोध पता बदलने का है या रद्द करने का, तात्कालिकता आँक सकता है और देख सकता है कि संदेश में नुक़सान का सबूत है या नहीं। ये काल्पनिक उदाहरण हैं, Jev तैनाती के नतीजे नहीं। जवाबों के आधार पर आगे क्या करना है, यह ऐप तय करेगा।
यह बँटवारा उपयोगी है, क्योंकि अर्थ समझना और अधिकार मिलना अलग ज़िम्मेदारियाँ हैं। एआई अनुमान लगा सकता है कि ग्राहक रिफ़ंड चाहता है। सिर्फ़ यह निष्कर्ष निकालने से उसे रिफ़ंड जारी करने की अनुमति नहीं मिलनी चाहिए। ऐप ऑर्डर जाँच सकता है, रिफ़ंड की सीमा लागू कर सकता है और जहाँ उचित हो मंज़ूरी माँग सकता है।
TypeSafe इस मॉडल श्रेणी को तेज़, सहज सोच के अर्थ में उधार लिए शब्द System One कहता है। नाम को इच्छित काम का वर्णन समझें। यह मनुष्य जैसी सोच को प्रमाणित नहीं करता और न आसान व कठिन कामों के बीच साफ़ सीमा तय करता है। छोटा सवाल भी जटिल निर्णय छिपा सकता है, ख़ासकर जब ज़रूरी जानकारी न हो।
इंजीनियरिंग बदलाव छोटे, जाँचने योग्य फ़ैसलों का है
Almeida हिस्सों में बाँटने की वकालत करते हैं: सीमित दायरे वाले सवाल पूछें, फिर कोड में जवाब जोड़ें। साक्षात्कार, 1:03:02
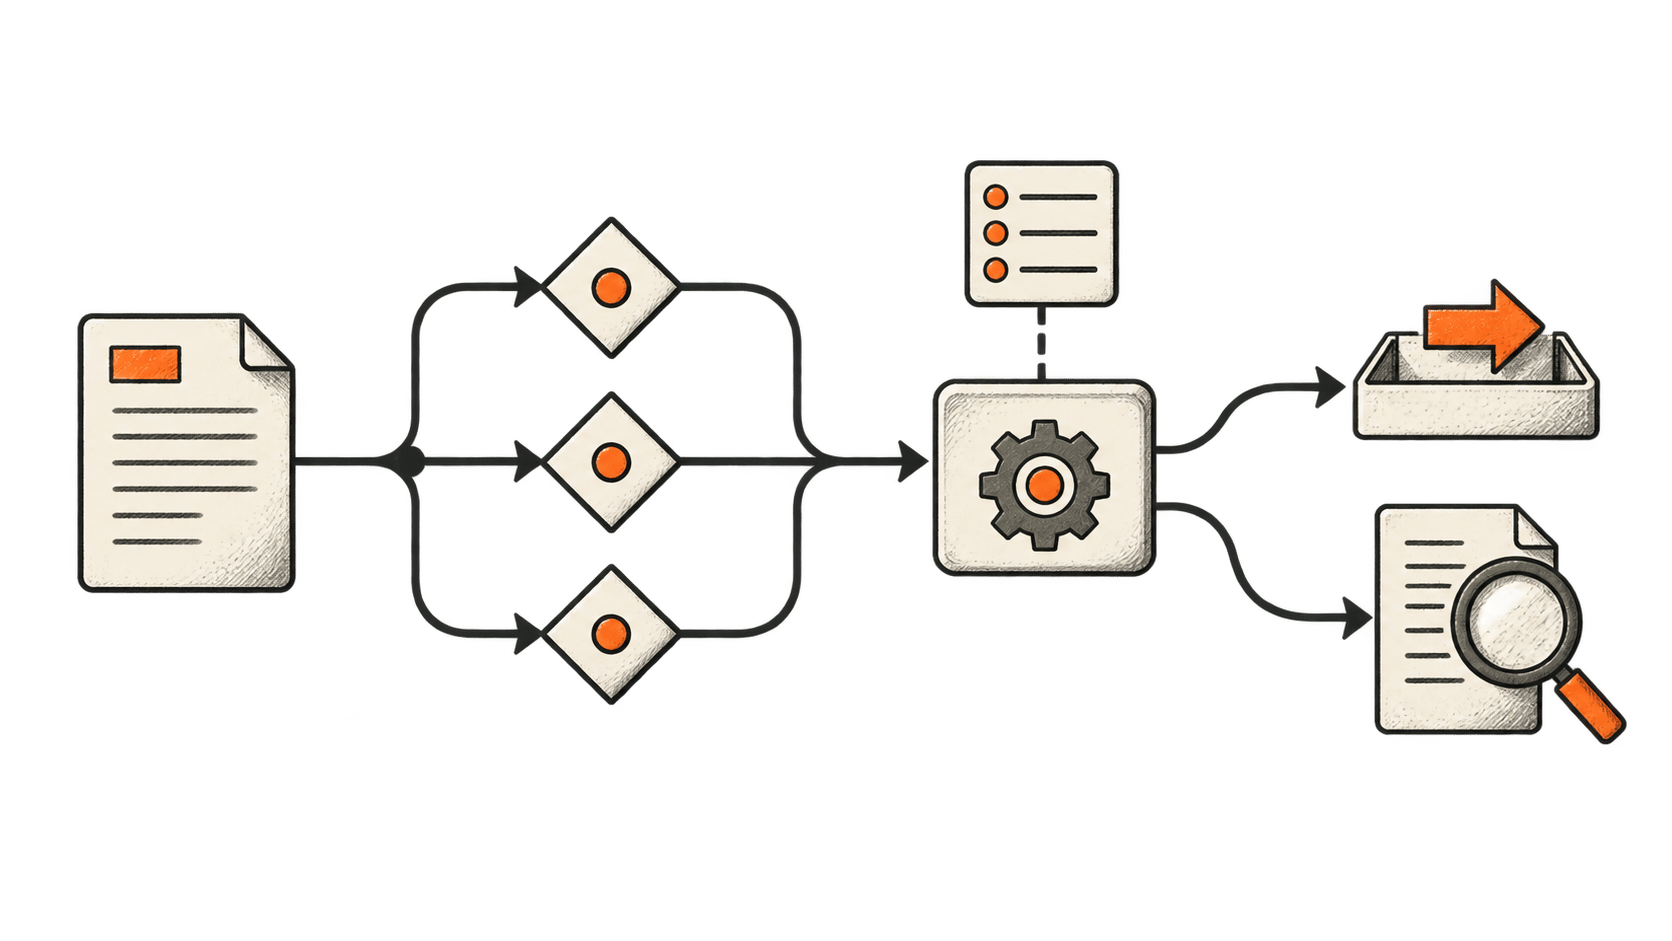
क्षतिग्रस्त ऑर्डर के उदाहरण पर फिर आएँ। शिकायत सँभालने का एक निर्देश कई निर्णय एक जवाब में छिपा देता है। अधिक जाँचने योग्य डिज़ाइन में अलग-अलग पता लगाया जाएगा कि माँगी कार्रवाई क्या है, ऑर्डर की पहचान हो सकती है या नहीं और उपलब्ध सबूत नुक़सान के दावे का समर्थन करते हैं या नहीं। नीति के नियम इन निर्णयों से बाहर रहेंगे।
इससे विफलता की जाँच आसान होती है। प्रणाली पता बदलने को रिटर्न टीम के पास भेजे, तो संचालक उस रूटिंग निर्णय की पड़ताल कर सकता है। नुक़सान का आकलन ग़लत हो, तो उस हिस्से को पिछले मामलों पर परखा जा सकता है। व्यापक निर्देश फिर से लिखे बिना और मॉडल की लगातार एक-सी व्याख्या की उम्मीद किए बिना स्पष्ट नियम बदला जा सकता है।
इसके ख़र्च भी हैं। अधिक हिस्सों का अर्थ है सँभालने के लिए अधिक इंटरफ़ेस। सवाल से वह संदर्भ छूट सकता है जो जवाब को स्पष्ट करता। ऊपर से स्वतंत्र दिखने वाले दो निर्णय एक ही भ्रामक सबूत पर निर्भर हो सकते हैं। अलग-अलग स्वीकार्य हिस्सों से जुड़ा कार्यप्रवाह भी कुल मिलाकर अस्वीकार्य नतीजा दे सकता है।
TypeSafe के दस्तावेज़ी तरीक़ों में कई सवाल साथ पूछना, स्कोर जोड़ना और अनिश्चित मामलों को आगे की जाँच के लिए भेजना शामिल है। ये वास्तुकला के विकल्प बताते हैं, यह प्रमाण नहीं कि ग्राहक की कोई प्रक्रिया बिना निगरानी चलने को तैयार है। TypeSafe के तरीक़े
उपयोगी कसौटी यह है कि हिस्सों में बाँटने से जाँच और नतीजे—दोनों बेहतर होते हैं या नहीं। यह बता पाना कि कौन-सा क़दम विफल हुआ मूल्यवान है। विफलताओं की संख्या और उनका असर घटाना कारोबारी औचित्य है।
वैध जवाब फिर भी ग़लत हो सकता है
Jev “भ्रम गढ़ नहीं सकता” वाले लॉन्च दावे को सीमित अर्थ में पढ़ना चाहिए। TypeSafe की गारंटी अनुमत आउटपुट स्कीमा से मेल खाने तक है। इससे चुना हुआ जवाब सच साबित नहीं होता। उसकी अपनी घोषणा स्कीमा की गारंटी और अनुभवजन्य मूल्यांकन में अंतर करती है। TypeSafe का type safety पर स्पष्टीकरण
मान लें कि ऐप इन मानों की अनुमति देता है: damaged, late और other. damaged लौटाना पूरी तरह वैध है, भले ही पैकेज सिर्फ़ देर से पहुँचा हो। मॉडल चौथी श्रेणी न गढ़े, फिर भी ग़लत विकल्प चुन सकता है। सूची में सचमुच ज़रूरी श्रेणी न हो, तो समस्या स्कीमा में ही है।
संरचित आउटपुट पहले से इस्तेमाल होने वाला इंजीनियरिंग तरीका भी है। OpenAI ने अगस्त 2024 में स्कीमा-सीमित Structured Outputs पेश किए और साफ़ बताया कि लौटाए गए मूल्यों के भीतर मॉडल फिर भी ग़लती कर सकता है। इसलिए Jev को निर्णय की गुणवत्ता, अनिश्चितता बताने, गति और लागत के अपने मेल पर परखना चाहिए; इसे हर तरह के संरचित एआई आउटपुट का आविष्कारक नहीं मानना चाहिए। OpenAI की मूल घोषणा और सीमाएँ
ख़रीदारों के लिए यह अंतर मूल्यांकन की योजना बदलता है। स्कीमा परीक्षण पूछता है कि सॉफ़्टवेयर जवाब ग्रहण कर सकता है या नहीं। तथ्य-जाँच पूछती है कि जवाब सबूत से मेल खाता है या नहीं। नीति-परीक्षण देखता है कि उससे निकली कार्रवाई अनुमत है या नहीं। एक पास हो जाने से बाकी की जगह नहीं ली जा सकती।
साक्षात्कार की सबसे अहम चुनौती कैलिब्रेशन पर है
1:09 पर Almeida पूर्ण कैलिब्रेशन के सुझाव को नकारते हैं और मानते हैं कि मॉडल ग़लतियाँ करता है। साक्षात्कार, 1:08:50
कैलिब्रेशन का मतलब है कि अनुमानित संभावनाएँ अलग-अलग भविष्यवाणियों के समूहों में देखे गए नतीजों से कितनी मेल खाती हैं। हर अधिक-संभावना वाले मामले में सही न होते हुए भी मॉडल अनिश्चितता का उपयोगी संकेत दे सकता है। TypeSafe की शुरुआती मार्गदर्शिका यह अंतर स्पष्ट रखती है। TypeSafe की कैलिब्रेशन व्याख्या
API का confidence फ़ील्ड एक और अंतर माँगता है। TypeSafe इसे जवाब के वितरण से निकला आँकड़ा बताता है। यह स्वतंत्र रूप से मापी गई उस संभावना के बराबर नहीं कि चुना जवाब सही है। दस्तावेज़ काम और उसके परिणाम के हिसाब से सीमाएँ चुनने की सलाह देते हैं। TypeSafe के confidence दस्तावेज़
ये व्यावहारिक चिंताएँ हैं। मान लें कि रूटिंग मॉडल छोटे अंग्रेज़ी संदेशों पर अच्छा चलता है, लेकिन कई अनुरोधों वाली लंबी शिकायतों में मुश्किल करता है। कुल मिलाकर एक स्कोर यह कमज़ोरी छिपा सकता है। कमज़ोर समूह के ऊँचे-confidence निर्णय को परिचित समूह के उतने ही दिखने वाले स्कोर से अधिक जाँच की ज़रूरत पड़ सकती है।
इसलिए टीम को मिलने की अपेक्षा वाले मामले परखने चाहिए—जानकारी की कमी, अपरिचित शब्दावली और जानबूझकर उलझाए इनपुट समेत। ग़लतियों को श्रेणीवार देखें और मामले को समीक्षा में भेजने की लागत की तुलना ग़लत कार्रवाई की लागत से करें। सीमाएँ डेमो से उठाए अंकों के बजाय सबूत पर आधारित परिचालन फ़ैसले बनें।
कैलिब्रेशन पर शोध Jev से बहुत पुराना है। Chuan Guo और सहलेखकों के 2017 के व्यापक रूप से उद्धृत शोधपत्र ने आधुनिक न्यूरल नेटवर्कों में कमज़ोर कैलिब्रेशन और उसे सुधारने के तरीक़े जाँचे। वह इस समस्या का संदर्भ देता है; TypeSafe के मॉडल को मान्य नहीं करता। आधुनिक न्यूरल नेटवर्कों का कैलिब्रेशन
सेवा बदलने पर क्या होता है, यह भी भरोसेमंदी का हिस्सा है
बातचीत में मजबूती और नियतात्मकता अलग रखी गई हैं; संस्करण की स्थिरता पर चर्चा है, लेकिन लंबे समय तक सहायता का सामान्य वादा नहीं। साक्षात्कार, 41:24 और 49:40
ये ख़रीद के अलग सवाल हैं। नियतात्मकता पूछती है कि क्या एक जैसे इनपुट एक जैसे आउटपुट देते हैं। मजबूती पूछती है कि क्या कोई अप्रासंगिक बदलाव—जैसे रिकॉर्ड का अलग पहचानकर्ता—व्यवहार में अनुचित बदलाव लाता है। मॉडल बार-बार एक ही ग़लत जवाब देकर भी नियतात्मक हो सकता है। आसपास का कार्यप्रवाह भरोसेमंद रहते हुए उसका जवाब थोड़ा बदल भी सकता है।
इनमें से कोई गुण पूरे जीवन-चक्र का जोखिम नहीं सुलझाता। कारोबार को जानना चाहिए कि निर्णय किस मॉडल संस्करण ने दिया, वह संस्करण उपलब्ध रहेगा या नहीं और उसके बदले आए संस्करण का मूल्यांकन कैसे होगा। प्रदाता के परीक्षणों में सुधार ग्राहक के सावधानी से समायोजित कार्यप्रवाह का व्यवहार फिर भी बदल सकता है।
समझदारी होगी कि प्रतिनिधि मामले सँभालकर रखें, संस्करण दर्ज करें और अहम काम का स्थानांतरण करने से पहले नए विकल्पों की तुलना करें। वैकल्पिक रास्ता भी ज़रूरी है: सही निर्णय देने वाली सेवा भी अनुपलब्ध हो सकती है। ऐप सुरक्षित रूप से काम रोक या कहीं और भेज न सके, तो व्यवहार में सेवा उपलब्ध रहने का समय निर्णय की गुणवत्ता का हिस्सा बन जाता है।
यहीं आकर्षक API परिचालन निर्भरता बन जाती है। मॉडल तेज़ हो जाने से खरीद, निगरानी और स्थानांतरण की योजना ग़ायब नहीं होती। वे नज़रअंदाज़ करना आसान हो जाता है, क्योंकि हर कॉल बहुत सरल दिखती है।
गति और क़ीमत के आँकड़ों को संदर्भ की ज़रूरत है
TypeSafe के सुर्ख़ी वाले कार्यप्रवाह नतीजों में गति 193.6 गुना और लागत में 444.6 गुना सुधार शामिल है। घोषणा इन्हें कंपनी के बनाए कार्यप्रवाहों से मिली अधिकतम बढ़त बताती है। संदर्भ जवाब स्वतंत्र रूप से सत्यापित सही वर्गीकरण नहीं, दूसरे मॉडलों के संभावना-अनुमान थे। कंपनी यह भी चेताती है कि उसका छोटा प्रदर्शन Jev के पक्ष में है और लंबे समय की टिकाऊ क़ीमत अभी तय होनी है। TypeSafe के मूल्यांकन की सीमाएँ
ये सीमाएँ आँकड़ों के साथ बतानी चाहिए। संदर्भ मॉडल से सहमति उपयोगी हो सकती है, लेकिन यह सुलझाए गए ग्राहक-मामले के मुक़ाबले शुद्धता मापने से अलग है। विक्रेता का बनाया कार्यप्रवाह ख़रीदार के लिए मायने रख सकता है, पर उसके अनुरोधों का वास्तविक बँटवारा दर्शाए, ज़रूरी नहीं।
सही तुलना में पूरा काम होना चाहिए: संदर्भ जुटाना, निर्णय लेना, नियम लागू करना, अपवाद सँभालना और विफलता से उबरना। सस्ती मॉडल कॉल के बावजूद कुल लागत बढ़ सकती है, अगर समीक्षक के पास बहुत काम जाए। धीमी कॉल भी किफ़ायती हो सकती है, यदि महँगा दोबारा काम बचाती हो।
गति भी ऐप के वास्तविक क्षेत्र से मापें। सेवा के इन्फ़्रास्ट्रक्चर के पास हुआ प्रदर्शन दूसरी जगह के उपयोगकर्ता के अनुभव का वादा नहीं। संवादात्मक प्रणाली में औसत के साथ धीमे अनुरोध भी देखें; पृष्ठभूमि में काम को गति-क्षमता और कुल लागत अधिक मायने दे सकती है।
Jev का नाम इस विचार की ओर इशारा करता है कि दक्षता से इस्तेमाल बढ़ सकता है। किसी कारोबार के लिए इससे बजट का सवाल उठता है: कौन-से नए निर्णय अब जाँचने लायक हो जाते हैं, और कौन-से सिर्फ़ इसलिए जाँचे जाने लगते हैं कि लागत कम है? अधिक मॉडल कॉल अपने-आप में कोई नतीजा नहीं।
अलग शोध-उद्देश्य, लेकिन प्रमाण अभी अधूरे
Almeida का शोध-संबंधी तर्क डेटा, काम के चुनाव और RLCD को प्राथमिकता-अनुकूलन की उनकी आलोचना से जोड़ता है। साक्षात्कार, 7:23 और 22:12
RLCD का पूरा नाम Reinforcement Learning for Calibrated Decisions है। TypeSafe इसे इंसानी पसंद और सत्यापित इनाम वाले तरीक़ों से अलग, उपयोगी निर्णय और संभावनाएँ देने की ओर प्रशिक्षण बताता है। यह कंपनी का अपने उद्देश्य का विवरण है, पूरी प्रशिक्षण-विधि के स्वतंत्र सत्यापन के बराबर नहीं। TypeSafe की एआई मार्गदर्शिका
विधि का मूल्यांकन जारी रहने के बावजूद बड़ा सवाल पूछना उचित है: प्रशिक्षण का उद्देश्य किस व्यवहार को इनाम देता है? प्रभावशाली व्याख्या के लिए अनुकूलित मॉडल इस्तेमाल में अच्छा लग सकता है, पर कोड को इस्तेमाल योग्य रूप में अनिश्चितता नहीं दिखा सकता। निर्णय-केंद्रित इंटरफ़ेस उसे सँभालना आसान कर सकता है, लेकिन आउटपुट को वास्तविकता के विरुद्ध बाहरी जाँच फिर भी चाहिए।
TypeSafe इस चिंता को mode dropping से जोड़ता है: पसंद-अनुकूलन उन संभावित आउटपुट का दायरा संकरा कर सकता है जिन्हें लोग पुरस्कृत करते हैं। यह विफलता के एक तरीक़े की उसकी व्याख्या है, यह निष्कर्ष नहीं कि पसंद पर प्रशिक्षित हर मॉडल निर्णय के लिए अनुपयोगी है। TypeSafe की पसंद-अनुकूलन पर चर्चा
Almeida की पृष्ठभूमि इस तर्क को ख़ास तौर पर दिलचस्प बनाती है। वह InstructGPT शोधपत्र के सहलेखक हैं, जिसमें मानव प्रतिक्रिया से भाषा मॉडलों को निर्देश मानना सिखाने का अध्ययन हुआ था। उनका लेखक होना सत्यापित है; हर प्रयोगशाला की ग़लतियों पर व्यापक दावे अलग बात हैं। InstructGPT शोधपत्र
प्रीट्रेनिंग पर ख़र्च और बिना दिशा की नई प्रयोगशालाओं पर उनकी आपत्ति भी उपयोगी काम चुनने के इसी तर्क में आती है। साक्षात्कार, 1:49:32 और 2:03:10
ख़रीदार के लिए सबक यह पूछना है कि तय प्रक्रिया में उत्पाद क्या कर सकता है। शोध की पृष्ठभूमि, कंप्यूट पर ख़र्च और अलग मॉडल वास्तुकला यह समझा सकते हैं कि कंपनी इस पेशकश तक कैसे पहुँची। इससे किसी और के कारोबार में तैनाती का अर्थशास्त्र साबित नहीं होता।
बातचीत में Almeida के OpenAI छोड़ने, शुरुआत में अपनाए जाने की मुश्किल और डेवलपर-आधारित बढ़त पर भी चर्चा है। साक्षात्कार, 1:31:27 और 1:56:48
ये यादें कंपनी की प्राथमिकताएँ समझाती हैं। ये ऑडिट किए अपनाव के प्रमाण नहीं। डेवलपर मंच को आख़िरकार लंबे समय तक उपयोगी काम और विफल होने पर दी जाने वाली मदद से परखना चाहिए। लॉन्च के बाद का उत्साह जाँच करने की वजह है, उस रिकॉर्ड का विकल्प नहीं।
मौजूदा सॉफ़्टवेयर को नई चैट विंडो से अधिक लाभ हो सकता है
Almeida अधिक सक्षम SaaS उत्पादों और पृष्ठभूमि में जाती एआई की कल्पना करते हैं। साक्षात्कार, 1:19:57
यह जाँचने योग्य दिशा है, क्योंकि सॉफ़्टवेयर में पहले से ऐसी जगहें हैं जहाँ उपयोगी निर्णय अगला क़दम बदल सकता है। शेड्यूलिंग ऐप बुकिंग से पहले अस्पष्ट अनुरोध पहचान सकता है। मीडिया संग्रह शोधकर्ता के लिए सामग्री व्यवस्थित कर सकता है। सहायता डेस्क सामान्य अपडेट और ध्यान माँगती शिकायत में अंतर कर सकती है। ये संभावित डिज़ाइन हैं, Jev की बताई तैनातियाँ नहीं।
इंटरफ़ेस शायद बहुत कम बदले। उपयोगकर्ता कम ग़लतियाँ, बार-बार वर्गीकरण में कमी या सही व्यक्ति तक जल्दी पहुँच देखेंगे। व्यावसायिक लाभ उन कंपनियों को मिल सकता है जो कार्यप्रवाह पहले से समझती हैं और उसमें बेहतर निर्णय जोड़ सकती हैं।
मौजूदा सॉफ़्टवेयर कारोबारों को प्रतिस्पर्धा फिर भी झेलनी होगी। वही निर्णय कई डेवलपरों को उपलब्ध हो जाए तो अकेली मॉडल कॉल से बहुत फ़र्क नहीं पड़ेगा। आसपास के उत्पाद को उपयोगी डेटा तक पहुँच, सोच-समझकर बनाया इंटरफ़ेस और काम पूरा करने का भरोसेमंद तरीका देना होगा।
रोज़गार पर दावों में अधिक संयम चाहिए। किसी एक काम की मेहनत घटाने से कर्मचारियों की संख्या बदल सकती है, सेवा की मात्रा बढ़ सकती है या काम अपवादों की ओर खिसक सकता है। नतीजे संगठन और उसकी सेवा की माँग पर निर्भर हैं। न साक्षात्कार, न शुरुआती पहुँच वाला लॉन्च यह स्थापित करता है कि कितनी नौकरियाँ बचेंगी, ख़त्म होंगी या बनेंगी।
BIG CHANGE के उद्योग अवलोकन में मापी जा सकने वाली घटना निर्णय स्वचालित करने का एक और तरीका उपलब्ध होना है। व्यापक अपनाव, उत्पादकता में बढ़त और श्रम-बाज़ार का असर आगे के सवाल हैं, जिनके लिए अलग सबूत चाहिए।
छिपा डेटा, रीयल-टाइम सॉफ़्टवेयर और डेमो की सीमाएँ
साक्षात्कार में संग्रहित डेटा, संवादात्मक ऐप, सत्यापन और कंप्यूटर चलाने के प्रदर्शनों पर बात है। साक्षात्कार, 1:34:50
हर श्रेणी का मूल्यांकन अलग होना चाहिए। संग्रह सँभालने वाला काम कुछ देरी सह सकता है, मगर नतीजों का नमूना लेने और उन्हें मूल रिकॉर्ड से जोड़ने की योजना चाहिए। रीयल-टाइम इंटरफ़ेस की प्रतिक्रिया अनुमानित होनी चाहिए। दूसरे मॉडल को परखने वाले जाँचकर्ता को उस मॉडल की वास्तविक ग़लतियों पर जाँचना चाहिए—उन मामलों समेत जहाँ दोनों प्रणालियों में एक जैसी ग़लती हो।
कंप्यूटर इस्तेमाल में कार्रवाई चुनना प्रणाली का सिर्फ़ एक हिस्सा है। उसे इंटरफ़ेस का सटीक रूप, कार्रवाई करने का तरीका और अपेक्षित बदलाव सचमुच हुआ या नहीं इसकी जाँच भी चाहिए। सँवरा प्रदर्शन दिखा सकता है कि एक क्रम एक बार चला; भरोसेमंद स्वचालन को बार-बार परीक्षण और रुकावट के बाद सँभलना चाहिए।
यही सावधानी खेलों पर भी लागू है। मॉडल से नियंत्रित पात्र अधिक विस्तृत स्थिति पर प्रतिक्रिया दे सकता है, जबकि गेम इंजन तय करता रहेगा कि कौन-सी कार्रवाइयाँ संभव हैं। इससे खेल बेहतर होगा या नहीं, यह प्रतिक्रिया, निरंतरता और अनुभव के डिज़ाइन पर निर्भर है। हर फ़्रेम में अनुमान जोड़ देने से खेल अपने-आप दिलचस्प नहीं हो जाता।
ये अंतर श्रेणी की ग़लती रोकते हैं: उपयोगी हिस्से को उसके अपने काम का श्रेय दें, आसपास के बड़े ऐप की हर क्षमता उसके नाम न करें।
साक्षात्कार में फ़ाइन-ट्यूनिंग, विज़न और मॉडल के अतिरिक्त रूपों को संभावनाओं की तरह उठाया गया है। साक्षात्कार, 1:10:27 और 1:26:23
रोडमैप की बातचीत लॉन्च योजना की निर्भरता न बने। उपलब्ध इंटरफ़ेस के इर्द-गिर्द बनाएँ, तय करें कि अलग हिस्से को क्या देना होगा और कोई नई क्षमता आने पर उसका मूल्यांकन करें। इससे भविष्य के सुधारों का लाभ लेने की गुंजाइश रहती है और अटकल उत्पाद की सुविधा बनकर पेश नहीं होती।
कोडिंग एजेंट काम बाँटने का तरीका बदल सकते हैं
Almeida एक मॉडल के बार-बार वाले चक्र से आगे, कोडिंग एजेंटों के लिए स्थिति सँभालने की कम लागत और साझा संदर्भ का प्रस्ताव रखते हैं। साक्षात्कार, 1:40:17 और 2:09:29
एक संभावित वास्तुकला में सक्षम कोडिंग मॉडल बदलाव तैयार करे, छोटी निर्णय कॉलें प्रासंगिक फ़ाइलों की पहचान करें और सामान्य सॉफ़्टवेयर नतीजे में बने काम सँभाले। अलग समीक्षक अंतिम पैच देख सकता है। यह डिज़ाइन का प्रस्ताव है, बेंचमार्क की सिफ़ारिश या इस बात का प्रमाण नहीं कि Jev पहले से मौजूदा कोडिंग एजेंट की जगह लेता है।
आकर्षक बात चुना हुआ संदर्भ है। किसी उपकार्य को सिर्फ़ एक इंटरफ़ेस और कुछ पाबंदियाँ चाहिए हों, तो पूरी बातचीत भेजना फ़िज़ूल हो सकता है। स्पष्ट कार्य-रिकॉर्ड से यह पता लगाना आसान हो सकता है कि कौन-से तथ्य अहम हैं, क्या तय हो चुका और कौन-से बदलाव लंबित हैं।
ख़तरा समन्वय के सुझाव को साथ-साथ लिखने की गारंटी समझने में है। दो एजेंट एक ही फ़ाइल लिखना अपना काम समझ सकते हैं। संभाव्यतामूलक मॉडल को टकराव वाले लेखन रोकने वाले सॉफ़्टवेयर तंत्र की जगह नहीं लेनी चाहिए। नतीजा लागू कराने के लिए अनुमति, संस्करण-जाँच और लॉक अब भी ज़रूरी हैं।
इसी तरह पुराने काम को सस्ता निकालना स्मृति प्रबंधन सुधार सकता है, पर निरंतर सीखने की हर समस्या नहीं सुलझाता। पुरानी कोशिश याद रखना, उसके विफल होने की वजह समझना और नई स्थिति में भरोसेमंद ढंग से ढलना अलग क्षमताएँ हैं। ठोस मूल्यांकन में पूरे हुए काम, पीछे आए बदलाव, टकराव और मानवीय दख़ल देखना चाहिए—सिर्फ़ एजेंटों या कॉल की संख्या नहीं।
सुरक्षा प्रणाली में आगे बढ़ती है, ग़ायब नहीं होती
Almeida मॉडल के इनकार की बजाय ऐप-स्तर के सुरक्षा नियंत्रणों को प्राथमिकता देते हैं; swyx इसके परिणामों पर सवाल उठाते हैं। साक्षात्कार, 13:11 और 1:42:29
यह वास्तविक डिज़ाइन समस्या है: बिना निगरानी वाला ऐप निर्भरता के इनकार, विफलता या अनिश्चित नतीजे लौटाने पर काम सँभाले। उसे आगे का स्पष्ट रास्ता चाहिए। इस बात से यह तय नहीं हो जाता कि हर सुरक्षा उपाय कहाँ होना चाहिए।
मॉडल इच्छित कार्रवाई ठीक पहचान ले, तब भी ऐप को पहुँच की अनुमति लागू करनी चाहिए। रिकॉर्ड हटाने का अनुरोध पूरी तरह समझ में आ सकता है, फिर भी अनधिकृत हो सकता है। कोई अनुरोध तकनीकी रूप से वैध होते हुए संचालक की नीति तोड़ सकता है। उचित संदर्भ के बिना निर्णय सेवा इन सवालों का ज़िम्मेदार जवाब नहीं दे सकती, और कार्रवाई का नियंत्रण ऐप के पास रहना चाहिए।
अधिक निर्णय सॉफ़्टवेयर में ले जाने से तैनाती से पहले सीमाएँ तय करना और अहम हो जाता है। टीम को तय करना होगा कि कौन-सा प्रमाण चाहिए, कौन-सी कार्रवाई पलटी जा सकती है और व्यक्ति नतीजे को चुनौती देकर कैसे सुधार सकता है। मॉडल के साथ असहज संवाद हटा देना पूरे तंत्र की सुरक्षा का पर्याप्त प्रमाण नहीं।
बड़े बदलाव का प्रमाण क्या होगा
लॉन्च एक स्पष्ट प्रयोग संभव बनाता है। दिखने वाले नतीजे वाली एक सीमित प्रक्रिया चुनें। आज वह कैसे चलती है, ग़लतियों और उन्हें सुधारने में लोगों के समय समेत, दर्ज करें। कार्रवाई का अधिकार देने से पहले प्रतिनिधि मामलों पर निर्णय-आधारित रूप परखें।
बिना दख़ल सही पूरे हुए मामलों का अनुपात, समीक्षा से बच निकली ग़लतियाँ, लोगों को सौंपा गया काम और प्रति पूरे मामले की कुल लागत मापें। मूल प्रमाण उपलब्ध रखें ताकि समीक्षक देख सके कि नतीजा क्यों स्वीकार हुआ। मॉडल, नीति या इनपुट समूह बदलने पर तुलना फिर करें।
मूल्यांकन दिखा सकता है कि प्रक्रिया का केवल एक हिस्सा तैयार है। यह उपयोगी नतीजा है। नियमित वर्गीकरण स्वचालित करके अस्पष्ट मामले अनुभवी संचालक के पास रखने से लाभ हो सकता है, बिना अधिक स्वायत्तता को सही ठहराए।
Jev का लॉन्च और Almeida का साक्षात्कार इस महत्वाकांक्षी परिकल्पना को सामने रखते हैं कि एआई अर्थव्यवस्था में कैसे आएगा: बार-बार के सीमित निर्णय लोगों के मौजूदा सॉफ़्टवेयर को अधिक सक्षम बना सकते हैं। अगला प्रमाण समय के साथ यह काम करती प्रणालियों से मिलना चाहिए, जिनके हिसाब में ग़लतियाँ और अपवाद भी हों। वहीं दिलचस्प मॉडल वास्तुकला ऐसा बदलाव बनती है जिसे पाठक सचमुच देख सकते हैं।


