
顧客更改訂單地址。訊息還要求退款、提到包裹受損,並暗示這已是第三次出問題。把這則訊息轉成有用的回覆,是一項工作;判斷要更新哪些紀錄、由哪個團隊介入,以及哪些操作需要授權,則是另一項工作。
TypeSafe AI 於 2026 年 9 月 15 日開放搶先體驗的模型 Jev,瞄準的正是這類決策。它為軟體產生受約束的結構化答案。這次推出促使人們重新思考:應用程式有多少功能必須仰賴與通用模型進行長篇對話。 TypeSafe 的推出公告
TypeSafe 共同創辦人暨執行長 Diogo Almeida 在 swyx 主持、Latent Space 於 9 月 21 日刊出的訪談中,最完整地闡述了這套主張。我們檢視了這場兩小時二十二分鐘對談的完整英文字幕,並查閱產品文件。本文分析的是該訪談與公開證據;我們並未自行對 Jev 進行基準測試。 觀看原始訪談
我們認為,Jev 最具影響力的主張在於自動化的基本單位。一家公司或許能先自動化既有流程中的某個有限判斷,再考慮是否能負責任地交出整個流程。如果這類判斷的重複執行成本夠低,而且足夠明確、可供衡量,常見的商業軟體就可能獲得實用的新能力,而不必把每次互動都變成聊天。
這也會影響工作流程的設計者,而不只是使用者。仍須有人決定哪些操作獲准、什麼情況算錯,以及由誰處理例外。這些決策的品質,將決定這種做法帶來的是可靠服務,還是只是加快犯錯。
TypeSafe 實際推出了什麼
Jev 的文件所描述的介面會接收一個狀態,以及一組具型別的問題。它有三種基本操作:Choice 從指定選項中選擇;Score 依據評分規準進行評估;Noul 則以 0 到 1 的尺度表示某項陳述成立的機率。Choice 和 Score 會回傳分布及信心欄位;Noul 沒有獨立的信心欄位。多個問題可以共用所提供的狀態,並分別評估。 TypeSafe 的介面文件
在客服應用程式中,開發者可用這些基本操作區分改址與取消要求、評估急迫性,並檢查訊息中是否有損壞證據。這些是假設情境,並非 Jev 部署後的實績。接著由應用程式決定如何處理答案。
這種分工很有用,因為理解意圖與擁有行動權限是兩種不同職責。AI 可能推斷顧客想退款,但不能只因為得出這項結論,就取得核准退款的權限。應用程式可以查驗訂單、執行退款上限,並在適當情況下要求核准。
TypeSafe 將這類模型稱為 System One,借用快速、直覺思考的概念。應把這個名稱視為對預期工作負載的描述。它既不能證明模型具有人類般的認知,也不能劃出簡單與困難任務的明確界線。簡短問題也可能隱含複雜判斷,尤其是缺少必要資訊時。
工程上的改變:更小、更易檢視的決策
Almeida 主張把問題拆解:提出範圍明確的問題,再用程式碼組合答案。 訪談,1:03:02
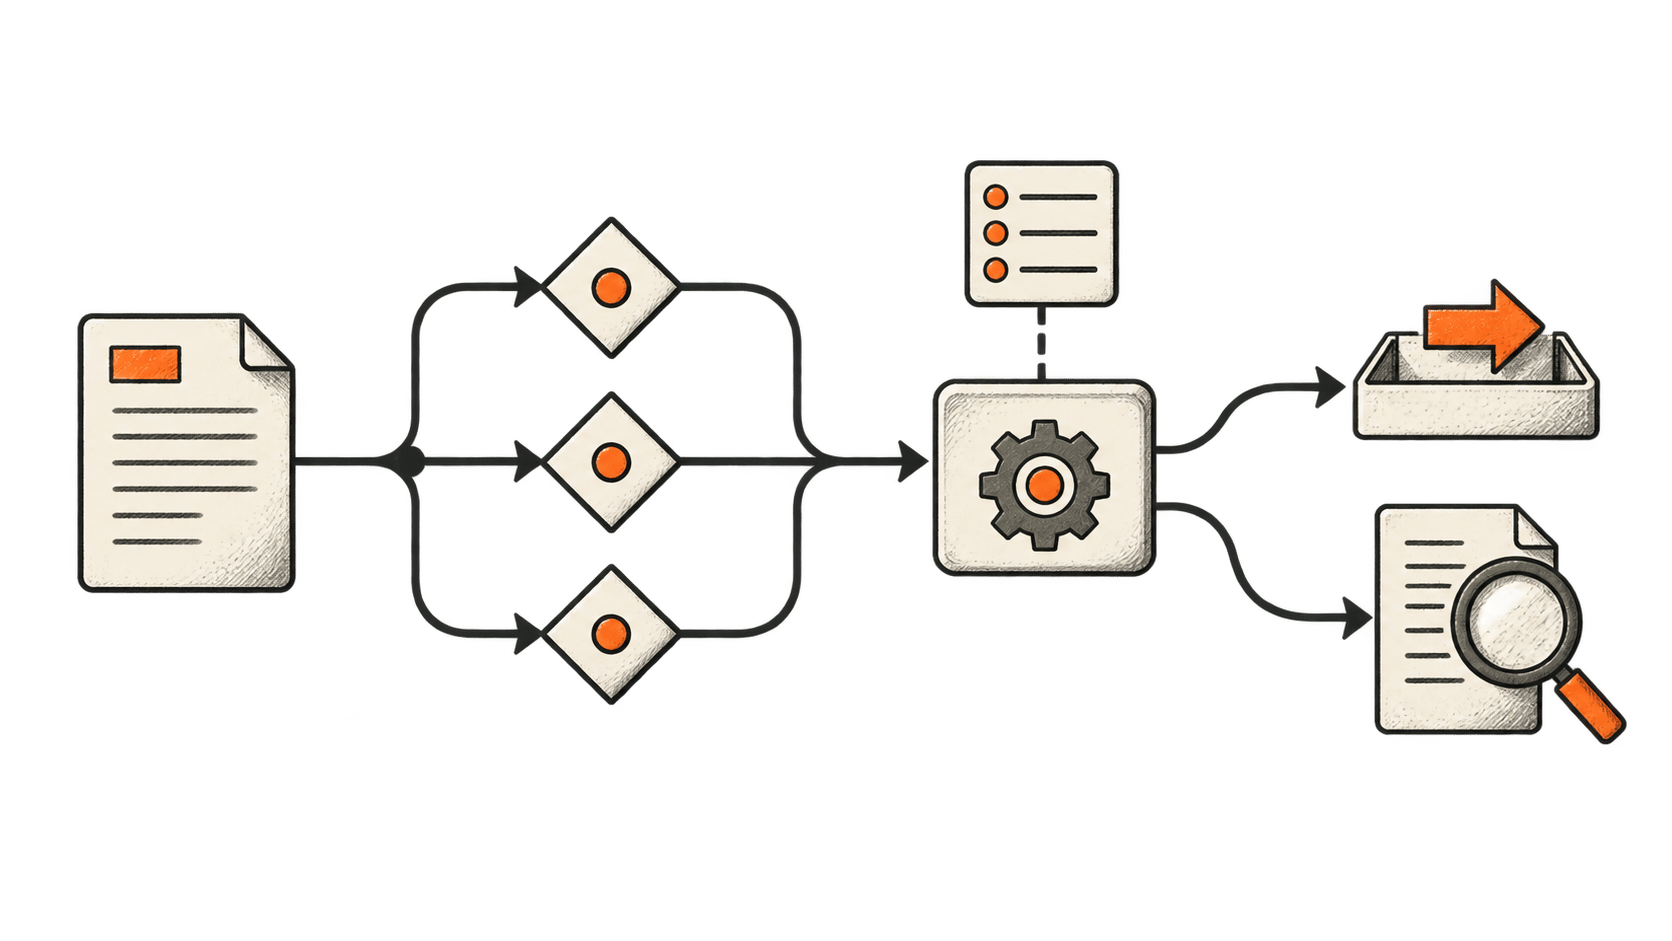
再看一次包裹受損的例子。只用一條指令處理客訴,會把好幾個判斷藏在同一個回答中。更容易檢視的設計,會分別確認顧客要求採取什麼行動、能否辨識訂單,以及現有證據是否支持損壞申訴。政策規則則留在這些判斷之外。
這樣更容易調查故障。如果系統把改址要求轉給退貨團隊,操作人員可以檢查分流決策;如果損壞評估有誤,就能用過往案例測試該元件。修改政策時,也可以直接調整明確規則,不必重寫一大段指令,再寄望模型每次都能一致解讀。
這種做法也有代價。元件愈多,需要維護的介面就愈多。問題可能意外漏掉有助於釐清答案的背景;兩個看似獨立的判斷,也可能依賴同一項誤導性證據。即使每個部分單獨看來都能接受,組合成的工作流程仍可能產生不可接受的結果。
TypeSafe 文件列出的模式包括同時提出多個問題、組合分數,以及將不確定的案例轉交進一步處理。這些是架構選項,並不能證明特定客戶流程已適合無人監督地運作。 TypeSafe 的模式
真正有用的檢驗,是拆解流程能否同時改善診斷能力與結果。能說明哪個步驟出錯固然重要;降低錯誤的頻率及後果,才是商業效益所在。
答案格式正確,仍可能答錯
對於 Jev「不會產生幻覺」的宣稱,必須採取狹義解讀。TypeSafe 將其保證範圍限定在輸出符合允許的結構。這並不能證明所選答案為真。TypeSafe 自己的公告也把結構保證與實證評估區分開來。 TypeSafe 對型別安全的說明
假設應用程式只允許以下幾種狀態:damaged、late與other。即使回傳damaged,而包裹實際上只是延誤,也完全符合格式。即使模型無法憑空創造第四種分類,它仍可能選錯。如果清單排除了真正需要的分類,那麼結構本身就成了問題的一部分。
結構化輸出也是既有的工程方法。OpenAI 於 2024 年 8 月推出受結構約束的 Structured Outputs,並明確指出模型仍可能在回傳值中出錯。因此,評估 Jev 時應檢視它在決策品質、不確定性回報、延遲與成本上的特定組合,而不應把所有結構化 AI 輸出都說成是它首創。 OpenAI 的原始公告與限制說明
對採購者而言,這項區分會改變評估計畫。格式測試會確認軟體能否讀取答案;事實測試會確認答案是否符合證據;政策測試則會確認後續操作是否獲准。通過其中一項,不能取代其餘測試。
訪談中最重要的挑戰:校準
在 1:09 左右,Almeida 否定模型能完美校準的說法,並承認模型會出錯。 訪談,1:08:50
校準關乎模型預測的機率,對照不同預測群組中的實際結果如何。模型可以有效提示不確定性,卻不代表每個高機率案例都答對。TypeSafe 的入門說明也保留了這項區分。 TypeSafe 對校準的說明
API 的信心欄位也需要進一步釐清。TypeSafe 將它描述為從答案分布推得的統計量,不能與「所選答案正確的機率」這種獨立測量值互換。文件建議依任務及其後果選擇門檻。 TypeSafe 的信心值文件
這些都是實際問題。假設分流模型處理簡短英文訊息時表現良好,卻難以理解混合多項要求的長篇客訴。單一整體分數可能掩蓋這項弱點。對較弱群組而言,高信心決策或許比熟悉群組中顯示相同數值的決策更需要審查。
因此,團隊應評估預期會收到的案例,包括資訊缺漏、陌生措辭及刻意混淆的輸入。應依類別檢視錯誤,並比較轉交人工審查的成本與錯誤行動的代價。門檻應是有證據支持的營運決策,而非從展示中照抄的數字。
校準研究早在 Jev 出現之前就已存在。Chuan Guo 等人於 2017 年發表、廣受引用的論文,探討了現代神經網路校準不佳的問題及改善方法。該研究為這個問題提供背景,並未驗證 TypeSafe 的模型。 現代神經網路的校準
可靠性也取決於服務變更時會發生什麼事
對談區分了穩健性與確定性,也談及版本穩定性,但並未承諾普遍適用的長期支援。 訪談,41:24;49:40
這些是不同的採購問題。確定性是指相同輸入是否總會產生相同輸出;穩健性則是指訂單編號等無關變動,是否會導致不合理的行為改變。模型可以一再給出同一個錯誤答案,仍然具備確定性;即使答案略有波動,周邊工作流程也可能依然可靠。
這兩項特性都無法消除生命週期風險。企業需要知道哪個模型版本產生了某項決策、該版本是否會持續提供,以及如何評估替代版本。供應商的測試顯示模型有所進步,仍可能改變客戶精心調校的工作流程。
明智的做法是保存具代表性的案例、記錄版本,並在遷移前比較替代版本。也需要備援方案:再準確的決策服務也可能中斷。如果應用程式沒有安全的暫停方式或其他分流管道,實務上,正常運作時間也會成為決策品質的一部分。
這正是吸引人的 API 轉化為營運依賴之處。採購、監控與遷移規劃不會因模型變快而消失。由於單次呼叫看起來如此簡單,這些工作反而更容易被忽略。
速度與價格數字需要哪些背景
TypeSafe 公布的工作流程成效包括速度提升 193.6 倍、成本降低至原來的 1/444.6。公告說明,這些是公司自行設計的工作流程中,效果最高的案例。參考答案來自其他模型的機率估計,而非獨立查證的標準答案。公司也提醒,短時間的展示有利於 Jev,長期可持續的定價仍待確認。 TypeSafe 對評估結果的限定說明
這些限定條件應與數字一併呈現。與參考模型一致或許有參考價值,但它衡量的不是答案是否符合已釐清的客戶案例。供應商設計的工作流程可能與買方相關,卻不一定代表買方實際收到的請求分布。
正確的比較應涵蓋整項工作:蒐集背景、做出決策、套用規則、處理例外,以及從故障中復原。如果模型呼叫較便宜,卻把太多工作轉交審查者,總成本仍可能更高;如果模型較慢,但能避免昂貴的返工,反而可能更划算。
延遲也應從應用程式實際所在的區域測量。靠近服務基礎設施的展示,不代表其他地區的使用者也有相同體驗。互動系統除了平均值,也應檢視耗時較長的請求;背景處理則可能更在意吞吐量與總成本。
Jev 的名稱借用了「效率提升可能擴大消耗」的概念。對個別企業而言,這引出一項預算問題:哪些新決策值得納入評估?哪些只是因為評估成本變低,才被不必要地評估?模型呼叫增加本身並不是成效。
不同的研究目標,以及尚未完成的證據
Almeida 將資料、任務選擇與 RLCD 的研究論點,連結到他對偏好最佳化的批評。 訪談,7:23;22:12
RLCD 是「校準決策強化學習」(Reinforcement Learning for Calibrated Decisions)的縮寫。TypeSafe 表示,這種訓練方式著重可用的決策與機率,並與以人類偏好及可驗證獎勵為主的做法相對照。這是公司對自身訓練目標的說明,不應誤當成完整訓練方法已獲獨立驗證。 TypeSafe 的 AI 入門指南
即使方法仍在接受評估,更廣泛的問題仍值得探討:訓練目標究竟在獎勵什麼行為?以產生有說服力的解釋為最佳化目標,可能讓模型更好用,卻未必能以程式可採取行動的形式揭露不確定性。以決策為核心的介面可以讓不確定性更容易處理,但輸出仍須透過外部檢查,確認是否符合現實。
TypeSafe 將這項疑慮連結到「模式坍縮」:偏好最佳化可能會讓常見輸出集中於人們偏好的回覆。這是 TypeSafe 對一種失效模式的解釋,並不表示每個經偏好訓練的模型都無法用於決策。 TypeSafe 對偏好最佳化的討論
Almeida 的背景讓這項主張格外值得關注。他是 InstructGPT 論文的共同作者;該研究探討以人類回饋訓練語言模型遵循指令。共同署名可查證,但對所有實驗室所犯錯誤的概括性說法,則是另一回事。 InstructGPT 論文
他對預訓練支出及缺乏明確方向的新創實驗室所提出的反對意見,也屬於同一套「應選擇有用任務」的論述。 訪談,1:49:32;2:03:10
對買方而言,相關啟示是:應詢問產品能為某個明確流程帶來什麼。研究背景、運算支出與獨特的模型架構,或許能說明一家公司如何打造產品,卻無法證明它在別家企業中的部署效益。
訪談也談到 Almeida 離開 OpenAI、早期採用的困難,以及由開發者帶動的成長。 訪談,1:31:27;1:56:48
這些回憶能說明公司的優先事項,但不是經稽核的採用證據。最終,開發者平台應以持續產生效益的工作負載,以及工作負載出錯時所提供的支援來評判。產品推出後受到熱烈關注,是值得進一步調查的理由,不能取代這類紀錄。
既有軟體可能比新的聊天視窗受益更多
Almeida 預期 SaaS 產品會變得更強大,而 AI 會退居幕後。 訪談,1:19:57
這個方向值得探索,因為既有軟體中已有許多環節,只要做出有用的判斷,就能改變後續步驟。排程應用程式可以在預訂前找出含糊的要求;媒體檔案庫可以協助研究人員整理資料;服務台可以分辨例行更新與需要關注的客訴。這些都是可能的設計,並非 Jev 已部署的實例。
介面可能幾乎不必改變。使用者會感受到錯誤變少、重複分類的工作減少,或更快找到合適的處理人員。已了解工作流程、又能把更好的決策整合進產品的公司,可能因此取得商業優勢。
既有軟體公司仍會面臨競爭。如果許多開發者都能取得相同的判斷能力,單靠模型呼叫就難以形成差異化。周邊產品還必須提供實用的資料存取、周到的互動設計,以及可靠的工作完成方式。
談到就業影響時更應審慎。減少某項工作的投入,可能改變人力配置、增加服務量,或將工作轉向例外處理。結果取決於組織與服務需求。訪談或搶先體驗的推出,都不足以證明特定數量的工作將被保留、消失或新增。
對 BIG CHANGE 的產業概覽而言,可衡量的事件是另一種決策自動化方法開始提供使用。廣泛採用、生產力提升與勞動市場影響,都是後續問題,需要不同證據才能回答。
暗資料、即時軟體與展示的限制
訪談談及儲存資料、互動式應用程式、驗證,以及電腦操作展示。 訪談,1:34:50
每種情境都需要不同的評估方式。檔案處理工作可以容忍一些延遲,但需要抽樣結果並追溯至原始紀錄的計畫。即時介面需要可預期的回應速度。用來檢查另一個模型的檢查器,則必須針對該模型實際會犯的錯誤進行測試,包括兩個系統可能犯下相同錯誤的案例。
在電腦操作中,選擇動作只是系統的一部分。系統還需要準確呈現介面、執行動作的方法,以及確認預期變更確實發生的檢查。精心設計的展示可以證明某個流程成功執行過一次;可靠的自動化則需要反覆測試,並能從中斷中復原。
同樣的審慎也適用於遊戲。由模型驅動的角色或許能根據更豐富的狀態做出反應,而遊戲引擎仍負責限制可執行的動作。這是否改善遊戲體驗,取決於回應速度、一致性與體驗設計。每一影格都加入推論,並不會自動讓遊戲更有趣。
這些區分能避免類別錯誤:應根據有用元件實際執行的角色來肯定它,不應將周邊整個應用程式的所有能力都算在它頭上。
訪談也將微調、視覺能力與其他模型形式列為可能發展。 訪談,1:10:27;1:26:23
不要把談論產品路線圖當成推出計畫時可以仰賴的功能。應以目前可用的介面設計,找出哪些需求須由獨立元件提供,並在新能力實際推出後再評估。如此既能把握日後改進的機會,也不會把推測說成產品功能。
程式碼代理可以用不同方式分工
Almeida 提議,除了單一模型循環外,也可用更低成本處理狀態,並讓程式碼代理共用背景資訊。 訪談,1:40:17;2:09:29
一種可能的架構是由能力較強的程式碼模型撰寫變更,再用較小的決策呼叫分類相關檔案,並由一般軟體管理後續任務,最後交由另一個審查者檢視修補內容。這是設計構想,不是經基準測試的建議,也不能證明 Jev 已取代現有的程式碼代理。
這種做法吸引人的地方,在於選擇性地提供背景資訊。如果子任務只需要一個介面與少數限制,傳送整段對話可能很浪費。明確的任務紀錄則有助於辨認哪些事實相關、哪些事項已決定,以及還有哪些變更待處理。
危險之處,是把協調上的建議誤當成並行作業保證。兩個代理可能都認為自己應該寫入同一個檔案。不能用機率模型取代防止寫入衝突的軟體機制;權限、版本檢查與鎖定仍須確實限制最終結果。
同樣地,降低取回過往工作的成本,或許能改善記憶管理,卻不能解決所有被稱為持續學習的問題。記住先前的嘗試、理解失敗原因,以及可靠地因應新情況,是彼此不同的能力。若要提出有說服力的評估,應檢視任務是否完成、有無退化或衝突,以及需要多少人工介入,而不能只計算代理或呼叫的數量。
安全責任會沿著系統移動,不會憑空消失
Almeida 偏好在應用程式層實施安全控制,而非依賴模型拒絕;swyx 則質疑此做法的後果。 訪談,13:11;1:42:29
這裡確實有一項設計難題:無人監督的應用程式必須處理依賴服務拒絕、故障或回傳不確定結果等情況,並設置明確的因應途徑。但這項觀察本身並未解決所有防護措施應設在哪一層。
即使模型正確辨認出預期操作,應用程式仍應執行存取權限。一項刪除紀錄的要求可能完全被理解,卻仍未獲授權;要求也可能在技術上有效,卻違反操作者的政策。若缺少適當背景,決策服務就無法妥善回答這些問題,而應用程式必須保有對實際操作的控制權。
因此,把更多決策移入軟體,也提高了部署前明確界定界線的重要性。團隊需要決定必須具備哪些證據、哪些操作仍可復原,以及人們如何質疑或更正結果。只移除與模型互動時不順手的步驟,並不足以證明整個系統安全。
哪些證據才能證明重大改變
這次推出提供了一個明確的實驗機會。選擇一項結果可觀察、範圍有限的流程,記錄目前的運作方式,包括錯誤,以及人們花多少時間修復錯誤。先以具代表性的案例測試決策式方案,再賦予它執行操作的權限。
衡量無須介入即可正確完成的案例比例、未被審查攔下的錯誤、轉交給人員的工作量,以及每個完成案例的總成本。保留原始證據,讓審查者能檢視接受結果的理由。當模型、政策或輸入對象改變時,應再次比較。
評估結果可能顯示,流程只有一部分已準備好自動化。這仍是有用的發現。只自動化例行分類,把模糊案例交由有經驗的操作人員處理,可能就有價值,卻不代表整個流程可以交由更廣泛的自主系統處理。
Jev 的推出及 Almeida 的訪談提出了一項雄心勃勃的假設,描述 AI 如何進入經濟:反覆執行、受約束的決策,能讓人們已仰賴的軟體變得更有能力。接下來的證據應來自長期執行這類工作的系統,並把錯誤與例外都納入計算。如此,有趣的模型架構才會成為讀者看得見的改變。


