
Um cliente altera o endereço de um pedido. A mensagem também solicita um reembolso, menciona uma embalagem danificada e sugere que esta é a terceira vez que algo dá errado. Transformar essa mensagem em uma resposta útil é uma tarefa. Decidir quais registros atualizar, qual equipe deve intervir e quais ações exigem permissão é outra.
O Jev, modelo que a TypeSafe AI disponibilizou em acesso antecipado em 15 de setembro de 2026, foi criado para essas decisões. Ele gera respostas estruturadas e restritas para uso em softwares. O lançamento convida a repensar quanto de um aplicativo deveria depender de uma longa conversa com um modelo de uso geral. Anúncio de lançamento da TypeSafe
O argumento é apresentado em detalhes na entrevista de 21 de setembro do Latent Space com o cofundador e CEO da TypeSafe, Diogo Almeida, conduzida por swyx. Analisamos as legendas completas em inglês da conversa, que dura duas horas e 22 minutos, e conferimos a documentação do produto. Este artigo analisa a entrevista e as evidências públicas; não fizemos um benchmark independente do Jev. Assista à entrevista original
Em nossa leitura, a proposta mais importante do Jev diz respeito à unidade de automação. Uma empresa talvez consiga automatizar um julgamento delimitado dentro de um processo existente antes de delegar o processo inteiro com responsabilidade. Se esse julgamento se tornar barato o bastante para ser repetido e claro o bastante para ser medido, softwares empresariais conhecidos poderão ganhar recursos úteis sem transformar cada interação numa conversa por chat.
Isso afetaria tanto quem projeta fluxos de trabalho quanto quem os utiliza. Alguém ainda precisa decidir quais ações são permitidas, o que conta como erro e quem trata das exceções. A qualidade dessas decisões determinará se a abordagem cria serviços confiáveis ou apenas acelera os erros.
O que a TypeSafe realmente lançou
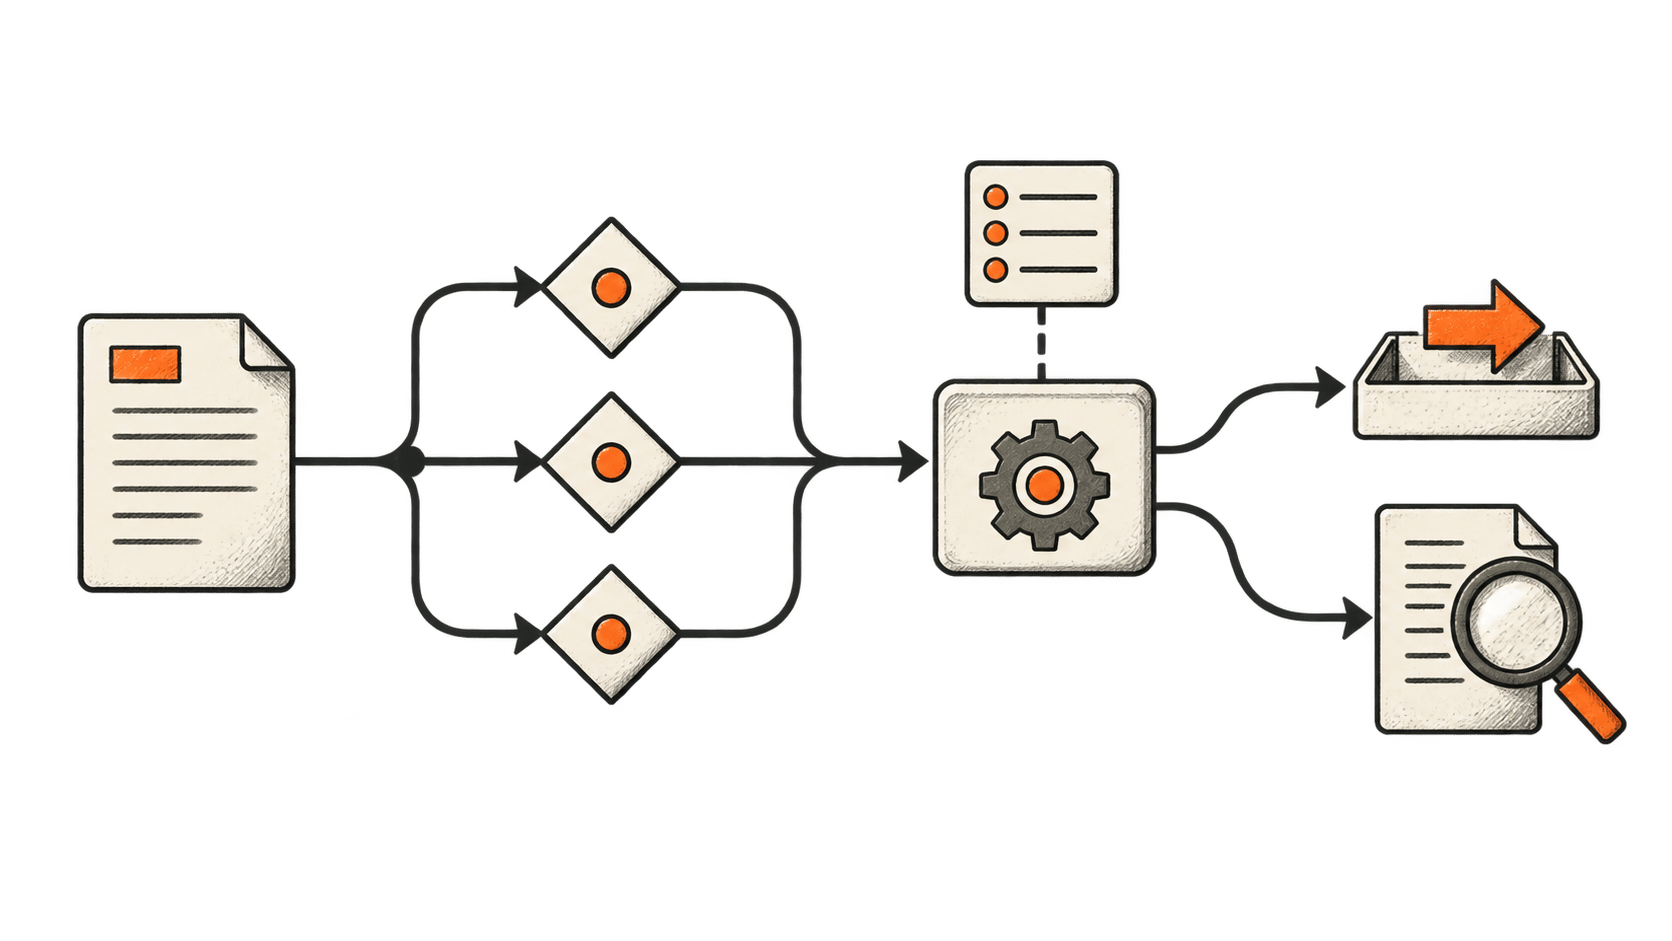
A interface documentada do Jev recebe um estado e um conjunto de perguntas tipadas. Seus três elementos básicos são Choice, que seleciona entre opções especificadas; Score, que avalia com base em uma rubrica; e Noul, que expressa a probabilidade de uma afirmação numa escala de zero a um. Choice e Score retornam distribuições e um campo de confiança. Noul não tem esse campo de confiança separado. As perguntas podem compartilhar o estado fornecido e ser avaliadas de forma independente. Documentação da interface da TypeSafe
Num aplicativo de atendimento ao cliente, um desenvolvedor poderia usar esses elementos para distinguir um pedido de alteração de endereço de um cancelamento, avaliar a urgência e verificar se a mensagem traz evidências de danos. São exemplos hipotéticos, não resultados de uma implantação do Jev. Depois, o aplicativo decidiria o que fazer com as respostas.
Essa separação é útil porque interpretar e ter autoridade são responsabilidades diferentes. Uma IA pode inferir que o cliente quer um reembolso. Não deveria ganhar permissão para concedê-lo apenas por chegar a essa conclusão. O aplicativo pode verificar o pedido, impor um limite de reembolso e exigir aprovação quando for apropriado.
A TypeSafe chama essa categoria de modelo de System One, recorrendo à ideia de pensamento rápido e intuitivo. O nome descreve o tipo de tarefa pretendido. Não certifica uma cognição semelhante à humana nem estabelece um limite claro entre tarefas fáceis e difíceis. Uma pergunta curta pode esconder um julgamento complexo, sobretudo quando faltam informações necessárias.
A mudança de engenharia são decisões menores e inspecionáveis
Almeida defende decompor o problema: fazer perguntas de escopo restrito e combinar as respostas no código. Entrevista, 1:03:02
Voltemos ao exemplo do pedido danificado. Uma única instrução para resolver a reclamação esconde vários julgamentos numa só resposta. Um design mais fácil de inspecionar determinaria separadamente a ação solicitada, se é possível identificar o pedido e se as evidências disponíveis sustentam uma alegação de dano. As regras de política ficariam fora desses julgamentos.
Isso facilita investigar uma falha. Se o sistema encaminhar uma alteração de endereço para a equipe de devoluções, o operador poderá examinar a decisão de encaminhamento. Se a avaliação do dano estiver errada, será possível testar esse componente com casos anteriores. Uma mudança de política poderá alterar uma regra explícita sem obrigar a equipe a reescrever uma instrução ampla e torcer para que o modelo a interprete sempre da mesma maneira.
Há custos. Mais componentes significam mais interfaces para manter. Perguntas podem omitir por acidente um contexto que esclareceria a resposta. Dois julgamentos aparentemente independentes podem depender das mesmas evidências enganosas. Um fluxo de trabalho montado com partes aceitáveis individualmente ainda pode produzir um resultado inaceitável.
Os padrões documentados pela TypeSafe incluem fazer várias perguntas em conjunto, combinar pontuações e encaminhar casos incertos para análise adicional. Eles descrevem opções de arquitetura, não provam que um processo específico de atendimento ao cliente esteja pronto para operar sem supervisão. Padrões da TypeSafe
O teste útil é verificar se a decomposição melhora tanto o diagnóstico quanto os resultados. Conseguir explicar qual etapa falhou é valioso. O argumento comercial depende de reduzir a frequência e as consequências dessas falhas.
Uma resposta válida ainda pode estar errada
A afirmação do lançamento de que o Jev “não pode alucinar” precisa ser interpretada de forma restrita. A garantia da TypeSafe diz respeito a corresponder ao esquema de saída permitido. Isso não comprova que a resposta selecionada seja verdadeira. O próprio anúncio diferencia as garantias do esquema da avaliação empírica. Explicação da TypeSafe sobre segurança de tipos
Suponha que um aplicativo permita os valores damaged, late e other. Retornar damaged é perfeitamente válido mesmo que a encomenda tenha apenas atrasado. Um modelo incapaz de inventar uma quarta categoria ainda pode escolher a errada. Se a lista deixar de fora uma categoria realmente necessária, o próprio esquema passa a fazer parte do problema.
Saídas estruturadas também já são uma abordagem de engenharia. Em agosto de 2024, a OpenAI lançou a funcionalidade Structured Outputs, que impõe um esquema, e observou explicitamente que o modelo ainda poderia errar nos valores retornados. Portanto, o Jev deve ser avaliado pela combinação específica de qualidade das decisões, comunicação de incerteza, latência e custo — não receber o crédito por ter inventado todas as saídas estruturadas de IA. Anúncio original da OpenAI e suas limitações
Para os compradores, essa distinção muda o plano de avaliação. Um teste de esquema pergunta se o software consegue consumir a resposta. Um teste factual pergunta se ela está de acordo com as evidências. Um teste de política pergunta se a ação resultante é permitida. Passar em um deles não substitui passar nos demais.
O desafio mais importante da entrevista diz respeito à calibração
Às 1:09, Almeida rejeita a ideia de calibração perfeita e reconhece que o modelo comete erros. Entrevista, 1:08:50
Calibração diz respeito à correspondência entre probabilidades previstas e resultados observados em grupos de previsões. Um modelo pode ser útil para sinalizar incerteza sem acertar todos os casos aos quais atribui alta probabilidade. O guia da TypeSafe preserva explicitamente essa distinção. Explicação da TypeSafe sobre calibração
O campo de confiança da API exige outra distinção. A TypeSafe o descreve como uma estatística derivada da distribuição de respostas. Ele não equivale a uma probabilidade medida de forma independente de que a resposta selecionada esteja correta. A documentação recomenda escolher limites adequados à tarefa e às suas consequências. Documentação da TypeSafe sobre confiança
Essas são preocupações práticas. Imagine um modelo de encaminhamento que funciona bem com mensagens curtas em inglês, mas tem dificuldade com reclamações longas que misturam vários pedidos. Uma única pontuação agregada pode ocultar essa fraqueza. Uma decisão de alta confiança no grupo mais difícil talvez mereça mais atenção do que a mesma pontuação exibida no grupo mais familiar.
Uma equipe deve, portanto, avaliar os casos que espera receber, incluindo informações ausentes, formulações desconhecidas e entradas deliberadamente confusas. Deve analisar os erros por categoria e comparar o custo de encaminhar um caso para revisão com o custo de agir incorretamente. Assim, os limites tornam-se decisões operacionais amparadas por evidências, não números copiados de uma demonstração.
A pesquisa sobre calibração é muito anterior ao Jev. Um artigo de 2017, bastante citado, de Chuan Guo e colegas, examinou a calibração deficiente de redes neurais modernas e métodos para aprimorá-la. Esse trabalho contextualiza o problema; não valida o modelo da TypeSafe. Sobre a calibração de redes neurais modernas
A confiabilidade também depende do que acontece quando o serviço muda
A conversa diferencia robustez de determinismo e discute a estabilidade das versões sem prometer suporte de longo prazo em geral. Entrevista, 41:24 e 49:40
Essas são perguntas diferentes para quem compra. Determinismo pergunta se entradas idênticas produzem saídas idênticas. Robustez pergunta se uma mudança irrelevante, como outro identificador de registro, provoca uma alteração desproporcional no comportamento. Um modelo pode repetir indefinidamente a mesma resposta errada e ainda ser determinístico. Também pode variar um pouco enquanto o fluxo de trabalho ao redor continua confiável.
Nenhuma dessas propriedades resolve o risco ao longo do ciclo de vida. Uma empresa precisa saber qual versão do modelo produziu uma decisão, se ela continuará disponível e como será avaliada uma substituta. Uma melhoria nos testes do fornecedor ainda pode mudar o comportamento de um fluxo de trabalho do cliente ajustado cuidadosamente.
A resposta sensata é preservar casos representativos, registrar as versões e comparar as substitutas antes de transferir tarefas importantes. Também é preciso ter uma alternativa: um serviço de decisão preciso pode ficar indisponível. Se o aplicativo não tiver uma forma segura de pausar ou encaminhar o trabalho para outro lugar, na prática a disponibilidade passa a fazer parte da qualidade das decisões.
É nesse ponto que uma API atraente vira uma dependência operacional. Compras, monitoramento e planejamento de migração não desaparecem quando o modelo fica mais rápido. Fica mais fácil negligenciá-los porque cada chamada parece tão simples.
Por que os números de velocidade e preço precisam de contexto
Os principais resultados de fluxo de trabalho anunciados pela TypeSafe incluem um aumento de 193,6 vezes na velocidade e uma redução de 444,6 vezes no custo. O anúncio os identifica como ganhos máximos em fluxos de trabalho criados pela própria empresa. As respostas de referência vieram das estimativas de probabilidade de outros modelos, e não de classificações de verdade fundamental verificadas de forma independente. A empresa também alerta que sua breve demonstração favorece o Jev e que os preços sustentáveis de longo prazo ainda precisam ser estabelecidos. Ressalvas da avaliação da TypeSafe
Essas ressalvas devem acompanhar os números. A concordância com um modelo de referência pode ser informativa, mas mede algo diferente da correção diante de um caso de cliente já resolvido. Um fluxo de trabalho projetado pelo fornecedor pode ser relevante para um comprador sem representar a distribuição de solicitações desse comprador.
A comparação adequada deve incluir o trabalho inteiro: reunir contexto, tomar decisões, aplicar regras, tratar exceções e se recuperar de falhas. Uma chamada de modelo mais barata pode coexistir com um custo total maior se encaminhar trabalho demais para revisores. Uma chamada mais lenta pode ser econômica se evitar retrabalho caro.
A latência também precisa ser medida na região real do aplicativo. Uma demonstração próxima à infraestrutura do serviço não promete a mesma experiência para um usuário em outro lugar. Sistemas interativos devem analisar as solicitações lentas, além da média; o processamento em segundo plano talvez dependa mais da vazão e do custo total.
O nome Jev remete à ideia de que ganhos de eficiência podem ampliar o consumo. Para uma empresa, isso levanta uma questão orçamentária: quais novas decisões passam a valer a pena avaliar e quais apenas ficam baratas o bastante para serem avaliadas sem necessidade? Fazer mais chamadas ao modelo não é, por si só, um resultado.
Outro objetivo de pesquisa, com evidências ainda incompletas
O argumento de pesquisa de Almeida relaciona dados, seleção de tarefas e RLCD à crítica que ele faz à otimização por preferências. Entrevista, 7:23 e 22:12
RLCD significa Reinforcement Learning for Calibrated Decisions, ou aprendizado por reforço para decisões calibradas. A TypeSafe o apresenta como um treinamento voltado a decisões e probabilidades úteis, em contraste com abordagens baseadas em preferências humanas e recompensas verificáveis. Essa é a descrição da empresa para seu objetivo. Não deve ser confundida com uma verificação independente do método completo de treinamento. Guia de IA da TypeSafe
Vale investigar a questão mais ampla enquanto o método é avaliado: que comportamento um objetivo de treinamento recompensa? Um modelo otimizado para dar explicações convincentes pode ser agradável de usar sem expor a incerteza de uma forma que o código consiga usar. Uma interface voltada a decisões pode facilitar o tratamento da incerteza, mas suas respostas ainda precisam ser verificadas externamente em relação à realidade.
A TypeSafe relaciona essa preocupação ao chamado mode dropping: a otimização por preferências pode estreitar a gama de respostas prováveis, favorecendo aquelas que as pessoas recompensam. Essa é a explicação da empresa para um modo de falha, não uma constatação de que todos os modelos treinados com preferências sejam inadequados para tomar decisões. Discussão da TypeSafe sobre otimização por preferências
A trajetória de Almeida torna o argumento especialmente interessante. Ele é coautor do artigo sobre o InstructGPT, que estudou o treinamento de modelos de linguagem para seguir instruções usando feedback humano. Essa autoria é verificável; afirmações abrangentes sobre tudo que todos os laboratórios fazem de errado são outra coisa. Artigo sobre o InstructGPT
As objeções dele aos gastos com pré-treinamento e à criação de novos laboratórios sem foco fazem parte do mesmo argumento sobre selecionar tarefas úteis. Entrevista, 1:49:32 e 2:03:10
Para um comprador, a lição relevante é perguntar o que o produto pode fazer em um processo definido. A trajetória de pesquisa, os gastos com computação e uma arquitetura de modelo diferente podem explicar como uma empresa chegou à oferta. Não estabelecem a economia de implantá-la no negócio de outra pessoa.
A entrevista também aborda a saída de Almeida da OpenAI, as dificuldades da adoção inicial e o crescimento liderado por desenvolvedores. Entrevista, 1:31:27 e 1:56:48
Essas lembranças explicam as prioridades da empresa. Não são evidências auditadas de adoção. Uma plataforma para desenvolvedores deve ser avaliada, em última análise, pelo uso contínuo em tarefas úteis e pelo suporte oferecido quando elas falham. O entusiasmo após um lançamento é motivo para investigar, não substituto desse histórico.
Os softwares existentes podem ganhar mais do que uma nova janela de chat
Almeida prevê produtos SaaS melhores e uma IA que fique em segundo plano. Entrevista, 1:19:57
É uma direção plausível para investigar, pois os softwares já contêm pontos em que um julgamento útil poderia mudar a próxima etapa. Um aplicativo de agendamento poderia identificar um pedido ambíguo antes de reservar um horário. Um arquivo de mídia poderia organizar materiais para um pesquisador. Uma central de serviços poderia distinguir uma atualização rotineira de uma reclamação que exige atenção. São designs possíveis, não implantações relatadas do Jev.
A interface talvez quase não mude. Os usuários perceberiam menos erros, menos classificações repetitivas ou uma espera menor pela pessoa certa. A vantagem comercial poderia caber às empresas que já entendem o fluxo de trabalho e conseguem incorporar decisões melhores a ele.
As empresas de software existentes ainda enfrentariam concorrência. Se o mesmo tipo de julgamento ficar acessível a muitos desenvolvedores, a chamada ao modelo, por si só, pouco diferenciará um produto. O software ao redor precisa oferecer acesso útil aos dados, uma interface bem projetada e uma forma confiável de concluir o trabalho.
É preciso ter mais cautela nas afirmações sobre emprego. Reduzir o esforço de uma tarefa pode mudar o quadro de funcionários, aumentar o volume de serviços ou deslocar trabalho para o tratamento de exceções. Esses resultados dependem da organização e da demanda por seu serviço. Nem uma entrevista nem um lançamento em acesso antecipado demonstram que determinada quantidade de empregos será protegida, eliminada ou criada.
No panorama do setor da BIG CHANGE, o acontecimento mensurável é a disponibilidade de outra abordagem à automação de decisões. A adoção generalizada, os ganhos de produtividade e os efeitos no mercado de trabalho são questões posteriores, que exigem evidências diferentes.
Dados obscuros, software em tempo real e os limites de uma demonstração
A entrevista aborda dados armazenados, aplicativos interativos, verificação e demonstrações de uso do computador. Entrevista, 1:34:50
Cada categoria sugere uma avaliação diferente. Uma tarefa de processamento de arquivos pode tolerar algum atraso, mas requer um plano para amostrar resultados e rastreá-los até os registros originais. Uma interface em tempo real precisa responder de forma previsível. Um verificador que avalia outro modelo deve ser testado com os erros que esse modelo realmente comete, inclusive casos em que ambos compartilham o mesmo erro.
No uso do computador, escolher uma ação é apenas uma parte do sistema. Ele também precisa representar a interface com precisão, executar a ação e verificar se a mudança esperada ocorreu. Uma demonstração bem apresentada pode comprovar que uma sequência aconteceu uma vez; uma automação confiável exige tentativas repetidas e recuperação após interrupções.
A mesma cautela vale para jogos. Um personagem controlado por modelo pode reagir a um estado mais rico, enquanto o motor do jogo continua limitando as ações possíveis. A melhora da experiência depende da velocidade de resposta, da consistência e do design. Acrescentar inferência a cada quadro não tornaria automaticamente um jogo mais interessante.
Essas distinções evitam um erro de categoria: um componente útil deve ser valorizado pelo papel que desempenha, sem receber por associação todas as capacidades do aplicativo maior em que está inserido.
O ajuste fino, a visão computacional e outros formatos de modelo surgem como possibilidades na entrevista. Entrevista, 1:10:27 e 1:26:23
Uma conversa sobre o roteiro de desenvolvimento não deve virar uma dependência no plano de lançamento. Construa o produto com a interface disponível, identifique o que um componente separado precisa fornecer e avalie qualquer recurso novo quando ele realmente chegar. Assim, é possível aproveitar melhorias futuras sem apresentar especulações como funcionalidades do produto.
Agentes de programação poderiam dividir o trabalho de outra forma
Almeida propõe gerenciar estados com menor custo e compartilhar contexto entre agentes de programação, em vez de usar um único modelo em todo o ciclo. Entrevista, 1:40:17 e 2:09:29
Uma arquitetura possível usaria um modelo de programação capaz para desenvolver uma alteração, chamadas menores de decisão para classificar arquivos relevantes e software convencional para gerenciar as tarefas resultantes. Um revisor separado poderia examinar a versão final. Trata-se de uma proposta de design, não de uma recomendação baseada em benchmarks nem de evidência de que o Jev já substitua um agente de programação existente.
O aspecto atraente é selecionar o contexto. Se uma subtarefa precisar de apenas uma interface e alguns requisitos, talvez seja um desperdício enviar uma conversa inteira. Registros explícitos das tarefas poderiam facilitar a identificação dos fatos relevantes, das decisões já tomadas e das alterações que ainda faltam.
O perigo está em confundir uma sugestão de coordenação com uma garantia de execução concorrente. Dois agentes podem acreditar que ambos devem gravar o mesmo arquivo. Um modelo probabilístico não deve substituir os mecanismos de software que evitam gravações conflitantes. Permissões, verificações de versão e bloqueios ainda precisam garantir o resultado.
Da mesma forma, recuperar trabalhos anteriores com menor custo pode melhorar o gerenciamento da memória sem resolver todos os problemas reunidos sob o nome de aprendizado contínuo. Lembrar uma tentativa anterior, entender por que ela falhou e adaptar-se de modo confiável a uma situação nova são capacidades distintas. Uma avaliação convincente examinaria tarefas concluídas, regressões, conflitos e intervenções humanas, não apenas a quantidade de agentes ou chamadas.
A segurança percorre o sistema; ela não desaparece
Almeida prefere controles de segurança no nível do aplicativo a recusas do modelo; swyx questiona as consequências. Entrevista, 13:11 e 1:42:29
Há um problema real de design: um aplicativo sem supervisão precisa lidar com casos em que uma dependência recusa, falha ou retorna um resultado incerto. É necessário definir uma resposta explícita para cada situação. Essa constatação não determina onde todas as salvaguardas devem ficar.
Um aplicativo deve impor permissões de acesso mesmo quando o modelo identifica corretamente a ação pretendida. Um pedido para excluir um registro pode ser perfeitamente compreendido e ainda assim não estar autorizado. Um pedido também pode ser tecnicamente válido e violar a política do operador. O serviço de decisão não pode responder a essas perguntas com responsabilidade sem o contexto adequado, e o aplicativo precisa manter o controle da ação.
Transferir mais decisões para o software aumenta, portanto, a importância de definir limites antes da implantação. As equipes precisam decidir quais evidências são exigidas, quais operações continuam reversíveis e como uma pessoa pode contestar ou corrigir um resultado. Eliminar uma interação incômoda com o modelo não basta para comprovar que o sistema inteiro é seguro.
O que comprovaria uma grande mudança
O lançamento possibilita um experimento claro. Escolha um processo delimitado e com resultado observável. Registre como ele funciona hoje, incluindo erros e o tempo que as pessoas gastam para corrigi-los. Teste uma versão baseada em decisões com casos representativos antes de lhe dar autoridade para agir.
Meça a proporção de casos concluídos corretamente sem intervenção, os erros que passam pela revisão, o volume de trabalho transferido às pessoas e o custo total por caso concluído. Mantenha as evidências originais disponíveis para que um revisor possa examinar por que o resultado foi aceito. Repita a comparação quando o modelo, a política ou o conjunto de entradas mudar.
A avaliação pode revelar que apenas uma parte do processo está pronta. Esse é um resultado útil. Automatizar a classificação rotineira e deixar os casos ambíguos com um operador experiente pode valer a pena sem justificar uma autonomia mais ampla.
O lançamento do Jev e a entrevista de Almeida apresentam uma hipótese ambiciosa sobre a entrada da IA na economia: decisões repetidas e restritas podem tornar mais capazes os softwares de que as pessoas já dependem. As próximas evidências devem vir de sistemas que realizem esse trabalho ao longo do tempo, contabilizando erros e exceções. É assim que uma arquitetura interessante de modelo se transforma em uma mudança que os leitores conseguem perceber.


