
Um cliente altera a morada de uma encomenda. A mensagem também pede um reembolso, menciona uma embalagem danificada e sugere que esta é a terceira vez que algo corre mal. Transformar a mensagem numa resposta útil é uma tarefa. Decidir que registos atualizar, que equipa deve intervir e que ações exigem autorização é outra.
A Jev, o modelo que a TypeSafe AI lançou em acesso antecipado a 15 de setembro de 2026, destina-se a tomar esse tipo de decisão. Produz respostas estruturadas e limitadas para software. O lançamento convida a reconsiderar até que ponto uma aplicação deve depender de uma conversa longa com um modelo de uso geral. Anúncio de lançamento da TypeSafe
O argumento é desenvolvido em maior profundidade na entrevista de 21 de setembro da Latent Space com o cofundador e CEO da TypeSafe, Diogo Almeida, conduzida por swyx. Revimos as legendas completas em inglês da conversa, com duas horas e 22 minutos, e consultámos a documentação do produto. Trata-se de uma análise da entrevista e das provas públicas; não fizemos uma avaliação comparativa independente da Jev. Ver a entrevista original
Na nossa leitura, a proposta mais importante da Jev diz respeito à unidade de automatização. Uma empresa poderá conseguir automatizar um juízo delimitado dentro de um processo existente antes de poder entregar responsavelmente todo o processo ao sistema. Se esse juízo se tornar suficientemente barato para ser repetido e claro para ser medido, o software empresarial conhecido poderá ganhar capacidades úteis sem que cada interação se transforme numa conversa.
Isso afetaria tanto quem concebe os fluxos de trabalho como quem os utiliza. Alguém continuará a ter de decidir que ações são permitidas, o que conta como erro e quem trata das exceções. A qualidade dessas decisões determinará se esta abordagem cria serviços fiáveis ou apenas acelera os erros.
O que a TypeSafe lançou realmente
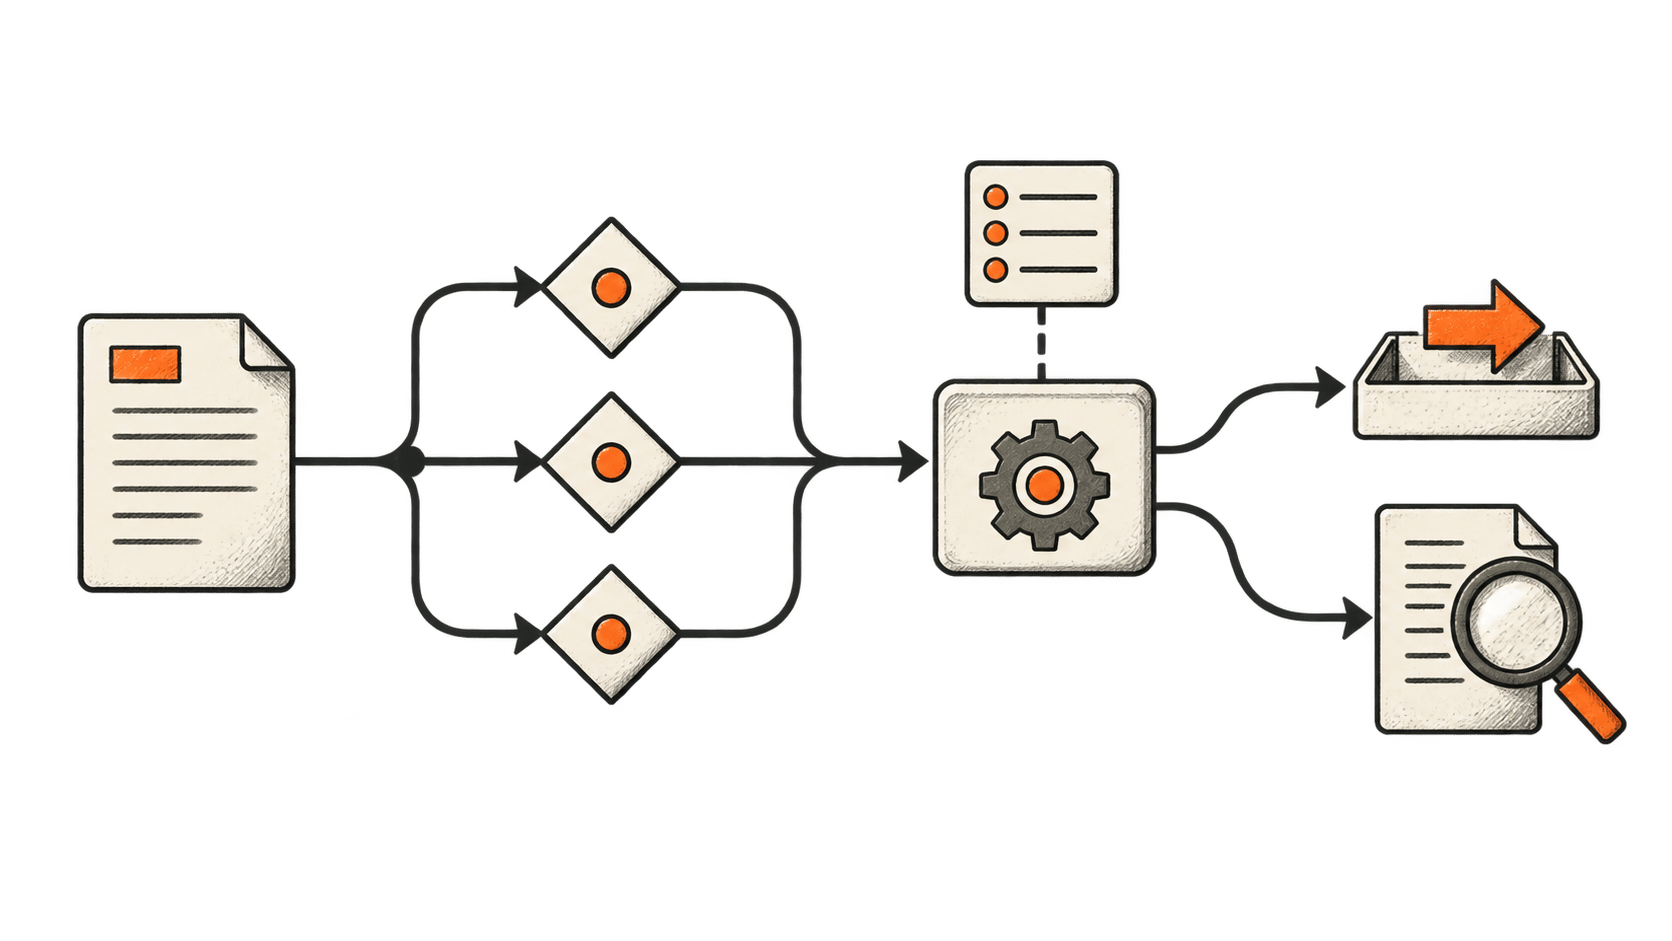
A interface documentada da Jev recebe um estado e um conjunto de perguntas tipadas. Os três elementos básicos são Choice, que seleciona entre opções especificadas; Score, que avalia segundo uma grelha; e Noul, que exprime a probabilidade de uma afirmação numa escala de zero a um. Choice e Score devolvem distribuições e um campo de confiança. Noul não tem esse campo de confiança separado. As perguntas podem partilhar o estado fornecido, embora sejam avaliadas de forma independente. Documentação da interface da TypeSafe
Numa aplicação de apoio ao cliente, um programador poderia utilizar esses elementos para distinguir um pedido de alteração de morada de um cancelamento, avaliar a urgência e verificar se uma mensagem contém provas de danos. São exemplos hipotéticos, não resultados de uma implementação da Jev. A aplicação decidiria depois o que fazer com as respostas.
Esta divisão é útil porque a interpretação e a autoridade são responsabilidades diferentes. Uma IA pode inferir que um cliente pretende um reembolso. Não deve, apenas por chegar a essa conclusão, adquirir autorização para o emitir. A aplicação pode verificar a encomenda, aplicar um limite ao reembolso e exigir aprovação quando for adequado.
A TypeSafe chama a esta categoria de modelos System One, recorrendo à linguagem do pensamento rápido e intuitivo. O nome deve ser entendido como uma descrição das tarefas pretendidas. Não certifica uma cognição semelhante à humana nem estabelece uma fronteira nítida entre tarefas fáceis e difíceis. Uma pergunta breve pode esconder um juízo complexo, sobretudo quando faltam informações necessárias.
A mudança de engenharia consiste em decisões menores e inspecionáveis
Almeida defende a decomposição: fazer perguntas de âmbito restrito e, depois, combinar as respostas em código. Entrevista, 1:03:02
Consideremos novamente o exemplo da encomenda danificada. Uma única instrução para tratar a reclamação oculta vários juízos numa só resposta. Uma conceção mais inspecionável determinaria separadamente a ação pretendida, se é possível identificar a encomenda e se as provas disponíveis sustentam uma alegação de danos. As regras da política ficariam fora desses juízos.
Isto facilita a investigação de uma falha. Se o sistema encaminhar uma alteração de morada para a equipa de devoluções, o operador pode analisar a decisão de encaminhamento. Se a avaliação dos danos estiver errada, esse componente pode ser testado com casos anteriores. Uma alteração da política pode modificar uma regra explícita sem obrigar a equipa a reescrever uma instrução ampla e esperar que o modelo a interprete de forma consistente.
Há custos. Mais componentes significam mais interfaces para manter. As perguntas podem omitir acidentalmente contexto que tornaria a resposta clara. Dois juízos aparentemente independentes podem depender das mesmas provas enganosas. Um fluxo de trabalho composto por elementos individualmente aceitáveis pode ainda assim produzir um resultado inaceitável.
Os padrões documentados pela TypeSafe incluem colocar várias perguntas em conjunto, combinar pontuações e encaminhar casos incertos para tratamento adicional. Descrevem opções arquitetónicas, não provam que um processo específico de um cliente esteja preparado para funcionar sem supervisão. Padrões da TypeSafe
O teste útil é saber se a decomposição melhora tanto o diagnóstico como os resultados. Conseguir explicar qual etapa falhou é valioso. Reduzir a frequência e as consequências dessas falhas é o argumento empresarial.
Uma resposta válida pode continuar errada
A alegação de lançamento de que a Jev «não pode alucinar» exige uma interpretação restrita. A TypeSafe associa a garantia à conformidade com o esquema de saída permitido. Isso não demonstra que a resposta selecionada seja verdadeira. O próprio anúncio distingue as garantias de esquema da avaliação empírica. Explicação da TypeSafe sobre segurança de tipos
Suponhamos que uma aplicação permite os valores damaged, late e other. Devolver damaged é perfeitamente válido, mesmo que a embalagem apenas se tenha atrasado. Um modelo que não possa inventar uma quarta categoria ainda pode escolher a errada. Se a lista excluir uma categoria realmente necessária, o próprio esquema passa a fazer parte do problema.
A saída estruturada também é uma abordagem de engenharia já existente. A OpenAI introduziu as Structured Outputs com restrições de esquema em agosto de 2024 e assinalou explicitamente que um modelo ainda poderia cometer erros nos valores devolvidos. A Jev deve, por isso, ser avaliada pela combinação específica de qualidade das decisões, comunicação da incerteza, latência e custo, em vez de lhe ser atribuída a invenção de toda a saída de IA estruturada. Anúncio original e limitações da OpenAI
Para os compradores, esta distinção altera o plano de avaliação. Um teste de esquema pergunta se o software consegue processar uma resposta. Um teste factual pergunta se a resposta coincide com as provas. Um teste de política pergunta se a ação resultante é permitida. Passar um não substitui passar os outros.
O desafio mais importante da entrevista diz respeito à calibração
Aos 1:09, Almeida rejeita a ideia de uma calibração perfeita e reconhece a existência de erros do modelo. Entrevista, 1:08:50
A calibração diz respeito à correspondência entre as probabilidades previstas e os resultados observados em grupos de previsões. Um modelo pode ser útil a assinalar incerteza sem acertar em todos os casos de alta probabilidade. O guia da TypeSafe mantém explicitamente esta distinção. Explicação da TypeSafe sobre calibração
O campo de confiança da API exige uma segunda distinção. A TypeSafe descreve-o como uma estatística derivada da distribuição das respostas. Não é intercambiável com uma probabilidade medida de forma independente de a resposta selecionada estar correta. A documentação recomenda escolher limiares adequados à tarefa e às suas consequências. Documentação da TypeSafe sobre confiança
Estas são questões práticas. Imaginemos que um modelo de encaminhamento funciona bem com mensagens curtas em inglês, mas tem dificuldades com reclamações longas que misturam vários pedidos. Uma pontuação agregada pode ocultar essa fragilidade. Uma decisão de alta confiança no grupo mais difícil poderá merecer mais escrutínio do que o mesmo valor apresentado para o grupo habitual.
Uma equipa deve, por isso, avaliar os casos que espera receber, incluindo informações em falta, formulações desconhecidas e entradas deliberadamente confusas. Deve inspecionar os erros por categoria e comparar o custo de encaminhar um caso para revisão com o custo de agir incorretamente. Os limiares passam a ser decisões operacionais sustentadas por provas, em vez de números copiados de uma demonstração.
A investigação sobre calibração é muito anterior à Jev. Um artigo de 2017 frequentemente citado, de Chuan Guo e colegas, analisou a calibração deficiente em redes neuronais modernas e métodos para a melhorar. Esse trabalho contextualiza o problema; não valida o modelo da TypeSafe. Sobre a calibração das redes neuronais modernas
A fiabilidade inclui o que acontece quando o serviço muda
A conversa distingue robustez de determinismo e aborda a estabilidade entre versões sem prometer apoio geral de longo prazo. Entrevista, 41:24 e 49:40
Estas são questões de compra distintas. O determinismo pergunta se entradas idênticas produzem resultados idênticos. A robustez pergunta se uma alteração irrelevante, como um identificador de registo diferente, provoca uma alteração de comportamento desproporcionada. Um modelo poderia repetir indefinidamente a mesma resposta errada e ser determinista. Também poderia variar ligeiramente e, ainda assim, integrar um fluxo de trabalho fiável.
Nenhuma destas propriedades resolve o risco do ciclo de vida. Uma empresa precisa de saber que revisão do modelo produziu uma decisão, se essa revisão continuará disponível e como será avaliada uma substituição. Uma melhoria nos testes do fornecedor pode ainda assim alterar o comportamento de um fluxo de trabalho de um cliente cuidadosamente ajustado.
A resposta sensata consiste em conservar casos representativos, registar versões e comparar substituições antes de migrar trabalho importante. Também é necessário ter uma alternativa: um serviço de decisões que, de resto, seja preciso pode ficar indisponível. Se a aplicação não tiver uma forma segura de parar ou encaminhar o trabalho para outro lado, a disponibilidade passa, na prática, a fazer parte da qualidade das decisões.
É aqui que uma API atraente se transforma numa dependência operacional. A aquisição, a monitorização e o planeamento da migração não desaparecem quando o modelo fica mais rápido. Tornam-se mais fáceis de negligenciar porque cada chamada parece muito simples.
Porque precisam os números de velocidade e preço de contexto
Os resultados de destaque da TypeSafe para fluxos de trabalho incluem melhorias de 193,6 vezes na velocidade e de 444,6 vezes no custo. O anúncio identifica-as como ganhos máximos em fluxos de trabalho concebidos pela própria empresa. As respostas de referência foram obtidas a partir de estimativas probabilísticas de outros modelos, em vez de classificações de referência verificadas de forma independente. A empresa alerta também que a breve demonstração favorece a Jev e que ainda é necessário estabelecer preços sustentáveis a longo prazo. Qualificações da avaliação da TypeSafe
Estas qualificações devem acompanhar os números. A concordância com um modelo de referência pode ser informativa, mas mede algo diferente da exatidão face a um caso real de cliente já resolvido. Um fluxo de trabalho concebido pelo fornecedor poderá ser relevante para um comprador sem representar a distribuição de pedidos desse comprador.
A comparação correta deve abranger a tarefa completa: recolher contexto, tomar decisões, aplicar regras, tratar exceções e recuperar de falhas. Uma chamada mais barata ao modelo pode coexistir com um custo total superior se encaminhar demasiado trabalho para os revisores. Uma chamada mais lenta pode ser económica se evitar retrabalho dispendioso.
A latência também deve ser medida na região real da aplicação. Uma demonstração próxima da infraestrutura de um serviço não promete a mesma experiência a um utilizador noutro local. Os sistemas interativos devem analisar os pedidos lentos além da média; o processamento em segundo plano poderá dar mais importância à capacidade de processamento e ao custo total.
O nome da Jev evoca a ideia de que a eficiência pode aumentar o consumo. Para uma empresa individual, isso levanta uma questão orçamental: que novas decisões passam a valer a pena avaliar e quais se limitam a ficar suficientemente baratas para serem avaliadas sem necessidade? Fazer mais chamadas ao modelo não é, por si só, um resultado.
Um objetivo de investigação diferente, com provas ainda incompletas
O argumento de investigação de Almeida liga dados, seleção de tarefas e RLCD à sua crítica da otimização de preferências. Entrevista, 7:23 e 22:12
RLCD significa Reinforcement Learning for Calibrated Decisions (aprendizagem por reforço para decisões calibradas). A TypeSafe apresenta-o como um treino orientado para decisões e probabilidades utilizáveis, por oposição a abordagens baseadas em preferências humanas e recompensas verificáveis. Essa é a descrição da empresa sobre o seu objetivo. Não deve ser confundida com uma verificação independente do método de treino completo. Guia de IA da TypeSafe
A questão mais ampla merece ser investigada enquanto o método é avaliado: que comportamento recompensa um objetivo de treino? Um modelo otimizado para uma explicação convincente pode ser agradável de usar sem expor a incerteza num formato utilizável pelo código. Uma interface orientada a decisões pode facilitar o tratamento da incerteza, mas as suas saídas continuam a exigir verificações externas com base na realidade.
A TypeSafe associa esta preocupação ao mode dropping: a otimização de preferências pode estreitar a gama de resultados prováveis em torno das respostas recompensadas pelas pessoas. É a explicação da empresa para um modo de falha, não uma conclusão de que todos os modelos treinados com preferências sejam inúteis para tomar decisões. Debate da TypeSafe sobre otimização de preferências
A formação de Almeida torna este argumento particularmente interessante. É coautor do artigo InstructGPT, que estudou o treino de modelos de linguagem para seguirem instruções com recurso a feedback humano. A autoria pode ser verificada; as alegações abrangentes sobre aquilo em que todos os laboratórios erram são outra questão. Artigo sobre o InstructGPT
As suas objeções às despesas de pré-treino e aos novos laboratórios sem orientação fazem parte do mesmo argumento sobre a escolha de tarefas úteis. Entrevista, 1:49:32 e 2:03:10
Para um comprador, a lição relevante é perguntar o que o produto pode fazer por um processo definido. A experiência de investigação, as despesas computacionais e uma arquitetura de modelo distinta podem explicar como uma empresa chegou a uma oferta. Não podem demonstrar os resultados económicos da sua implementação no negócio de outra pessoa.
A entrevista aborda também a saída de Almeida da OpenAI, as dificuldades da adoção inicial e o crescimento impulsionado pelos programadores. Entrevista, 1:31:27 e 1:56:48
Estas recordações explicam as prioridades da empresa. Não são provas auditadas de adoção. Uma plataforma para programadores deverá, em última análise, ser avaliada pelos usos contínuos e úteis e pelo apoio prestado quando estes falham. O entusiasmo após um lançamento é um motivo para investigar, não um substituto desse historial.
O software existente poderá beneficiar mais do que uma nova janela de conversa
Almeida prevê produtos SaaS melhores e uma IA que passe para segundo plano. Entrevista, 1:19:57
É uma direção credível a investigar, pois o software já contém pontos em que um juízo útil poderia alterar a etapa seguinte. Uma aplicação de agendamento poderia identificar um pedido ambíguo antes de marcar. Um arquivo multimédia poderia organizar materiais para um investigador. Um serviço de assistência poderia distinguir uma atualização de rotina de uma reclamação que requer atenção. São conceções possíveis, não implementações da Jev comunicadas.
A interface poderá mudar muito pouco. Os utilizadores notarão menos erros, menos classificações repetitivas ou menor espera pela pessoa indicada. A vantagem comercial poderá caber às empresas que já compreendem um fluxo de trabalho e conseguem nele incorporar decisões melhores.
As empresas de software existentes continuariam a enfrentar concorrência. Se a mesma capacidade de decisão ficar acessível a muitos programadores, a chamada ao modelo, por si só, pouco as distinguirá. O produto envolvente tem de disponibilizar acesso útil aos dados, uma conceção de interação ponderada e uma forma fiável de concluir o trabalho.
As alegações relativas ao emprego exigem maior contenção. Reduzir o esforço numa tarefa poderá alterar o número de trabalhadores, aumentar o volume de serviços ou transferir trabalho para as exceções. Esses resultados dependem da organização e da procura pelos seus serviços. Nem uma entrevista nem um lançamento de acesso antecipado demonstram que serão protegidos, eliminados ou criados empregos em determinada quantidade.
Na análise setorial da BIG CHANGE, o acontecimento mensurável é a disponibilização de outra abordagem à automatização de decisões. A adoção generalizada, os ganhos de produtividade e os efeitos no mercado de trabalho são questões posteriores, que exigem outras provas.
Dados obscuros, software em tempo real e limites de uma demonstração
A entrevista aborda dados armazenados, aplicações interativas, verificação e demonstrações de utilização do computador. Entrevista, 1:34:50
Cada categoria sugere uma avaliação diferente. Um trabalho de processamento de arquivos pode tolerar algum atraso, mas precisa de um plano para amostrar resultados e os associar aos registos originais. Uma interface em tempo real precisa de uma resposta previsível. Um verificador que avalie outro modelo tem de ser testado com os erros que esse modelo realmente comete, incluindo casos em que ambos partilham o mesmo erro.
No controlo do computador, escolher uma ação é apenas uma parte do sistema. Também é necessária uma representação precisa da interface, uma forma de executar a ação e uma verificação de que a alteração esperada ocorreu. Uma demonstração polida pode comprovar que uma sequência aconteceu uma vez; uma automatização fiável exige tentativas repetidas e recuperação após interrupções.
A mesma cautela aplica-se aos jogos. Uma personagem mediada por um modelo poderá reagir a um estado mais rico, enquanto o motor do jogo continua a impor os limites das ações possíveis. A melhoria da experiência depende da capacidade de resposta, da consistência e da conceção do jogo. Acrescentar inferência a cada fotograma não tornaria automaticamente um jogo mais interessante.
Estas distinções evitam um erro de categoria: deve reconhecer-se a contribuição de cada componente útil pelo papel que desempenha, sem lhe atribuir todas as capacidades da aplicação mais abrangente em que se insere.
O ajuste fino, a visão e outras formas de modelos surgem como possibilidades na entrevista. Entrevista, 1:10:27 e 1:26:23
Uma conversa sobre o roteiro de desenvolvimento não deve transformar-se numa dependência do plano de lançamento. Desenvolva-se em torno da interface disponível, identifique-se o que cada componente separado tem de fornecer e avalie-se qualquer nova capacidade quando esta efetivamente chegar. Assim, será possível beneficiar de melhorias futuras sem apresentar especulação como funcionalidade de um produto.
Os agentes de programação poderão dividir o trabalho de outra forma
Almeida propõe um tratamento do estado mais barato e um contexto partilhado para agentes de programação, para além de um ciclo baseado num único modelo. Entrevista, 1:40:17 e 2:09:29
Uma arquitetura possível recorreria a um modelo de programação capaz para desenvolver uma alteração, a chamadas de decisão menores para classificar ficheiros relevantes e a software convencional para gerir as tarefas resultantes. Um revisor separado poderia inspecionar a correção final. É uma proposta de conceção, não uma recomendação avaliada por benchmarks nem provas de que a Jev já substitua um agente de programação existente.
A parte atraente é o contexto seletivo. Se uma subtarefa precisar apenas de uma interface e de alguns requisitos, enviar-lhe uma conversa inteira poderá ser um desperdício. Registos explícitos das tarefas poderiam facilitar a identificação dos factos relevantes, das decisões já tomadas e das alterações ainda pendentes.
A parte perigosa é confundir uma sugestão de coordenação com uma garantia de concorrência. Dois agentes poderão acreditar que ambos devem escrever num ficheiro. Um modelo probabilístico não deve substituir os mecanismos de software que impedem conflitos de escrita. As permissões, as verificações de versão e os bloqueios continuam a ter de impor o resultado.
Do mesmo modo, recuperar trabalhos anteriores a um custo menor poderá melhorar a gestão da memória sem resolver todos os problemas designados por aprendizagem contínua. Recordar uma tentativa anterior, compreender por que motivo falhou e adaptar-se de forma fiável a uma situação nova são capacidades distintas. Uma avaliação convincente analisaria tarefas concluídas, regressões, conflitos e intervenção humana, em vez de simplesmente contar agentes ou chamadas.
A segurança acompanha o sistema; não desaparece
Almeida prefere controlos de segurança ao nível da aplicação às recusas do modelo; swyx questiona as consequências. Entrevista, 13:11 e 1:42:29
Existe aqui um problema de conceção real: uma aplicação sem supervisão tem de lidar com situações em que uma dependência recusa, falha ou devolve um resultado incerto. Precisa de uma via de resposta explícita. Essa observação não determina onde deve residir cada salvaguarda.
Uma aplicação deve impor permissões de acesso mesmo quando um modelo identifica corretamente a ação pretendida. O pedido para apagar um registo pode ser perfeitamente compreendido e, ainda assim, não estar autorizado. Um pedido também pode ser tecnicamente válido e violar a política do operador. Sem o contexto adequado, o serviço de decisão não pode responder responsavelmente a estas questões, e a aplicação tem de manter o controlo da ação.
Por conseguinte, transferir mais decisões para o software aumenta a importância de especificar limites antes da implementação. As equipas têm de decidir que provas são necessárias, que operações continuam reversíveis e como pode uma pessoa contestar ou corrigir um resultado. Eliminar uma interação pouco prática com um modelo não é prova suficiente de que todo o sistema seja seguro.
O que demonstraria uma grande mudança
O lançamento permite realizar uma experiência clara. Escolha um processo delimitado com um resultado observável. Registe como funciona atualmente, incluindo erros e o tempo que as pessoas gastam a corrigi-los. Teste uma versão baseada em decisões com casos representativos antes de lhe conceder autoridade para agir.
Meça a proporção de casos concluídos corretamente sem intervenção, os erros que escapam à revisão, o trabalho encaminhado para pessoas e o custo total por caso concluído. Mantenha as provas originais disponíveis para que um revisor possa analisar por que motivo um resultado foi aceite. Repita a comparação quando mudar o modelo, a política ou a população de entradas.
Esta avaliação poderá revelar que apenas parte do processo está pronta. É um resultado útil. Automatizar a classificação rotineira e deixar os casos ambíguos a cargo de um operador experiente poderá ser vantajoso sem justificar uma autonomia mais ampla.
O lançamento da Jev e a entrevista de Almeida apresentam uma hipótese ambiciosa sobre a forma como a IA entra na economia: decisões repetidas e delimitadas podem tornar mais capaz o software de que as pessoas já dependem. As próximas provas deverão vir de sistemas que executem esse trabalho ao longo do tempo, incluindo erros e exceções na contabilização. É assim que uma arquitetura de modelo interessante se transforma numa mudança que os leitores conseguem observar.


