
Клиент меняет адрес в заказе. В сообщении также содержится просьба о возврате денег, говорится о повреждённой посылке и намекается, что это уже третья неприятность. Подготовить подходящий ответ — одна задача. Решить, какие записи изменить, какая команда должна вмешаться и для каких действий требуется разрешение, — другая.
Jev, модель, представленная TypeSafe AI в раннем доступе 15 сентября 2026 года, предназначена именно для таких решений. Она выдаёт ограниченные структурированные ответы для программного обеспечения. Запуск предлагает пересмотреть, насколько приложение должно зависеть от длинного разговора с универсальной моделью. объявлении TypeSafe о запуске
Наиболее полно этот аргумент изложен в интервью Latent Space от 21 сентября с сооснователем и гендиректором TypeSafe Дьогу Алмейдой, которое провёл swyx. Мы изучили полные английские субтитры двухчасовой и двадцатидвухминутной беседы и проверили документацию продукта. Это анализ интервью и доступных материалов; мы самостоятельно не проводили бенчмарк Jev. Посмотрите оригинальное интервью
По нашей оценке, наиболее значимое предложение Jev касается единицы автоматизации. Компания может автоматизировать ограниченное суждение внутри существующего процесса ещё до того, как сможет ответственно передать машине весь процесс целиком. Если повторное вынесение такого суждения станет достаточно дешёвым, а его качество — достаточно понятным для измерения, знакомое бизнес-ПО сможет получить полезные функции, не превращая каждое взаимодействие в чат.
Это повлияет и на тех, кто проектирует рабочие процессы, и на их пользователей. Кому-то всё равно придётся определить допустимые действия, критерии ошибки и ответственных за исключительные случаи. От качества этих решений зависит, создаст ли такой подход надёжные сервисы или лишь ускорит ошибки.
Что именно выпустила TypeSafe
Согласно документации, интерфейс Jev принимает состояние и набор типизированных вопросов. В нём предусмотрены три базовые операции: Choice выбирает из заданных вариантов, Score оценивает по критериям, а Noul выдаёт вероятность утверждения по шкале от нуля до единицы. Choice и Score возвращают распределения и поле уверенности. У Noul отдельного поля уверенности нет. Для оценки вопросов можно использовать общее переданное состояние, но вопросы обрабатываются независимо. документации интерфейса TypeSafe
В приложении для обслуживания клиентов разработчик мог бы использовать эти операции, чтобы отличить просьбу изменить адрес от отмены, оценить срочность и проверить наличие в сообщении свидетельств повреждения. Это гипотетические примеры, а не результаты внедрения Jev. Затем приложение решило бы, что делать с ответами.
Такое разделение полезно, потому что интерпретация и полномочия — разные обязанности. ИИ может предположить, что клиент хочет получить деньги обратно, но не должен автоматически получать право на возврат только потому, что пришёл к такому выводу. Приложение может проверить заказ, применить ограничение на сумму возврата и потребовать одобрения, когда это необходимо.
TypeSafe называет эту категорию моделей System One, используя выражение для быстрого интуитивного мышления. Это название описывает предполагаемый тип задач, но не удостоверяет подобие человеческому мышлению и не устанавливает чёткую границу между простыми и сложными задачами. За коротким вопросом может скрываться трудное суждение, особенно если нужной информации не хватает.
Инженерное изменение — меньше решений, которые проще проверить
Алмейда выступает за декомпозицию: задавать узкие вопросы, а затем объединять ответы в коде. Интервью, 1:03:02
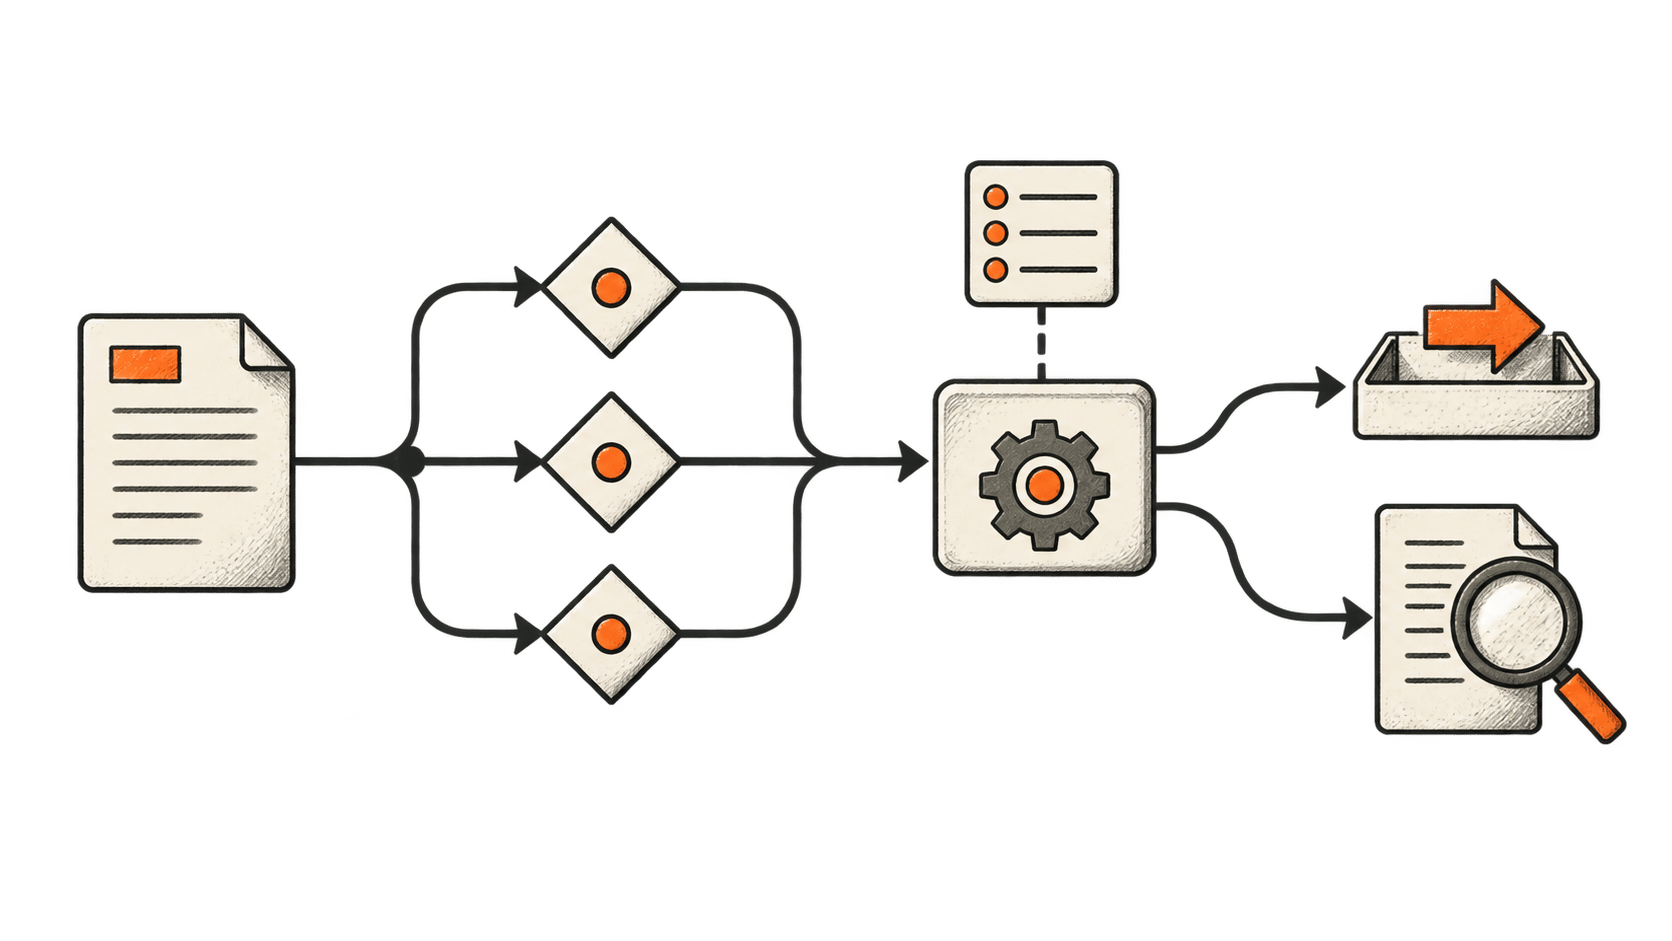
Вернёмся к примеру с повреждённым заказом. В одной инструкции разобраться с жалобой скрыто сразу несколько суждений. В более проверяемом варианте отдельно выяснялось бы, какое действие запрашивается, можно ли определить заказ и подтверждают ли доступные сведения заявление о повреждении. Правила политики оставались бы за пределами этих суждений.
Так проще разбираться в сбоях. Если система направила запрос об изменении адреса в команду возвратов, оператор может проверить решение о маршрутизации. Если оценка повреждения ошибочна, этот компонент можно проверить на прошлых случаях. Изменение политики можно выразить явным правилом, не переписывая широкую инструкцию в надежде, что модель будет истолковывать её последовательно.
Есть и издержки. Чем больше компонентов, тем больше интерфейсов нужно поддерживать. Вопросы могут случайно упустить контекст, который прояснил бы ответ. Два на вид независимых суждения могут опираться на одно и то же вводящее в заблуждение свидетельство. Рабочий процесс из по отдельности приемлемых частей всё равно может дать неприемлемый результат.
В документированных шаблонах TypeSafe предлагается задавать несколько вопросов вместе, объединять оценки и направлять неоднозначные случаи на дополнительную обработку. Это архитектурные варианты, а не доказательство того, что конкретный процесс клиента готов работать без надзора. шаблонах TypeSafe
Полезная проверка — выяснить, улучшается ли благодаря декомпозиции и диагностика, и результат. Возможность объяснить, какой шаг дал сбой, ценна. Деловое обоснование состоит в уменьшении частоты и последствий таких сбоев.
Правдоподобный ответ всё равно может быть неверным
Заявление при запуске, что Jev «не может галлюцинировать», требует узкого толкования. TypeSafe связывает гарантию с соответствием разрешённой схеме вывода. Это не подтверждает истинность выбранного ответа. В собственном объявлении компания отделяет гарантии схемы от эмпирической оценки. объяснении TypeSafe о безопасности типов
Предположим, приложение допускает значения damaged, late и other. Возврат значения damaged вполне соответствует схеме, даже если посылка всего лишь задержалась. Модель, которая не может придумать четвёртую категорию, всё равно может выбрать неправильную. Если в перечне нет действительно необходимой категории, часть проблемы заложена уже в самой схеме.
Структурированный вывод — также уже существующий инженерный подход. В августе 2024 года OpenAI представила Structured Outputs с ограничением формата схемой и прямо отметила, что модель всё ещё может ошибаться в возвращаемых значениях. Поэтому Jev следует оценивать по сочетанию качества решений, сообщения о неопределённости, задержки и стоимости, а не приписывать ей изобретение всего структурированного вывода ИИ. первоначальном объявлении OpenAI и его ограничениях
Для покупателя это различие меняет план оценки. Проверка схемы выясняет, может ли программа обработать ответ. Проверка фактов — соответствует ли ответ доказательствам. Проверка политики — разрешено ли итоговое действие. Успешное прохождение одной проверки не заменяет остальные.
Самый важный вопрос интервью касается калибровки
На отметке 1:09 Алмейда отвергает предположение о безупречной калибровке и признаёт, что модели ошибаются. Интервью, 1:08:50
Калибровка описывает соответствие предсказанных вероятностей наблюдаемым исходам для групп предсказаний. Модель может полезно сигнализировать о неопределённости, не будучи правой в каждом случае с высокой вероятностью. В учебном материале TypeSafe это различие специально сохраняется. объяснении калибровки от TypeSafe
Поле уверенности в API требует ещё одного уточнения. TypeSafe описывает его как статистическую величину, полученную из распределения ответов. Это не то же самое, что независимо измеренная вероятность правильности выбранного ответа. В документации рекомендуется выбирать порог с учётом задачи и возможных последствий. документации TypeSafe по уверенности
Это практические вопросы. Представим, что система маршрутизации хорошо справляется с короткими сообщениями на английском, но затрудняется с длинными жалобами, содержащими несколько просьб. Общий балл может скрыть эту слабость. Решение с высокой уверенностью для более слабой группы может требовать большего внимания, чем такой же показанный показатель для знакомой группы.
Поэтому команде следует оценивать ожидаемые случаи, включая нехватку данных, незнакомые формулировки и намеренно запутанные сообщения. Нужно изучать ошибки по категориям и сопоставлять цену передачи дела на проверку с ценой ошибочного действия. Пороги должны стать операционными решениями, подкреплёнными свидетельствами, а не числами, скопированными с демонстрации.
Исследования калибровки начались задолго до Jev. В широко цитируемой работе Чуана Го и соавторов 2017 года изучалась плохая калибровка современных нейронных сетей и способы её улучшить. Эта работа даёт контекст проблемы, но не подтверждает качество модели TypeSafe. «О калибровке современных нейронных сетей»
Надёжность зависит и от того, что происходит при изменении сервиса
В разговоре робастность отделяется от детерминированности и обсуждается стабильность версий без общего обещания долгосрочной поддержки. Интервью, 41:24 и 49:40
Это отдельные вопросы для покупателя. Детерминированность означает, что одинаковые входные данные дают одинаковые результаты. Робастность — что незначительное изменение, например другой идентификатор записи, не приводит к необоснованному изменению поведения. Модель может бесконечно повторять один и тот же неправильный ответ и оставаться детерминированной. Она также может немного колебаться, а окружающий рабочий процесс при этом оставаться надёжным.
Ни то ни другое не устраняет риск жизненного цикла. Бизнесу важно знать, какая версия модели вынесла решение, останется ли она доступна и как будут оценивать замену. Даже улучшение результатов поставщика на собственных тестах может изменить поведение тщательно настроенного процесса клиента.
Разумный ответ — сохранять репрезентативные случаи, записывать версии и сравнивать замену до переноса ответственных задач. Важен и запасной вариант: даже точный сервис принятия решений может стать недоступен. Если приложение не умеет безопасно поставить процесс на паузу или направить работу в другое место, фактическая надёжность решений будет зависеть и от бесперебойной работы.
Именно здесь привлекательный API превращается в операционную зависимость. Закупки, мониторинг и планирование перехода не исчезают, когда модель становится быстрее. О них легче забыть, потому что отдельный вызов выглядит таким простым.
Почему показатели скорости и цены нужно рассматривать в контексте
В заголовке TypeSafe фигурируют улучшения скорости в 193,6 раза и стоимости в 444,6 раза. В объявлении уточняется, что это максимальные результаты рабочих процессов, созданных самой компанией. Эталонными ответами служили оценки вероятностей других моделей, а не независимо проверенная разметка с достоверно установленными результатами. Компания также предупреждает, что короткая демонстрация благоприятствует Jev, а устойчивую долгосрочную цену ещё предстоит установить. оговорках TypeSafe об оценке
Эти оговорки нужно приводить вместе с цифрами. Согласие с эталонной моделью может быть информативным, но оно измеряет не то же самое, что правильность относительно окончательно проверенного случая клиента. Разработанный поставщиком рабочий процесс может быть важен для покупателя, но не представлять распределение его запросов.
Сравнение должно охватывать всю задачу: получение контекста, принятие решений, применение правил, разбор исключений и восстановление после сбоя. Более дешёвый вызов модели может сочетаться с большими общими расходами, если на проверку отправляется слишком много работы. Более медленный вызов может оказаться экономичным, если предотвращает дорогостоящие исправления.
Задержку также нужно измерять в том регионе, где будет работать приложение. Демонстрация рядом с инфраструктурой сервиса не гарантирует такого же опыта пользователю в другом месте. В интерактивных системах следует изучать и медленные запросы, а не только среднее значение; для фоновой обработки могут быть важнее пропускная способность и общая стоимость.
Название Jev отсылает к идее, что рост эффективности может расширять потребление. Для отдельной компании это означает вопрос о бюджете: какие новые решения теперь стоит оценивать, а какие просто стали достаточно дешёвыми для ненужной оценки? Большее число вызовов модели само по себе не является результатом.
Иная исследовательская цель, доказательства которой пока неполны
Исследовательский аргумент Алмейды связывает данные, выбор задач и RLCD с его критикой оптимизации по предпочтениям. Интервью, 7:23 и 22:12
RLCD означает обучение с подкреплением для калиброванных решений. TypeSafe представляет его как обучение ради полезных решений и вероятностей в противопоставление подходам, основанным на предпочтениях людей и проверяемых вознаграждениях. Так компания описывает цель своего метода; это нельзя считать независимым подтверждением полной методики обучения. пособии TypeSafe по ИИ
Более широкий вопрос важен даже до полной оценки метода: какое поведение вознаграждает цель обучения? Модель, оптимизированная для убедительных объяснений, может быть приятной в использовании, но не показывать неопределённость в форме, пригодной для программной обработки. Интерфейс, ориентированный на решения, облегчает работу с неопределённостью, но его результаты всё равно требуется проверять по реальным данным.
TypeSafe связывает эту проблему с выпадением режимов: оптимизация по предпочтениям может сузить диапазон вероятных ответов до тех, которые получают одобрение людей. Это объяснение возможного механизма сбоя, а не вывод о том, что любая модель, обученная на предпочтениях, непригодна для принятия решений. обсуждении оптимизации по предпочтениям от TypeSafe
Предыдущая работа Алмейды делает этот аргумент особенно интересным. Он соавтор статьи InstructGPT, в которой изучалось обучение языковых моделей следованию инструкциям с использованием обратной связи людей. Его авторство можно проверить; широкие утверждения о том, в чём ошибаются все исследовательские лаборатории, — уже другое дело. статье InstructGPT
Его возражения против расходов на предварительное обучение и создания новых лабораторий без чёткой цели относятся к тому же аргументу о выборе полезных задач. Интервью, 1:49:32 и 2:03:10
Покупателю следует спросить, что продукт может сделать для определённого процесса. Исследовательская школа, вычислительные расходы и необычная архитектура модели могут объяснить, как компания пришла к своему предложению, но не доказывают экономическую целесообразность внедрения продукта в чужом бизнесе.
В интервью также обсуждаются уход Алмейды из OpenAI, трудности раннего внедрения и рост за счёт разработчиков. Интервью, 1:31:27 и 1:56:48
Эти воспоминания объясняют приоритеты компании, но не являются проверенными данными о внедрении. В конечном счёте платформу для разработчиков следует оценивать по устойчивым полезным нагрузкам и поддержке, которую она предоставляет при их сбоях. Энтузиазм после запуска — повод разобраться, а не замена такой истории.
Привычное ПО может выиграть больше, чем от нового окна чата
Алмейда предвидит более мощные SaaS-продукты, в которых ИИ отойдёт на второй план. Интервью, 1:19:57
Это заслуживающее изучения направление: в программном обеспечении уже есть места, где полезное суждение могло бы изменить следующий шаг. Приложение для расписания могло бы обнаружить неоднозначную просьбу до бронирования. Архив мультимедиа мог бы упорядочить материалы для исследователя. Служба поддержки могла бы отличить обычное обновление от жалобы, требующей внимания. Это возможные варианты, а не известные внедрения Jev.
Интерфейс может почти не измениться. Пользователи заметят меньше ошибок, меньше повторной классификации или более быстрое направление запроса нужному человеку. Коммерческое преимущество может достаться компаниям, которые уже понимают рабочий процесс и умеют встроить в него более качественные решения.
Действующим компаниям-разработчикам всё равно придётся конкурировать. Если то же суждение станет доступно множеству разработчиков, один лишь вызов модели даст мало отличий. Окружающий продукт должен обеспечивать полезный доступ к данным, продуманный интерфейс и надёжное завершение работы.
Заявления о занятости требуют ещё большей осторожности. Снижение усилий для одной задачи может изменить штат, увеличить объём услуг или перенести нагрузку на разбор исключений. Результаты зависят от организации и спроса на её услуги. Ни интервью, ни ранний доступ не доказывают, что Jev создаст, устранит или сохранит какое-то определённое число рабочих мест.
Для отраслевого обзора BIG CHANGE измеримое событие — появление ещё одного подхода к автоматизации принятия решений. Широкое внедрение, рост производительности и последствия для рынка труда — последующие вопросы, требующие других доказательств.
Скрытые данные, программное обеспечение реального времени и ограничения демонстраций
В интервью Алмейда также рассказывает о будущих взаимодействиях между моделями, уточняя, что большая часть этого не входит в текущий релиз. Интервью, 1:34:50
Каждая категория требует своей оценки. Архивную обработку можно выполнять с задержкой, но нужно проверять выборку результатов и уметь связывать их с исходными записями. Для интерфейса реального времени важна предсказуемая скорость отклика. Средство проверки результатов другой модели следует тестировать на реальных ошибках этой модели, в том числе случаях, когда обе системы ошибаются одинаково.
Для управления компьютером выбор действия — только одна часть системы. Нужны также точное представление интерфейса, средство выполнить действие и проверка, что ожидаемое изменение произошло. Красивая демонстрация может показать, что цепочка действий сработала один раз; для надёжной автоматизации нужны повторные испытания и восстановление после прерываний.
То же предостережение относится к играм. Персонаж под управлением модели может реагировать на более насыщенное состояние, а игровой движок при этом продолжит ограничивать доступные действия. Улучшит ли это игру, зависит от отзывчивости, последовательности поведения и дизайна. Добавление вывода модели в каждый кадр не сделает игру интереснее автоматически.
Эти различия помогают избежать категориальной ошибки: полезный компонент следует оценивать за выполняемую им роль, не приписывая ему все возможности окружающего приложения.
В интервью также обсуждаются дообучение, зрение и дополнительные варианты моделей. Интервью, 1:10:27 и 1:26:23
Обсуждение планов развития не должно становиться зависимостью плана запуска. Стройте систему вокруг доступного интерфейса, определите, что должен предоставлять отдельный компонент, и оценивайте новые возможности, когда они действительно появятся. Так можно воспользоваться будущими улучшениями, не выдавая предположения за функции продукта.
Кодирующие агенты могли бы иначе распределять работу
Алмейда предлагает более дешёвую обработку состояния и общий контекст для кодирующих агентов вместо цикла вокруг одной модели. Интервью, 1:40:17 и 2:09:29
Возможная архитектура могла бы поручить мощной модели подготовку изменения кода, небольшим вызовам модели принятия решений — классификацию нужных файлов, а обычному ПО — управление последующими задачами. Отдельный проверяющий анализировал бы итоговый патч. Это проектное предложение, а не рекомендация, подтверждённая бенчмарком, и не доказательство, что Jev уже заменяет существующий инструмент разработки.
Преимущество такого подхода — выборочный контекст. Если подзадаче нужны лишь один интерфейс и несколько ограничений, отправка ей всего разговора может оказаться расточительной. Явные записи задач помогут определить, какие факты важны, что уже решено и какие изменения ещё предстоят.
Опасно принимать совет по координации за гарантию параллельной работы. Два агента могут одновременно решить, что должны записать один и тот же файл. Вероятностная модель не должна заменять программные средства предотвращения конфликтующих записей. Итог должны по-прежнему обеспечивать разрешения, проверки версий и блокировки.
Аналогичным образом, более дешёвое извлечение прошлой работы может улучшить управление памятью, но не решает автоматически все задачи, называемые непрерывным обучением. Вспомнить прежнюю попытку, понять причину неудачи и надёжно приспособиться к новой ситуации — разные способности. Убедительная оценка должна учитывать завершённые задачи, регрессии, конфликты и вмешательство человека, а не только считать число агентов или вызовов.
Безопасность проходит через всю систему, а не исчезает
Алмейда отдаёт предпочтение средствам защиты на уровне приложения, а не отказам модели; swyx обсуждает последствия такого подхода. Интервью, 13:11 и 1:42:29
Здесь есть реальная проектная проблема: автономное приложение должно справляться с отказами, сбоями или неопределёнными ответами зависимого компонента. Для этого нужен чёткий путь дальнейших действий. Но из этого наблюдения не следует, что все средства защиты должны находиться в одном определённом месте.
Приложение должно проверять права доступа, даже если модель правильно определила предполагаемое действие. Просьба удалить запись может быть понята совершенно верно и всё же оставаться несанкционированной. Просьба может быть технически допустимой, но нарушать правила оператора. Сервис принятия решений не сможет ответственно ответить на такие вопросы без нужного контекста, а приложение должно сохранять контроль над действием.
Перенос большего числа решений в программное обеспечение повышает важность определения границ до развёртывания. Команды должны решить, какие доказательства нужны, какие операции остаются обратимыми и как человек может оспорить или исправить результат. Устранения неудобного взаимодействия с моделью недостаточно, чтобы доказать безопасность всей системы.
Что могло бы доказать большое изменение
Запуск позволяет провести понятный эксперимент. Выберите один ограниченный процесс с наблюдаемым результатом. Запишите, как он работает сейчас, включая ошибки и время, которое люди тратят на их исправление. Проверьте вариант с принятием решений на репрезентативных случаях, прежде чем разрешать ему действовать.
Измеряйте долю случаев, правильно завершённых без вмешательства, ошибки, прошедшие проверку, объём переданной людям работы и общую стоимость завершённого случая. Сохраняйте исходные доказательства, чтобы проверяющий мог выяснить, почему результат приняли. Повторяйте сравнение при изменении модели, политики или состава входных данных.
Такое исследование может показать, что готова лишь часть процесса. Это полезный результат. Автоматизация рутинной классификации при передаче неоднозначных случаев опытному специалисту может быть оправдана, даже если более широкая автономность нецелесообразна.
Запуск Jev и интервью с Алмейдой предлагают амбициозную гипотезу о том, как ИИ входит в экономику: повторяемые решения с ограниченными рамками могут сделать привычные программы полезнее. Следующие свидетельства должны поступить от систем, которые выполняют эту работу длительное время, причём в расчёт должны входить ошибки и исключения. Тогда интересная архитектура модели станет изменением, которое читатели смогут увидеть в реальной работе.


