
Un cliente cambia la dirección de un pedido. El mensaje también solicita un reembolso, menciona un paquete dañado y deja entrever que es la tercera vez que algo sale mal. Convertir ese mensaje en una respuesta útil es una tarea. Decidir qué registros actualizar, qué equipo debe intervenir y qué acciones requieren autorización es otra.
Jev, el modelo que TypeSafe AI presentó en acceso anticipado el 15 de septiembre de 2026, está pensado para esas decisiones. Genera respuestas estructuradas y acotadas para que las use el software. El lanzamiento invita a reconsiderar cuánto de una aplicación debería depender de una conversación extensa con un modelo de propósito general. Anuncio de lanzamiento de TypeSafe
El argumento se desarrolla con mayor amplitud en la entrevista del 21 de septiembre de Latent Space con el cofundador y director ejecutivo de TypeSafe, Diogo Almeida, conducida por swyx. Revisamos los subtítulos completos en inglés de la conversación, de dos horas y 22 minutos, y comprobamos la documentación del producto. Este es un análisis de la entrevista y las pruebas públicas; no hemos evaluado Jev con pruebas comparativas independientes. Ver la entrevista original
A nuestro juicio, la propuesta más trascendente de Jev se refiere a la unidad de automatización. Una empresa quizá pueda automatizar un juicio acotado dentro de un proceso existente antes de poder delegar responsablemente todo el proceso. Si ese juicio llega a ser lo bastante barato como para repetirse y lo bastante claro como para medirse, el software empresarial conocido podría adquirir funciones útiles sin que cada interacción se convierta en una sesión de chat.
Esto afectaría tanto a quienes diseñan los flujos de trabajo como a quienes los utilizan. Alguien debe decidir qué acciones se permiten, qué se considera un error y quién se ocupa de las excepciones. La calidad de esas decisiones determinará si el enfoque da lugar a servicios fiables o simplemente acelera los errores.
Qué ha lanzado TypeSafe realmente
La interfaz documentada de Jev recibe un estado y un conjunto de preguntas tipadas. Sus tres primitivas son Choice, que elige entre opciones especificadas; Score, que evalúa con arreglo a una rúbrica; y Noul, que expresa la probabilidad de una afirmación en una escala de cero a uno. Choice y Score devuelven distribuciones y un campo de confianza. Noul no tiene ese campo de confianza separado. Las preguntas pueden compartir el estado proporcionado, aunque se evalúan de forma independiente. Documentación de la interfaz de TypeSafe
En una aplicación de atención al cliente, un desarrollador podría utilizar esas primitivas para distinguir una solicitud de cambio de dirección de una cancelación, evaluar su urgencia y comprobar si el mensaje contiene pruebas de daños. Son ejemplos hipotéticos, no resultados de una implementación de Jev. Después, la aplicación decidiría qué hacer con las respuestas.
Esta separación es útil porque interpretar y tener autoridad son responsabilidades distintas. Una IA puede inferir que un cliente quiere un reembolso. Llegar a esa conclusión no debería darle permiso para concederlo. La aplicación puede comprobar el pedido, aplicar un límite de reembolso y exigir autorización cuando corresponda.
TypeSafe denomina Sistema Uno a esta categoría de modelos, tomando prestado el concepto de pensamiento rápido e intuitivo. El nombre describe el tipo de trabajo al que se orienta. No certifica una cognición semejante a la humana ni establece un límite nítido entre tareas fáciles y difíciles. Una pregunta breve puede ocultar un juicio complejo, sobre todo cuando falta información necesaria.
La mejora de ingeniería: decisiones más pequeñas y examinables
Almeida defiende la descomposición: plantear preguntas de alcance reducido y después combinar las respuestas en el código. Entrevista, 1:03:02
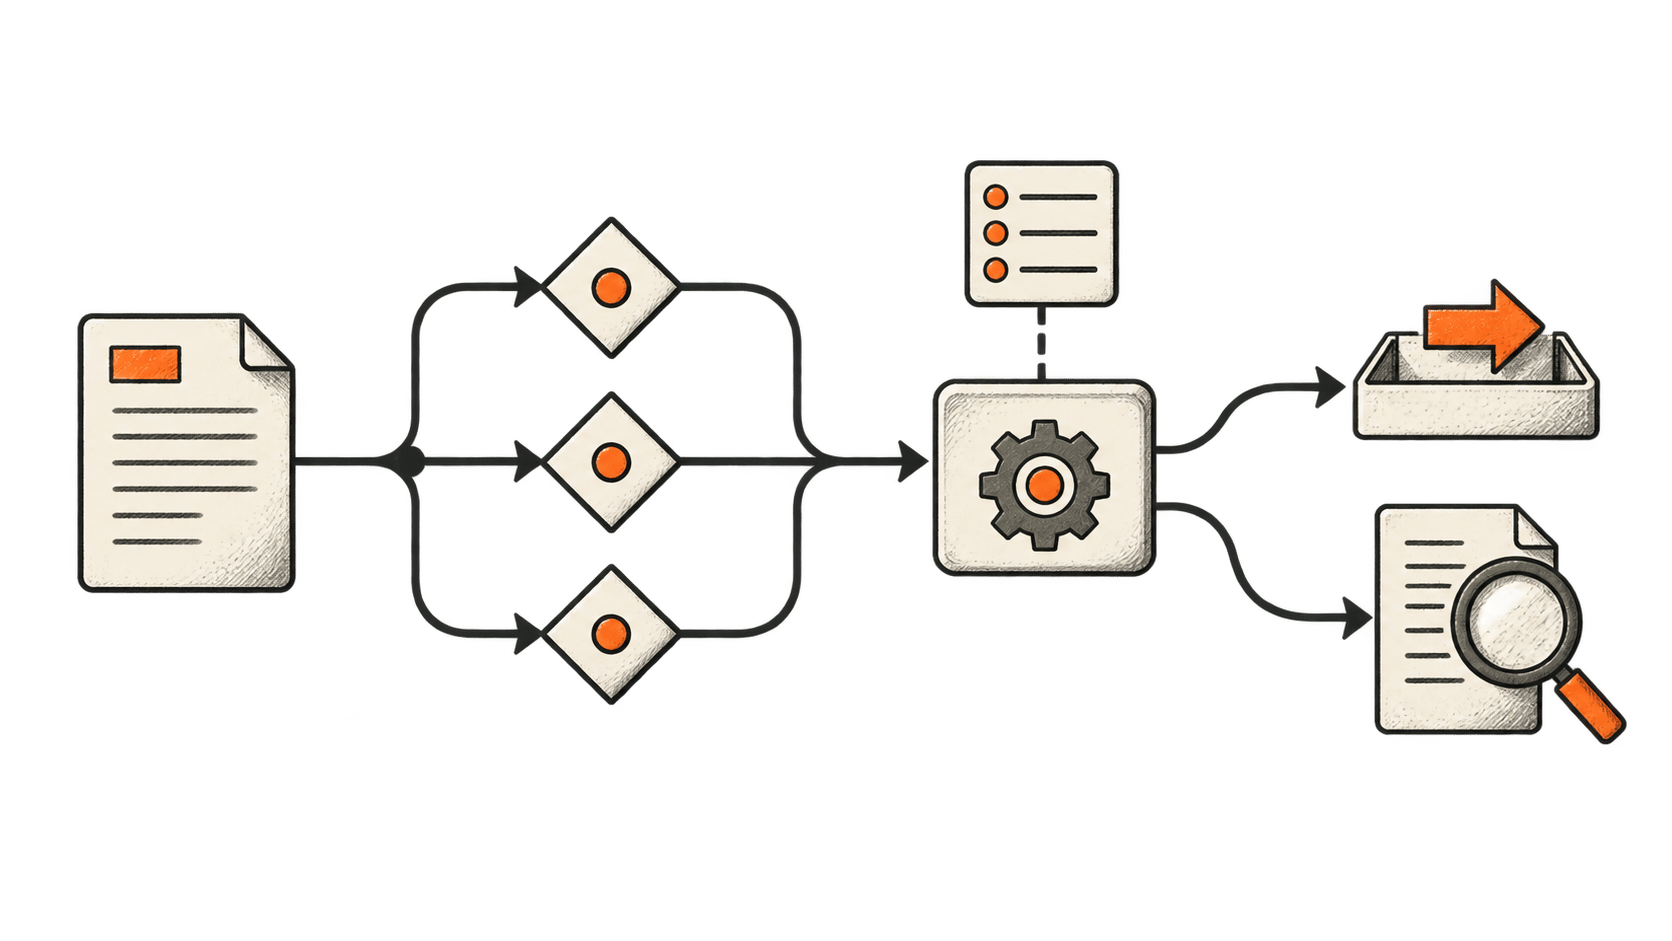
Volvamos al ejemplo del pedido dañado. Una sola instrucción para gestionar la reclamación oculta varios juicios en una misma respuesta. Un diseño más fácil de examinar determinaría por separado qué acción se solicita, si se puede identificar el pedido y si las pruebas disponibles respaldan una reclamación por daños. Mantendría las reglas de la política fuera de esos juicios.
Así es más fácil investigar un fallo. Si el sistema dirige un cambio de dirección al equipo de devoluciones, el operador puede examinar la decisión de enrutamiento. Si la evaluación de daños es incorrecta, ese componente puede probarse con casos anteriores. Un cambio de política puede modificar una regla explícita sin que el equipo tenga que reescribir una instrucción general y confiar en que el modelo la interprete de forma coherente.
Este enfoque tiene costes. Cuantos más componentes haya, más interfaces habrá que mantener. Las preguntas pueden omitir por accidente el contexto necesario para responder con claridad. Dos juicios que parecen independientes quizá se basen en las mismas pruebas engañosas. Un flujo de trabajo compuesto por partes individualmente aceptables aún puede producir un resultado inaceptable.
Los patrones documentados de TypeSafe incluyen plantear varias preguntas a la vez, combinar puntuaciones y derivar los casos inciertos a un proceso adicional. Describen opciones arquitectónicas, no pruebas de que un proceso concreto de un cliente esté listo para funcionar sin supervisión. Patrones de TypeSafe
La prueba útil consiste en comprobar si la descomposición mejora tanto el diagnóstico como los resultados. Poder explicar qué paso falló es valioso. Reducir la frecuencia y las consecuencias de esos fallos es el argumento comercial.
Una respuesta válida aún puede ser incorrecta
La afirmación de lanzamiento de que Jev «no puede alucinar» debe interpretarse de forma acotada. TypeSafe vincula su garantía al cumplimiento del esquema de salida permitido. Eso no demuestra que la respuesta elegida sea verdadera. El propio anuncio distingue entre las garantías del esquema y la evaluación empírica. Explicación de TypeSafe sobre la seguridad de tipos
Supongamos que una aplicación admite los valores damaged, late y other. Devolver damaged es perfectamente válido aunque el paquete simplemente haya llegado tarde. Un modelo incapaz de inventar una cuarta categoría todavía puede elegir la incorrecta. Si la lista excluye una categoría realmente necesaria, el propio esquema se convierte en parte del problema.
La salida estructurada también es una técnica de ingeniería ya existente. OpenAI presentó Structured Outputs con restricciones de esquema en agosto de 2024 y señaló expresamente que un modelo aún podía equivocarse al elegir entre los valores devueltos. Por tanto, Jev debe evaluarse por su combinación específica de calidad de decisión, comunicación de incertidumbre, latencia y coste, no atribuirse el mérito de haber inventado toda la generación estructurada de respuestas con IA. Anuncio original y limitaciones de OpenAI
Para los compradores, esta distinción cambia el plan de evaluación. Una prueba de esquema pregunta si el software puede procesar una respuesta. Una prueba factual pregunta si concuerda con las pruebas. Una prueba de políticas pregunta si la acción resultante está permitida. Superar una no sustituye a superar las otras.
El reto más importante de la entrevista se refiere a la calibración
En el minuto 1:09, Almeida rechaza la idea de una calibración perfecta y reconoce que los modelos se equivocan. Entrevista, 1:08:50
La calibración se refiere a cómo se comparan las probabilidades previstas con los resultados observados en grupos de predicciones. Un modelo puede ser útil para señalar incertidumbre sin acertar todos los casos a los que asigna una probabilidad alta. La guía introductoria de TypeSafe conserva expresamente esta distinción. Explicación de TypeSafe sobre la calibración
El campo de confianza de la API requiere otra distinción. TypeSafe lo describe como una estadística derivada de la distribución de respuestas. No es intercambiable con una probabilidad medida de forma independiente de que la respuesta elegida sea correcta. Su documentación recomienda elegir umbrales de acuerdo con la tarea y sus consecuencias. Documentación de TypeSafe sobre la confianza
Son consideraciones prácticas. Imaginemos que un modelo de enrutamiento funciona bien con mensajes breves en inglés, pero le cuesta procesar reclamaciones largas que mezclan varias solicitudes. Una única puntuación agregada puede ocultar esa debilidad. Una decisión de confianza alta en el grupo más débil quizá merezca más escrutinio que el mismo valor mostrado para el grupo conocido.
Por ello, un equipo debería evaluar los casos que espera recibir, incluidos los que carecen de información, utilizan expresiones desconocidas o están deliberadamente redactados para confundir. Debería analizar los errores por categoría y comparar el coste de enviar un caso a revisión con el de actuar incorrectamente. Así, los umbrales se convierten en decisiones operativas respaldadas por pruebas, en vez de números copiados de una demostración.
La investigación sobre calibración es muy anterior a Jev. Un artículo muy citado de 2017, de Chuan Guo y sus colaboradores, examinó la mala calibración de las redes neuronales modernas y métodos para mejorarla. Aporta contexto sobre el problema; no valida el modelo de TypeSafe. Sobre la calibración de las redes neuronales modernas
La fiabilidad incluye lo que ocurre cuando cambia el servicio
En la conversación se distinguen robustez y determinismo y se habla de la estabilidad de las versiones sin prometer asistencia general a largo plazo. Entrevista, 41:24 y 49:40
Son preguntas distintas para quien compra el producto. El determinismo pregunta si las mismas entradas producen las mismas salidas. La robustez pregunta si un cambio irrelevante, como otro identificador de registro, altera el comportamiento de forma irracional. Un modelo puede repetir la misma respuesta equivocada indefinidamente y ser determinista. También puede variar ligeramente mientras el flujo de trabajo que lo rodea sigue siendo fiable.
Ninguna de estas propiedades resuelve el riesgo del ciclo de vida. Una empresa necesita saber qué versión del modelo produjo una decisión, si seguirá disponible y cómo se evaluará una sustituta. Una mejora en las pruebas del proveedor aún puede alterar el comportamiento de un flujo de trabajo del cliente ajustado cuidadosamente.
La respuesta sensata es conservar casos representativos, registrar las versiones y comparar las sustitutas antes de migrar trabajo de consecuencias importantes. También hace falta una alternativa: un servicio de decisiones que, por lo demás, sea preciso puede dejar de estar disponible. Si la aplicación no dispone de una forma segura de detenerse o dirigir el trabajo a otro lugar, el tiempo de actividad se convierte en la práctica en parte de la calidad de la decisión.
Aquí es donde una API atractiva se convierte en una dependencia operativa. Las tareas de adquisición, supervisión y planificación de migraciones no desaparecen porque el modelo sea más rápido. Es más fácil descuidarlas porque cada llamada parece muy sencilla.
Por qué las cifras de velocidad y precio necesitan contexto
Los resultados principales del flujo de trabajo de TypeSafe incluyen mejoras de velocidad de 193,6 veces y de coste de 444,6 veces. El anuncio las identifica como mejoras máximas obtenidas con flujos de trabajo creados por la empresa. Las respuestas de referencia procedían de estimaciones de probabilidad de otros modelos, no de clasificaciones verdaderas verificadas de forma independiente. La empresa también advierte que su breve demostración favorece a Jev y que aún debe establecerse un precio sostenible a largo plazo. Salvedades de TypeSafe sobre la evaluación
Esas salvedades deben acompañar a las cifras. La concordancia con un modelo de referencia puede aportar información, pero mide algo distinto de la corrección contrastada con un caso real de cliente ya resuelto. Un flujo de trabajo diseñado por el proveedor puede interesar a un comprador sin reflejar la distribución de sus propias solicitudes.
La comparación adecuada debería incluir todo el trabajo: reunir el contexto, tomar decisiones, aplicar reglas, gestionar excepciones y recuperarse de fallos. Una llamada más barata al modelo puede coexistir con un coste total mayor si deriva demasiado trabajo a los revisores. Una llamada más lenta puede resultar económica si evita rehacer tareas costosas.
También hay que medir la latencia desde la región real de la aplicación. Una demostración cercana a la infraestructura del servicio no garantiza la experiencia de un usuario en otro lugar. Los sistemas interactivos deberían examinar las solicitudes lentas, además del promedio; el procesamiento en segundo plano quizá dependa más del rendimiento y el coste total.
El nombre de Jev alude a la idea de que la eficiencia puede ampliar el consumo. Para una empresa concreta, esto plantea una pregunta presupuestaria: ¿qué nuevas decisiones merece la pena evaluar y cuáles simplemente pasan a ser lo bastante baratas como para evaluarlas innecesariamente? Un mayor número de llamadas al modelo no es un resultado por sí mismo.
Otro objetivo de investigación, con pruebas aún incompletas
El argumento de investigación de Almeida relaciona los datos, la selección de tareas y RLCD con su crítica a la optimización basada en preferencias. Entrevista, 7:23 y 22:12
RLCD corresponde a Reinforcement Learning for Calibrated Decisions, o aprendizaje por refuerzo para decisiones calibradas. TypeSafe lo presenta como un entrenamiento orientado a decisiones y probabilidades utilizables, en contraste con enfoques basados en preferencias humanas y recompensas verificables. Ese es el relato de la empresa sobre su objetivo. No debe confundirse con una verificación independiente del método de entrenamiento completo. Guía introductoria de IA de TypeSafe
Aunque se siga evaluando el método, vale la pena investigar la pregunta general: ¿qué conductas recompensa un objetivo de entrenamiento? Un modelo optimizado para dar explicaciones persuasivas puede ser agradable de usar sin mostrar la incertidumbre de forma que el código pueda aprovecharla. Una interfaz centrada en decisiones puede facilitar la gestión de la incertidumbre, pero sus resultados aún requieren comprobaciones externas con la realidad.
TypeSafe relaciona esta preocupación con el fenómeno denominado mode dropping: la optimización por preferencias puede reducir la variedad de resultados probables y concentrarlos en respuestas que la gente recompensa. Esta es la explicación de la empresa sobre un modo de fallo, no la conclusión de que todos los modelos entrenados con preferencias sean inútiles para tomar decisiones. Análisis de TypeSafe sobre la optimización por preferencias
La trayectoria de Almeida hace que este argumento resulte especialmente interesante. Es coautor del artículo de InstructGPT, que estudió cómo entrenar modelos de lenguaje para seguir instrucciones mediante la retroalimentación humana. Esa autoría es verificable; las afirmaciones amplias sobre los errores de todos los laboratorios son otra cosa. Artículo de InstructGPT
Sus objeciones al gasto en preentrenamiento y a la creación de nuevos laboratorios sin una dirección clara forman parte del mismo argumento sobre la selección de tareas útiles. Entrevista, 1:49:32 y 2:03:10
Para quien compra el producto, la lección pertinente es preguntar qué puede hacer por un proceso definido. La trayectoria de investigación, el gasto en capacidad de cómputo y una arquitectura de modelo distintiva pueden explicar cómo llegó una empresa a su oferta. No demuestran la economía de implementarla en otra empresa.
La entrevista también aborda la salida de Almeida de OpenAI, las dificultades de las primeras etapas de adopción y el crecimiento impulsado por desarrolladores. Entrevista, 1:31:27 y 1:56:48
Esos recuerdos explican las prioridades de la empresa. No son pruebas de adopción auditadas. En última instancia, una plataforma para desarrolladores debería evaluarse por los flujos de trabajo útiles y sostenidos y el apoyo que ofrece cuando fallan. El entusiasmo tras un lanzamiento es motivo para investigar, no sustituye ese historial.
El software existente podría ganar más que una nueva ventana de chat
Almeida prevé mejores productos SaaS y que la IA pase a un segundo plano. Entrevista, 1:19:57
Es una dirección creíble para investigar porque el software ya incluye puntos donde un juicio útil podría cambiar el siguiente paso. Una aplicación de calendario podría detectar una solicitud ambigua antes de programar una cita. Un archivo multimedia podría organizar materiales para un investigador. Una mesa de ayuda podría distinguir una actualización rutinaria de una reclamación que requiere atención. Son diseños posibles, no implementaciones de Jev de las que se haya informado.
La interfaz podría apenas cambiar. Los usuarios notarían menos errores, menos clasificación repetitiva o menos espera para dar con la persona adecuada. La ventaja comercial podría recaer en las empresas que ya conocen un flujo de trabajo y pueden incorporar en él mejores decisiones.
Aun así, las empresas de software existentes se enfrentarían a la competencia. Si muchos desarrolladores pueden acceder al mismo juicio, la llamada al modelo por sí sola ofrece poca diferenciación. El producto que la rodea debe ofrecer acceso a datos útiles, una interacción bien diseñada y una forma fiable de terminar el trabajo.
Las afirmaciones sobre el empleo requieren más cautela. Reducir el esfuerzo en una tarea podría cambiar la plantilla, aumentar el volumen de servicios o trasladar el trabajo a las excepciones. El resultado dependerá de la organización y de la demanda de su servicio. Ni una entrevista ni un lanzamiento de acceso anticipado demuestran que se protejan, eliminen o creen empleos en una cantidad determinada.
Para el panorama sectorial de BIG CHANGE, el hecho medible es que hay otra opción disponible para automatizar decisiones. La adopción generalizada, las mejoras de productividad y los efectos en el mercado laboral son preguntas posteriores que exigen otras pruebas.
Datos ocultos, software en tiempo real y los límites de una demostración
En la entrevista se habla de datos almacenados, aplicaciones interactivas, verificación y demostraciones de uso de computadoras. Entrevista, 1:34:50
Cada categoría sugiere una evaluación diferente. Un trabajo de procesamiento de archivos puede tolerar demoras, pero necesita un plan para muestrear resultados y rastrearlos hasta los registros originales. Una interfaz en tiempo real requiere una respuesta predecible. Un verificador que evalúa a otro modelo debe probarse con los errores reales de ese modelo, incluidos los casos en que ambos sistemas comparten un fallo.
En el uso de computadoras, elegir una acción es solo una parte del sistema. También hace falta una representación precisa de la interfaz, un medio para ejecutar la acción y una comprobación de que se produjo el cambio previsto. Una demostración pulida puede probar que una secuencia ocurrió una vez; una automatización fiable requiere ensayos repetidos y recuperación tras las interrupciones.
La misma cautela se aplica a los juegos. Un personaje controlado mediante un modelo podría reaccionar a un estado más rico, mientras que el motor del juego sigue limitando las acciones posibles. Que eso mejore la experiencia dependerá de la capacidad de respuesta, la consistencia y el diseño. Añadir inferencia en cada fotograma no hace que un juego resulte automáticamente más interesante.
Estas distinciones evitan un error de categoría: hay que reconocer el valor de un componente por la función que cumple sin atribuirle todas las capacidades de la aplicación que lo rodea.
En la entrevista se plantean como posibilidades el ajuste fino, la visión y otras arquitecturas de modelos. Entrevista, 1:10:27 y 1:26:23
Una conversación sobre la hoja de ruta no debe convertirse en una dependencia del plan de lanzamiento. Diseña en torno a la interfaz disponible, identifica lo que debe aportar un componente aparte y evalúa las funciones nuevas cuando realmente lleguen. Así se podrán aprovechar las mejoras futuras sin presentar especulaciones como funciones del producto.
Los agentes de programación podrían organizar el trabajo de otra manera
Almeida propone gestionar el estado a menor coste y compartir el contexto entre agentes de programación, en vez de limitarse a un ciclo con un solo modelo. Entrevista, 1:40:17 y 2:09:29
Una arquitectura posible emplearía un modelo de programación capaz para desarrollar un cambio, llamadas de decisión más pequeñas para clasificar los archivos pertinentes y software convencional para gestionar las tareas resultantes. Otro sistema podría revisar el parche final. Es una propuesta de diseño, no una recomendación evaluada comparativamente ni una prueba de que Jev ya sustituya a un agente de programación existente.
Lo atractivo es el uso selectivo del contexto. Si una subtarea solo necesita una interfaz y unas pocas restricciones, enviarle toda una conversación puede ser un derroche. Los registros explícitos de tareas podrían facilitar la identificación de los datos pertinentes, las decisiones ya tomadas y los cambios aún pendientes.
El peligro es confundir una sugerencia de coordinación con una garantía de ejecución simultánea. Dos agentes pueden creer que deben escribir en el mismo archivo. Un modelo probabilístico no debería sustituir los mecanismos de software que evitan los conflictos de escritura. Los permisos, las comprobaciones de versiones y los bloqueos deben seguir imponiendo el resultado correcto.
Del mismo modo, recuperar a menor coste el trabajo anterior podría mejorar la gestión de la memoria sin resolver todos los problemas agrupados bajo el término aprendizaje continuo. Recordar un intento anterior, entender por qué falló y adaptarse con fiabilidad a una situación nueva son capacidades distintas. Una evaluación convincente examinaría las tareas completadas, las regresiones, los conflictos y la intervención humana, no se limitaría a contar agentes o llamadas.
La seguridad atraviesa todo el sistema; no desaparece
Almeida prefiere los controles de seguridad en la aplicación a los rechazos del modelo; swyx cuestiona las consecuencias. Entrevista, 13:11 y 1:42:29
Hay un problema de diseño real: una aplicación desatendida debe gestionar las situaciones en que una dependencia rechace una solicitud, falle o devuelva un resultado incierto. Necesita un procedimiento de respuesta explícito. Esta observación no determina dónde deben ubicarse todas las salvaguardas.
Una aplicación debe hacer cumplir los permisos de acceso incluso cuando el modelo identifica correctamente la acción prevista. Puede entender perfectamente una solicitud para borrar un registro y aun así carecer de autorización. Una solicitud también puede ser técnicamente válida y contravenir la política del operador. El servicio de decisiones no puede responder responsablemente sin el contexto adecuado, y la aplicación debe conservar el control de la acción.
Por ello, trasladar más decisiones al software aumenta la importancia de especificar los límites antes del despliegue. Los equipos deben decidir qué pruebas hacen falta, qué operaciones siguen siendo reversibles y cómo puede una persona cuestionar o corregir un resultado. Eliminar una interacción incómoda con el modelo no demuestra que todo el sistema sea seguro.
Qué demostraría un gran cambio
El lanzamiento permite realizar un experimento claro. Elige un proceso acotado con un resultado observable. Registra cómo funciona hoy, incluidos los errores y el tiempo que las personas dedican a corregirlos. Prueba una versión basada en decisiones con casos representativos antes de concederle autoridad para actuar.
Mide la proporción de casos completados correctamente sin intervención, los errores que escapan a la revisión, el trabajo que se deriva a las personas y el coste total por caso resuelto. Conserva las pruebas originales para que un revisor pueda examinar por qué se aceptó un resultado. Repite la comparación cuando cambien el modelo, la política o la población de entradas.
Esta evaluación puede revelar que solo una parte del proceso está lista. Es un resultado útil. Automatizar la clasificación rutinaria y dejar los casos ambiguos en manos de un operador experimentado puede ser valioso sin justificar una autonomía más amplia.
El lanzamiento de Jev y la entrevista de Almeida proponen una hipótesis ambiciosa sobre cómo entra la IA en la economía: las decisiones repetidas y acotadas pueden hacer más capaz el software del que ya depende la gente. Las próximas pruebas deberían proceder de sistemas que realicen ese trabajo a lo largo del tiempo, incluyendo en las cuentas los errores y las excepciones. Ahí es donde una arquitectura de modelo interesante se convierte en un cambio que los lectores pueden observar.


