
Pelanggan mengubah alamat pada pesanan. Pesannya juga meminta pengembalian dana, menyebut paket yang rusak, dan menyiratkan bahwa ini sudah ketiga kalinya ada masalah. Mengubah pesan itu menjadi jawaban yang berguna adalah satu pekerjaan. Memutuskan catatan mana yang perlu diperbarui, tim mana yang harus turun tangan, dan tindakan mana yang memerlukan izin adalah pekerjaan lain.
Jev, model yang diperkenalkan TypeSafe AI dalam akses awal pada 15 September 2026, menyasar keputusan-keputusan tersebut. Model ini menghasilkan jawaban terstruktur dengan batasan tertentu untuk digunakan perangkat lunak. Peluncurannya mengajak kita mempertimbangkan kembali seberapa banyak bagian aplikasi yang harus bergantung pada percakapan panjang dengan model serbaguna. Pengumuman peluncuran TypeSafe
Argumen ini diuraikan paling lengkap dalam wawancara Latent Space pada 21 September dengan salah satu pendiri sekaligus CEO TypeSafe, Diogo Almeida, yang dipandu swyx. Kami meninjau takarir lengkap berbahasa Inggris dari percakapan berdurasi dua jam 22 menit itu dan memeriksa dokumentasi produk. Ini adalah analisis atas wawancara dan bukti publik; kami belum menguji Jev secara independen. Tonton wawancara asli
Menurut pembacaan kami, gagasan Jev yang paling berpengaruh menyangkut unit otomasi. Perusahaan mungkin dapat mengotomatiskan suatu penilaian terbatas di dalam proses yang sudah ada sebelum dapat menyerahkan seluruh proses itu secara bertanggung jawab. Jika penilaian tersebut cukup murah untuk diulang dan cukup jelas untuk diukur, perangkat lunak bisnis yang sudah dikenal dapat memperoleh kemampuan berguna tanpa mengubah setiap interaksi menjadi sesi percakapan.
Perubahan itu akan berdampak pada perancang alur kerja maupun penggunanya. Seseorang tetap harus menentukan tindakan yang diizinkan, apa yang dianggap sebagai kesalahan, dan siapa yang menangani pengecualian. Mutu keputusan-keputusan tersebut akan menentukan apakah pendekatan ini menghasilkan layanan yang dapat diandalkan atau sekadar mempercepat kesalahan.
Apa yang sebenarnya diluncurkan TypeSafe
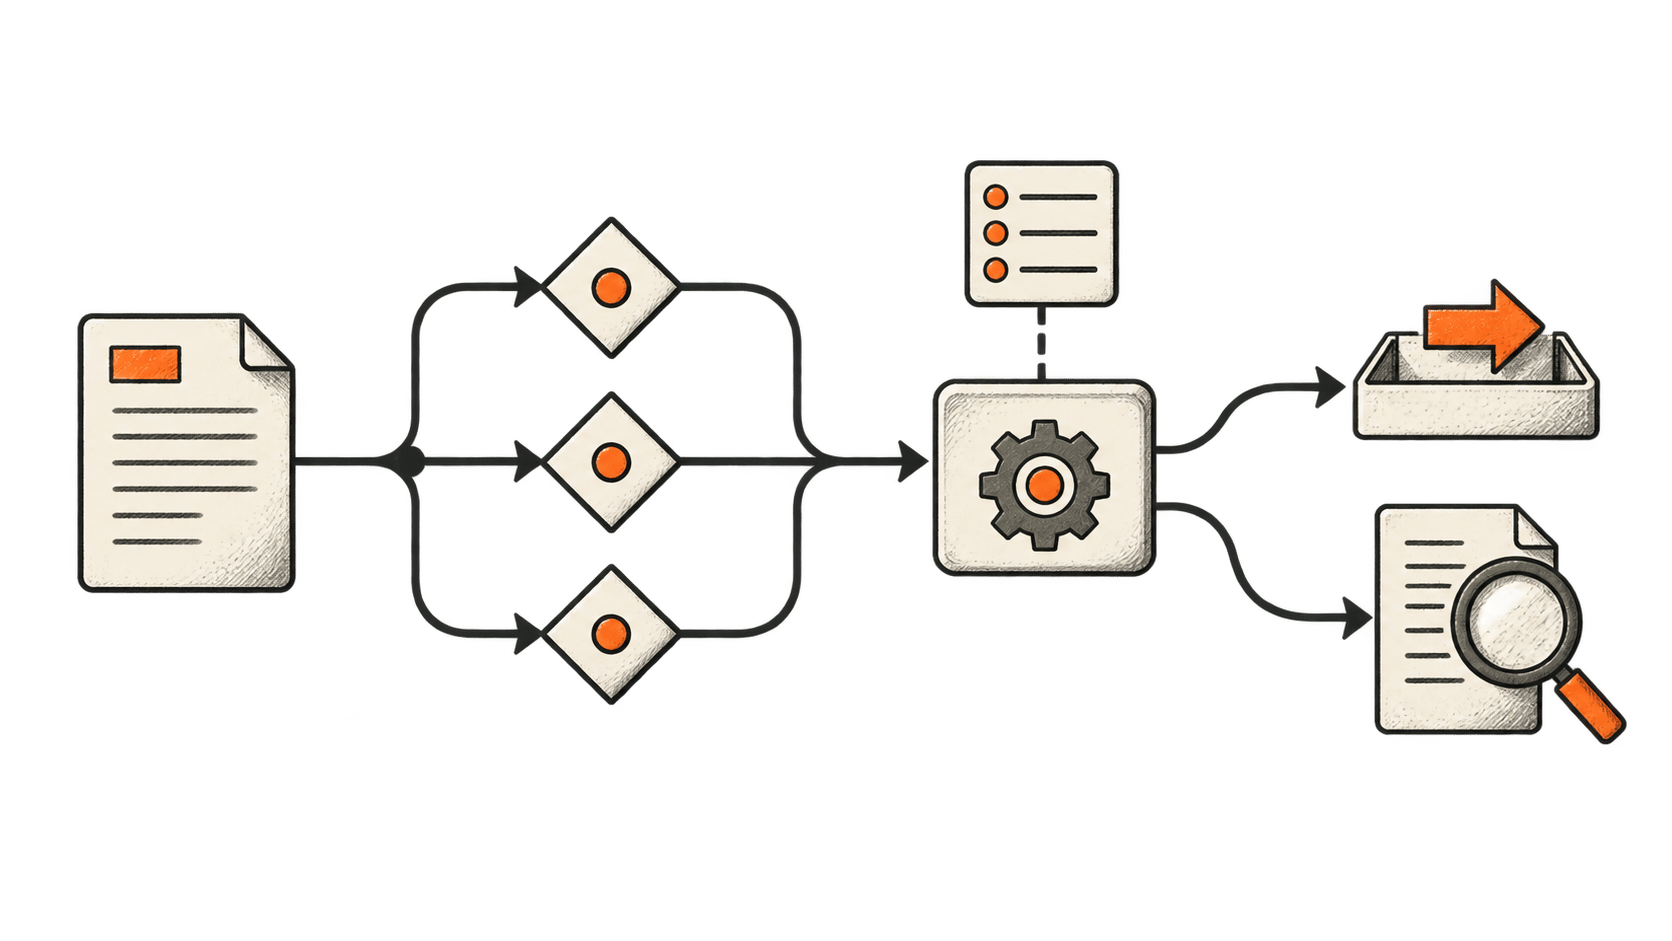
Antarmuka Jev yang didokumentasikan menerima suatu keadaan dan sekumpulan pertanyaan bertipe. Tiga primitifnya adalah Choice, yang memilih dari opsi yang ditentukan; Score, yang menilai berdasarkan rubrik; dan Noul, yang menyatakan probabilitas suatu pernyataan pada skala nol hingga satu. Choice dan Score mengembalikan distribusi serta kolom confidence. Noul tidak memiliki kolom confidence terpisah itu. Sejumlah pertanyaan dapat menggunakan keadaan yang sama, tetapi dievaluasi secara independen. Dokumentasi antarmuka TypeSafe
Dalam aplikasi layanan pelanggan, pengembang dapat menggunakan primitif tersebut untuk membedakan permintaan perubahan alamat dari pembatalan, menilai urgensi, serta memeriksa apakah pesan memuat bukti kerusakan. Ini contoh hipotetis, bukan hasil penerapan Jev. Aplikasi kemudian akan menentukan tindakan berdasarkan jawabannya.
Pembagian tanggung jawab itu berguna karena interpretasi dan kewenangan adalah dua hal berbeda. AI mungkin menyimpulkan bahwa pelanggan menginginkan pengembalian dana. Namun, AI tidak semestinya memperoleh izin untuk menerbitkannya hanya karena mencapai kesimpulan tersebut. Aplikasi dapat memeriksa pesanan, menerapkan batas pengembalian dana, dan meminta persetujuan jika diperlukan.
TypeSafe menyebut kategori model ini System One, meminjam istilah untuk pemikiran cepat dan intuitif. Anggap nama tersebut sebagai gambaran beban kerja yang dituju. Nama itu tidak membuktikan adanya kognisi mirip manusia ataupun batas yang tegas antara tugas mudah dan sulit. Pertanyaan singkat dapat menyembunyikan penilaian rumit, terutama ketika informasi yang dibutuhkan tidak tersedia.
Perubahan rekayasanya adalah keputusan yang lebih kecil dan mudah diperiksa
Almeida menganjurkan penguraian: ajukan pertanyaan dengan cakupan sempit, lalu gabungkan jawabannya dalam kode. Wawancara, 1:03:02
Perhatikan lagi contoh pesanan rusak tadi. Satu instruksi untuk menangani keluhan menyembunyikan beberapa penilaian di dalam satu jawaban. Desain yang lebih mudah diperiksa akan menetapkan secara terpisah tindakan yang diminta, apakah pesanan dapat diidentifikasi, dan apakah bukti yang tersedia mendukung klaim kerusakan. Aturan kebijakan tetap ditempatkan di luar penilaian tersebut.
Cara ini memudahkan penyelidikan ketika terjadi kegagalan. Jika sistem mengarahkan perubahan alamat ke tim pengembalian barang, operator dapat memeriksa keputusan peruteannya. Jika penilaian kerusakan keliru, komponen itu dapat diuji dengan kasus-kasus sebelumnya. Perubahan kebijakan dapat mengubah aturan yang dinyatakan secara eksplisit tanpa mengharuskan tim menulis ulang instruksi luas dan berharap model menafsirkannya secara konsisten.
Ada biayanya. Semakin banyak komponen, semakin banyak pula antarmuka yang harus dipelihara. Pertanyaan dapat tanpa sengaja menghilangkan konteks yang membuat jawaban menjadi jelas. Dua penilaian yang tampak independen mungkin bergantung pada bukti menyesatkan yang sama. Alur kerja yang dirangkai dari bagian-bagian yang masing-masing dapat diterima tetap bisa menghasilkan hasil yang tidak dapat diterima.
Pola yang didokumentasikan TypeSafe mencakup pengajuan beberapa pertanyaan sekaligus, penggabungan skor, dan pengalihan kasus yang tidak pasti untuk penanganan tambahan. Pola-pola itu menjelaskan pilihan arsitektur, bukan membuktikan bahwa proses pelanggan tertentu siap dijalankan tanpa pengawasan. Pola-pola TypeSafe
Uji yang berguna adalah apakah penguraian meningkatkan diagnosis sekaligus hasil. Kemampuan menjelaskan langkah mana yang gagal itu berharga. Namun, alasan bisnisnya adalah berkurangnya frekuensi dan dampak kegagalan tersebut.
Jawaban yang valid tetap bisa salah
Klaim peluncuran bahwa Jev “tidak bisa berhalusinasi” perlu ditafsirkan secara sempit. TypeSafe mengaitkan jaminannya dengan kesesuaian terhadap skema keluaran yang diizinkan. Hal itu tidak membuktikan bahwa jawaban yang dipilih benar. Pengumuman TypeSafe sendiri membedakan jaminan skema dari evaluasi empiris. Penjelasan TypeSafe tentang keamanan tipe
Misalkan aplikasi mengizinkan nilai damaged, late dan other. Mengembalikan damaged tetap sepenuhnya valid meskipun paketnya hanya terlambat. Model yang tidak dapat menciptakan kategori keempat tetap bisa memilih kategori yang salah. Jika daftar itu tidak memuat kategori yang benar-benar diperlukan, skemanya sendiri menjadi bagian dari masalah.
Keluaran terstruktur juga merupakan pendekatan rekayasa yang sudah ada. OpenAI memperkenalkan Structured Outputs dengan batasan skema pada Agustus 2024 dan secara eksplisit menyebutkan bahwa model tetap dapat membuat kesalahan di antara nilai-nilai yang dikembalikan. Karena itu, Jev perlu dinilai berdasarkan gabungan mutu keputusan, pelaporan ketidakpastian, latensi, dan biaya yang dimilikinya, bukan dianggap sebagai pencipta seluruh bentuk keluaran AI terstruktur. Pengumuman awal OpenAI beserta keterbatasannya
Bagi pembeli, perbedaan ini mengubah rencana evaluasi. Uji skema menanyakan apakah perangkat lunak dapat menggunakan suatu jawaban. Uji faktual menanyakan apakah jawaban tersebut sesuai dengan bukti. Uji kebijakan menanyakan apakah tindakan yang dihasilkan diizinkan. Lulus salah satunya tidak menggantikan kelulusan yang lain.
Tantangan terpenting dalam wawancara menyangkut kalibrasi
Pada menit 1:09, Almeida menolak anggapan bahwa kalibrasinya sempurna dan mengakui adanya kesalahan model. Wawancara, 1:08:50
Kalibrasi berkaitan dengan kesesuaian probabilitas prediksi terhadap hasil yang teramati pada sekumpulan prediksi. Model dapat berguna untuk menandai ketidakpastian tanpa selalu benar pada setiap kasus dengan probabilitas tinggi. Panduan TypeSafe secara eksplisit mempertahankan pembedaan itu. Penjelasan TypeSafe tentang kalibrasi
Kolom confidence pada API memerlukan pembedaan kedua. TypeSafe menjelaskannya sebagai statistik yang diturunkan dari distribusi jawaban. Nilai ini tidak dapat disamakan dengan probabilitas yang diukur secara independen bahwa jawaban terpilih itu benar. Dokumentasinya menyarankan pemilihan ambang yang sesuai dengan tugas dan konsekuensinya. Dokumentasi confidence TypeSafe
Ini persoalan praktis. Bayangkan model perutean bekerja baik pada pesan singkat berbahasa Inggris, tetapi kesulitan menangani keluhan panjang yang mencampur beberapa permintaan. Satu skor agregat dapat menyembunyikan kelemahan tersebut. Keputusan ber-confidence tinggi dari kelompok yang lebih lemah mungkin perlu lebih dicermati daripada angka tampilan yang sama dari kelompok yang sudah lazim.
Karena itu, tim sebaiknya mengevaluasi kasus yang diperkirakan akan diterima, termasuk informasi yang hilang, ungkapan yang tidak lazim, dan masukan yang sengaja membingungkan. Periksa kesalahan menurut kategori dan bandingkan biaya mengirim kasus untuk ditinjau dengan biaya bertindak secara keliru. Dengan demikian, ambang menjadi pilihan operasional yang ditopang bukti, bukan angka yang disalin dari demo.
Riset kalibrasi telah ada jauh sebelum Jev. Makalah Chuan Guo dan rekan-rekannya yang banyak dikutip dari 2017 meneliti buruknya kalibrasi pada jaringan saraf modern serta metode untuk memperbaikinya. Karya itu memberi konteks tentang masalahnya; makalah tersebut tidak memvalidasi model TypeSafe. Tentang Kalibrasi Jaringan Saraf Modern
Keandalan mencakup apa yang terjadi ketika layanan berubah
Percakapan itu membedakan robustnes dari determinisme dan membahas stabilitas versi tanpa menjanjikan dukungan jangka panjang secara umum. Wawancara, 41:24 dan 49:40
Ini pertanyaan pembelian yang berbeda. Determinisme menanyakan apakah masukan identik menghasilkan keluaran identik. Robustnes menanyakan apakah perubahan yang tidak relevan, seperti ID catatan yang berbeda, menyebabkan perubahan perilaku yang tidak masuk akal. Model dapat terus-menerus mengulang jawaban salah yang sama dan tetap deterministik. Model juga dapat sedikit berubah-ubah sementara alur kerja di sekitarnya tetap andal.
Kedua sifat itu tidak menyelesaikan risiko siklus hidup. Bisnis perlu mengetahui revisi model mana yang menghasilkan suatu keputusan, apakah revisi itu akan tetap tersedia, dan bagaimana penggantinya akan dievaluasi. Peningkatan pada pengujian penyedia tetap dapat mengubah perilaku alur kerja pelanggan yang telah disetel dengan cermat.
Tanggapan yang masuk akal adalah menyimpan kasus-kasus representatif, mencatat versi, dan membandingkan pengganti sebelum memigrasikan pekerjaan yang berdampak besar. Mekanisme cadangan juga penting: layanan pengambilan keputusan yang akurat sekalipun dapat tidak tersedia. Jika aplikasi tidak memiliki cara aman untuk menjeda atau mengalihkan pekerjaan, pada praktiknya waktu aktif menjadi bagian dari mutu keputusannya.
Di sinilah API yang menarik berubah menjadi ketergantungan operasional. Pengadaan, pemantauan, dan perencanaan migrasi tidak hilang ketika model menjadi lebih cepat. Semua itu justru lebih mudah diabaikan karena pemanggilan individualnya terlihat sederhana.
Mengapa angka kecepatan dan harga perlu konteks
Hasil alur kerja yang ditonjolkan TypeSafe mencakup peningkatan kecepatan 193,6 kali lipat dan perbaikan biaya 444,6 kali lipat. Pengumuman menyebutkan bahwa angka tersebut adalah peningkatan maksimum dari alur kerja yang dibuat perusahaan. Jawaban acuan berasal dari perkiraan probabilitas model lain, bukan klasifikasi kebenaran dasar yang diverifikasi secara independen. Perusahaan juga mengingatkan bahwa demo singkatnya menguntungkan Jev dan harga berkelanjutan untuk jangka panjang masih harus ditetapkan. Kualifikasi evaluasi TypeSafe
Kualifikasi itu harus selalu menyertai angkanya. Kesepakatan dengan model acuan dapat memberi informasi, tetapi mengukur hal yang berbeda dari kebenaran terhadap kasus pelanggan yang telah dipastikan. Alur kerja yang dirancang vendor mungkin relevan bagi pembeli tanpa mencerminkan distribusi permintaan pembeli tersebut.
Perbandingan yang tepat harus mencakup seluruh pekerjaan: mengumpulkan konteks, membuat keputusan, menerapkan aturan, menangani pengecualian, dan memulihkan diri dari kegagalan. Pemanggilan model yang lebih murah dapat beriringan dengan biaya total yang lebih tinggi jika terlalu banyak pekerjaan diteruskan ke peninjau. Pemanggilan yang lebih lambat dapat lebih ekonomis jika mencegah pengerjaan ulang yang mahal.
Latensi juga perlu diukur dari wilayah aplikasi yang sebenarnya. Demo yang dekat dengan infrastruktur layanan bukan janji tentang pengalaman pengguna di tempat lain. Sistem interaktif perlu memeriksa permintaan yang lambat selain rata-ratanya; pemrosesan latar belakang mungkin lebih mementingkan throughput dan biaya total.
Nama Jev merujuk pada gagasan bahwa efisiensi dapat memperluas konsumsi. Bagi satu bisnis, hal itu menimbulkan pertanyaan anggaran: keputusan baru mana yang layak dievaluasi, dan keputusan mana yang hanya menjadi cukup murah untuk dievaluasi secara tidak perlu? Bertambahnya pemanggilan model bukanlah hasil dengan sendirinya.
Tujuan riset yang berbeda, dengan bukti yang belum lengkap
Argumen riset Almeida menghubungkan data, pemilihan tugas, dan RLCD dengan kritiknya terhadap optimasi preferensi. Wawancara, 7:23 dan 22:12
RLCD adalah singkatan dari Reinforcement Learning for Calibrated Decisions. TypeSafe menjelaskannya sebagai pelatihan yang diarahkan pada keputusan dan probabilitas yang dapat digunakan, berbeda dari pendekatan preferensi manusia dan imbalan yang dapat diverifikasi. Itu adalah penjelasan perusahaan mengenai tujuannya. Penjelasan tersebut jangan disalahartikan sebagai verifikasi independen atas seluruh metode pelatihannya. Panduan AI TypeSafe
Pertanyaan yang lebih luas ini layak ditelusuri meskipun metodenya masih dievaluasi: perilaku apa yang diberi imbalan oleh suatu tujuan pelatihan? Model yang dioptimalkan untuk penjelasan persuasif mungkin menyenangkan digunakan, tetapi tidak mengungkapkan ketidakpastian dalam bentuk yang dapat ditindaklanjuti kode. Antarmuka berorientasi keputusan dapat memudahkan penanganan ketidakpastian, tetapi keluarannya tetap memerlukan pemeriksaan eksternal terhadap kenyataan.
TypeSafe mengaitkan kekhawatiran ini dengan mode dropping: optimasi preferensi dapat mempersempit ragam keluaran yang mungkin menuju respons yang diberi imbalan oleh manusia. Ini penjelasan TypeSafe tentang suatu mode kegagalan, bukan temuan bahwa setiap model yang dilatih dengan preferensi tidak dapat digunakan untuk mengambil keputusan. Uraian TypeSafe tentang optimasi preferensi
Latar belakang Almeida membuat argumen ini menarik. Ia adalah salah satu penulis makalah InstructGPT, yang meneliti pelatihan model bahasa agar mengikuti instruksi menggunakan umpan balik manusia. Kepengarangan itu dapat diverifikasi; klaim luas tentang kesalahan setiap laboratorium merupakan perkara berbeda. Makalah InstructGPT
Keberatannya atas pengeluaran prapelatihan dan pendirian laboratorium baru tanpa arah merupakan bagian dari argumen yang sama tentang pemilihan tugas yang berguna. Wawancara, 1:49:32 dan 2:03:10
Bagi pembeli, pelajaran yang relevan adalah menanyakan apa yang dapat dilakukan produk untuk proses yang terdefinisi. Rekam jejak riset, belanja komputasi, dan arsitektur model yang khas dapat menjelaskan bagaimana perusahaan menghasilkan suatu penawaran. Namun, hal-hal itu tidak membuktikan keekonomian penerapan produk tersebut dalam bisnis pihak lain.
Wawancara itu juga membahas kepergian Almeida dari OpenAI, sulitnya adopsi awal, dan pertumbuhan yang dipimpin pengembang. Wawancara, 1:31:27 dan 1:56:48
Kilas balik tersebut menjelaskan prioritas perusahaan. Itu bukan bukti adopsi yang telah diaudit. Pada akhirnya, platform pengembang perlu dinilai berdasarkan beban kerja bermanfaat yang berkelanjutan dan dukungan yang disediakan ketika beban kerja gagal. Antusiasme setelah peluncuran menjadi alasan untuk menyelidiki, bukan pengganti rekam jejak.
Perangkat lunak yang sudah ada mungkin mendapat manfaat lebih besar daripada sekadar jendela percakapan baru
Almeida memperkirakan produk SaaS akan menjadi lebih kuat dan AI akan semakin bekerja di latar belakang. Wawancara, 1:19:57
Arah itu layak ditelusuri karena perangkat lunak sudah memiliki bagian-bagian tempat penilaian berguna dapat mengubah langkah berikutnya. Aplikasi penjadwalan dapat mengenali permintaan yang ambigu sebelum membuat janji. Arsip media dapat mengatur materi untuk peneliti. Meja layanan dapat membedakan pembaruan rutin dari keluhan yang perlu ditangani. Ini rancangan yang mungkin, bukan penerapan Jev yang telah dilaporkan.
Antarmukanya mungkin nyaris tidak berubah. Pengguna akan merasakan lebih sedikit kesalahan, berkurangnya klasifikasi berulang, atau waktu tunggu yang lebih singkat hingga masalah sampai kepada orang yang tepat. Keunggulan komersial mungkin diperoleh perusahaan yang sudah memahami alur kerja dan mampu memasukkan keputusan yang lebih baik ke dalamnya.
Bisnis perangkat lunak yang sudah ada tetap akan menghadapi persaingan. Jika penilaian yang sama dapat diakses banyak pengembang, pemanggilan model saja hanya memberi sedikit pembeda. Produk di sekitarnya harus menyediakan akses data yang berguna, rancangan interaksi yang matang, dan cara yang dapat diandalkan untuk menuntaskan pekerjaan.
Klaim tentang pekerjaan membutuhkan kehati-hatian lebih besar. Mengurangi upaya pada satu tugas dapat mengubah kebutuhan staf, meningkatkan volume layanan, atau mengalihkan pekerjaan ke kasus pengecualian. Hasilnya bergantung pada organisasi dan permintaan atas layanannya. Wawancara maupun peluncuran akses awal tidak membuktikan bahwa pekerjaan akan terlindungi, dihilangkan, atau tercipta dalam jumlah tertentu.
Untuk tinjauan industri BIG CHANGE, peristiwa yang dapat diukur adalah tersedianya pendekatan lain untuk otomasi keputusan. Adopsi luas, peningkatan produktivitas, dan dampak terhadap pasar kerja adalah pertanyaan lanjutan yang memerlukan bukti berbeda.
Data gelap, perangkat lunak waktu nyata, dan keterbatasan demo
Wawancara membahas data tersimpan, aplikasi interaktif, verifikasi, dan demo penggunaan komputer. Wawancara, 1:34:50
Setiap kategori mengisyaratkan evaluasi yang berbeda. Pekerjaan pemrosesan arsip dapat menoleransi sedikit keterlambatan, tetapi memerlukan rencana untuk mengambil sampel hasil dan menelusurinya ke catatan asli. Antarmuka waktu nyata memerlukan respons yang konsisten. Pemeriksa yang mengevaluasi model lain harus diuji pada kesalahan yang benar-benar dibuat model tersebut, termasuk kasus ketika kedua sistem berbagi kesalahan yang sama.
Untuk penggunaan komputer, memilih tindakan hanyalah satu bagian sistem. Sistem juga membutuhkan representasi antarmuka yang akurat, cara untuk menjalankan tindakan, dan pemeriksaan bahwa perubahan yang diharapkan benar-benar terjadi. Demo yang rapi dapat membuktikan bahwa suatu rangkaian berhasil sekali; otomasi yang dapat diandalkan memerlukan uji berulang dan pemulihan saat terjadi gangguan.
Kehati-hatian yang sama berlaku untuk gim. Karakter yang diperantarai model mungkin bereaksi terhadap keadaan yang lebih kaya, sementara mesin gim tetap membatasi tindakan yang mungkin dilakukan. Apakah itu meningkatkan pengalaman bermain bergantung pada responsivitas, konsistensi, dan desain pengalaman. Menambahkan inferensi pada setiap bingkai tidak otomatis membuat gim lebih menarik.
Pembedaan ini mencegah kesalahan kategori: komponen yang berguna perlu dihargai sesuai perannya, tanpa mewarisi semua kemampuan aplikasi yang lebih besar di sekitarnya.
Penyetelan halus, visi, dan bentuk model tambahan muncul sebagai kemungkinan dalam wawancara. Wawancara, 1:10:27 dan 1:26:23
Percakapan tentang peta jalan produk tidak semestinya menjadi ketergantungan dalam rencana peluncuran. Bangun sistem berdasarkan antarmuka yang tersedia, tentukan apa yang harus disediakan komponen terpisah, lalu evaluasi kemampuan baru ketika benar-benar tersedia. Dengan begitu, perbaikan di masa depan tetap dapat dimanfaatkan tanpa menyajikan spekulasi sebagai fitur produk.
Agen coding dapat membagi pekerjaan dengan cara berbeda
Almeida mengusulkan penanganan keadaan yang lebih murah dan konteks bersama untuk agen coding, melampaui satu putaran model. Wawancara, 1:40:17 dan 2:09:29
Salah satu kemungkinan arsitektur menggunakan model coding yang cakap untuk mengembangkan perubahan, pemanggilan keputusan yang lebih kecil untuk mengklasifikasikan berkas terkait, dan perangkat lunak biasa untuk mengelola tugas yang dihasilkan. Peninjau terpisah dapat memeriksa patch akhir. Ini usulan desain, bukan rekomendasi yang telah diuji melalui tolok ukur atau bukti bahwa Jev sudah menggantikan agen coding yang ada.
Hal yang menarik adalah pemilihan konteks. Jika subtugas hanya memerlukan satu antarmuka dan beberapa batasan, mengirim seluruh percakapan mungkin boros. Catatan tugas yang eksplisit dapat memudahkan identifikasi fakta yang relevan, keputusan yang sudah diambil, dan perubahan yang masih tertunda.
Risikonya adalah menyamakan saran koordinasi dengan jaminan konkurensi. Dua agen bisa sama-sama mengira bahwa merekalah yang harus menulis sebuah berkas. Model probabilistik tidak semestinya menggantikan mekanisme perangkat lunak yang mencegah penulisan yang saling bertentangan. Izin, pemeriksaan versi, dan penguncian tetap harus menegakkan hasilnya.
Demikian pula, pengambilan pekerjaan terdahulu dengan biaya lebih rendah dapat memperbaiki pengelolaan memori tanpa memecahkan semua masalah yang disebut pembelajaran berkelanjutan. Mengingat upaya sebelumnya, memahami penyebab kegagalannya, dan beradaptasi dengan andal pada situasi baru adalah kemampuan yang berbeda. Evaluasi yang meyakinkan akan memeriksa tugas yang diselesaikan, kemunduran, konflik, dan campur tangan manusia, bukan sekadar menghitung agen atau pemanggilan.
Keselamatan bergerak melalui sistem; keselamatan tidak lenyap
Almeida mengutamakan kontrol keselamatan di tingkat aplikasi dibandingkan penolakan model; swyx mempertanyakan konsekuensinya. Wawancara, 13:11 dan 1:42:29
Ada persoalan desain yang nyata di sini: aplikasi tanpa pengawasan harus menangani kondisi ketika dependensi menolak, gagal, atau mengembalikan hasil yang tidak pasti. Aplikasi memerlukan jalur respons yang jelas. Pengamatan itu tidak menentukan di mana setiap perlindungan harus ditempatkan.
Aplikasi harus menegakkan izin akses sekalipun model berhasil mengenali tindakan yang dimaksud. Permintaan untuk menghapus catatan mungkin dipahami dengan sempurna, tetapi tetap tidak berwenang. Permintaan juga bisa sah secara teknis tetapi melanggar kebijakan operator. Layanan pengambilan keputusan tidak dapat menjawab pertanyaan tersebut secara bertanggung jawab tanpa konteks yang sesuai, dan aplikasi harus tetap memegang kendali atas tindakannya.
Karena itu, memindahkan lebih banyak keputusan ke dalam perangkat lunak semakin meningkatkan pentingnya penetapan batas sebelum penerapan. Tim perlu menentukan bukti apa yang diperlukan, operasi mana yang masih dapat dibatalkan, serta bagaimana seseorang dapat menggugat atau memperbaiki hasil. Menghapus interaksi yang merepotkan dengan model saja belum cukup untuk membuktikan bahwa keseluruhan sistem aman.
Apa yang dapat membuktikan adanya perubahan besar
Peluncuran ini memungkinkan eksperimen yang jelas. Pilih satu proses terbatas dengan hasil yang dapat diamati. Catat cara kerjanya saat ini, termasuk kesalahan dan waktu yang dihabiskan orang untuk memperbaikinya. Uji versi berbasis keputusan dengan kasus yang representatif sebelum memberinya wewenang untuk bertindak.
Ukur proporsi kasus yang diselesaikan dengan benar tanpa campur tangan, kesalahan yang lolos dari peninjauan, beban kerja yang diteruskan kepada manusia, serta biaya total per kasus yang diselesaikan. Simpan bukti asli agar peninjau dapat memeriksa alasan suatu hasil diterima. Ulangi perbandingan saat model, kebijakan, atau populasi masukan berubah.
Evaluasi ini mungkin menunjukkan bahwa hanya sebagian proses yang siap diotomatisasi. Itu hasil yang berguna. Mengotomatiskan klasifikasi rutin sambil tetap menangani kasus ambigu dengan operator berpengalaman dapat bermanfaat tanpa membenarkan otonomi yang lebih luas.
Peluncuran Jev dan wawancara Almeida mengajukan hipotesis ambisius tentang cara AI memasuki perekonomian: keputusan yang berulang dan dibatasi dapat membuat perangkat lunak yang sudah diandalkan orang menjadi lebih mumpuni. Bukti berikutnya seharusnya berasal dari sistem yang menjalankan pekerjaan tersebut dari waktu ke waktu, dengan kesalahan dan pengecualian ikut diperhitungkan. Di situlah arsitektur model yang menarik menjadi perubahan yang benar-benar dapat dilihat pembaca.


