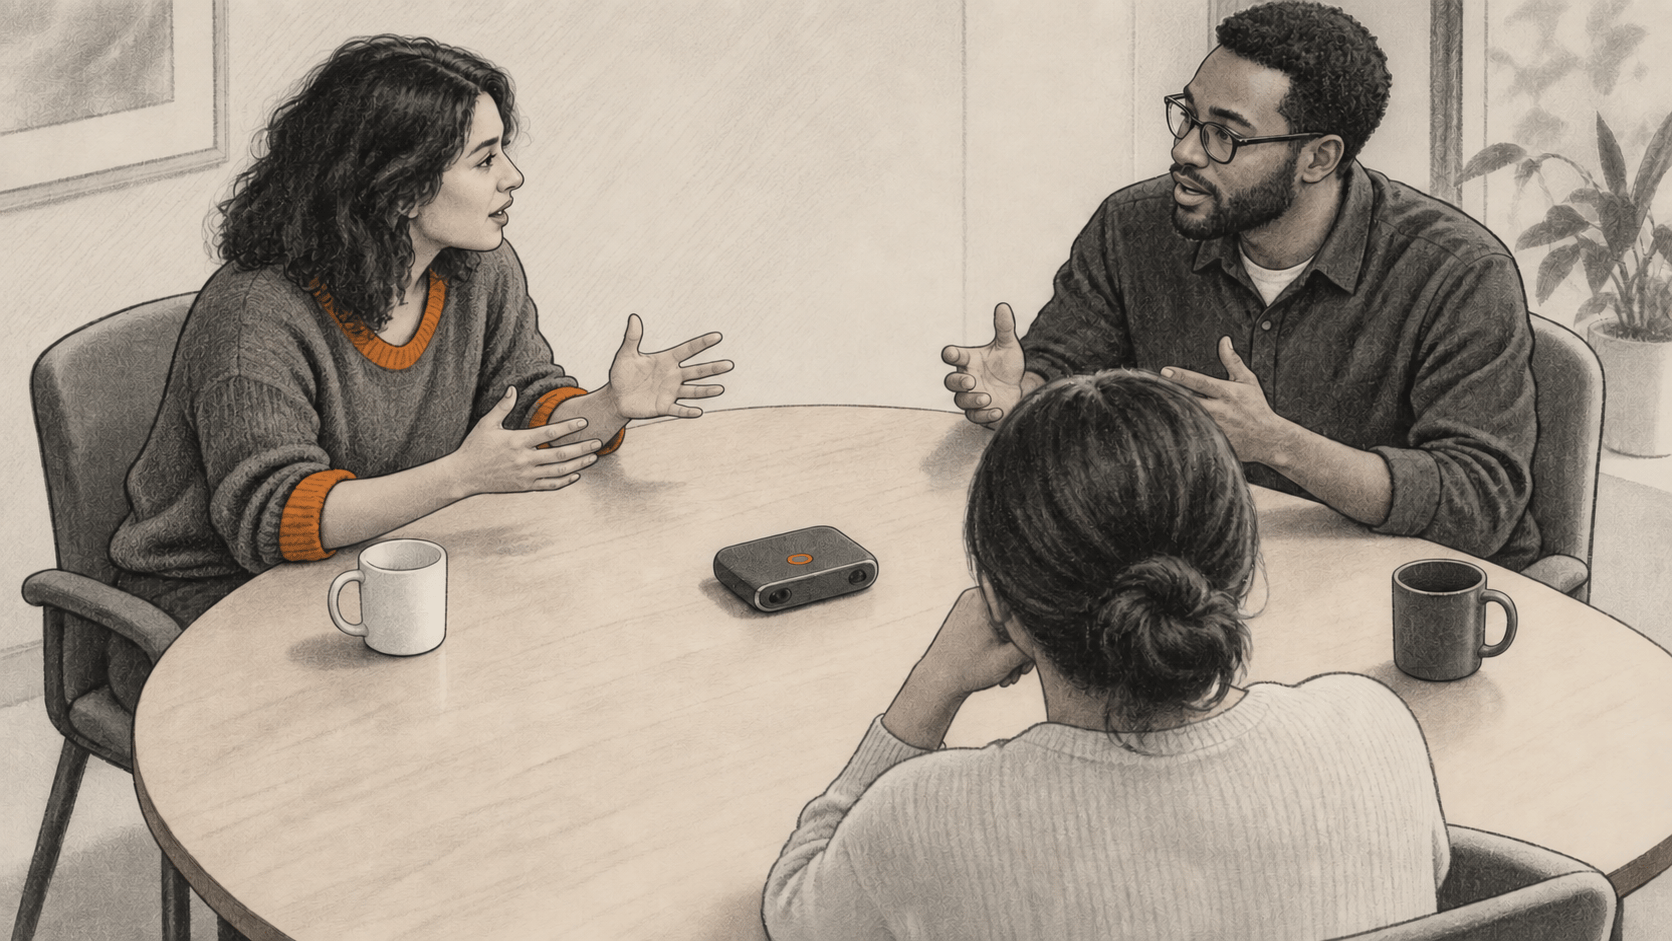
أصدرت NVIDIA نموذج Nemotron 3 Diarization في 23 سبتمبر. ويحدّد هذا النموذج المفتوح الأوزان، الذي يضم نحو 100 مليون معلمة، أوقات حديث كل واحد من ثمانية متحدثين كحد أقصى، سواء في الصوت المسجل أو المتدفق. ويوفر للمطورين نشاط المتحدثين والطوابع الزمنية للمحادثة؛ أما إنتاج نص يتضمن الكلمات فيتطلب أيضًا نظامًا للتعرف على الكلام.
التغيير الأبرز
- ما الذي تغيّر: يدعم إصدار Sortformer السابق من NVIDIA، المخصص للبث، أربعة متحدثين. أما هذا الإصدار فيوفر قنوات لثمانية متحدثين، مرتبة بحسب ظهورهم، انطلاقًا من نقطة تحقق واحدة تعمل مع الصوت المسجل والكتل الصوتية الواردة.
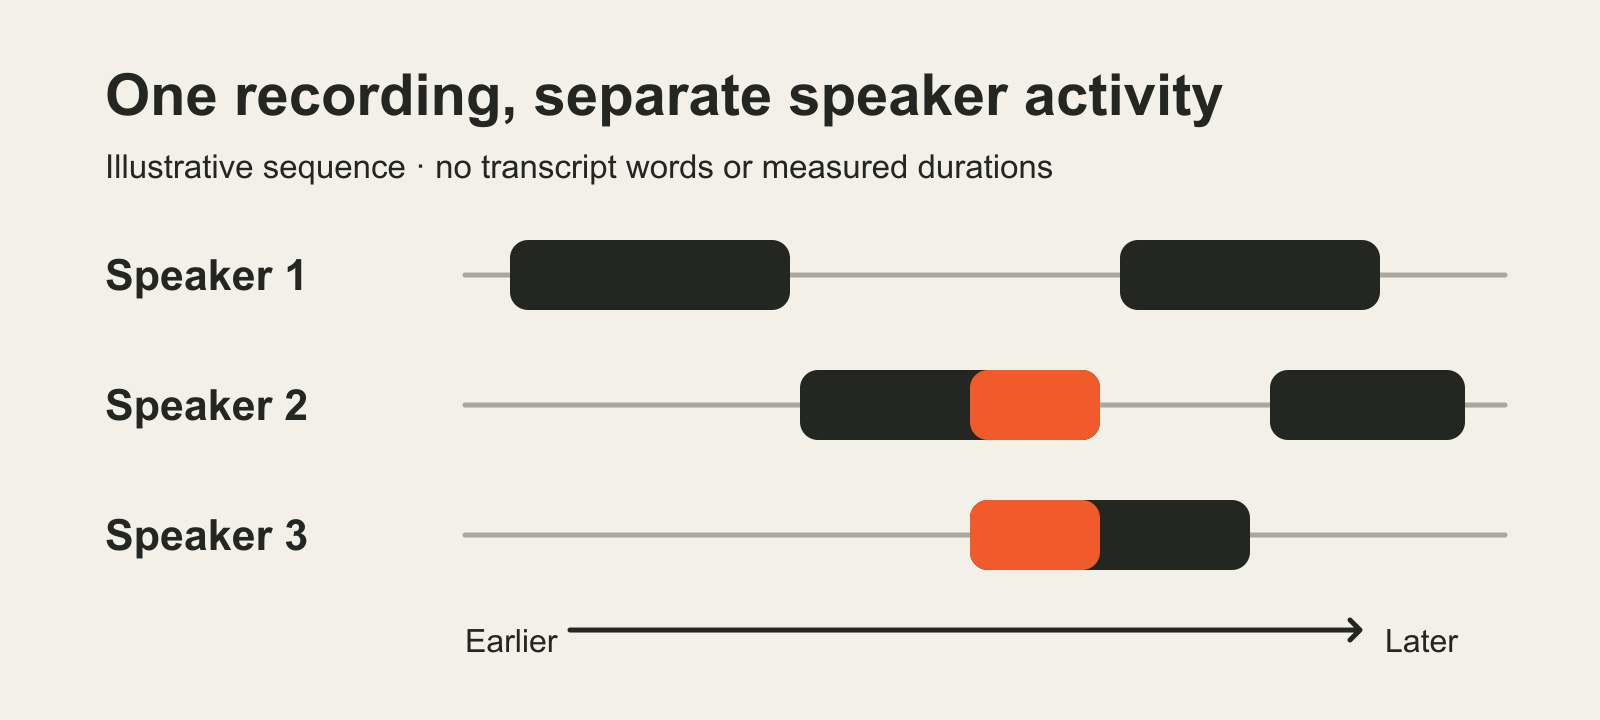
- لماذا يهم ذلك: يستطيع المطور الذي يبني نظامًا لتفريغ الاجتماعات أو المكالمات استخدام النموذج لإسناد تسميات عامة للمتحدثين إلى فترات زمنية، بما في ذلك الكلام المتداخل، ثم دمج تلك الفترات مع الكلمات الناتجة من نظام تعرّف مستقل. ويزيد الإصدار الحد الموثق لعدد المتحدثين في هذه المهمة.
- ما الذي ينبغي متابعته: يتعلق القرار العملي بمقدار الصوت الذي ينبغي تخزينه مؤقتًا قبل كل نتيجة للبث. فأقصر إعداد توصي به NVIDIA ينتظر 0.32 ثانية من الصوت قبل بدء الحساب، وتُظهر جداول الدقة الخاصة بها أن استخدام هذا الإعداد له كلفة. ولا تزال الفرق بحاجة إلى قياس أداء المسار الكامل على تسجيلاتها.
ما الذي يعيده النموذج
تحدد بطاقة النموذج صوتًا أحادي القناة بتردد 16 كيلوهرتز. وتذكر ملفات WAV وFLAC وOpus وMP3، كما تقبل واجهة NeMo مسارات الملفات أو مصفوفات الصوت أو ملف بيان JSON مفصولًا بأسطر. ويجب تمرير معدل أخذ العينات الصحيح مع مصفوفات الصوت إلى الدالة diarize(). ولا تضع البطاقة حدًا أقصى ثابتًا لمدة التسجيل للاستدلال على كتل صوتية.
يحوّل النموذج الصوت إلى [T, 8] من احتمالات نشاط المتحدثين، بخطوة إخراج افتراضية مقدارها 10 مللي ثوانٍ. ويمكن تنشيط قنوات متعددة في الوقت نفسه عند تداخل المتحدثين. وتحول المعالجة اللاحقة هذه الاحتمالات إلى فترات ذات أوقات بداية ونهاية وتسميات عامة للمتحدثين. وتتبع التسميات ترتيب ظهور الأصوات أول مرة؛ ولا تحدد هوية الأشخاص بأسمائهم. وتستخدم NVIDIA ذاكرة مؤقتة للمتحدثين في الكتل السابقة، وقائمة انتظار «الأول دخولًا، الأول خروجًا» للإطارات الحديثة، كي يحتفظ نموذج البث بالسياق.
وهذا التمييز مهم للمطور الذي يحتاج إلى نص مفرغ يحمل علامات للمتحدثين. يوائم دليل التكامل من NVIDIA الطوابع الزمنية لتمييز المتحدثين مع مخرجات مستقلة للتعرف الآلي على الكلام. وتترك قاعدة نقطة المنتصف في المثال كلمةً بلا إسناد عند غياب متحدث نشط، وتضع علامة على النشاط المتزامن بوصفه ملتبسًا. ولا يقرر نموذج تمييز المتحدثين وحده أي صوت متداخل نطق كلمة تم التعرف عليها.
زمن التخزين المؤقت ليس زمن الاستجابة
تسرد NVIDIA إعدادات موصى بها لمخزن الإدخال المؤقت: 30.4 و1.04 و0.64 و0.32 ثانية. ويتكون إعداد 0.32 ثانية من ثلاثة إطارات معالجة مدة كل منها 80 مللي ثانية، وإطار واحد مدته 80 مللي ثانية للسياق اللاحق. وتعرّف البطاقة زمن الانتقال صراحةً بأنه الصوت المحتجز قبل الاستدلال، مع استبعاد وقت الحساب. وسيضيف نظام التفريغ النصي أيضًا زمن التعرف والنقل والتطبيق.
يتطلب المسار الموثق عبر NeMo إصدار Python 3.12 أو أحدث، وCython، وإصدارًا حديثًا من PyTorch، وحزمة NeMo Speech. وتوفر NVIDIA SortformerEncLabelModel.from_pretrained() مثالًا، واستدعاءً diarize() يعيد مقاطع المتحدثين، وخيارًا لتضمين موترات الاحتمالات. وتذكر البطاقة أن تحميل نقطة التحقق المستضافة عبر استدعاء NeMo يتطلب رمز Hugging Face. كما تعرض واجهة Transformers للاستدلال دون اتصال وبالبث، مع التثبيت من مستودع مصدر Transformers، إضافة إلى مسار سطر أوامر NeMo-Speech.cpp. وهذه واجهات موثقة، ولم تشغّلها BIG CHANGE. وتسرد بطاقة النموذج أنظمة Linux وعائلات وحدات معالجة الرسوميات NVIDIA Ampere وHopper وBlackwell لتكامل NeMo. وتتوقف متطلبات الأجهزة وتكلفة المعالجة لحمل عمل معين على المسار والجهاز المختارين؛ ولا تحدد NVIDIA في البطاقة سعر تشغيل لكل ساعة.
تُتاح الأوزان بموجب ترخيص OpenMDW 1.1. ويمنح الترخيص حق الاستخدام والتعديل والتوزيع من دون رسوم ترخيص، مع مراعاة شروطه. ويجب عند التوزيع الاحتفاظ بالترخيص وإشعارات المصدر المنطبقة. ولا يقيّد الترخيص استخدام المخرجات أو مشاركتها، كما يحمل المستخدمين مسؤولية تأمين الحقوق والموافقات اللازمة لصوتهم. وتقول NVIDIA إن النموذج متاح للاستخدام التجاري وغير التجاري.
ما الذي قاستْه NVIDIA
تقارن تقييمات بطاقة النموذج بين Nemotron 3 وإصدار Sortformer v2.1 السابق من NVIDIA، الذي يدعم البث وأربعة متحدثين. وعلى مجموعة التقييم الكاملة DIHARD III، تسجل NVIDIA معدل خطأ في تمييز المتحدثين قدره 13.18% لنموذج Nemotron 3 عند إعداد مخزن الإدخال المؤقت البالغ 1.04 ثانية، مقابل 19.60% للنموذج السابق عند الإعداد نفسه. وعند 0.32 ثانية، تبلغ نتيجة Nemotron 3 نحو 13.55%. ويجمع معدل الخطأ الكلام الفائت والإنذارات الكاذبة والالتباس بين المتحدثين، مقسومًا على زمن المتحدثين في المرجع. والأقل أفضل.
ترتبط هذه الأرقام ببروتوكول محدد. وتقول NVIDIA إن جميع تقييماتها تحتسب الكلام المتداخل. وتستخدم DIHARD III هامشًا صفريًا عند حدود المقاطع، بينما تستخدم CALLHOME-Part2 هامشًا قدره 0.25 ثانية. وبالنسبة إلى AMI وAliMeeting وNOTSOFAR1، تستخدم NVIDIA تعليقات مرجعية مرتبطة ومُحاذاة قسرية بدلًا من تسميات المقاطع الأصلية؛ فتغيير تلك التسميات يغيّر الدرجات. وتحدد تعليمات التقييم نص NeMo البرمجي، وتشترط ملف RTTM مرجعيًا وإعدادات التداخل والهامش والبث والمعالجة اللاحقة لإجراء مقارنة قابلة للتكرار. واستخدمت نتائج NVIDIA لسرعة الاستدلال تنسيق BF16 على وحدة RTX PRO 5000، مع وبدون torch.compile(). وهذه اختبارات أبلغت عنها الشركة، وليست إعادة إنتاج أجرتها BIG CHANGE.
ولا يزال الحد الأقصى البالغ ثمانية متحدثين مهمًا. فبعض تسجيلات DIHARD III موسوم بما يصل إلى تسعة متحدثين، وتذكر البطاقة أن الكلام الذي يتجاوز القنوات الثماني للنموذج قد يفوت أو يُسند إلى قناة أخرى. وفي تسجيلات اختبار AMI، تسجل NVIDIA معدل خطأ أقل لتمييز المتحدثين في Nemotron 3 مقارنة بخط الأساس السابق، لكن دقته في تحديد العدد الدقيق للمتحدثين أقل. لذلك تعتمد الدقة على المهمة والمقياس، وكذلك على الصوت. ويمكن للفريق الذي يدرس دمج النموذج أن يبدأ من الواجهات المنشورة لدى NVIDIA، ثم يختبر المسار الكامل للمتحدثين والكلمات على تسجيلات تشبه الاستخدام المقصود.