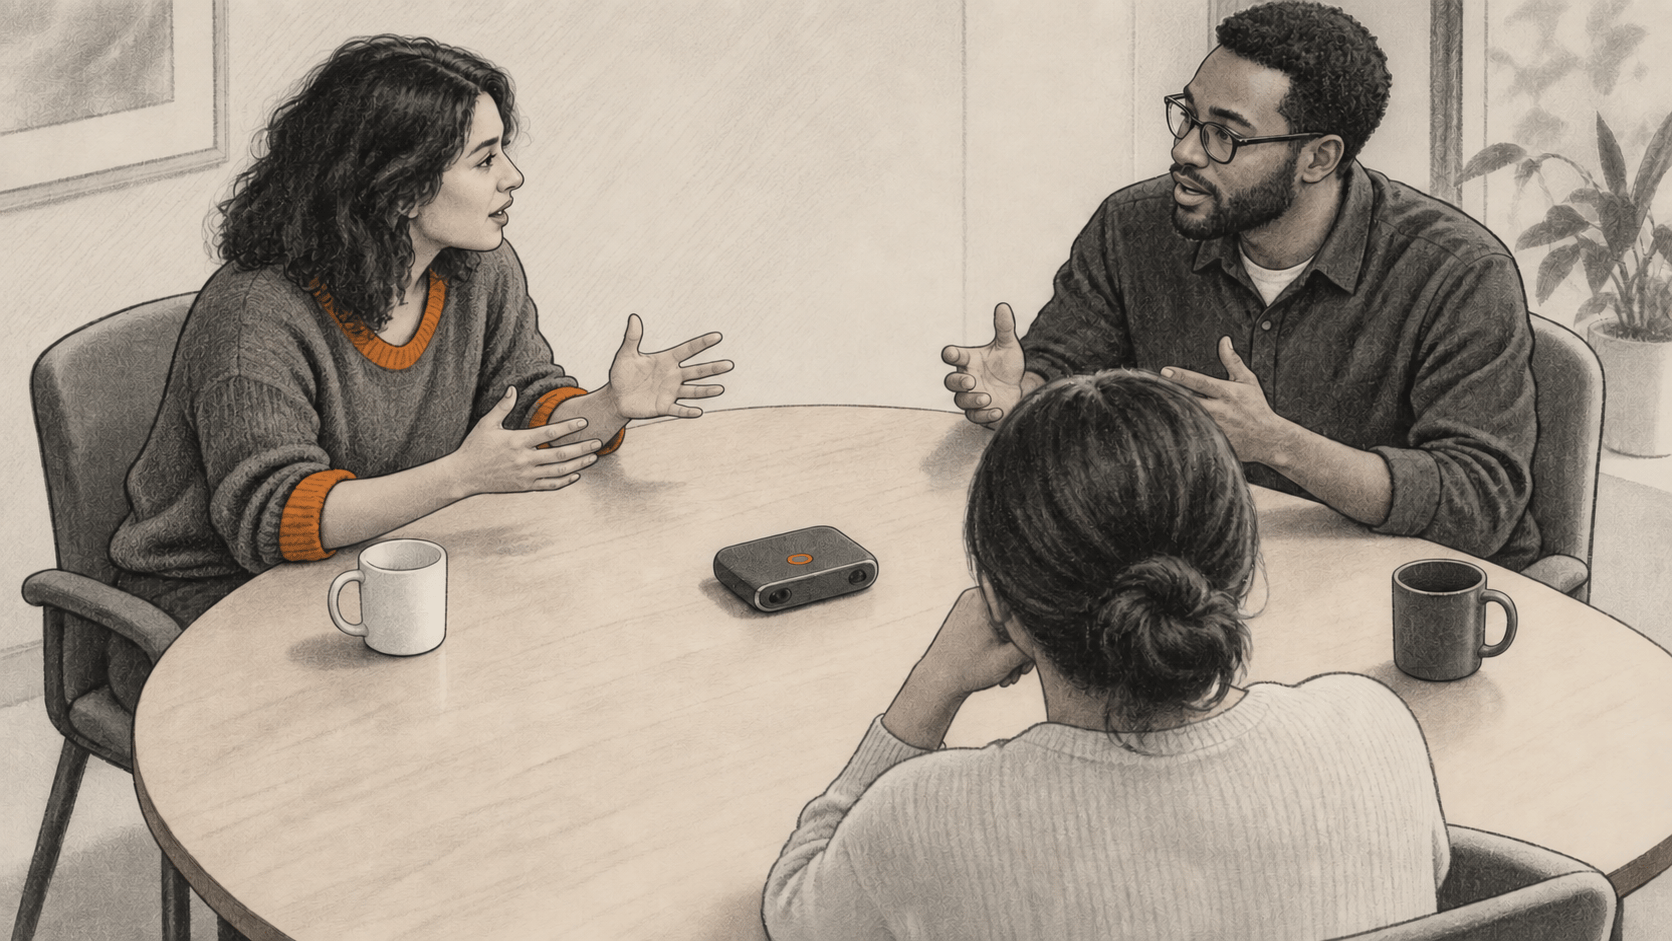
NVIDIA lanzó Nemotron 3 Diarization el 23 de septiembre. El modelo de pesos abiertos, de unos 100 millones de parámetros, marca cuándo habla cada uno de hasta ocho interlocutores en audio grabado o en streaming. Ofrece a los desarrolladores actividad por hablante y marcas de tiempo de una conversación; para generar una transcripción con palabras también se necesita reconocimiento de voz.
El gran cambio
- Qué ha cambiado: El punto de control anterior de Sortformer para streaming de NVIDIA admite cuatro hablantes. Esta versión ofrece ocho canales de hablante asignados en orden de aparición desde un único punto de control, compatible tanto con audio grabado como con fragmentos entrantes.
- Por qué importa: Un desarrollador que cree un sistema para transcribir reuniones o llamadas puede usar el modelo para asignar etiquetas genéricas de hablante a intervalos de tiempo, incluso cuando hay voces superpuestas, y después combinarlos con las palabras de un reconocedor independiente. El lanzamiento amplía el límite de hablantes documentado para esa tarea.
- Qué conviene observar: La decisión práctica es cuánto audio almacenar en búfer antes de cada resultado de streaming. El ajuste recomendado más breve de NVIDIA espera 0,32 segundos de audio antes de empezar el cálculo, y sus propias tablas de precisión muestran el coste de usarlo. Los equipos aún deben medir el flujo completo con sus grabaciones.
Qué devuelve el modelo
La ficha del modelo especifica audio mono a 16 kHz. Enumera archivos WAV, FLAC, Opus y MP3; la interfaz de NeMo acepta rutas de archivos, matrices de audio o un manifiesto JSON delimitado por líneas. Para las matrices de audio, hay que indicar la frecuencia de muestreo correcta para diarize(). La inferencia por fragmentos no tiene una duración máxima fija en la ficha.
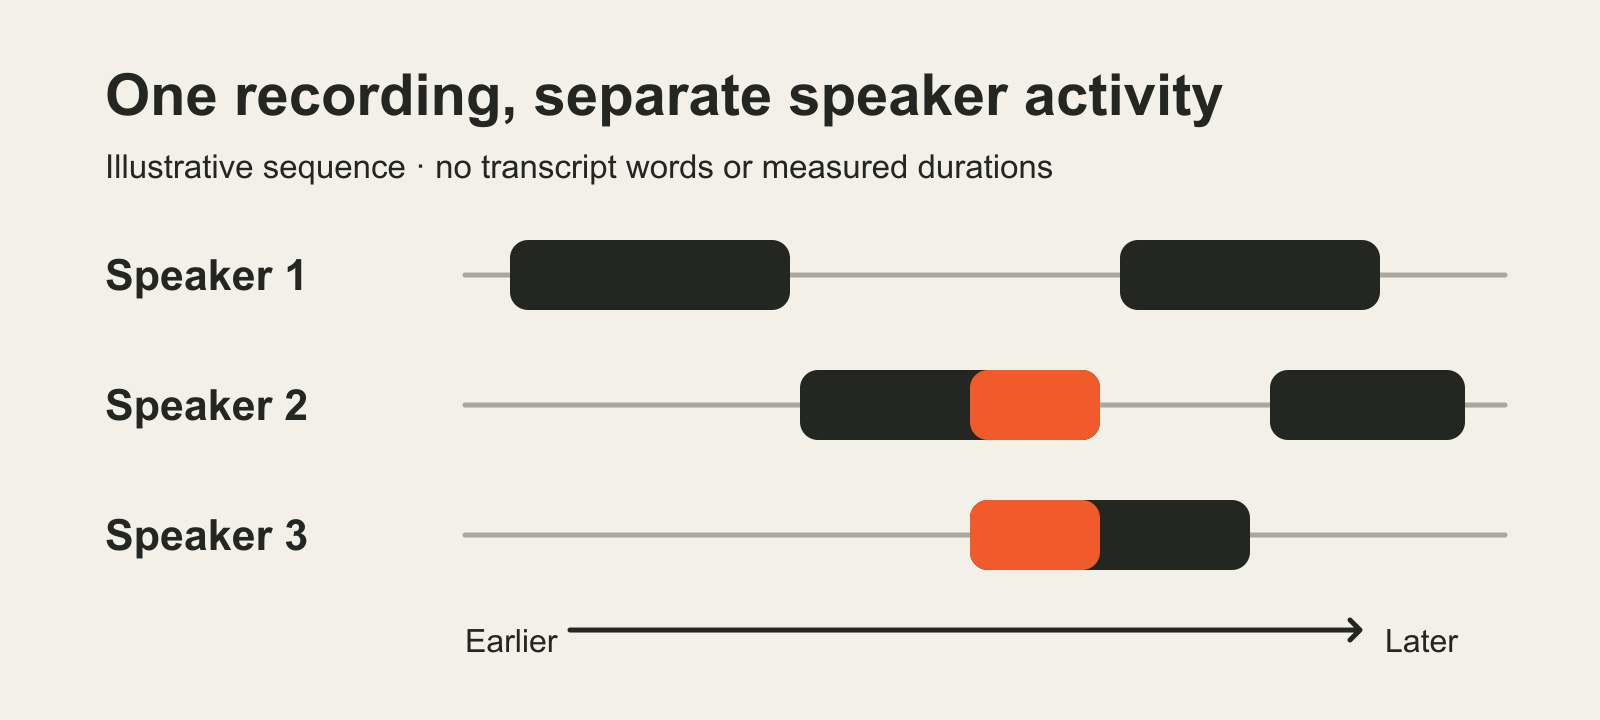
El modelo convierte el audio en un tensor con forma [T, 8] que contiene probabilidades de actividad por hablante, con un intervalo de salida predeterminado de 10 milisegundos. Varios canales pueden estar activos al mismo tiempo si las voces se superponen. El posprocesamiento convierte esas probabilidades en intervalos con horas de inicio y fin, y etiquetas genéricas de hablante. Las etiquetas siguen el orden en que aparecen las voces por primera vez; no identifican a las personas por su nombre. NVIDIA usa una caché de hablantes para los fragmentos anteriores y una cola de primero en entrar, primero en salir para los fotogramas recientes, de modo que el modelo de streaming conserve el contexto.
Para quien desarrolla una transcripción con etiquetas de hablante, esa distinción es importante. La guía de integración de NVIDIA combina las marcas de tiempo de la diarización con el resultado de un sistema independiente de reconocimiento automático del habla. Su regla de ejemplo, basada en el punto medio, deja una palabra sin asignar cuando no hay ningún hablante activo y marca como ambigua la actividad simultánea. El modelo de diarización por sí solo no determina qué voz superpuesta produjo una palabra reconocida.
El tiempo de búfer no es el tiempo de respuesta
NVIDIA recomienda ajustes de búfer de entrada de 30,4, 1,04, 0,64 y 0,32 segundos. El ajuste de 0,32 segundos consta de tres tramas de procesamiento de 80 milisegundos y una trama de contexto futuro de 80 milisegundos. La ficha define explícitamente la latencia como el audio retenido antes de la inferencia; no incluye el cálculo. Un sistema de transcripción añadiría también el tiempo de reconocimiento, transporte y aplicación.
La ruta documentada de NeMo requiere Python 3.12 o posterior, Cython, una versión reciente de PyTorch y NeMo Speech. NVIDIA ofrece, como ejemplo, la llamada SortformerEncLabelModel.from_pretrained(), y una llamada diarize() que devuelve segmentos de hablante y permite activar los tensores de probabilidades. La ficha indica que se necesita un token de Hugging Face para cargar el punto de control alojado mediante esa llamada de NeMo. También muestra interfaces de Transformers para uso local y en streaming, que requieren instalar desde el repositorio de origen de Transformers, además de una ruta de línea de comandos con NeMo-Speech.cpp. Son interfaces documentadas; BIG CHANGE no las ha ejecutado. La ficha del modelo enumera Linux y las familias de GPU NVIDIA Ampere, Hopper y Blackwell para su integración con NeMo. Las necesidades de hardware y el coste de procesamiento de una carga concreta dependen de la ruta y el equipo elegidos; la ficha no da un precio de operación por hora.
Los pesos se ofrecen bajo la licencia OpenMDW 1.1. La licencia permite usar, modificar y distribuir el modelo sin pagar una tarifa de licencia, con sujeción a sus términos. Al distribuirlo hay que conservar la licencia y los avisos de origen pertinentes. La licencia no restringe el uso ni la difusión de los resultados y responsabiliza a los usuarios de obtener los derechos y consentimientos que pueda requerir su audio. NVIDIA describe el modelo como apto para usos comerciales y no comerciales.
Qué midió NVIDIA
La evaluación de la ficha del modelo compara Nemotron 3 con la versión anterior Sortformer v2.1 para streaming, que admite cuatro hablantes. En el conjunto completo de evaluación DIHARD III, NVIDIA informa de una tasa de error de diarización del 13,18 % para Nemotron 3 con un búfer de entrada de 1,04 segundos, frente al 19,60 % del modelo anterior con el mismo ajuste de búfer declarado. Con 0,32 segundos, el resultado de Nemotron 3 es del 13,55 %. La tasa de error de diarización combina el habla omitida, las falsas alarmas y la confusión entre hablantes, y la divide por el tiempo de referencia de los hablantes. Un valor menor es mejor.
Esas cifras corresponden a un protocolo definido. NVIDIA indica que todas sus evaluaciones puntúan el habla superpuesta. DIHARD III usa un margen de tolerancia de cero segundos en los límites, mientras que CALLHOME-Part2 usa uno de 0,25 segundos. Para AMI, AliMeeting y NOTSOFAR1, NVIDIA usa anotaciones de referencia vinculadas y alineadas de forma forzada, en vez de las etiquetas de segmentos originales; cambiar esas etiquetas cambia los resultados. Las instrucciones de evaluación identifican el script de NeMo y exigen un archivo de referencia RTTM, el ajuste de superposición, el margen de tolerancia, los parámetros de streaming y los detalles del posprocesamiento para que una prueba sea comparable. NVIDIA midió la velocidad de inferencia en precisión BF16 con una RTX PRO 5000, con y sin torch.compile(). Son pruebas comunicadas por el proveedor, no una reproducción de BIG CHANGE.
El límite de ocho hablantes sigue siendo importante. DIHARD III incluye grabaciones anotadas con hasta nueve hablantes, y la ficha indica que el habla que supere los ocho canales del modelo puede omitirse o asignarse a otro canal. En las grabaciones de prueba de AMI, NVIDIA informa que Nemotron 3 tiene un error de diarización menor que su referencia anterior, aunque su precisión exacta al contar hablantes es más baja. Por tanto, la precisión depende de la tarea y la métrica, además del audio. Un equipo que decida integrar el modelo puede partir de las interfaces publicadas por NVIDIA y probar el flujo completo de hablantes y palabras con grabaciones similares a las de su uso previsto.