NVIDIA가 Nemotron 3 화자 분리 모델을 9월 23일 공개했다. 오픈 웨이트 방식의 약 1억 개 매개변수 모델은 녹음 또는 스트리밍 오디오에서 최대 8명의 화자가 말하는 시점을 표시한다. 대화에서 화자의 활동 구간과 타임스탬프를 제공하며, 단어까지 포함된 녹취록을 만들려면 별도의 음성 인식도 필요하다.
큰 변화
- 무엇이 달라졌나: NVIDIA의 기존 스트리밍 Sortformer 체크포인트는 화자 4명을 지원한다. 이번 출시 모델은 녹음 오디오와 들어오는 오디오 청크 모두에 사용할 수 있는 단일 체크포인트로, 발화 순서에 따라 8개의 화자 채널을 제공한다.
- 왜 중요한가: 회의나 통화 녹취 시스템을 만드는 개발자는 이 모델로 겹쳐 말하는 경우까지 시간 구간에 일반적인 화자 표지를 붙인 뒤, 별도 음성 인식기가 만든 단어와 해당 구간을 결합할 수 있다. 이번 공개는 이 작업에서 문서화된 화자 수 한도를 넓힌다.
- 앞으로 지켜볼 점: 스트리밍 결과를 내기 전에 오디오를 얼마나 버퍼링할지가 실제 선택의 관건이다. NVIDIA가 권장하는 가장 짧은 설정은 계산을 시작하기 전에 오디오를 0.32초 기다리며, 자체 정확도 표에서는 이 설정을 사용할 때의 비용도 보여 준다. 각 팀은 실제 녹음으로 전체 처리 파이프라인을 측정해야 한다.
모델이 반환하는 값
해당 모델 카드에는 16kHz 단일 채널 오디오를 사용한다고 명시한다. WAV와 FLAC, Opus, MP3 파일을 지원하며 NeMo 인터페이스는 파일 경로와 오디오 배열, 줄 단위 JSON 매니페스트를 받는다. 오디오 배열을 전달할 때는 올바른 샘플링 주파수도 diarize() 호출에 전달해야 한다. 청크 방식 추론의 경우 모델 카드에는 고정된 최대 녹음 길이가 없다.
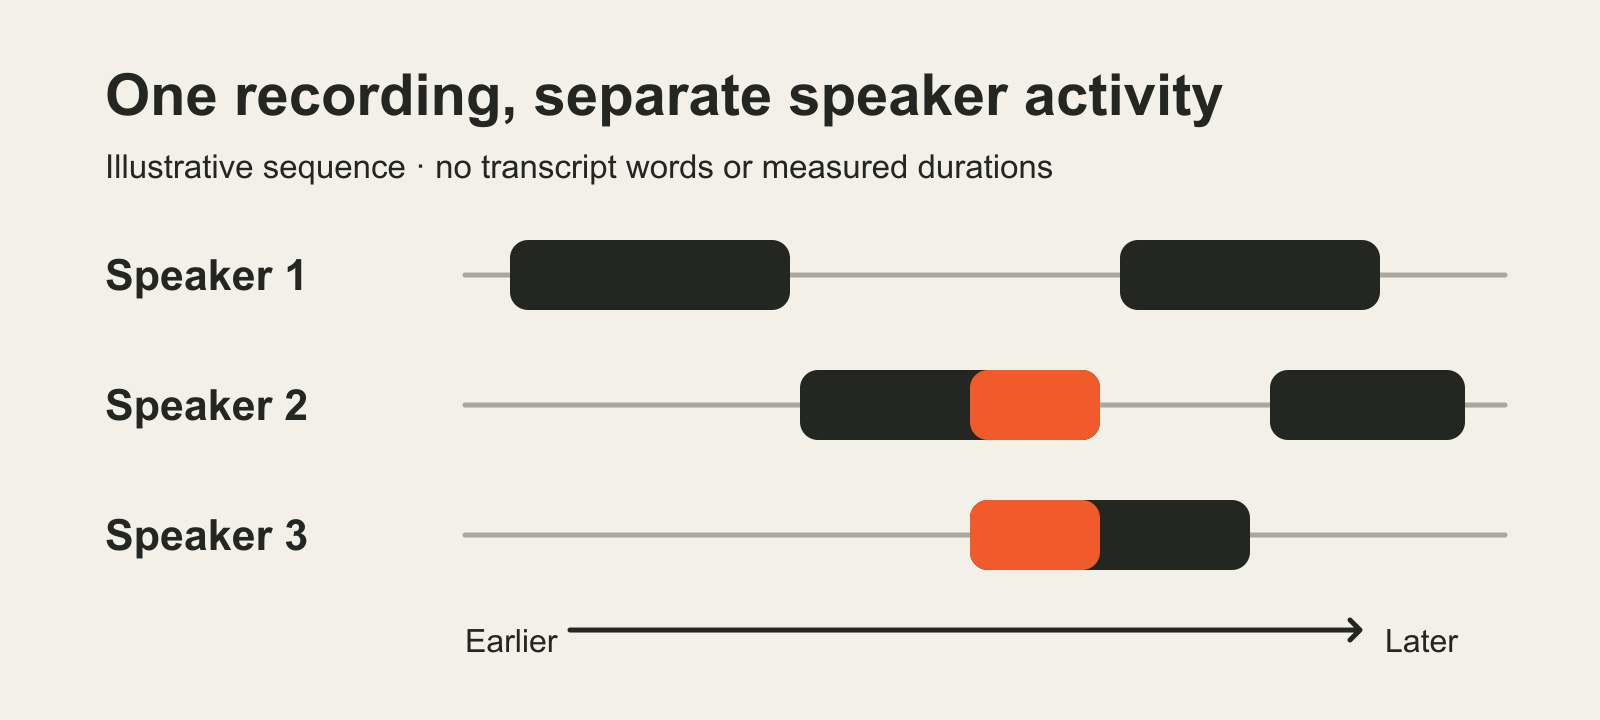
모델은 오디오를 [T, 8] 형태의 화자 활동 확률 텐서로 변환한다. 기본 출력 간격은 10밀리초다. 여러 사람이 겹쳐 말하면 복수 채널이 동시에 활성화될 수 있다. 후처리 과정에서 확률을 시작·종료 시점이 있는 구간과 일반 화자 표지로 바꾼다. 표지는 목소리가 처음 나타난 순서를 따르며 사람의 이름을 알려 주지는 않는다. 스트리밍 모델이 맥락을 유지할 수 있도록 NVIDIA는 이전 청크의 화자 캐시와 최근 프레임의 선입선출 큐를 사용한다.
화자 표지가 붙은 녹취록을 원하는 개발자에게 이 차이는 중요하다. NVIDIA의 통합 가이드는 화자 분리 타임스탬프를 별도 자동 음성 인식 결과와 결합한다. 예시에서 사용하는 중간 시점 규칙은 활성 화자가 없으면 단어를 누구에게도 배정하지 않고, 여러 화자가 동시에 활동하면 모호한 사례로 표시한다. 화자 분리 모델만으로는 겹쳐 말한 목소리 중 어느 쪽이 인식된 단어를 말했는지 판단할 수 없다.
버퍼링 시간은 응답 시간이 아니다
NVIDIA는 입력 버퍼 권장 설정으로 30.4초와 1.04초, 0.64초, 0.32초를 제시한다. 0.32초 설정은 처리 프레임 80밀리초 세 개와 오른쪽 맥락 프레임 80밀리초 하나로 구성된다. 모델 카드에서는 지연 시간을 명시적으로 정의해 추론 전에 보류하는 오디오의 길이라고 설명하며 계산 시간은 포함하지 않는다. 녹취 시스템에는 음성 인식과 전송, 응용 프로그램 처리 시간도 추가된다.
문서에 나온 NeMo 실행 경로에는 Python 3.12 이상과 Cython, 최신 PyTorch 버전, NeMo Speech가 필요하다. NVIDIA는 SortformerEncLabelModel.from_pretrained() 예시와 diarize() 호출을 제공한다. 이 호출은 화자 구간을 반환하며 확률 텐서를 포함하는 옵션도 있다. 모델 카드에 따르면 이 NeMo 호출로 호스팅된 체크포인트를 불러오려면 Hugging Face 토큰이 필요하다. Transformers 인터페이스를 오프라인과 스트리밍 방식으로 사용하는 법도 보여 주며, Transformers 소스 저장소에서 설치하는 방법과 함께 NeMo-Speech.cpp 명령줄 실행 경로도 제공한다. 이는 문서화된 인터페이스이며 BIG CHANGE가 직접 실행한 것은 아니다. 모델 카드는 NeMo 통합에 Linux와 NVIDIA Ampere, Hopper, Blackwell GPU 제품군을 제시한다. 특정 작업의 하드웨어 필요량과 처리 비용은 선택한 실행 경로와 기기에 따라 달라진다. NVIDIA는 모델 카드에서 시간당 운영 비용을 제시하지 않는다.
가중치는 OpenMDW 1.1 라이선스로 제공된다. 라이선스 조건에 따라 라이선스 사용료 없이 사용과 수정, 배포가 허용된다. 배포 시 라이선스와 해당되는 출처 고지를 유지해야 한다. 라이선스는 출력의 사용이나 공유를 제한하지 않으며, 오디오에 필요할 수 있는 권리와 동의를 확보할 책임은 사용자에게 둔다. NVIDIA는 이 모델을 상업적 및 비상업적 용도로 모두 사용할 수 있다고 설명한다.
NVIDIA의 측정 결과
NVIDIA의 모델 카드 평가에서는 Nemotron 3과 이전의 4화자 스트리밍 Sortformer v2.1을 비교한다. 전체 DIHARD III 평가 세트에서 NVIDIA는 입력 버퍼를 1.04초로 설정했을 때 Nemotron 3의 화자 분리 오류율이 13.18%라고 보고했다. 같은 버퍼 설정을 적용한 이전 모델의 수치는 19.60%다. 입력 버퍼를 0.32초로 줄이면 Nemotron 3의 결과는 13.55%다. 화자 분리 오류율은 누락된 발화와 오경보, 화자 혼동을 합산해 기준 화자 발화 시간으로 나눈 값이다. 낮을수록 좋다.
이 수치는 정해진 프로토콜에 따른 것이다. NVIDIA는 모든 평가에서 겹쳐 말하는 음성을 채점했다고 밝힌다. DIHARD III는 경계 여유를 0초로 사용하고 CALLHOME-Part2는 0.25초를 사용한다. AMI와 AliMeeting, NOTSOFAR1에서는 NVIDIA가 원래 구간 표지 대신 서로 연결하고 강제 정렬한 기준 주석을 사용한다. 표지를 바꾸면 점수도 달라진다. 해당 평가 지침은 비교 가능한 실행에 필요한 NeMo 스크립트와 기준 RTTM 파일, 겹침 설정, 경계 여유, 스트리밍 설정, 후처리 세부 사항을 명시한다. NVIDIA의 추론 속도 결과는 RTX PRO 5000에서 BF16을 사용해 측정했으며, torch.compile()를 사용한 경우와 사용하지 않은 경우가 모두 포함됐다. 이는 공급사가 보고한 시험 결과이지 BIG CHANGE가 직접 재현한 결과가 아니다.
화자 8명이라는 상한은 여전히 중요하다. DIHARD III에는 최대 9명의 화자로 주석 처리된 녹음도 있다. 모델 카드에 따르면 모델의 8개 채널을 넘는 발화는 누락되거나 다른 채널에 배정될 수 있다. AMI 테스트 녹음에서 NVIDIA는 Nemotron 3의 화자 분리 오류율이 이전 기준 모델보다 낮다고 보고하지만, 화자 수를 정확히 맞힌 비율은 더 낮다. 따라서 정확도는 오디오뿐 아니라 과제와 측정 방법에도 좌우된다. 이 모델을 통합할지 결정하려는 팀은 NVIDIA가 공개한 인터페이스를 출발점으로 삼아 용도와 비슷한 녹음에서 화자 및 단어를 포함한 전체 파이프라인을 시험할 수 있다.