NVIDIA প্রকাশ করেছে Nemotron 3 Diarization ২৩ সেপ্টেম্বর। প্রায় ১০ কোটি parameter-এর open-weight modelটি রেকর্ড করা বা সরাসরি আসা অডিওতে সর্বোচ্চ আটজন বক্তার কথা বলার সময় চিহ্নিত করে। কথোপকথনে কে কখন সক্রিয় ছিল এবং তার timestamp এটি developer-দের দেয়; শব্দসহ transcript বানাতে আলাদা speech recognition-ও দরকার।
মূল পরিবর্তন
- কী বদলেছে: NVIDIA-র আগের streaming Sortformer checkpoint সর্বোচ্চ চারজন বক্তাকে সমর্থন করত। এই সংস্করণে একটি checkpoint থেকেই আগমনের ক্রমে আটটি speaker channel পাওয়া যায়; সেটি রেকর্ড করা অডিও এবং আসা audio chunk—দুইভাবেই কাজ করে।
- কেন গুরুত্বপূর্ণ: meeting বা call-এর transcript তৈরি করা developer modelটি দিয়ে সময়ের অংশে সাধারণ speaker label বসাতে পারেন—একসঙ্গে একাধিক জন কথা বললেও। এরপর সেই অংশগুলো আলাদা recognizer-এর শনাক্ত করা শব্দের সঙ্গে জোড়া যায়। এই কাজে নথিভুক্ত speaker সীমা বেড়েছে।
- যা নজরে রাখা দরকার: প্রতিটি streaming ফল দেওয়ার আগে কতটা audio buffer করা হবে, সেটিই ব্যবহারিক সিদ্ধান্ত। NVIDIA-র প্রস্তাবিত সবচেয়ে কম সেটিংয়ে computation শুরুর আগে ০.৩২ সেকেন্ডের audio জমা হয়, আর তাদের নিজস্ব accuracy table-এ এই সেটিংয়ের বিনিময়মূল্য দেখা যায়। দলগুলোকে নিজেদের recording-এ সম্পূর্ণ pipeline-এর কার্যকারিতা মাপতে হবে।
model কী ফেরত দেয়
NVIDIA-র model card-এ ১৬ kHz, single-channel audio নির্দিষ্ট করা হয়েছে। এতে WAV, FLAC, Opus ও MP3 ফাইলের কথা আছে; NeMo interface-এ file path, audio array বা line-delimited JSON manifest দেওয়া যায়। audio array দিলে সঠিক sample rate-সহ diarize() call-এ পাঠাতে হয়। chunk ধরে inference করলে recording-এর নির্দিষ্ট সর্বোচ্চ দৈর্ঘ্য নেই বলে card-এ উল্লেখ আছে।
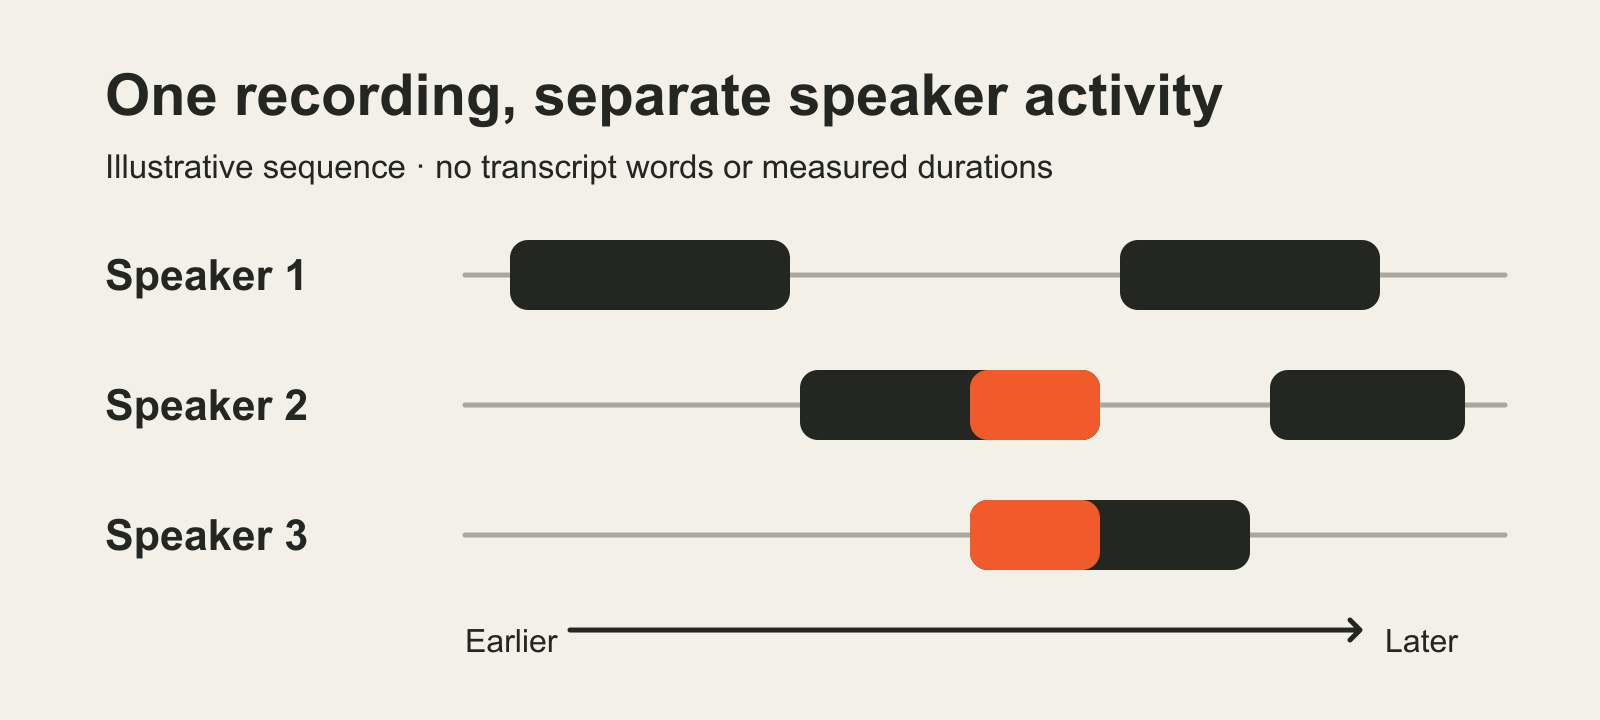
modelটি অডিওকে [T, 8] আকারের speaker activity probability tensor-এ রূপান্তর করে; default output step ১০ মিলিসেকেন্ড। মানুষ একসঙ্গে কথা বললে একাধিক channel একই সময়ে সক্রিয় থাকতে পারে। পরবর্তী ধাপে probability-গুলো থেকে শুরুর ও শেষের সময়সহ interval এবং সাধারণ speaker label তৈরি হয়। কণ্ঠ প্রথম যে ক্রমে আসে label-গুলো সেই ক্রম মেনে চলে; এগুলো বক্তার নাম জানায় না। আগের chunk মনে রাখতে NVIDIA speaker cache এবং সাম্প্রতিক frame-এর জন্য first-in, first-out queue ব্যবহার করে, যাতে streaming model প্রেক্ষাপট ধরে রাখতে পারে।
speaker label-সহ transcript দরকার এমন developer-এর জন্য এই পার্থক্য গুরুত্বপূর্ণ। NVIDIA-র integration guide আলাদা automatic speech recognition output-এর সঙ্গে diarization timestamp জোড়ে। তাদের উদাহরণের midpoint নিয়মে সক্রিয় speaker না থাকলে শব্দটি কোনো বক্তাকে দেওয়া হয় না; একাধিক speaker একই সময়ে সক্রিয় থাকলে ফল ambiguous চিহ্নিত হয়। overlapping কণ্ঠের মধ্যে কোনটি শনাক্ত শব্দটি বলেছে, diarization model একা তা স্থির করে না।
buffer করার সময় মানেই response time নয়
NVIDIA প্রস্তাবিত input-buffer হিসেবে ৩০.৪, ১.০৪, ০.৬৪ ও ০.৩২ সেকেন্ডের সেটিং দেয়। ০.৩২ সেকেন্ডের সেটিংয়ে তিনটি ৮০-মিলিসেকেন্ড processing frame এবং সামনের দিকের context হিসেবে আরও একটি ৮০-মিলিসেকেন্ড frame থাকে। card-এ latency-র সংজ্ঞা হলো inference-এর আগে ধরে রাখা audio; এতে computation-এর সময় ধরা হয় না। transcript system-এ recognition, data আদান-প্রদান ও application-এর সময়ও যোগ হবে।
নথিভুক্ত NeMo পদ্ধতিতে Python 3.12 বা পরবর্তী সংস্করণ, Cython, PyTorch-এর সাম্প্রতিক সংস্করণ ও NeMo Speech দরকার। NVIDIA-র উদাহরণে SortformerEncLabelModel.from_pretrained() ব্যবহার দেখানো হয়েছে; diarize() call থেকে speaker segment ফেরত আসে; probability tensor যোগ করার switch-ও আছে। NeMo call দিয়ে hosted checkpoint load করতে Hugging Face token লাগে বলে card-এ বলা আছে। Transformers interface-এ offline ও streaming ব্যবহারের পথও আছে; এটি install করতে Transformers source repository লাগে। পাশাপাশি NeMo-Speech.cpp command-line পদ্ধতি নথিভুক্ত। BIG CHANGE interface-গুলো চালিয়ে দেখেনি। NeMo integration-এর জন্য model card-এ Linux এবং NVIDIA Ampere, Hopper ও Blackwell GPU family তালিকাভুক্ত। নির্দিষ্ট workload-এর hardware দরকার ও processing cost বেছে নেওয়া পথ ও machine-এর ওপর নির্ভর করে; card-এ প্রতি ঘণ্টা চালানোর মূল্য নেই।
weight-গুলো OpenMDW 1.1 লাইসেন্সের অধীনে দেওয়া হয়েছে। শর্ত মেনে লাইসেন্স ফি ছাড়াই ব্যবহার, পরিবর্তন ও বিতরণ করা যায়। বিতরণের সময় লাইসেন্স ও প্রযোজ্য উৎস-সংক্রান্ত notice রাখতে হবে। তৈরি output ব্যবহার বা ভাগ করায় লাইসেন্স বাধা দেয় না; audio ব্যবহারের জন্য প্রয়োজনীয় অধিকার ও সম্মতি নিশ্চিত করার দায় ব্যবহারকারীর। NVIDIA modelটিকে বাণিজ্যিক ও অবাণিজ্যিক—দুই ধরনের ব্যবহারের জন্যই উপলভ্য বলে বর্ণনা করেছে।
NVIDIA কী মেপেছে
NVIDIA-র model card-এর মূল্যায়ন Nemotron 3-কে তাদের আগের চার-speaker streaming Sortformer v2.1-এর সঙ্গে তুলনা করে। সম্পূর্ণ DIHARD III evaluation set-এ ১.০৪-সেকেন্ড input-buffer setting-এ Nemotron 3-এর diarization error rate NVIDIA জানিয়েছে ১৩.১৮%; একই buffer setting-এ আগের model-এর ১৯.৬০%। ০.৩২ সেকেন্ডে Nemotron 3-এর ফল ১৩.৫৫%। diarization error rate-এ বাদ পড়া speech, ভুল alarm ও speaker গুলিয়ে ফেলার হার যোগ করে reference speaker time দিয়ে ভাগ করা হয়। কম ফল ভালো।
এই পরিসংখ্যান নির্দিষ্ট evaluation protocol-এর। NVIDIA বলেছে, তাদের সব পরীক্ষায় overlapping speech-ও score করা হয়েছে। DIHARD III-তে boundary collar শূন্য সেকেন্ড; CALLHOME-Part2-এ collar ০.২৫ সেকেন্ড। AMI, AliMeeting ও NOTSOFAR1-এর ক্ষেত্রে NVIDIA মূল segment label-এর বদলে পরস্পরের সঙ্গে মেলানো ও forced-aligned reference annotation ব্যবহার করে; label বদলালে score-ও বদলে যায়। তুলনাযোগ্য পরীক্ষা চালানোর জন্য reference RTTM file, overlap setting, collar, streaming setting ও postprocessing-এর বিবরণ দিতে evaluation নির্দেশিকায় NeMo script-এর প্রয়োজনীয়তা উল্লেখ করা হয়েছে। NVIDIA-র inference-speed পরীক্ষায় RTX PRO 5000-তে BF16 ব্যবহার করা হয়েছে, compilation চালু ও বন্ধ—দুই অবস্থায় torch.compile()। এগুলো বিক্রেতার প্রকাশিত পরীক্ষা, BIG CHANGE-এর পুনরাবৃত্তি নয়।
আটজন বক্তার সীমাটিও গুরুত্বপূর্ণ। DIHARD III-তে এমন কিছু recording আছে যেখানে সর্বোচ্চ নয়জন বক্তাকে চিহ্নিত করা হয়েছে; card বলেছে, model-এর আটটি channel-এর বাইরে থাকা কথা বাদ পড়তে পারে বা অন্য channel-এ পড়তে পারে। AMI test recording-এ NVIDIA জানায়, তাদের আগের baseline-এর তুলনায় Nemotron 3-এর diarization error কম, কিন্তু বক্তার সঠিক সংখ্যা শনাক্ত করার accuracy-ও কম। ফলে audio-র পাশাপাশি কাজ ও পরিমাপের ধরন অনুযায়ী accuracy বদলায়। modelটি যুক্ত করা উচিত কি না ভাবা দল NVIDIA-র প্রকাশিত interface দিয়ে শুরু করে নিজেদের ব্যবহারের মতো recording-এ বক্তা ও শব্দ মিলিয়ে সম্পূর্ণ pipeline পরীক্ষা করতে পারে।