NVIDIA выпустила Nemotron 3 Diarization 23 сентября. Модель с открытыми весами и примерно 100 млн параметров определяет моменты, когда говорит каждый из восьми собеседников, в записи или потоке. Она передает разработчикам сведения о речевой активности и временные метки разговора; чтобы получить текст произнесенных слов, требуется отдельная система распознавания речи.
Главное изменение
- Что изменилось: Предыдущая потоковая версия Sortformer от NVIDIA поддерживала четырех собеседников. В новом выпуске доступны восемь каналов, назначаемых по порядку появления голосов; один и тот же чекпойнт работает как с записью, так и с входящими фрагментами.
- Почему это важно: Разработчик системы расшифровки встреч или звонков может использовать модель, чтобы присвоить временным интервалам общие метки собеседников, в том числе при одновременной речи, а затем объединить их со словами, распознанными отдельной системой. Выпуск расширяет заявленный предел числа голосов для этой задачи.
- На что обратить внимание: На практике нужно выбрать, сколько аудио накапливать до каждого результата потока. Минимальный рекомендуемый интервал NVIDIA — 0,32 секунды до начала вычисления; в собственных таблицах точности компании показана цена использования этой настройки. Командам все равно нужно измерить полный конвейер на своих записях.
Что возвращает модель
В карточке модели указано, что на вход подается монофоническое аудио с частотой 16 кГц. Поддерживаются файлы WAV, FLAC, Opus и MP3; интерфейс NeMo принимает пути к файлам, массивы аудиоданных или манифест в построчном формате JSON. Для массивов аудиоданных необходимо передать правильную частоту дискретизации в вызов diarize(). В карточке для обработки фрагментами не установлен максимальный предел продолжительности записи.
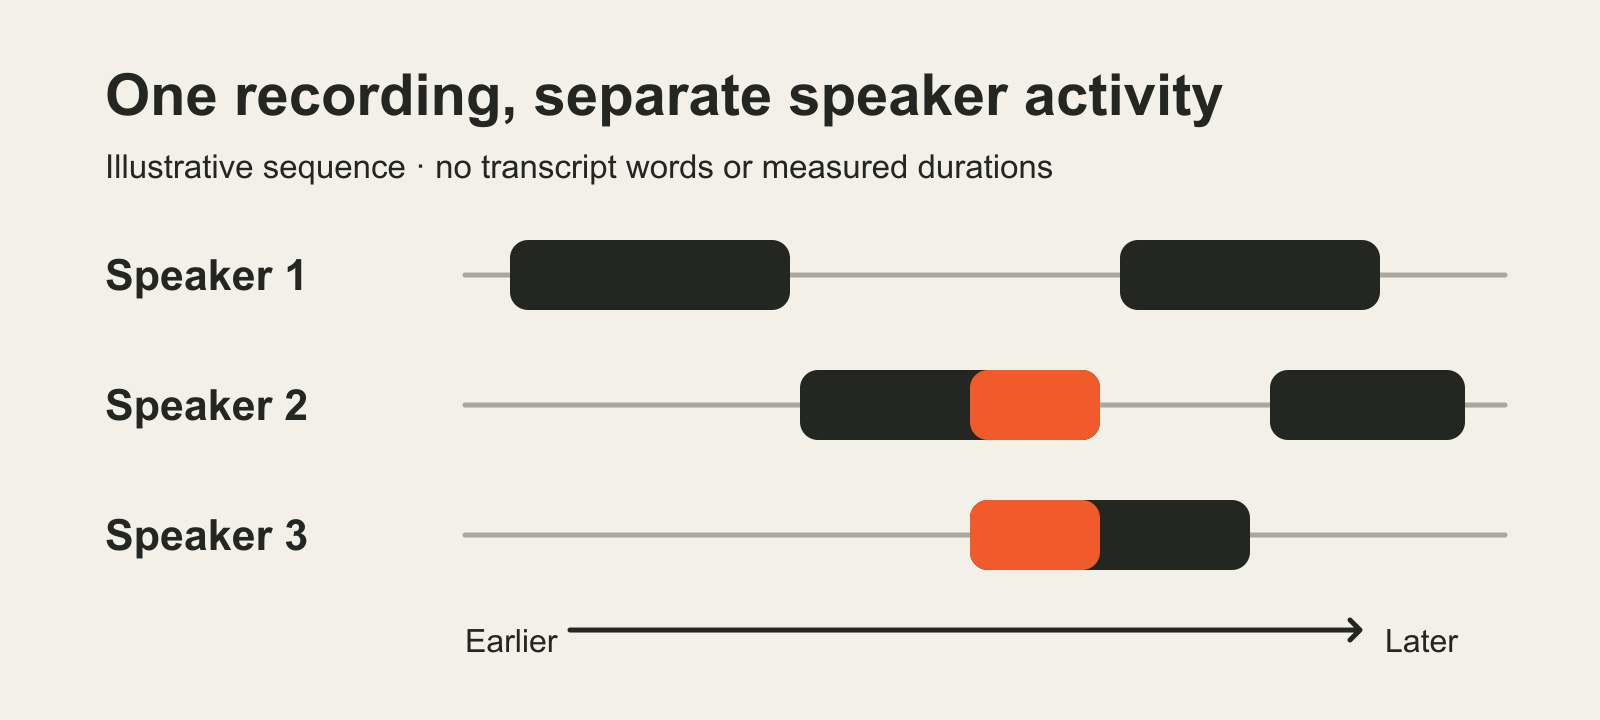
Модель преобразует аудио в [T, 8] тензор вероятностей активности собеседников с шагом вывода по умолчанию 10 миллисекунд. При одновременной речи могут быть активны несколько каналов. Постобработка преобразует вероятности в интервалы с начальным и конечным временем и общими метками собеседников. Метки назначаются в порядке первого появления голосов и не идентифицируют людей по именам. Для хранения контекста потоковая модель использует кэш собеседников для предыдущих фрагментов и очередь недавних кадров по принципу «первым пришел — первым вышел».
Для разработчика, которому нужна расшифровка с указанием собеседников, это различие существенно. В руководстве NVIDIA по интеграции временные метки диаризации объединяются с результатом отдельной системы автоматического распознавания речи. В примере используется правило середины интервала: если в этот момент никто не говорит, слово остается без метки; если говорят одновременно несколько человек, результат помечается как неоднозначный. Сама модель диаризации не определяет, какой голос произнес распознанное слово при наложении речи.
Время буферизации — не время ответа
NVIDIA приводит рекомендуемые настройки буфера ввода: 30,4, 1,04, 0,64 и 0,32 секунды. Настройка 0,32 секунды состоит из трех кадров обработки по 80 миллисекунд и одного кадра правого контекста той же длительности. В карточке прямо указано определение задержки как времени, в течение которого аудио удерживается до обработки; вычислительное время в него не входит. Система расшифровки также добавит время распознавания речи, передачи данных и работы приложения.
Для документированного пути NeMo необходимы Python 3.12 или новее, Cython, современная версия PyTorch и NeMo Speech. NVIDIA приводит SortformerEncLabelModel.from_pretrained() пример, diarize() вызов, возвращающий сегменты речи разных собеседников, и переключатель для включения тензоров вероятности. В карточке сказано, что для загрузки размещенного чекпойнта через этот вызов NeMo нужен токен Hugging Face. Также описаны интерфейсы Transformers для автономной и потоковой работы с установкой из исходного репозитория Transformers, а еще маршрут командной строки NeMo-Speech.cpp. Это документированные интерфейсы; BIG CHANGE их не запускал. В карточке модели для интеграции с NeMo указаны Linux и семейства графических процессоров NVIDIA Ampere, Hopper и Blackwell. Требования к оборудованию и стоимость обработки конкретной нагрузки зависят от выбранного пути и машины; цена эксплуатации за час в карточке не приводится.
Веса распространяются по лицензии OpenMDW 1.1. Она разрешает использовать, изменять и распространять материалы без лицензионной платы, при соблюдении ее условий. При распространении необходимо сохранять текст лицензии и применимые уведомления об источнике. Лицензия не ограничивает использование или распространение результатов генерации и возлагает на пользователей ответственность за получение необходимых прав и согласий на аудио. NVIDIA указывает, что модель можно применять в коммерческих и некоммерческих целях.
Что измерила NVIDIA
В оценке в карточке модели Nemotron 3 сравнивается с предыдущей потоковой версией Sortformer v2.1, поддерживающей четырех собеседников. На полном наборе проверки DIHARD III NVIDIA сообщает о показателе ошибки диаризации 13,18% для Nemotron 3 при буфере ввода 1,04 секунды против 19,60% у предыдущей модели при той же заявленной настройке. При 0,32 секунды показатель Nemotron 3 равен 13,55%. Ошибка диаризации включает пропущенную речь, ложные срабатывания и путаницу собеседников, деленные на эталонное время речи. Меньшее значение лучше.
Эти цифры получены по конкретным протоколам. NVIDIA сообщает, что во всех тестах учитывалась речь собеседников, накладывающаяся по времени. В DIHARD III используется нулевой временной допуск по границе сегмента, а в CALLHOME-Part2 — 0,25 секунды. Для AMI, AliMeeting и NOTSOFAR1 NVIDIA использует связанные эталонные разметки, принудительно выровненные по времени, вместо исходных меток сегментов; изменение разметки меняет оценки. В инструкциях по оценке указаны скрипт NeMo и необходимость сообщить файл эталонной разметки RTTM, настройки наложения речи и допуска, параметры потока и постобработки для сопоставимого запуска. Скорость вывода NVIDIA измеряла в BF16 на RTX PRO 5000, с дополнительной настройкой и без нее torch.compile(). Это испытания производителя, а не независимое воспроизведение BIG CHANGE.
Ограничение в восемь собеседников по-прежнему существенно. В DIHARD III есть записи, размеченные для числа участников до девяти; согласно карточке, речь сверх восьми каналов модели может быть пропущена или отнесена к другому каналу. На тестовых записях AMI NVIDIA сообщает о меньшей ошибке диаризации Nemotron 3 по сравнению с прежней моделью, но более низкой точности определения точного числа собеседников. Таким образом, точность зависит от задачи, выбранного показателя и аудио. Команда, решающая, интегрировать ли модель, может начать с опубликованных интерфейсов NVIDIA и проверить полный конвейер «собеседник — слово» на записях, похожих на те, для которых он предназначен.