Inilabas ng NVIDIA ang Nemotron 3 Diarization noong Setyembre 23. Minamarkahan ng open-weight na modelong may humigit-kumulang 100 milyong parameter kung kailan nagsasalita ang bawat isa sa hanggang walong tagapagsalita sa nirekord o live na audio. Nagbibigay ito sa mga developer ng aktibidad ng tagapagsalita at timestamp sa usapan; kailangan din ng speech recognition upang makagawa ng transcript na may mga salita.
Ang malaking pagbabago
- Ano ang nagbago:Apat na tagapagsalita ang sinusuportahan ng naunang streaming Sortformer checkpoint ng NVIDIA. Nagbibigay ang release na ito ng walong channel ng tagapagsalita ayon sa pagkakasunod ng pagsasalita mula sa iisang checkpoint na gumagana kapwa sa nirekord na audio at dumarating na mga chunk.
- Bakit mahalaga:Maaaring gumamit ang developer ng transcription para sa pulong o tawag sa modelo upang magtalaga ng pangkalahatang label sa mga tagapagsalita sa pagitan ng oras, kabilang ang sabayang pagsasalita, at saka itugma ang mga pagitan sa mga salitang mula sa hiwalay na recognizer. Pinalalawak ng release ang dokumentadong hangganan sa bilang ng tagapagsalita para sa gawaing iyon.
- Ano ang dapat bantayan:Ang praktikal na pasya ay kung gaano karaming audio ang iipunin bago maglabas ng bawat resulta ng streaming. Naghihintay muna ng 0.32 segundo ng audio bago magsimula ang pag-compute sa pinakamaikling inirerekomendang setting ng NVIDIA, at ipinakikita ng sarili nitong mga talahanayan ng katumpakan ang kapalit ng setting na iyon. Kailangan pa ring sukatin ng mga pangkat ang buong pipeline sa sarili nilang mga rekording.
Ano ang ibinabalik ng modelo
Tinutukoy sa model card Kailangang ipasa ang tamang sample rate sa diarize() na tawag. Walang itinakdang pinakamahabang tagal ng rekording sa card para sa inference na hinati sa mga chunk.
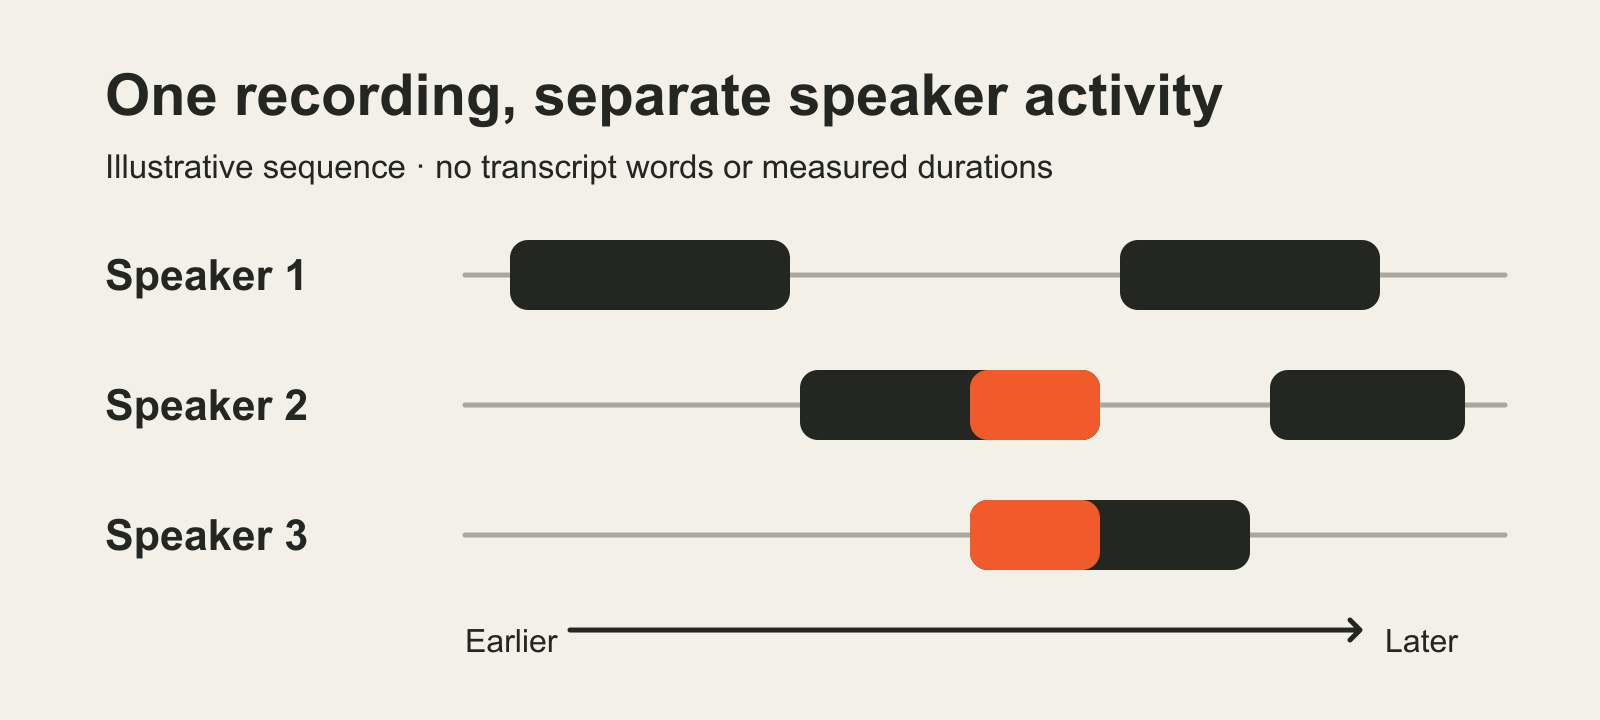
Ginagawang [T, 8] ng posibilidad ng aktibidad ng tagapagsalita, na may default na hakbang sa output na 10 millisecond. Maaaring sabay na aktibo ang maraming channel kapag nagsasapawan ang pagsasalita. Ginagawang mga pagitan na may oras ng pagsisimula at pagtatapos at pangkalahatang label ng tagapagsalita ang mga posibilidad sa postprocessing. Ayon sa pagkakasunod ng unang paglitaw ng boses ang mga label; hindi nito tinutukoy ang pangalan ng tao. Gumagamit ang NVIDIA ng speaker cache para sa mga naunang chunk at FIFO queue para sa kamakailang mga frame upang mapanatili ng streaming model ang konteksto.
Mahalaga ang pagkakaibang ito para sa developer na nangangailangan ng transcript na may label ng tagapagsalita. Itinatapat ng gabay sa integrasyon ng NVIDIA ang mga timestamp ng diarization sa output ng hiwalay na automatic speech recognition. Hindi inaatasan ng halimbawa nitong tuntunin sa gitna ng pagitan ang salitang walang aktibong tagapagsalita at nilalagyan ng markang malabo ang sabayang aktibidad. Hindi kayang tukuyin ng modelong diarization lamang kung aling nagsasapawang boses ang nagsabi ng kinilalang salita.
Hindi oras ng pagtugon ang oras ng buffering
Inililista ng NVIDIA ang mga inirerekomendang setting ng input buffer na 30.4, 1.04, 0.64 at 0.32 segundo. Binubuo ang setting na 0.32 segundo ng tatlong 80-millisecond na processing frame at isang 80-millisecond na frame para sa karagdagang konteksto. Tahasang itinatakda sa card ang latency bilang oras na hinahawakan ang audio bago ang inference; hindi kasama rito ang pag-compute. Magdaragdag din ng oras ang recognition, paglilipat ng datos at aplikasyon sa isang sistema ng transcript.
Kailangan ng dokumentadong paraan gamit ang NeMo ang Python 3.12 pataas, Cython, bagong bersiyon ng PyTorch at NeMo Speech. Nagbibigay ang NVIDIA ng SortformerEncLabelModel.from_pretrained() halimbawa, isang diarize() tawag na nagbabalik ng mga segment ng tagapagsalita, at switch upang isama ang mga tensor ng posibilidad. Sinasabi sa card na kailangan ng Hugging Face token upang i-load sa tawag na NeMo ang checkpoint na nasa host. Ipinakikita rin dito ang offline at streaming na interface ng Transformers, na ini-install mula sa source repository ng Transformers, pati ang command-line na paraan ng NeMo-Speech.cpp. Mga dokumentadong interface ang mga ito; hindi pinatakbo ng BIG CHANGE ang mga ito. Nakalista sa model card ang Linux at mga GPU ng NVIDIA na Ampere, Hopper at Blackwell para sa integrasyon nito sa NeMo. Nakasalalay sa piniling paraan at makina ang pangangailangan sa hardware at gastos sa pagproseso ng partikular na gawain; walang ibinigay ang NVIDIA na presyong kada oras ng operasyon sa card.
Iniaalok ang mga timbang sa ilalim ng lisensiyang OpenMDW 1.1. Pinahihintulutan ng lisensiya ang paggamit, pagbabago at pamamahagi nang walang bayad sa lisensiya, alinsunod sa mga tuntunin nito. Kailangang panatilihin sa pamamahagi ang lisensiya at naaangkop na abiso tungkol sa pinagmulan. Hindi nito nililimitahan ang paggamit o pagbabahagi ng output at inaatasan nito ang mga gumagamit na tiyakin ang anumang karapatang-ari at pahintulot na maaaring kailanganin para sa kanilang audio. Inilalarawan ng NVIDIA na maaari itong gamitin sa komersiyal at di-komersiyal na layunin.
Ano ang sinukat ng NVIDIA
Inihahambing sa pagsusuri sa model card ng NVIDIA ang Nemotron 3 sa nauna nitong four-speaker streaming Sortformer v2.1. Sa buong evaluation set ng DIHARD III, nag-ulat ang NVIDIA ng diarization error rate na 13.18% para sa Nemotron 3 sa setting na 1.04 segundong input buffer, kumpara sa 19.60% para sa naunang modelo sa parehong nakasaad na setting. 13.55% ang resulta ng Nemotron 3 sa 0.32 segundo. Pinagsasama ng diarization error rate ang hindi natukoy na pagsasalita, maling alarma at pagkalito sa tagapagsalita, at hinahati ito sa oras ng sangguniang pagsasalita. Mas mababa ang mas mahusay.
Nakabatay ang mga bilang na iyon sa tinukoy na protocol. Ayon sa NVIDIA, isinasaalang-alang ng lahat ng pagsusuri nito ang nagsasapawang pagsasalita. Gumagamit ang DIHARD III ng zero-second na pagitan sa hangganan, samantalang 0.25 segundo ang gamit ng CALLHOME-Part2. Para sa AMI, AliMeeting at NOTSOFAR1, gumagamit ang NVIDIA ng magkakaugnay at sapilitang itinapat na anotasyon ng sanggunian sa halip na orihinal na mga label ng segment; nagbabago ang mga marka kapag binago ang mga label na ito. Tinutukoy sa mga tagubilin sa pagsusuri ang NeMo script at hinihingi ang reference RTTM file, setting ng overlap, pagitan, setting ng streaming at detalye ng postprocessing upang maihambing ang resulta. Sinukat ng NVIDIA ang bilis ng inference gamit ang BF16 sa RTX PRO 5000, may torch.compile() at wala nito. Mga pagsubok na iniulat ng vendor ang mga ito, hindi muling pagsubok ng BIG CHANGE.
Mahalaga pa rin ang hangganang walong tagapagsalita. May ilang rekording sa DIHARD III na nilagyan ng anotasyon para sa hanggang siyam na tagapagsalita, at sinasabi sa card na maaaring hindi matukoy o mailagay sa ibang channel ang pagsasalita na lampas sa walong channel ng modelo. Sa mga test recording ng AMI, nag-uulat ang NVIDIA ng mas mababang diarization error para sa Nemotron 3 kaysa sa nauna nitong baseline, ngunit mas mababa ang katumpakan nito sa eksaktong bilang ng mga tagapagsalita. Kaya nakasalalay ang katumpakan sa gawain at panukat, gayundin sa audio. Maaaring magsimula ang pangkat na nag-iisip kung isasama ang modelo sa mga inilathalang interface ng NVIDIA, pagkatapos ay subukan ang buong pipeline ng tagapagsalita at salita sa mga rekording na kahawig ng nilalayong gamit.