NVIDIAは9月23日にNemotron 3 Diarizationを公開した。オープンウェイトの約1億パラメーターのモデルで、録音音声やストリーミング音声について、最大8人の話者がいつ発話したかを示す。会話の話者とタイムスタンプを開発者に提供するが、単語を含む文字起こしを作成するには、別の音声認識も必要になる。
大きな変化
- 変わったこと:以前のNVIDIA製ストリーミングSortformerチェックポイントは4人の話者に対応していた。今回のリリースでは、録音音声と入力チャンクの両方で動作する1つのチェックポイントから、到着順に並んだ8人分の話者チャンネルを出力する。
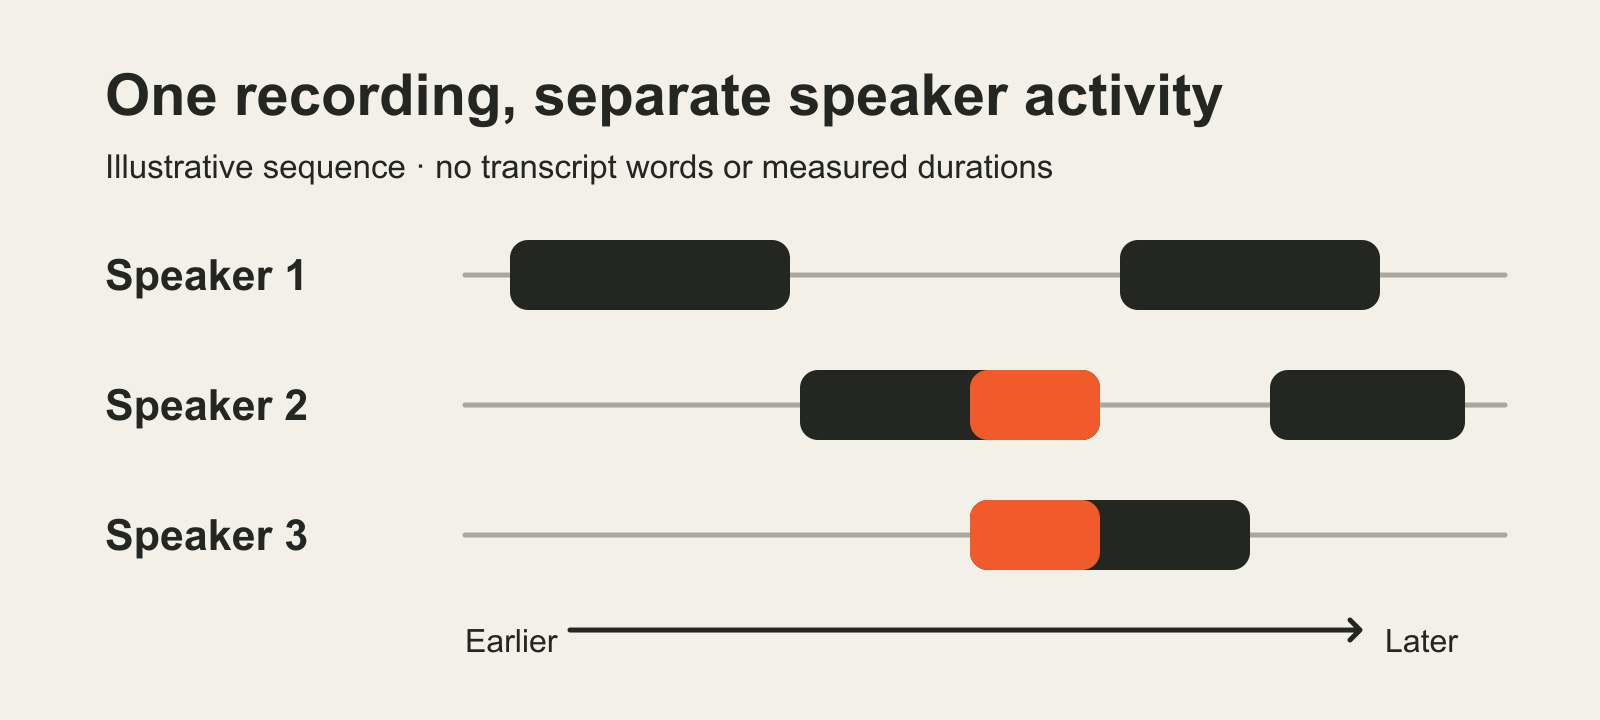
- なぜ重要か:会議や通話の文字起こしを開発する場合、このモデルで時間区間ごとに汎用的な話者ラベルを割り当てられる。発話の重なりにも対応し、その区間を別の音声認識モデルが出力した単語と組み合わせられる。このタスクで公表された話者数の上限が広がった。
- 今後の注目点:実運用では、ストリーミング結果ごとにどれだけの音声をバッファーにためるかが選択のポイントになる。NVIDIAが推奨する最短設定では、計算を始める前に0.32秒分の音声を待つ。同社自身の精度表は、この設定に精度面の代償があることを示している。各チームは、自分たちの録音でパイプライン全体を測定する必要がある。
モデルが返すもの
仕様はモデルカードが定めており、サンプリング周波数16 kHzのモノラル音声を指定する。WAV、FLAC、Opus、MP3のファイルに対応し、NeMoのインターフェースではファイルパス、音声配列、または行区切りJSON形式のマニフェストを受け付ける。音声配列には、正しいサンプリング周波数も渡してdiarize()を呼び出す必要がある。カードには、チャンク単位の推論について録音時間の固定上限は記載されていない。
モデルは音声を[T, 8]形状の話者発話確率テンソルに変換し、既定の出力間隔は10ミリ秒となる。複数人が重なって話すと、複数のチャンネルが同時に有効になることがある。後処理では、確率を開始・終了時刻と汎用的な話者ラベルを持つ区間に変換する。ラベルは声が最初に現れた順に付けられ、実在の人物名を示すものではない。ストリーミングモデルが文脈を維持できるよう、NVIDIAは過去のチャンク用に話者キャッシュを使い、直近のフレームには先入れ先出しのキューを使う。
話者ラベル付きの文字起こしを必要とする開発者にとって、この違いは重要だ。NVIDIAの統合ガイドでは、話者ダイアライゼーションのタイムスタンプを別の自動音声認識の出力と組み合わせる。サンプルの中点判定ルールでは、話者が発話していない区間の単語は話者に割り当てず、複数人が同時に話していれば曖昧とする。ダイアライゼーションモデル単体では、重なった音声のどの話者が認識された単語を発したかまでは判断できない。
バッファー時間は応答時間ではない
NVIDIAは入力バッファーの推奨設定を30.4秒、1.04秒、0.64秒、0.32秒としている。0.32秒の設定は、80ミリ秒の処理フレーム3つと、先読み用の80ミリ秒フレーム1つで構成される。カードはレイテンシーを明示的に定義しているが、これは推論前に音声を保持する時間であり、計算時間は含まない。文字起こしシステムでは、音声認識、通信、アプリケーションの処理時間も加わる。
文書に記載されたNeMoの手順では、Python 3.12以降、Cython、近年のPyTorch、NeMo Speechが必要だ。NVIDIAはSortformerEncLabelModel.from_pretrained()を使う例と、diarize()で話者区間を返す呼び出しと、確率テンソルを含める切り替え方法を提示している。カードによると、このNeMo呼び出しでホストされたチェックポイントを読み込むにはHugging Faceのトークンが必要だ。また、Transformersのオフライン版とストリーミング版のインターフェースも紹介し、Transformersのソースリポジトリからインストールするよう記している。さらに、NeMo-Speech.cppのコマンドライン手順も示されている。いずれも文書に記載されたインターフェースであり、BIG CHANGEは実行していない。モデルカードでは、NeMo統合にLinuxとNVIDIA Ampere、Hopper、Blackwell世代のGPUを挙げている。特定の作業負荷に必要なハードウェアや処理コストは、選ぶ手順とマシンによって異なる。カードには1時間当たりの運用価格は記載されていない。
重みはOpenMDW 1.1ライセンスで提供される。同ライセンスは、条件に従った使用、変更、再配布をライセンス料なしで認めている。配布時にはライセンスと該当する出所表示を保持する必要がある。生成物の使用や共有は制限せず、音声について必要となる権利や同意の確保は利用者の責任としている。NVIDIAは商用・非商用の両方で利用可能だと説明している。
NVIDIAが測定した内容
NVIDIAのモデルカードに掲載された評価では、Nemotron 3と、以前の4話者対応ストリーミングモデルSortformer v2.1を比較している。DIHARD IIIの評価セット全体で、入力バッファーを1.04秒に設定したNemotron 3の話者ダイアライゼーション誤り率は13.18%と報告されている。同じバッファー設定での旧モデルは19.60%だった。0.32秒設定でのNemotron 3の結果は13.55%だ。話者ダイアライゼーション誤り率は、発話の見落とし、誤検出、話者の混同を合算し、正解の話者発話時間で割った指標だ。低いほどよい。
これらの数値は、条件を定めた評価プロトコルに基づく。NVIDIAによると、すべての評価で重なった発話を採点している。DIHARD IIIでは境界許容幅を0秒、CALLHOME-Part2では0.25秒としている。AMI、AliMeeting、NOTSOFAR1では元の区間ラベルではなく、対応付けられ強制アラインメントされた参照注釈を使用している。ラベルを変えればスコアも変わる。評価手順書にはNeMoのスクリプトが示され、比較可能な実行には参照RTTMファイル、重複発話の設定、境界許容幅、ストリーミング設定、後処理の詳細が必要と記されている。NVIDIAによる推論速度の結果はRTX PRO 5000上でBF16を用い、torch.compile()を有効にした場合としない場合を比較している。これらはベンダーが報告したテストであり、BIG CHANGEが再現した結果ではない。
8人という上限も重要だ。DIHARD IIIには最大9人の話者が注釈された録音が含まれ、モデルカードによると、8チャンネルを超える発話は見落とされたり、別のチャンネルに割り当てられたりする可能性がある。AMIのテスト録音では、NVIDIAはNemotron 3のダイアライゼーション誤り率が旧モデルより低い一方、話者数を正確に当てる率は低いと報告している。精度は音声だけでなく、タスクと測定方法にも左右される。導入を検討するチームは、NVIDIAが公開するインターフェースを出発点に、想定用途に近い録音で話者識別と単語認識を組み合わせた全工程をテストできる。