NVIDIA 於 9 月 23 日推出Nemotron 3 說話者分離模型。這款約有 1 億參數的開放權重模型,可標示最多八位說話者在錄音或串流音訊中的發言時段。它會提供對話中各說話者的活動資訊與時間戳記;若要產生包含文字內容的逐字稿,還需要另外使用語音辨識模型。
核心變化
- 有哪些改變:NVIDIA 先前的 Sortformer 串流檢查點最多支援四位說話者。這次發布的模型則透過同一個檢查點提供依聲音出現順序排列的八個說話者通道,並可處理錄音檔與即時輸入的音訊區塊。
- 為何重要:開發會議或通話逐字稿服務的人,可用此模型將時間區間標記為通用說話者代號,也涵蓋多人同時發言的情況;接著再把這些區間與另一個語音辨識模型產生的文字結合。這次發布提高了該任務公開規格中的說話者人數上限。
- 後續觀察重點:實際使用時,開發者必須決定每次產生串流結果前要緩衝多少音訊。NVIDIA 建議的最短設定是在開始運算前等待 0.32 秒音訊;其自家準確度表也顯示,採用這項設定會付出一定代價。團隊仍須使用符合實際情境的錄音,測試完整處理流程。
模型會輸出什麼
這份模型卡指定音訊格式為 16 kHz、單聲道,並列出 WAV、FLAC、Opus 及 MP3 檔案格式。NeMo 介面可接受檔案路徑、音訊陣列,或以逐行分隔的 JSON 清單提供資料。使用音訊陣列時,必須在diarize()呼叫時須傳入正確的取樣率。模型卡未為分塊推論設定固定的最長錄音時間。
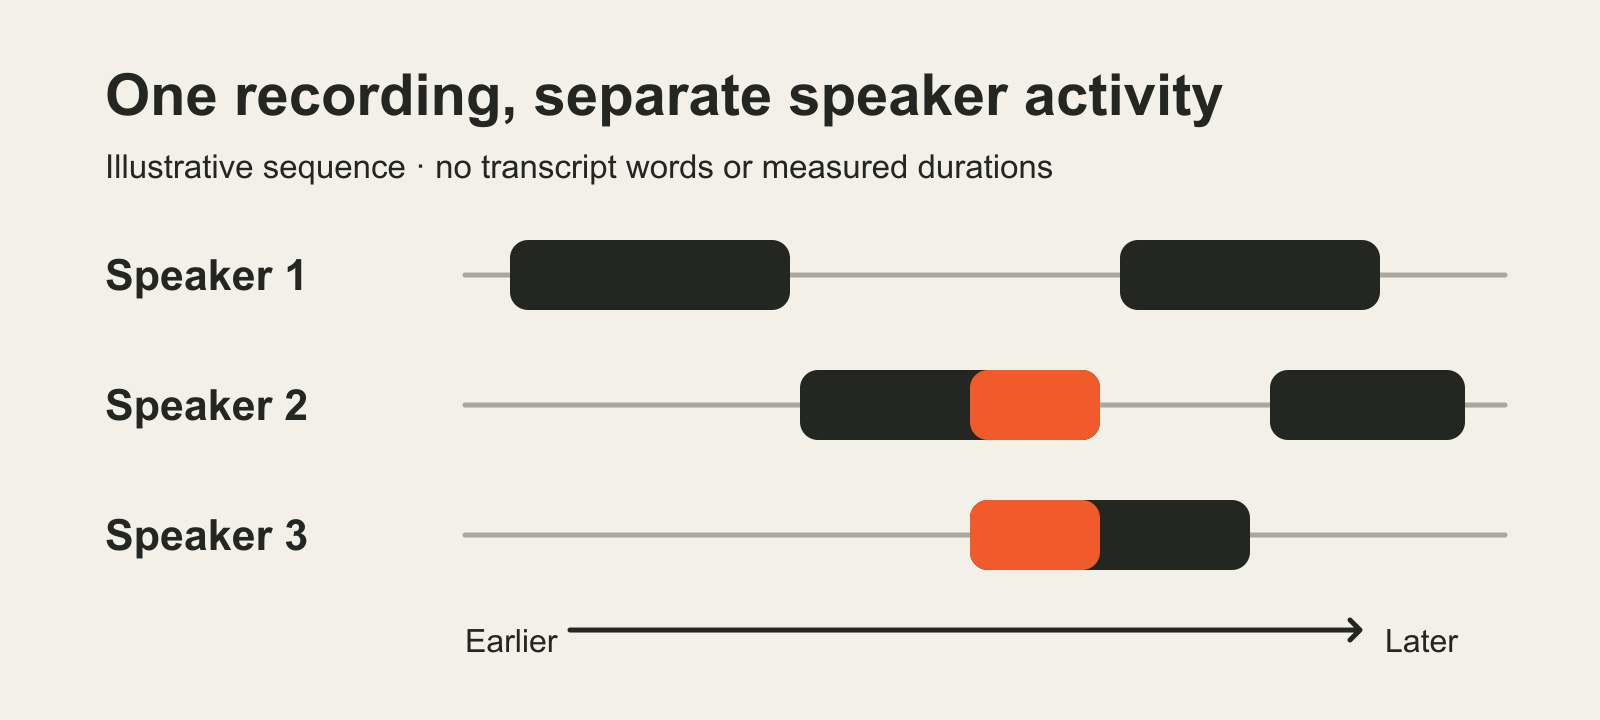
模型會將音訊轉換為[T, 8]說話者活動機率張量,預設輸出步長為 10 毫秒。多人重疊發言時,多個通道可同時啟用。後處理會將機率轉成含起訖時間的區間,並附上通用說話者代號。代號依聲音首次出現的順序排列,不能辨識說話者的真實姓名。NVIDIA 使用說話者快取保留較早區塊的資訊,並以先進先出佇列保存近期影格,讓串流模型得以延續上下文。
對需要產生含說話者標記逐字稿的開發者來說,這項區分很關鍵。NVIDIA 的整合指南會將說話者分離的時間戳記與另一個自動語音辨識系統的輸出結合。指南中的範例採用時間中點比對規則:若當下沒有啟用中的說話者,就不指派該詞;若多個說話者同時發言,則標為不明確。說話者分離模型本身不會判定辨識出的詞是由哪一個重疊發言者說出。
緩衝時間不等於回應時間
NVIDIA 列出的建議輸入緩衝設定為 30.4、1.04、0.64 與 0.32 秒。0.32 秒設定由三個 80 毫秒處理影格,以及一個 80 毫秒的右側上下文影格組成。模型卡片明確將延遲定義為推論前保留音訊的時間,不包括運算時間。逐字稿系統還會增加語音辨識、傳輸及應用程式處理時間。
文件記載的 NeMo 流程需要 Python 3.12 或更新版本、Cython、近期版本的 PyTorch,以及 NeMo Speech。NVIDIA 提供SortformerEncLabelModel.from_pretrained()範例,以及一個diarize()會回傳說話者片段的呼叫,並可選擇輸出機率張量。模型卡指出,透過該 NeMo 呼叫載入託管檢查點需要 Hugging Face 權杖。文件也提供離線與串流 Transformers 介面,並要求從 Transformers 原始碼儲存庫安裝;另外還有NeMo-Speech.cpp 命令列方式。以上都是文件記載的介面;BIG CHANGE 並未實際執行。模型卡列出 NeMo 整合所需的 Linux 環境,以及 NVIDIA Ampere、Hopper 或 Blackwell GPU。特定工作負載的硬體需求與處理成本,取決於所選流程及機器;模型卡未提供每小時運算價格。
模型權重採用OpenMDW 1.1授權。依授權條款,使用者可免費使用、修改及散布模型,但散布時須保留授權及適用的來源聲明。授權不限制使用或分享模型輸出,並由使用者負責確認音訊所需的權利與同意。NVIDIA 表示,模型可供商業及非商業用途使用。
NVIDIA 測量了什麼
NVIDIA 的模型卡評估將 Nemotron 3 與先前支援四位說話者的串流模型 Sortformer v2.1 比較。在完整 DIHARD III 評估集上,NVIDIA 報告 Nemotron 3 使用 1.04 秒輸入緩衝時,說話者分離錯誤率為 13.18%;先前模型使用同一緩衝設定時為 19.60%。Nemotron 3 在 0.32 秒設定下的結果為 13.55%。說話者分離錯誤率將漏失語音、誤報及說話者混淆時間相加,再除以參考說話者總時長;數值越低越好。
這些數據只適用於特定評估規範。NVIDIA 表示,所有評估都計入重疊語音。DIHARD III 使用零秒邊界容差,CALLHOME-Part2 則使用 0.25 秒容差。在 AMI、AliMeeting 與 NOTSOFAR1 資料集上,NVIDIA 使用經連結並強制對齊的參考標註,而非原始片段標籤;更換標籤也會改變分數。評估說明列出 NeMo 指令碼,並要求提供參考 RTTM 檔、重疊語音設定、邊界容差、串流設定及後處理細節,才能進行可比較的測試。NVIDIA 的推論速度測試以 BF16 在 RTX PRO 5000 上執行,並比較兩種設定下的結果torch.compile()。這些是廠商自行報告的測試結果,並非 BIG CHANGE 重現的結果。
八位說話者的人數上限仍然重要。DIHARD III 部分錄音標註多達九位說話者;模型卡指出,超過八個通道可處理範圍的語音可能會漏掉,或被分配至其他通道。在 AMI 測試錄音上,NVIDIA 報告 Nemotron 3 的說話者分離錯誤率低於舊版基準模型,但精確判斷說話者人數的準確率較低。因此,準確度會因任務、衡量指標及音訊內容而異。要決定是否整合此模型,團隊可先參考 NVIDIA 公布的介面,再用符合預定用途的錄音測試整套說話者與文字處理流程。