NVIDIA merilis Nemotron 3 Diarization pada 23 September. Model berbobot terbuka berukuran sekitar 100 juta parameter ini menandai kapan hingga delapan pembicara berbicara, baik dalam audio rekaman maupun streaming. Model ini memberi pengembang informasi aktivitas pembicara dan cap waktu percakapan; untuk menghasilkan transkrip berisi kata-kata, tetap diperlukan pengenal ucapan.
Perubahan besar
- Yang berubah: Checkpoint Sortformer streaming NVIDIA sebelumnya mendukung empat pembicara. Rilis ini menawarkan delapan kanal pembicara yang diurutkan berdasarkan kemunculan, dari satu checkpoint yang bekerja dengan audio rekaman maupun potongan audio yang masuk.
- Mengapa ini penting: Pengembang yang membangun transkripsi rapat atau panggilan dapat memakai model ini untuk menetapkan label pembicara generik pada rentang waktu, termasuk ketika ucapan bertumpang tindih, lalu menggabungkan rentang tersebut dengan kata-kata dari pengenal ucapan terpisah. Rilis ini memperluas batas jumlah pembicara yang didokumentasikan untuk tugas itu.
- Yang perlu dicermati: Pilihan praktisnya adalah berapa banyak audio yang perlu ditampung sebelum setiap hasil streaming. Setelan terpendek yang direkomendasikan NVIDIA menunggu audio selama 0,32 detik sebelum komputasi dimulai, dan tabel akurasinya sendiri menunjukkan adanya konsekuensi dari penggunaan setelan itu. Tim tetap perlu mengukur keseluruhan alur pada rekaman mereka.
Keluaran model
Spesifikasi kartu model menetapkan audio satu kanal dengan laju sampel 16 kHz. Format berkas yang dicantumkan meliputi WAV, FLAC, Opus, dan MP3; antarmuka NeMo menerima jalur berkas, larik audio, atau manifes JSON yang dibatasi baris. Larik audio memerlukan laju sampel yang benar saat diteruskan ke diarize() pemanggilan itu. Inferensi berbasis potongan tidak memiliki durasi rekaman maksimum tetap menurut kartu tersebut.
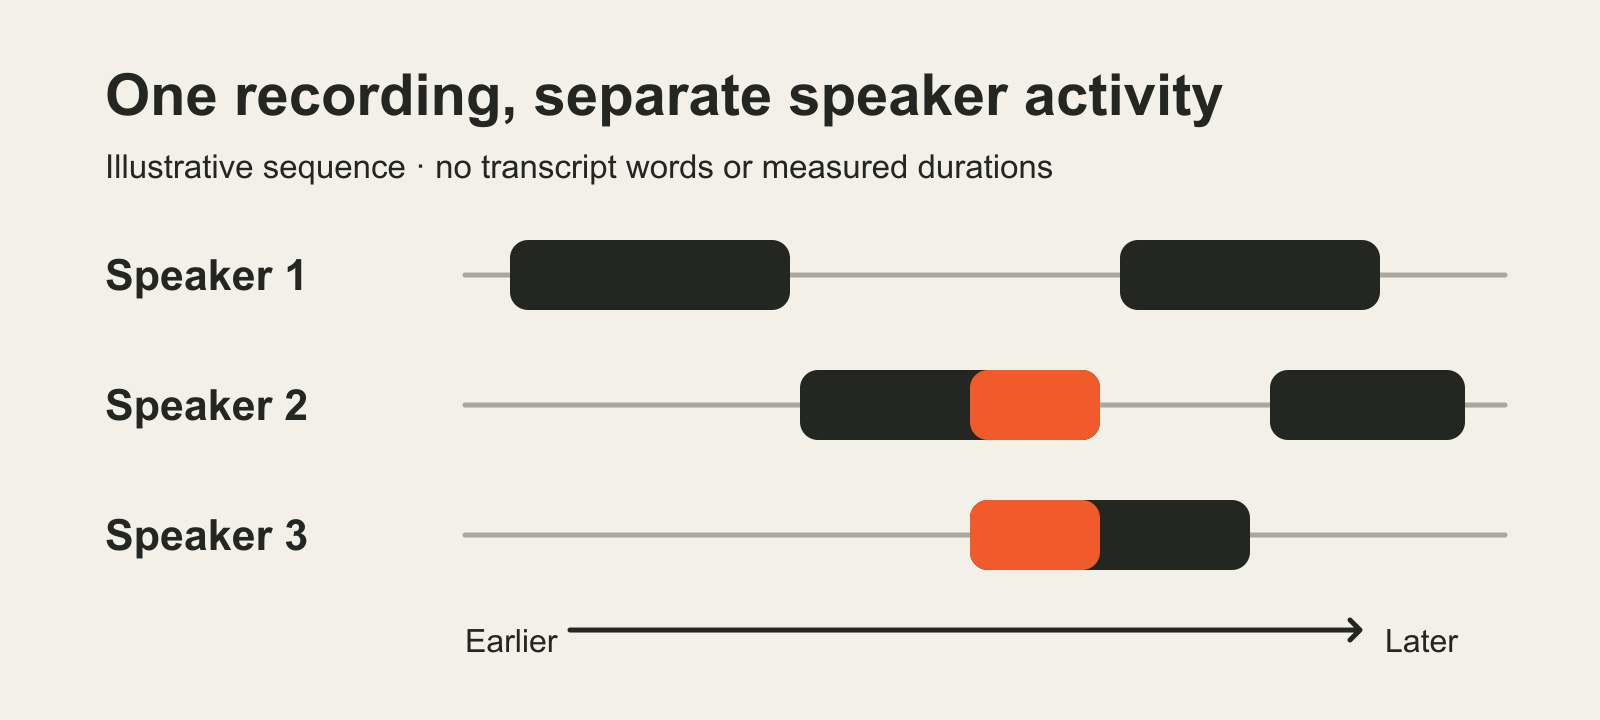
Model mengubah audio menjadi tensor [T, 8] probabilitas aktivitas pembicara, dengan langkah keluaran bawaan 10 milidetik. Beberapa kanal dapat aktif bersamaan ketika orang berbicara tumpang tindih. Pascapemrosesan mengubah probabilitas itu menjadi rentang dengan waktu mulai dan selesai serta label pembicara generik. Label mengikuti urutan kemunculan suara; label tidak mengidentifikasi orang berdasarkan nama. NVIDIA menggunakan cache pembicara untuk potongan sebelumnya dan antrean masuk-pertama-keluar-pertama untuk bingkai terbaru agar model streaming dapat mempertahankan konteks.
Bagi pengembang yang memerlukan transkrip bertanda pembicara, pembedaan itu penting. Panduan integrasi NVIDIA memasangkan cap waktu diarization dengan keluaran pengenalan ucapan otomatis yang terpisah. Aturan titik tengah dalam contoh NVIDIA membiarkan sebuah kata tanpa label jika tidak ada pembicara aktif, dan menandai aktivitas serentak sebagai ambigu. Model diarization saja tidak menentukan suara tumpang tindih mana yang menghasilkan kata yang dikenali.
Waktu buffering bukan waktu respons
NVIDIA mencantumkan setelan buffer masukan yang direkomendasikan sebesar 30,4; 1,04; 0,64; dan 0,32 detik. Setelan 0,32 detik terdiri atas tiga bingkai pemrosesan berdurasi 80 milidetik dan satu bingkai konteks kanan berdurasi 80 milidetik. Kartu tersebut secara eksplisit mendefinisikan latensi sebagai audio yang ditahan sebelum inferensi; definisi itu tidak mencakup komputasi. Sistem transkripsi juga akan menambah waktu untuk pengenalan, pemindahan data, dan aplikasi.
Jalur NeMo yang didokumentasikan memerlukan Python 3.12 atau yang lebih baru, Cython, versi PyTorch terkini, dan NeMo Speech. NVIDIA menyediakan SortformerEncLabelModel.from_pretrained() contoh, sebuah diarize() pemanggilan yang mengembalikan segmen pembicara, serta opsi untuk menyertakan tensor probabilitas. Kartu tersebut menyatakan bahwa token Hugging Face diperlukan untuk memuat checkpoint yang dihosting melalui pemanggilan NeMo itu. Kartu ini juga menampilkan antarmuka Transformers luring dan streaming, dengan pemasangan dari repositori sumber Transformers, serta jalur baris perintah NeMo-Speech.cpp. Semua ini merupakan antarmuka yang didokumentasikan; BIG CHANGE belum menjalankannya. Kartu model mencantumkan Linux dan keluarga GPU NVIDIA Ampere, Hopper, serta Blackwell untuk integrasi NeMo. Kebutuhan perangkat keras dan biaya pemrosesan untuk beban kerja tertentu bergantung pada jalur dan mesin yang dipilih; kartu itu tidak memberikan harga operasional per jam.
Bobot model ditawarkan di bawah lisensi OpenMDW 1.1. Lisensi tersebut mengizinkan penggunaan, modifikasi, dan distribusi tanpa biaya lisensi, dengan tetap tunduk pada ketentuannya. Distribusi harus menyertakan lisensi dan pemberitahuan asal yang berlaku. Lisensi tidak membatasi penggunaan atau pembagian keluaran, dan menetapkan tanggung jawab kepada pengguna untuk memperoleh hak dan persetujuan yang mungkin diperlukan atas audio mereka. NVIDIA menyebut model ini tersedia untuk penggunaan komersial maupun nonkomersial.
Yang diukur NVIDIA
Evaluasi pada kartu model NVIDIA membandingkan Nemotron 3 dengan Sortformer v2.1 streaming empat pembicara sebelumnya. Pada set evaluasi penuh DIHARD III, NVIDIA melaporkan tingkat kesalahan diarization sebesar 13,18% untuk Nemotron 3 dengan setelan buffer masukan 1,04 detik, dibandingkan 19,60% untuk model sebelumnya pada setelan buffer yang sama. Pada 0,32 detik, hasil Nemotron 3 adalah 13,55%. Tingkat kesalahan diarization menggabungkan ucapan yang terlewat, alarm palsu, dan kekeliruan pembicara, lalu membaginya dengan durasi bicara acuan. Nilai yang lebih rendah lebih baik.
Angka-angka itu berasal dari protokol tertentu. NVIDIA mengatakan semua evaluasinya menilai ucapan tumpang tindih. DIHARD III menggunakan toleransi batas nol detik, sedangkan CALLHOME-Part2 menggunakan toleransi 0,25 detik. Untuk AMI, AliMeeting, dan NOTSOFAR1, NVIDIA menggunakan anotasi acuan tertaut yang disejajarkan secara paksa, bukan label segmen asli; perubahan label tersebut mengubah skor. Petunjuk evaluasi mengidentifikasi skrip NeMo dan mensyaratkan berkas RTTM acuan, setelan tumpang tindih, toleransi batas, setelan streaming, serta rincian pascapemrosesan agar hasil dapat dibandingkan. Hasil kecepatan inferensi NVIDIA menggunakan BF16 pada RTX PRO 5000, dengan dan tanpa torch.compile(). Ini adalah pengujian yang dilaporkan vendor, bukan replikasi oleh BIG CHANGE.
Batas delapan pembicara tetap penting. DIHARD III mencakup beberapa rekaman dengan anotasi hingga sembilan pembicara, dan kartu tersebut menyatakan ucapan di luar delapan kanal model dapat terlewat atau ditetapkan ke kanal lain. Pada rekaman uji AMI, NVIDIA melaporkan tingkat kesalahan diarization Nemotron 3 lebih rendah daripada model dasar sebelumnya, tetapi akurasi jumlah pembicara tepatnya lebih rendah. Jadi, akurasi bergantung pada tugas dan ukuran yang digunakan, selain audionya. Tim yang mempertimbangkan integrasi dapat memulai dari antarmuka yang dipublikasikan NVIDIA, lalu menguji keseluruhan alur pembicara-dan-kata pada rekaman yang menyerupai penggunaan yang dituju.