NVIDIA je 23. septembra objavio Nemotron 3 Diarization. Ovaj model otvorenih težina sa približno 100 miliona parametara označava kada govori svaki od najviše osam govornika, u snimljenom zvuku ili prenosu uživo. Razvojnim timovima daje podatke o aktivnosti govornika i vremenske oznake razgovora; za transkript sa prepoznatim rečima potreban je i zaseban sistem za prepoznavanje govora.
Suštinska promena
- Šta se promenilo: NVIDIA-ina prethodna kontrolna tačka Sortformer za prenos uživo podržava četiri govornika. Novo izdanje nudi osam kanala za govornike, numerisanih po redosledu pojavljivanja, iz jedne kontrolne tačke koja radi i sa snimljenim zvukom i sa pristiglim segmentima.
- Zašto je to važno: Razvojni tim koji pravi sistem za transkripciju sastanaka ili poziva može modelom da dodeli generičke oznake govornika vremenskim intervalima, uključujući preklapanje govora, pa da te intervale spoji sa rečima iz zasebnog sistema za prepoznavanje govora. Ovim izdanjem povećava se dokumentovani broj govornika za taj zadatak.
- Na šta obratiti pažnju: U praksi treba odabrati koliko zvuka će se baferovati pre svakog rezultata prenosa uživo. NVIDIA-ino najkraće preporučeno podešavanje čeka da pristigne 0,32 sekunde zvuka pre početka obrade, a sopstvene tabele tačnosti kompanije pokazuju cenu tog podešavanja. Timovi i dalje moraju da izmere ceo postupak na svojim snimcima.
Šta model vraća
Kartica modela navodi mono zvuk uz frekvenciju uzorkovanja od 16 kHz. Podržava WAV, FLAC, Opus i MP3 datoteke, a interfejs NeMo prihvata putanje do datoteka, nizove zvučnih podataka i JSON manifest sa po jednim zapisom u redu. Za nizove zvučnih podataka odgovarajuću frekvenciju uzorkovanja treba proslediti kroz funkciju diarize() poziva. Kartica ne navodi fiksno maksimalno trajanje snimka za zaključivanje po segmentima.
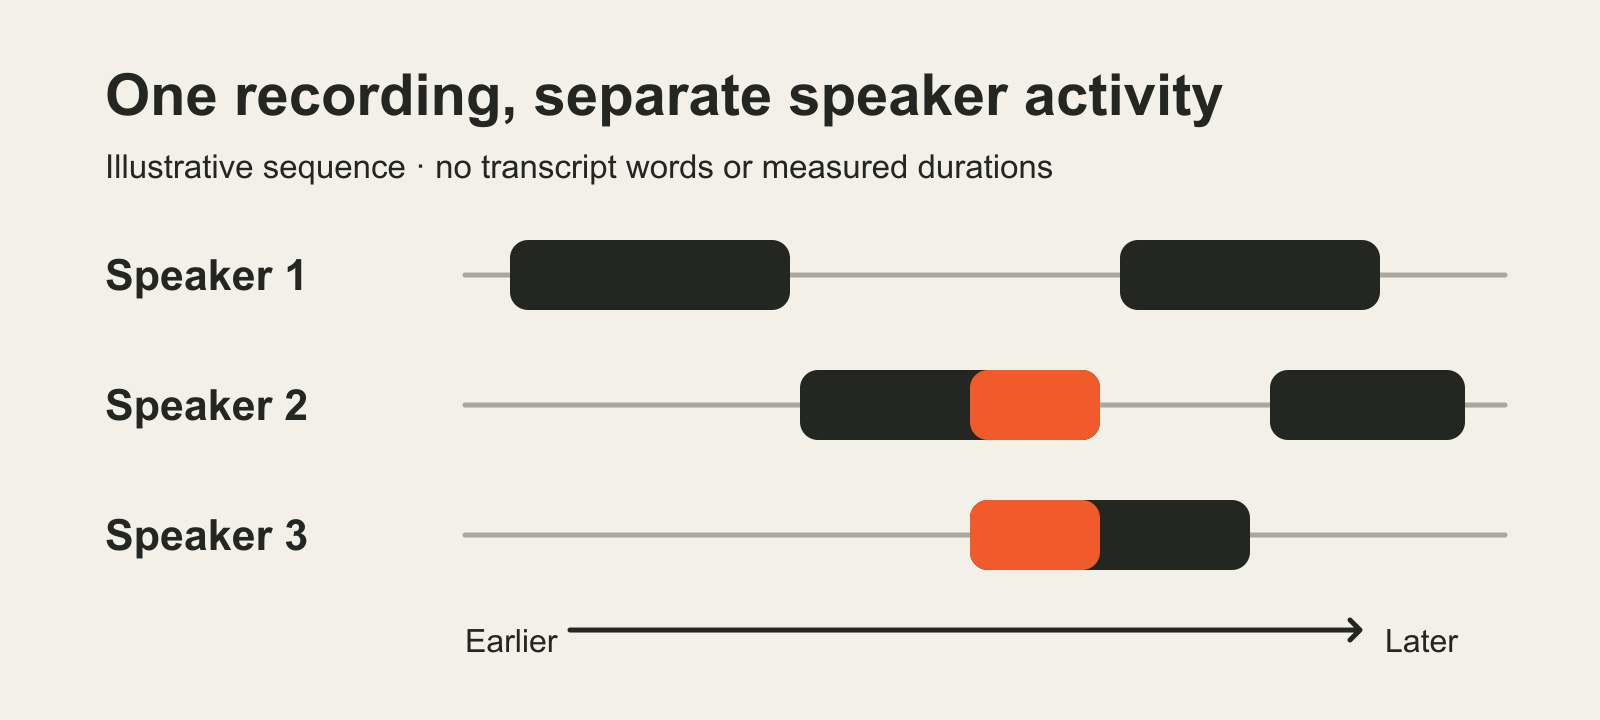
Model pretvara zvuk u tenzor [T, 8] verovatnoća aktivnosti govornika sa podrazumevanim korakom izlaza od 10 milisekundi. Više kanala može biti aktivno istovremeno kada se glasovi preklapaju. Naknadna obrada te verovatnoće pretvara u intervale sa početnim i završnim vremenima i generičkim oznakama govornika. Oznake prate redosled kojim se glasovi prvi put javljaju; ne otkrivaju identitet osobe. NVIDIA koristi keš govornika za prethodne segmente i red „prvi unutra, prvi napolje“ za nedavne kadrove kako bi model za prenos uživo zadržao kontekst.
Za razvojni tim kome je potreban transkript sa oznakama govornika, ta razlika je bitna. NVIDIA-ino uputstvo za povezivanje sistema spaja vremenske oznake diarizacije sa izlazom zasebnog automatskog prepoznavanja govora. U primeru se reč ne dodeljuje nijednom govorniku kada u tom trenutku niko ne govori, a istovremena aktivnost označava se kao nejasna. Sam model za diarizaciju ne određuje koji je govornik izgovorio prepoznatu reč tokom preklapanja.
Vreme baferovanja nije vreme odziva
NVIDIA navodi preporučena podešavanja ulaznog bafera od 30,4, 1,04, 0,64 i 0,32 sekunde. Podešavanje od 0,32 sekunde sastoji se od tri procesna kadra od 80 milisekundi i jednog kadra budućeg konteksta od 80 milisekundi. U kartici se izričito definiše latencija kao vreme tokom kog se zvuk zadržava pre zaključivanja; vreme obrade nije uključeno. Sistem za transkripciju dodao bi i vreme potrebno za prepoznavanje, prenos i aplikaciju.
Dokumentovani postupak sa NeMo-om zahteva Python 3.12 ili noviji, Cython, noviju verziju PyTorcha i NeMo Speech. NVIDIA daje SortformerEncLabelModel.from_pretrained() primer, a diarize() poziv koji vraća segmente govornika i prekidač za uključivanje tenzora verovatnoća. U kartici modela piše da je za učitavanje kontrolne tačke sa hostinga potreban Hugging Face token. Prikazani su i interfejsi Transformers-a za lokalnu obradu i prenos uživo, uz instalaciju iz izvornog repozitorijuma Transformers-a, kao i komandni alat NeMo-Speech.cpp. Ovo su dokumentovani interfejsi; BIG CHANGE ih nije pokrenuo. Kartica modela za integraciju sa NeMo-om navodi Linux i NVIDIA GPU porodice Ampere, Hopper i Blackwell. Potrebna oprema i trošak obrade za konkretno opterećenje zavise od izabranog postupka i računara; NVIDIA u kartici ne navodi cenu rada po satu.
Težine se nude pod licencom OpenMDW 1.1. Licenca, u skladu sa svojim uslovima, dozvoljava upotrebu, izmene i distribuciju bez naknade za licencu. Pri distribuciji se moraju zadržati licenca i odgovarajuća obaveštenja o poreklu. Licenca ne ograničava upotrebu ili deljenje izlaznih rezultata i ostavlja korisnicima odgovornost da obezbede prava i saglasnosti koji mogu biti potrebni za njihove zvučne zapise. NVIDIA navodi da je model dostupan za komercijalnu i nekomercijalnu upotrebu.
Šta je NVIDIA merio
NVIDIA-ina evaluacija u kartici modela poredi Nemotron 3 sa ranijim modelom Sortformer v2.1 za četiri govornika u prenosu uživo. Na celom skupu za evaluaciju DIHARD III, NVIDIA navodi stopu greške diarizacije od 13,18% za Nemotron 3 pri podešavanju ulaznog bafera od 1,04 sekunde, u poređenju sa 19,60% za raniji model pri istom navedenom podešavanju. Pri 0,32 sekunde rezultat Nemotron-a 3 iznosi 13,55%. Stopa greške diarizacije objedinjuje propušteni govor, lažne detekcije i zabunu oko govornika, podeljene referentnim vremenom govornika. Niža vrednost je bolja.
Ove brojke važe za definisani protokol. NVIDIA navodi da sve njene evaluacije ocenjuju i preklapajući govor. DIHARD III koristi granični interval od nula sekundi, dok CALLHOME-Part2 koristi interval od 0,25 sekundi. Za skupove AMI, AliMeeting i NOTSOFAR1 NVIDIA koristi povezane referentne oznake poravnate sa zvukom, umesto izvornih oznaka segmenata; promena oznaka menja rezultate. U uputstvu za evaluaciju navode se NeMo skripta i obavezna referentna RTTM datoteka, podešavanje preklapanja, granični interval, postavke prenosa uživo i detalji naknadne obrade za uporedivo pokretanje. NVIDIA-ina merenja brzine zaključivanja obavljena su u formatu BF16 na računaru RTX PRO 5000, sa uključenim i isključenim torch.compile(). Ovo su rezultati koje je prijavio proizvođač, a ne test koji je BIG CHANGE ponovio.
Granica od osam govornika i dalje je važna. Neki snimci u skupu DIHARD III označeni su sa najviše devet govornika, a u kartici se navodi da govor iznad osam kanala modela može biti propušten ili dodeljen drugom kanalu. Za testne snimke AMI-ja NVIDIA navodi nižu stopu greške diarizacije za Nemotron 3 nego za raniji osnovni model, ali i nižu tačnost utvrđivanja tačnog broja govornika. Tačnost zato zavisi od zadatka i merila, kao i od zvuka. Tim koji razmatra integraciju modela može da počne od javno dokumentovanih NVIDIA-inih interfejsa i testira ceo postupak označavanja govornika i reči na snimcima sličnim onima za koje namerava da ga koristi.