Grok 4.7 erschien am 21. September 2026. Für Teams, die KI zum Programmieren oder zur Analyse von Geschäftsinformationen einkaufen, stellt sich eine praktische Frage: Macht ein besseres Modell fertige Arbeit günstiger? Die Antwort hängt von mehr ab als den beworbenen Tokenpreisen. Offizielle Versionshinweise
Dieses gemischte Bild steht im Mittelpunkt von Matthew Bermans Video vom 22. September. Ich weiß nicht, was ich von Grok 4.7 halten soll …. Er hinterfragt die Auswahl der Vergleiche und argumentiert, Kosten pro abgeschlossener Aufgabe seien wichtiger als Tokenpreise. Außerdem sagt er, das Modell nicht gründlich getestet zu haben. Sein Video ist eine frühe Einschätzung der Belege, keine umfassende praktische Bewertung. Bermans Einleitung, 0:00
Der Start verdient Aufmerksamkeit, denn ein nützliches Modell muss nicht jeden Benchmark gewinnen, um zu verändern, welche Automatisierung sich für Unternehmen lohnt. Es muss jedoch genügend Arbeit korrekt abschließen, um seine Gesamtkosten zu rechtfertigen. Unabhängige Tests zeigen bereits den Zielkonflikt: Die besseren Ergebnisse von Grok 4.7 können mit deutlich mehr erzeugtem Text einhergehen.
Für Entwickler, kleine Unternehmen und Teams, die Agenten entwickeln, ist die Entscheidung daher praktisch: Welche Aufgaben kann dieses Modell in ausreichender Qualität erledigen? Wie viel Aufwand benötigt es? Und wie viel Arbeit bleibt einem Menschen, nachdem das Modell seine Aufgabe für erledigt erklärt?
Wir haben die vollständigen Untertitel von Bermans etwa 17-minütigem Video geprüft und Start, Produktdokumentation sowie die Bewertung von Artificial Analysis kontrolliert. Die folgende Analyse enthält weder einen BIG-CHANGE-Benchmark noch Behauptungen über eigene Grok-Tests.
Was eingeführt wurde und wo es verfügbar ist
Das Standardmodell ist über die xAI-API verfügbar unter grok-4.7, sowie in Cursor und Grok Build. Die API nimmt Text und Bilder entgegen und erzeugt Text. Das dokumentierte Kontextfenster umfasst 500.000 Token; es gibt vier Einstellungen für den Reasoning-Aufwand: low, medium, high und xhigh. High ist die Voreinstellung. Offizielle Versionshinweise
SpaceXAI führt die Verbesserung auf ein größeres Basismodell und längeres Reinforcement Learning mit schwierigeren Aufgaben zurück. Das ist die Erklärung des Entwicklers. Technischer Überblick zum Start
Daneben gibt es Grok 4.7 Fast. Laut Dokumentation ist es dasselbe Modell auf schnellerer Infrastruktur und wird mit dem Doppelten der üblichen Tokenpreise abgerechnet. Es wird über Cursor und Grok Build angeboten, ist von der kostenlosen Stufe von Grok Build ausgeschlossen und über die öffentliche xAI-API nicht verfügbar. Produktdokumentation zu Grok 4.7
Diese Unterschiede sind wichtig, wenn man Screenshots, Vorführungen und Rechnungen vergleicht. Modellversion, Reasoning-Aufwand und Bereitstellungsstufe sind getrennte Entscheidungen. Eine Vorführung mit Fast und xhigh ist weder ein Maß für Nutzungserlebnis noch Kosten eines API-Aufrufs mit Standardgeschwindigkeit und mittlerem Aufwand.
Auch der Vergleich auf der Startseite mit anderen Modellen ist von einem Upgrade-Vergleich zu unterscheiden. SpaceXAI zufolge bietet Grok 4.7 zum Standardpreis und mit derselben Geschwindigkeit wie Grok 4.6. Das Unternehmen sagt nicht, dass ein Upgrade von 4.6 die Rechnung automatisch halbiert.
Die Preiskarte hat eine Schwelle für lange Kontexte
Die veröffentlichten Standardpreise der API sind:
- Bis zu 200.000 Prompt-Token: 2 Dollar für Eingabe, 0,50 Dollar für zwischengespeicherte Eingabe und 6 Dollar für Ausgabe, jeweils pro einer Million Token.
- Über 200.000 Prompt-Token: 4 Dollar für Eingabe, 1 Dollar für zwischengespeicherte Eingabe und 12 Dollar für Ausgabe, jeweils pro einer Million Token.
Das sind Tokenpreise, keine vollständigen Kosten für einen Agenten, der eine Aufgabe erledigt. Die Modellseite weist auf höhere Preise für Anfragen über 200.000 Token hin; die Versionshinweise nennen die höheren Sätze. Preise und Verfügbarkeit wurden am 22. September geprüft. Modellpreise und Versionshinweise
Ein Kontextfenster von 500.000 Token bedeutet daher nicht, dass jede Anfrage innerhalb dieses Fensters zum niedrigsten Satz abgerechnet wird. Ein großes Kontextfenster belegt auch nicht, dass das Modell in einer großen Dateisammlung zuverlässig alle relevanten Details findet.
Die Dokumentation von Cursor nennt einen weiteren Unterschied auf Produktebene: ein Standardfenster von 256.000 Token und ein Maximum von 500.000. Die Kapazität im Editor kann von der API-Angabe abweichen oder vom gewählten Modus abhängen. Dokumentation von Cursor zu Grok 4.7
Für ein Team, das lange Berichte verarbeitet, stellt sich unmittelbar die Frage, ob die Übermittlung des gesamten Materials das Ergebnis so stark verbessert, dass sich die Kosten lohnen. Die relevanten Abschnitte abzurufen, kann günstiger und leichter zu überprüfen sein. Manchmal ist das ganze Dokument nötig; manchmal ist es bloß der einfachste Weg, einen Prompt zu erstellen. Diese Fälle sollten nicht gleich budgetiert werden.
Bessere Leistung kann mehr Token verbrauchen
Die Bewertung von Artificial Analysis vom 21. September gibt Grok 4.7 mit xhigh 46 Punkte in seinem Intelligence Index, zwei Punkte mehr als Grok 4.6. Laut Bericht erzeugt das Modell pro Aufgabe ungefähr 81.000 Ausgabe-Token, gegenüber 36.000 bei Grok 4.6 mit hohem Aufwand. Für Grok 4.6 mit xhigh nennt derselbe Bericht 38.000; selbst bei gleichem Aufwand sind das für das neue Modell mehr als doppelt so viele Ausgabe-Token. Startbewertung von Artificial Analysis
Dies ist ein konkreter Grund, Tokenpreis und Aufgabenkosten auseinanderzuhalten. 81.000 Ausgabe-Token zum Basissatz von 6 Dollar je Million ergeben beispielhaft Ausgabegebühren von 0,486 Dollar. Bei 38.000 Token wären es 0,228 Dollar. Diese Rechnungen lassen bewusst Eingabe, Cache-Verhalten, Werkzeuggebühren, höhere Preise für lange Kontexte und Fehlversuche außer Acht. Es ist eine Berechnung anhand der gemeldeten Tokenzahlen, kein gemessener Gesamtpreis einer Aufgabe.
Mehr Ausgabe ist nicht automatisch Verschwendung. Ein Modell könnte zusätzlichen Aufwand in die Überprüfung einer Antwort stecken und dadurch einen Fehler vermeiden, der sonst menschliches Eingreifen erfordert hätte. Es könnte auch länger einem falschen Ansatz folgen. Die Tokenzahl allein unterscheidet nicht zwischen produktiver Hartnäckigkeit und teurer Wiederholung.
Berman kommt gegen Ende seines Videos auf dieses Problem zurück und erwähnt den höheren Tokenverbrauch, den Artificial Analysis meldet. Video, 15:43
Das nützliche Ergebnis ist ein akzeptiertes Arbeitsergebnis. Eine Codeänderung, die passende Tests und Prüfung besteht, eine Tabelle mit abgestimmten Formeln oder ein Bericht, dessen Aussagen auf Belege zurückgehen, hat einen anderen Wert als eine Antwort, die bloß schnell eintrifft.
Benchmarks zeigen ein leistungsfähiges, aber uneinheitliches Modell
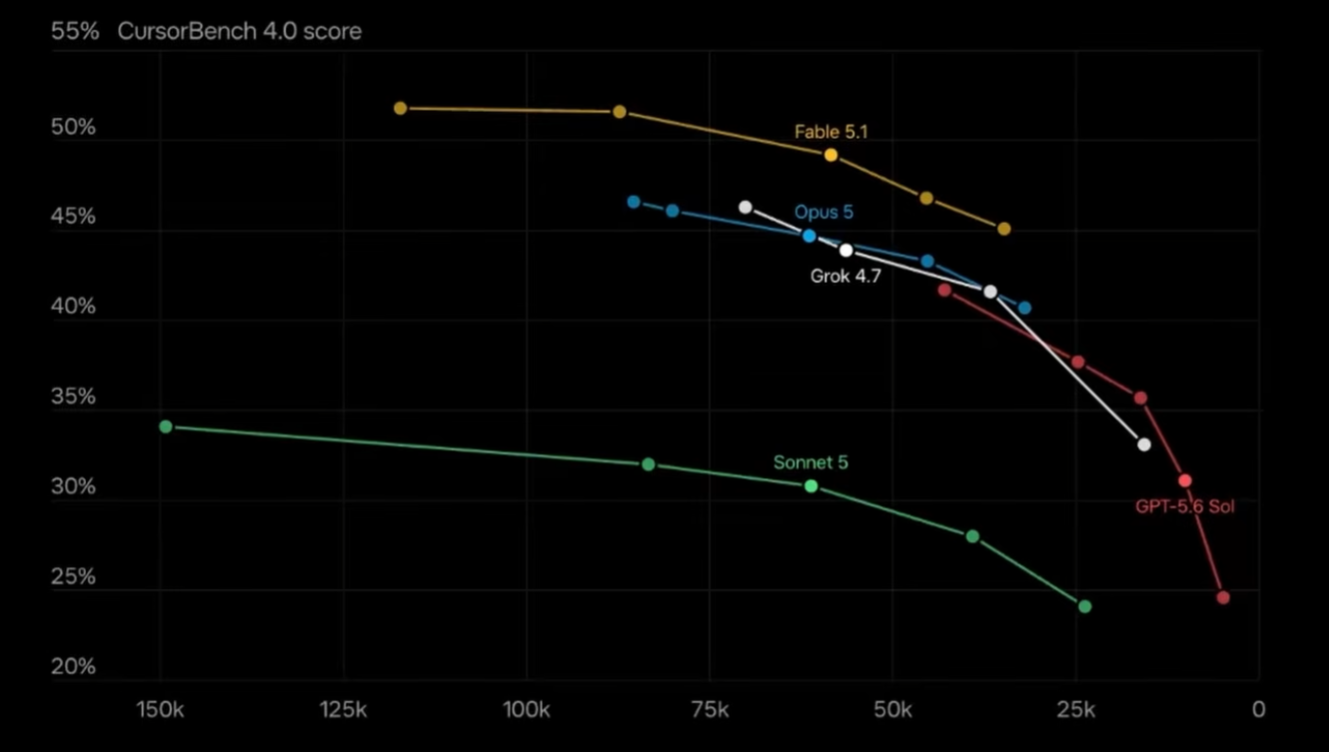
Die Starttabelle weist Grok 4.7 mit xhigh 46,3 Prozent bei CursorBench 4.0 aus, unter Fable 5.1 max mit 51,8 Prozent. Fable liegt auch im zugehörigen Vergleich von Terminal-Bench vorn. Benchmarktabelle des Anbieters
Die begleitende Grafik stellt Benchmark-Ergebnis und Ausgabe-Token gegenüber, wobei der Wert nach rechts abnimmt. Die Linien vergleichen die Reasoning-Einstellungen. Interaktive Originalgrafik: „Tokens“ auswählen. Grafik in voller Größe öffnen.
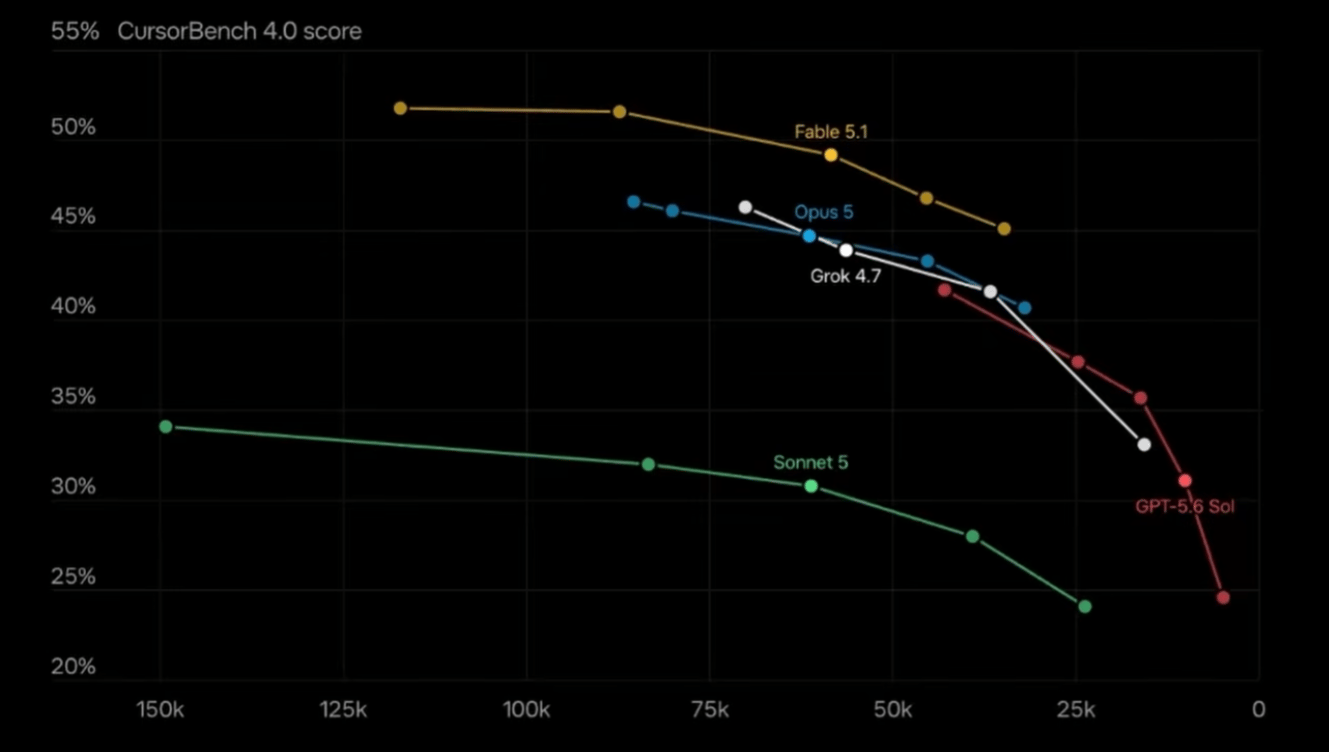
Eine Bewegung nach oben bedeutet ein höheres Ergebnis; nach rechts bedeutet in dieser Auswertung weniger erzeugte Token. Daraus folgt kein niedrigerer Gesamtpreis: Tokenpreise, Eingabeverbrauch und der umgebende Agent spielen ebenfalls eine Rolle. Außerdem handelt es sich um einen anderen Test als die Tokenzahlen von Artificial Analysis. Würde man ihre Werte zusammenführen, gingen die Unterschiede bei Aufgabe und Methodik verloren, die beide Ergebnisse interpretierbar machen.
Das reicht aus, um die pauschale Behauptung zurückzuweisen, Grok 4.7 führe jede Art von Programmierarbeit an. Zugleich rechtfertigt es einen genaueren Blick auf bestimmte Arbeitslasten. Wie stark ein Modell in einer Auswertung besser abschneidet, bestimmt nicht, wie es mit einem unbekannten Repository, einer unvollständigen Fehlerbeschreibung oder einer ungewöhnlichen Werkzeugumgebung zurechtkommt.
Artificial Analysis liefert eine nützliche Unterscheidung. Dem Bericht zufolge erreicht Grok 4.7 mit Grok Build im Coding Agent Index einen Wert von 56, gegenüber 47 für Grok 4.6 mit demselben Agenten. Die Ergebnisse dieser nativen Agenten trennt der Bericht ausdrücklich vom standardisierten Aufbau des Intelligence Index. Unabhängige Bewertung und Methodikhinweise
Auch der umgebende Agent ist wichtig. Er stellt Werkzeuge bereit, verwaltet den Kontext und entscheidet, wie die Anfragen des Modells ausgeführt werden. Eine veränderte Umgebung kann die Ergebnisse verändern, selbst wenn der Modellname gleich bleibt. Wer einen Terminal-Wert aus einem Aufbau mit einem Softwareentwicklungswert aus einem anderen kombiniert, kann eine überzeugende Tabelle erstellen, die kein tatsächlich getestetes System beschreibt.
Berman weist darauf hin, dass GPT-6 Astra in einer Starttabelle fehlt, und ergänzt es mithilfe einer KI-generierten Rekonstruktion. Das ist ein nützlicher Anstoß, den Vergleich zu untersuchen; die Rekonstruktion ist jedoch keine unabhängige Benchmarkquelle. Wir übernehmen die ergänzten Werte nicht, ohne die zugrunde liegende Auswertung zu prüfen. Video, 6:03
Auch die Geschäftsbeziehung sollte berücksichtigt werden. Laut Unternehmensankündigung vom 14. August wurde Cursor von SpaceX übernommen. Ein innerhalb derselben Produktfamilie veröffentlichter Benchmark bleibt ein nützlicher Beleg, ist aber keine unbeteiligte Bewertung eines konkurrierenden Anbieters. Übernahmeankündigung von Cursor
Büroarbeit könnte die interessantere Chance sein
In der unabhängigen Bewertung erreicht Grok 4.7 mit xhigh 1.657 Elo beim AA-Briefcase; das sind 111 Punkte mehr als Grok 4.6 mit hohem Aufwand. Einen großen Teil des Zuwachses schreibt die Auswertung der analytischen Qualität zu, während die Präsentationsqualität etwas unter dem früheren Ergebnis liegt. Ergebnisse von Artificial Analysis zu wissensintensiver Arbeit
Diese Aufteilung ist für alle nützlich, die Berichte, Tabellen oder Präsentationen in Auftrag geben. Eine Antwort kann bessere Analysen enthalten und dennoch redaktionelle oder gestalterische Überarbeitung erfordern. Umgekehrt kann eine ausgefeilte Präsentation oberflächliche Überlegungen verbergen. Wer nur das sichtbare Endprodukt bewertet, riskiert, die falsche Verbesserung zu belohnen.
Ein Betriebsteam könnte das Modell anhand eines regelmäßig erstellten Leistungsberichts testen. Ein sinnvoller Versuch würde prüfen, ob es den richtigen Zeitraum verwendet, Zahlen mit den Quelldaten abstimmt und beobachtete Veränderungen von vorgeschlagenen Erklärungen unterscheidet. Die prüfende Person sollte festhalten, wie viel Korrektur nötig war, nicht nur, ob der Bericht bei erster Sichtung professionell aussah.
Ein kleineres Unternehmen könnte es weniger wichtig finden, den schwierigsten Benchmark zu gewinnen, als eine sonst unbezahlbare Analyse zur Routine zu machen. Das ist ein plausibler Weg zu einer breiteren Einführung. Wirklichkeit wird er, wenn das Ergebnis genau genug ist, rechtzeitig eintrifft und dem Eigentümer weniger Arbeit lässt als die manuelle Erledigung.
Bezeichnungen für professionelle Benchmarks sind nicht mit Berufsqualifikationen zu verwechseln. Ein Ergebnis bei juristischen Aufgaben oder klinischem Schlussfolgern beschreibt die Leistung in dieser Auswertung. Es belegt nicht, dass ein Modell eigenständig den Rechtsfall eines Mandanten bearbeiten oder eine Entscheidung zur Patientenversorgung treffen kann. Dieser Artikel empfiehlt nicht, Grok für solche Entscheidungen einzusetzen.
Schutzmaßnahmen müssen im jeweiligen Kontext bewertet werden
SpaceXAI erklärt, Grok 4.7 habe einen neuen Schutzmechanismus und sei widerstandsfähiger gegen Jailbreaks. Das ist eine Behauptung zum Start, keine Garantie, dass jede Anwendung mit dem Modell sicher ist. Darstellung des Entwicklers zu Sicherheit
Für einen Geschäftsagenten bleiben mindestens zwei Fragen offen: Reagiert das Modell angemessen auf eingehende Anfragen? Und begrenzt die Anwendung, was das Modell tatsächlich tun kann?
Ein Modell kann eine Anweisung, einen Kundendatensatz zu ändern, richtig verstehen und trotzdem nicht berechtigt sein, die Änderung vorzunehmen. Es kann auch auf böswillige Anweisungen in einem Dokument stoßen, das es zusammenfassen sollte. Zugriffskontrollen und Genehmigungsregeln müssen Teil des umgebenden Systems bleiben; ein besseres Ablehnungsverhalten ersetzt sie nicht.
Praktisch sollte daher der gesamte Arbeitsablauf getestet werden. Dazu gehören legitime Anfragen, die erfolgreich sein sollen, unzulässige Aktionen, die blockiert werden müssen, und mehrdeutige Fälle, bei denen zunächst nachgefragt werden sollte. Ein Produkt, das harmlose Aufgaben zu oft ablehnt, kann unbrauchbar sein; eines, das nicht autorisierte Aktionen ausführt, kann deutlich schlimmer sein. Keines dieser Probleme lässt sich mit einer einzelnen Schlagzeilenkennzahl erfassen.
Was im Video offenbleibt
Bermans Bericht wirft mehrere Fragen auf, die offenbleiben sollten. Seine Erklärung zum Zusammenhang zwischen Preisen und verfügbarer Rechenleistung ist eine Marktdeutung, keine offengelegte Kostenrechnung pro Einheit. Die von ihm angesprochenen Vorhersagen für soziale Medien sind Erwartungen, keine Belege für bereits erbrachte Leistung. Bei seinem abschließenden Vergleich der Vorführungen räumt er selbst ein, die verwendeten Einstellungen nicht zu kennen. Preisgespräch, 8:44, Erwartungen, 11:51 und Vorführungsvergleich, 15:20
Das Video spricht auch über Modelle mit offenen Gewichten. Dieser breitere Wettbewerbstrend ist nicht mit der Lizenzierung von Grok 4.7 gleichzusetzen: Artificial Analysis führt diese Veröffentlichung als proprietär und gibt an, dass die Gewichte nicht verfügbar sind. Profil der Veröffentlichung Grok 4.7
Diese Unterschiede halten die Bewertung auf Kurs. Ein Produkt kann attraktiv bepreist sein, ohne dass die Öffentlichkeit weiß, warum der Anbieter diesen Preis gewählt hat. Eine auffällige misslungene Vorführung kann auf einen Test hinweisen, den man wiederholen sollte, ohne zu belegen, dass das Modell generell schlecht ist. Ein verfügbares Modell kann nützlich sein, ohne die frühere Prognose eines Gründers zu erfüllen.
Auch Werbung muss getrennt betrachtet werden. Bermans Video enthält einen Werbebeitrag für Zapier. Er ist kein unabhängiger Beleg zur Leistung von Grok, und seine Werbeaussagen sind keine Empfehlungen von BIG CHANGE.
Eine bessere Einkaufskennzahl: Kosten je akzeptierter Aufgabe
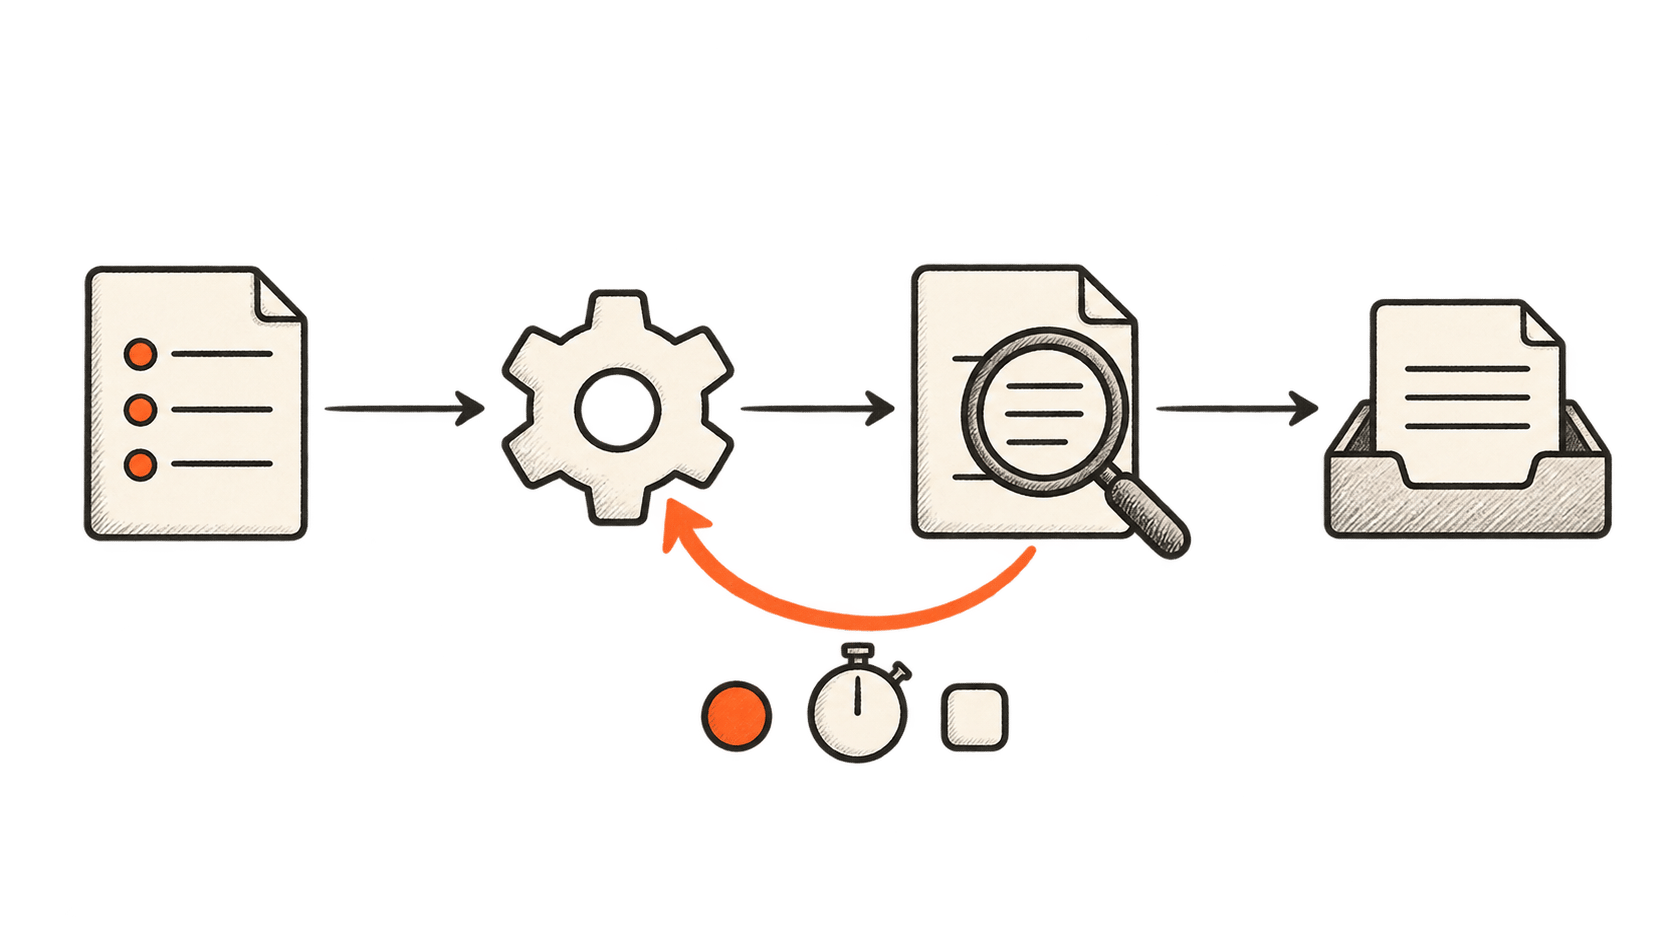
Ein Team, das Grok 4.7 erwägt, sollte es anhand einer kleinen, repräsentativen Auswahl von Aufgaben mit dem bisherigen Ablauf vergleichen. Legen Sie die Annahmekriterien fest, bevor Sie die Ausgaben ansehen. Beim Programmieren könnten passende Tests, ein gut lesbarer Patch und das Ausbleiben sachfremder Änderungen dazugehören. Bei einer Analyse könnten korrekte Berechnungen und Belege für wichtige Aussagen verlangt werden.
Erfassen Sie anschließend die vollständigen Kosten: Eingabe- und Ausgabenutzung, Werkzeuge, Wiederholungen sowie die Zeit für Prüfung und Korrektur. Zählen Sie auch erfolglose Versuche. Teilen Sie diese Kosten durch die Zahl der Arbeitsergebnisse, die die Annahmekriterien erfüllen.
Ein hypothetisches Beispiel zeigt, warum der Unterschied wichtig ist. Angenommen, eine Konfiguration kostet für eine Gruppe von Aufgaben 20 Dollar und liefert 80 akzeptierte Ergebnisse. Gemessen daran kostet jedes Ergebnis vor der menschlichen Arbeit 0,25 Dollar. Eine andere Konfiguration kostet 12 Dollar, liefert aber nur 30 akzeptierte Ergebnisse – 0,40 Dollar pro akzeptiertem Ergebnis. Die billigere Aufgabengruppe liefert die teurere nutzbare Arbeit. Das sind hypothetische Zahlen, keine Messwerte für Grok.
Der Reasoning-Aufwand sollte ebenfalls Teil des Tests sein. Eine Einstellung mit hohem Aufwand kann bei schwierigen Aufgaben ihren Preis rechtfertigen und bei Routineaufgaben wenig bringen. Nur jene Fälle hochzustufen, die es benötigen, könnte wirtschaftlicher sein als jede Anfrage mit xhigh zu bearbeiten – sofern auch die Weiterleitung selbst bewertet wird.
Behalten Sie bei allen Modellen dieselben Prüfmaßstäbe bei. Eine niedrigere Messlatte für ein günstigeres Modell erzeugt scheinbare Einsparungen, indem schlechtere Arbeit akzeptiert wird. Nur beim bisherigen Modell die Messlatte höher zu legen, verzerrt das Ergebnis in die andere Richtung. Ziel ist ein verlässliches Ergebnis mit klarer Darstellung der verbleibenden menschlichen Arbeit.
Die Entwicklung, die es zu beobachten gilt
Grok 4.7 bietet Teams eine weitere Option zum Testen. Die Entscheidung dafür erfordert eine Betrachtung der ganzen Aufgabe: was das Modell erzeugt, was es verbraucht und was jemand noch korrigieren muss.
Die breitere Folge könnte ein gezielterer KI-Einsatz in der täglichen Arbeit sein. Ein Team könnte für Routineanalysen eine Konfiguration wählen, eine andere fürs schwierige Programmieren und einen Menschen für Fälle, in denen sich Beurteilung oder Verantwortung nicht delegieren lassen. Mehr Wettbewerb verschafft dem Team eine weitere Option zum Prüfen; er schreibt nicht vor, welche sich durchsetzen soll.
Für BIG CHANGE ist der nächste Meilenstein messbar erledigte Arbeit mit geringerem Gesamtaufwand. Wenn Grok 4.7 die Kosten akzeptierter Ergebnisse senkt, kann es nützliche Automatisierung für mehr Organisationen erschwinglich machen. Verschiebt zusätzlicher Denkaufwand die Kosten dagegen nur vom Tokenpreis zum Verbrauch, sagt der Schlagzeilenpreis Käufern wenig. Entscheidend sind Belege aus abgeschlossenen Aufgaben – auch aus jenen, die zunächst scheiterten.