Grok 4.7, 2026 సెప్టెంబర్ 21న అందుబాటులోకి వచ్చింది. కోడ్ రాయడానికి లేదా వ్యాపార సమాచారాన్ని విశ్లేషించడానికి AI కొనుగోలు చేసే బృందాలకు, ఈ విడుదల ఆచరణాత్మక ప్రశ్న వేస్తుంది: మెరుగైన మోడల్తో పూర్తయిన పని చౌకవుతుందా? సమాధానం ప్రకటించిన టోకెన్ ధరలకన్నా ఎక్కువ అంశాలపై ఆధారపడుతుంది. అధికారిక విడుదల గమనికలు
ఈ మిశ్రమ దృశ్యమే సెప్టెంబర్ 22న విడుదలైన Matthew Berman వీడియోలోని అంశం: Grok 4.7 గురించి నాకు ఏమనుకోవాలో తెలియడం లేదు…. పోలికల ఎంపికను ఆయన ప్రశ్నిస్తూ, టోకెన్ ధరలకన్నా పూర్తయిన పనికి అయ్యే ఖర్చు ముఖ్యమని వాదిస్తారు. మోడల్ను సమగ్రంగా పరీక్షించలేదనీ చెబుతారు. ఆయన వీడియో ఆధారాలపై ప్రాథమిక అంచనా మాత్రమే; సంపూర్ణ ప్రత్యక్ష వినియోగ మూల్యాంకనం కాదు. Berman పరిచయం, 0:00
ప్రతి బెంచ్మార్క్లో గెలవకపోయినా, ఆటోమేట్ చేయగల పనుల ఖర్చును మార్చే ఉపయోగకరమైన మోడల్ విడుదలకు ఎందుకు శ్రద్ధ ఇవ్వాలో ఇది చూపిస్తుంది. అయితే మొత్తం ఖర్చును సమర్థించడానికి, తగినంత పనిని సరిగ్గా పూర్తి చేయాలి. స్వతంత్ర పరీక్షలు ఇప్పటికే ఉన్న ఉద్రిక్తతను బయటపెడుతున్నాయి: Grok 4.7 మెరుగైన ఫలితాలతో పాటు చాలా ఎక్కువ వచనాన్ని రూపొందించవచ్చు.
డెవలపర్లు, చిన్న వ్యాపారాలు, ఏజెంట్లు నిర్మించే బృందాలకు నిర్ణయం ఆచరణాత్మకమైనది. ఆమోదయోగ్యమైన నాణ్యతతో ఈ మోడల్ ఏ పనులు పూర్తి చేయగలదు? ఎంత శ్రమ అవసరం? పని పూర్తయిందని మోడల్ చెప్పిన తర్వాత, ఒక వ్యక్తికి ఇంకా ఎంత పని మిగులుతుంది?
Berman సుమారు 17 నిమిషాల వీడియోకు సంబంధించిన పూర్తి శీర్షికలను పరిశీలించి, విడుదల ప్రకటన, ఉత్పత్తి డాక్యుమెంటేషన్, Artificial Analysis మూల్యాంకనాన్ని తనిఖీ చేశాం. దిగువ విశ్లేషణలో BIG CHANGE బెంచ్మార్క్ లేదు; Grokను స్వయంగా పరీక్షించామని చెప్పే వాదన కూడా లేదు.
ఏమి విడుదలైంది, ఎక్కడ అందుబాటులో ఉంది?
సాధారణ Grok 4.7 మోడల్ xAI APIలో అందుబాటులో ఉంది grok-4.7, అలాగే Cursor, Grok Buildలో. API వచనం, చిత్రాలను స్వీకరించి వచనాన్ని ఉత్పత్తి చేస్తుంది. డాక్యుమెంటేషన్ ప్రకారం సందర్భ విండో 500,000 టోకెన్లు; low, medium, high, xhigh అనే నాలుగు reasoning స్థాయిలు ఉన్నాయి. High డిఫాల్ట్. అధికారిక విడుదల గమనికలు
పెద్ద ప్రాథమిక మోడల్, మరింత కఠినమైన పనులపై ఎక్కువ reinforcement learning వల్ల పనితీరు మెరుగైందని SpaceXAI చెబుతుంది. ఇది డెవలపర్ ఇచ్చిన వివరణ. విడుదల సాంకేతిక అవలోకనం
Grok 4.7 Fast కూడా ఉంది. అదే మోడల్ను వేగవంతమైన మౌలిక సదుపాయాల్లో అందిస్తున్నారని, సాధారణ టోకెన్ ధరలకు రెండింతలు వసూలు చేస్తారని డాక్యుమెంటేషన్ వివరిస్తుంది. Cursor, Grok Buildలో అందుబాటులో ఉంది; Grok Build ఉచిత స్థాయిలో లేదు; బహిరంగ xAI APIలో అందుబాటులో లేదు. Grok 4.7 ఉత్పత్తి డాక్యుమెంటేషన్
స్క్రీన్షాట్లు, ప్రదర్శనలు, బిల్లులను పోల్చేటప్పుడు ఈ తేడాలు ముఖ్యం. మోడల్ వెర్షన్, reasoning స్థాయి, సర్వింగ్ స్థాయి వేర్వేరు ఎంపికలు. xhighలో Fast ఉపయోగించిన ప్రదర్శన, సాధారణ వేగం, మధ్యస్థ reasoningతో చేసే API అభ్యర్థన అనుభవానికి లేదా ఖర్చుకు అంచనా కాదు.
ఇతర మోడళ్లతో విడుదల పేజీ చేసిన పోలికను, అప్గ్రేడ్ పోలిక నుంచి వేరుగా చూడాలి. సాధారణ Grok 4.7 ధర, వేగం Grok 4.6తో సమానమని SpaceXAI చెబుతుంది. 4.6 నుంచి అప్గ్రేడ్ చేస్తే కస్టమర్ బిల్లు ఆటోమేటిక్గా సగమవుతుందని మాత్రం చెప్పదు.
ధరల పట్టికలో దీర్ఘ సందర్భానికి వేరే మెట్టు ఉంది
ప్రకటించిన సాధారణ API ధరలు:
- 200,000 prompt టోకెన్ల వరకు: ప్రతి మిలియన్ టోకెన్లకు ఇన్పుట్ $2, కాష్ చేసిన ఇన్పుట్ $0.50, అవుట్పుట్ $6.
- 200,000 prompt టోకెన్లకు మించి: ప్రతి మిలియన్ టోకెన్లకు ఇన్పుట్ $4, కాష్ చేసిన ఇన్పుట్ $1, అవుట్పుట్ $12.
ఇవి టోకెన్ ధరలు మాత్రమే; ఏజెంట్ ఒక పనిని పూర్తి చేయడానికి అయ్యే సమగ్ర ధరలు కావు. 200,000 టోకెన్లు మించిన అభ్యర్థనలకు ధర ఎక్కువవుతుందని మోడల్ పేజీ సూచిస్తుంది; అధిక ధరలను విడుదల గమనికలు నిర్దేశిస్తాయి. ధరలు, లభ్యతను సెప్టెంబర్ 22న తనిఖీ చేశాం. మోడల్ ధరలు మరియు విడుదల గమనికలు
అందువల్ల 500,000 టోకెన్ల సందర్భ విండోలోని ప్రతి అభ్యర్థనకు తక్కువ ధరే వర్తిస్తుందని కాదు. అలాగే పెద్ద సందర్భ విండో ఉందంటే, పెద్ద ఫైళ్ల సమూహంలో సంబంధిత ప్రతి వివరాన్నీ మోడల్ స్థిరంగా కనుగొంటుందని నిర్ధారణ కాదు.
Cursor పత్రాలు మరో ఉత్పత్తి-స్థాయి తేడాను చూపుతాయి: సాధారణ విండో 256,000 టోకెన్లు; గరిష్ఠం 500,000. ఎడిటర్లో కనిపించే సామర్థ్యం API స్పెసిఫికేషన్కు భిన్నంగా ఉండవచ్చు లేదా ఎంచుకున్న మోడ్పై ఆధారపడవచ్చు. Cursor Grok 4.7 డాక్యుమెంటేషన్
దీర్ఘ నివేదికలను ప్రాసెస్ చేసే బృందానికి, మొత్తం సమాచారాన్ని పంపితే ఖర్చుకు తగినంతగా ఫలితం మెరుగవుతుందా అన్నది తక్షణ ప్రశ్న. సంబంధిత భాగాలను మాత్రమే తిరిగి తీసుకోవడం చౌకగా, పరిశీలించడానికి సులభంగా ఉండవచ్చు. కొన్నిసార్లు పూర్తి పత్రం అవసరం; మరికొన్నిసార్లు prompt రూపొందించడానికి అదే సులభ మార్గం. ఈ సందర్భాలకు ఒకే రకమైన బడ్జెట్ వేయకూడదు.
మెరుగైన పనితీరుకు ఎక్కువ టోకెన్లు ఖర్చవచ్చు
Artificial Analysis సెప్టెంబర్ 21న చేసిన మూల్యాంకనంలో, xhighతో Grok 4.7కు Intelligence Indexలో 46 స్కోరు ఇచ్చింది—Grok 4.6కన్నా రెండు పాయింట్లు ఎక్కువ. ఒక్కో పనికి సుమారు 81,000 అవుట్పుట్ టోకెన్లు అవసరమయ్యాయని తెలిపింది; Grok 4.6 high స్థాయిలో 36,000 టోకెన్లు. అదే నివేదికలో Grok 4.6 xhigh స్థాయికి 38,000 టోకెన్లు ఉన్నాయి. కాబట్టి reasoning స్థాయి ఒకటే ఉన్న పోలికలోనూ అవుట్పుట్ టోకెన్లు రెట్టింపుకంటే ఎక్కువ. Artificial Analysis ప్రారంభ మూల్యాంకనం
టోకెన్ ధరను, పనికి అయ్యే ఖర్చును వేరుచూడడానికి ఇది స్పష్టమైన కారణం. బేస్ ధర అయిన ప్రతి మిలియన్ అవుట్పుట్ టోకెన్లకు $6 చొప్పున, 81,000 టోకెన్లకు ఉదాహరణ గణనలో అవుట్పుట్ ఛార్జీ $0.486. 38,000 టోకెన్లైతే $0.228. ఈ లెక్కల్లో ఇన్పుట్, కాష్ వినియోగం, సాధనాల ఛార్జీలు, అధిక సందర్భ ధర, విఫల ప్రయత్నాలు లేవు. ఇవి నివేదించిన టోకెన్ గణాంకాలతో చేసిన అంకగణితం; కొలిచిన సమగ్ర పని ధరలు కావు.
ఎక్కువ అవుట్పుట్ అంటే వృథా అని తప్పనిసరిగా కాదు. సమాధానాన్ని తనిఖీ చేయడానికి మోడల్ అదనపు శ్రమ పెట్టి, లేకపోతే మనిషి జోక్యం చేసుకోవాల్సిన వైఫల్యాన్ని నివారించవచ్చు. తప్పు మార్గాన్ని ఎక్కువసేపు అనుసరించవచ్చు కూడా. ఉత్పాదక పట్టుదలను, ఖరీదైన పునరావృతాన్ని టోకెన్ సంఖ్య ఒక్కటే వేరు చేయలేడు.
వీడియో చివరి భాగంలో Berman మళ్లీ ఈ సమస్యను ప్రస్తావిస్తూ, Artificial Analysis తెలిపిన అధిక టోకెన్ వినియోగాన్ని గమనిస్తారు. వీడియో, 15:43
ఉపయోగకరమైన ఫలితం అంటే ఆమోదయోగ్యమైన పనిని అందించడం. తగిన పరీక్షలు, సమీక్షలో ఉత్తీర్ణమైన కోడ్ మార్పు; సూత్రాలు సరిపోలే స్ప్రెడ్షీట్; ఆధారాలతో అనుసంధానమైన వాదనలున్న నివేదిక—ఇవన్నీ కేవలం త్వరగా వచ్చిన సమాధానంతో సమాన విలువ కలిగినవి కావు.
బెంచ్మార్క్లు సామర్థ్యం ఉన్నా అసమానమైన మోడల్ను చూపుతున్నాయి
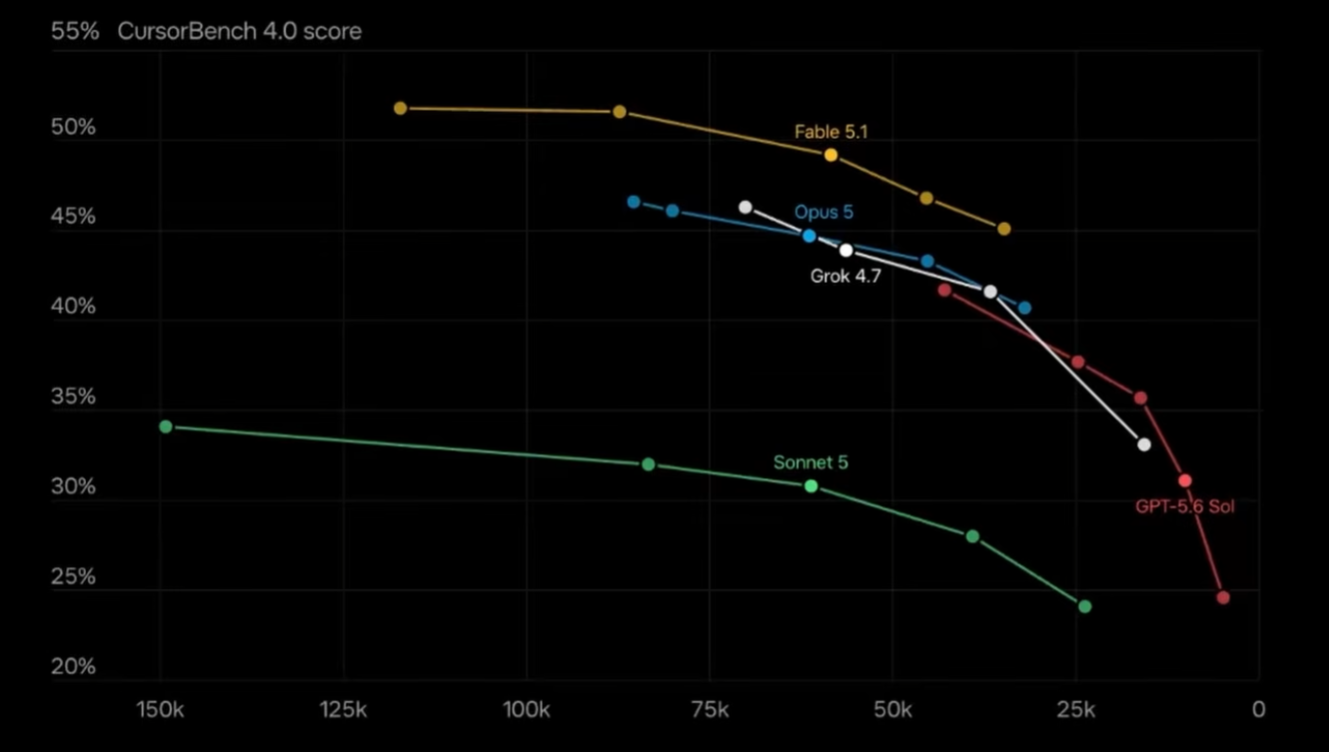
విడుదల పట్టికలో CursorBench 4.0లో xhigh Grok 4.7కు 46.3% ఉంది; Fable 5.1 max సాధించిన 51.8% కన్నా తక్కువ. Terminal-Bench పోలికలోనూ Fable ముందుంది. విక్రేత అందించిన బెంచ్మార్క్ పట్టిక
పక్కనున్న చార్ట్ బెంచ్మార్క్ స్కోరును అవుట్పుట్ టోకెన్లతో పోలుస్తుంది; కుడివైపు వెళ్తే టోకెన్లు తగ్గుతాయి. దాని గీతలు reasoning స్థాయిలను పోలుస్తాయి. అసలు ఇంటరాక్టివ్ చార్ట్: Tokens ఎంచుకోండి. పూర్తి పరిమాణంలో చార్ట్ తెరవండి.
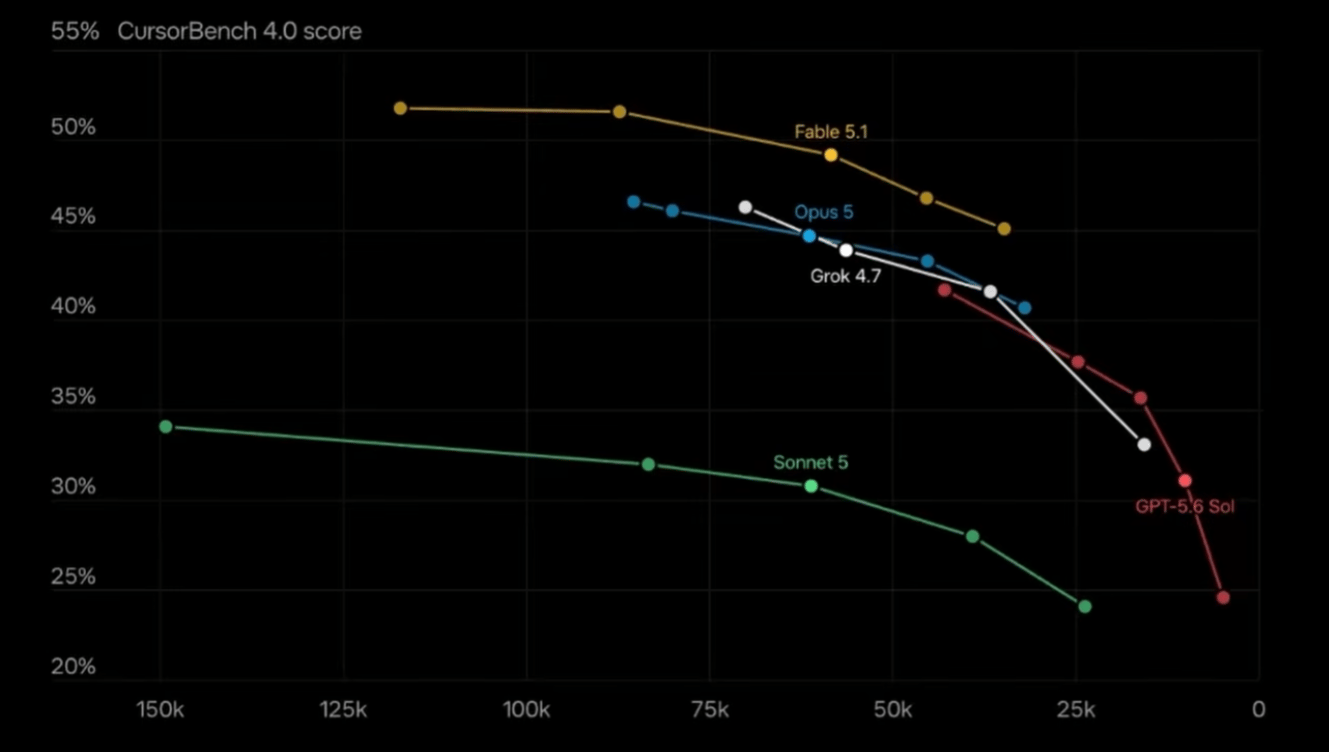
పైకి వెళ్తే స్కోరు పెరుగుతుంది; కుడికి వెళ్తే ఈ మూల్యాంకనంలో రూపొందించిన టోకెన్లు తగ్గుతాయి. అందువల్ల సమగ్ర ధర తగ్గుతుందని కాదు: టోకెన్ రేట్లు, ఇన్పుట్ వినియోగం, చుట్టూ పనిచేసే ఏజెంట్ కూడా ముఖ్యం. ఇది పైనున్న Artificial Analysis టోకెన్ గణాంకాలకన్నా వేరే పరీక్ష. రెండు చోట్ల గణాంకాలు కలిపితే, ఫలితాలను అర్థం చేసుకునే పనులు, పద్ధతుల తేడా చెరిగిపోతుంది.
ప్రతి రకమైన కోడింగ్ పనిలో Grok 4.7 ముందుందని సాధారణంగా చెప్పడానికి ఈ ఆధారం సరిపోదు. కొన్ని ప్రత్యేక పనులను మరింత దగ్గరగా పరిశీలించడానికి మాత్రం సరిపోతుంది. ఒక పరీక్షలో వచ్చిన మెరుగుదల పరిమాణం, పరిచయం లేని కోడ్ రిపాజిటరీ, అసంపూర్ణ లోప నివేదిక లేదా అరుదైన సాధనాల వాతావరణంలో మోడల్ ఎలా పనిచేస్తుందో నిర్ణయించదు.
Artificial Analysis మరో ఉపయోగకరమైన తేడాను చూపుతుంది. Grok Buildతో Grok 4.7కు Coding Agent Indexలో 56 స్కోరు ఇచ్చింది; అదే ఏజెంట్తో Grok 4.6కు 47. ఈ స్థానిక ఏజెంట్ ఫలితాలను ప్రామాణిక Intelligence Index పరీక్షా అమరిక నుంచి వేరుగా స్పష్టంగా పేర్కొంది. స్వతంత్ర మూల్యాంకనం, పద్ధతి గమనికలు
చుట్టూ ఉన్న ఏజెంట్ కూడా ముఖ్యం. అది సాధనాలను అందిస్తుంది, సందర్భాన్ని నిర్వహిస్తుంది, మోడల్ అభ్యర్థనలను ఎలా అమలు చేయాలో నిర్ణయిస్తుంది. మోడల్ పేరు అలాగే ఉన్నా ఈ వాతావరణం మారితే ఫలితాలూ మారవచ్చు. ఒక అమరికలోని టెర్మినల్ స్కోరును, మరో అమరికలోని సాఫ్ట్వేర్ ఇంజినీరింగ్ స్కోరుతో కలిపితే, ఎవరూ నిజంగా పరీక్షించని వ్యవస్థను వివరించే నమ్మదగిన పట్టిక తయారవుతుంది.
ఒక విడుదల పట్టికలో GPT-6 Astra లేకపోవడాన్ని Berman గుర్తించి, దాన్ని చేర్చేందుకు AI రూపొందించిన పునర్నిర్మాణాన్ని ఉపయోగిస్తారు. పోలికను పరిశీలించాలనే సూచనగా అది ఉపయోగకరం; ఆ పునర్నిర్మాణం స్వతంత్ర బెంచ్మార్క్ ఆధారం కాదు. అంతర్లీన మూల్యాంకనాన్ని తనిఖీ చేయకుండా అందులో చేర్చిన గణాంకాలను మేము స్వీకరించం. వీడియో, 6:03
గమనించాల్సిన వాణిజ్య సంబంధమూ ఉంది. Cursor ఆగస్టు 14 కంపెనీ ప్రకటన ప్రకారం SpaceX దాన్ని కొనుగోలు చేసింది. అదే కార్పొరేట్ కుటుంబంలో ప్రచురించిన బెంచ్మార్క్ ఉపయోగకరమైన ఆధారమే; కానీ పోటీదారు సరఫరాదారుపై ఆసక్తిలేని అంచనా కాదు. Cursor కొనుగోలు ప్రకటన
కార్యాలయ పని మరింత ఆసక్తికరమైన అవకాశం కావచ్చు
స్వతంత్ర మూల్యాంకనంలో xhigh Grok 4.7కు AA-Briefcaseలో 1,657 Elo స్కోరు ఉంది—Grok 4.6 high కన్నా 111 ఎక్కువ. ఈ మెరుగుదలలో ఎక్కువ భాగం విశ్లేషణ నాణ్యత వల్ల వచ్చిందని, ప్రదర్శన నాణ్యత మాత్రం మునుపటి మోడల్ ఫలితంకన్నా కొద్దిగా తక్కువని అది పేర్కొంది. జ్ఞానపని ఫలితాలపై Artificial Analysis
నివేదికలు, స్ప్రెడ్షీట్లు, ప్రెజెంటేషన్లు తయారు చేయించేవారికి ఈ విభజన ఉపయోగకరం. సమాధానంలో విశ్లేషణ బలంగా ఉన్నా, దిద్దుబాటు లేదా కొత్త రూపకల్పన అవసరమవచ్చు. మెరుగ్గా కనిపించే స్లైడ్లు బలహీనమైన తర్కాన్ని దాచవచ్చు కూడా. బయటకు కనిపించే తుది రూపాన్నే అంచనా వేస్తే, తప్పు మెరుగుదలకు బహుమతి ఇచ్చినట్టవుతుంది.
కార్యాచరణల బృందం పునరావృతమయ్యే పనితీరు నివేదికపై మోడల్ను పరీక్షించవచ్చు. అది సరైన కాలవ్యవధిని వాడుతోందా, మూల డేటాతో గణాంకాలను సరిపోలుస్తోందా, గమనించిన మార్పును ప్రతిపాదిత వివరణ నుంచి వేరుచేస్తోందా అని ఉపయోగకరమైన ట్రయల్లో తనిఖీ చేయాలి. మొదటి చూపులో నివేదిక వృత్తిపరంగా కనిపించిందా అన్నదే కాకుండా, ఎంత దిద్దుబాటు అవసరమైందో సమీక్షకుడు నమోదు చేయాలి.
అత్యంత కఠినమైన బెంచ్మార్క్ గెలవడంకన్నా, ఇంతవరకు భరించలేని విశ్లేషణను క్రమం తప్పకుండా అందుబాటులోకి తేవడం చిన్న వ్యాపారానికి ముఖ్యం కావచ్చు. విస్తృత స్వీకరణకు ఇది సాధ్యమైన మార్గం. ఫలితం తగినంత కచ్చితంగా ఉండి, సమయానికి చేరి, యజమాని స్వయంగా పని చేయడంకన్నా తక్కువ శ్రమ మిగిల్చినప్పుడే ఇది వాస్తవమవుతుంది.
వృత్తిపరమైన బెంచ్మార్క్ పేర్లను వృత్తిపరమైన అర్హతలుగా భావించకూడదు. న్యాయపని లేదా వైద్య తర్కం పరీక్షలో వచ్చిన ఫలితం ఆ మూల్యాంకనంలోని పనితీరునే వివరిస్తుంది. కస్టమర్ న్యాయ వ్యవహారాన్ని స్వతంత్రంగా నిర్వహించగలదని లేదా రోగి సంరక్షణ నిర్ణయం తీసుకోగలదని నిరూపించదు. ఆ నిర్ణయాల కోసం Grok వాడాలని ఈ వ్యాసం సిఫారసు చేయదు.
భద్రతా చర్యల వాదనలనూ సందర్భంలో పరిశీలించాలి
Grok 4.7లో కొత్త రక్షణల సమాహారం, jailbreak దాడులను మరింత నిరోధించే సామర్థ్యం ఉన్నాయని SpaceXAI చెబుతుంది. ఇది విడుదల సమయంలో చేసిన వాదన మాత్రమే; మోడల్ను ఉపయోగించే ప్రతి అనువర్తనం సురక్షితమని హామీ కాదు. భద్రతపై డెవలపర్ వివరణ
వ్యాపార ఏజెంట్ విషయంలో కనీసం రెండు ప్రశ్నలు మిగులుతాయి. అందుకున్న అభ్యర్థనలకు మోడల్ తగిన విధంగా స్పందిస్తుందా? మోడల్ వాస్తవంగా ఏమి చేయగలదో అనువర్తనం పరిమితం చేస్తుందా?
కస్టమర్ రికార్డు మార్చమనే సూచనను మోడల్ సరిగ్గా అర్థం చేసుకున్నా, ఆ మార్పు చేయడానికి దానికి అనుమతి లేకపోవచ్చు. సారాంశం చేయాల్సిన పత్రంలో పొందుపరిచిన హానికర సూచనలూ ఎదురుకావచ్చు. ప్రాప్యత నియంత్రణలు, ఆమోద నియమాలు చుట్టూ ఉన్న వ్యవస్థలో భాగంగానే ఉండాలి; నిరాకరణ ప్రవర్తన మెరుగుపడటం వాటికి ప్రత్యామ్నాయం కాదు.
ఆచరణలో మొత్తం పని ప్రవాహాన్ని పరీక్షించాలి. విజయవంతం కావాల్సిన చట్టబద్ధ అభ్యర్థనలు, నిరోధించాల్సిన నిషేధిత చర్యలు, స్పష్టత కోసం ఆగాల్సిన సందిగ్ధ సందర్భాలు చేర్చాలి. హానిలేని పనిని తరచూ తిరస్కరించే ఉత్పత్తి ఉపయోగించలేనిదవుతుంది; అనుమతి లేని చర్యలను అమలు చేసేది మరింత ప్రమాదకరం. ఒక్క ముఖ్య స్కోరు ఈ రెండింటినీ పట్టుకోదు.
వీడియోలో సమాధానం లేని ప్రశ్నలు
Berman విశ్లేషణలో ఉన్న పలు విషయాలను ప్రశ్నలుగానే ఉంచాలి. అందుబాటులోని కంప్యూట్ సామర్థ్యాన్ని ధరతో అనుసంధానించే ఆయన వివరణ, మార్కెట్ అంచనా మాత్రమే; ఒక్కో యూనిట్ ఖర్చు లెక్కల వెల్లడి కాదు. ఆయన చెప్పే సామాజిక మాధ్యమ అంచనాలు, అందించిన పనితీరుకు ఆధారాలు కాకుండా భవిష్యత్ నిరీక్షణలు. ఉపయోగించిన సెట్టింగ్లు తనకు తెలియవని అంగీకరిస్తూనే, చివర్లో ప్రదర్శనలను పోలుస్తారు. ధరల చర్చ, 8:44, అంచనాలు, 11:51 మరియు ప్రదర్శన చర్చ, 15:20
వీడియో ఓపెన్-వెయిట్ మోడళ్ల గురించీ మాట్లాడుతుంది. ఆ విస్తృత పోటీ ధోరణిని Grok 4.7 లైసెన్సింగ్తో కలపకూడదు: ఈ విడుదలను యాజమాన్య మోడల్గా Artificial Analysis గుర్తించి, దాని weights అందుబాటులో లేవని పేర్కొంది. Grok 4.7 విడుదల వివరాలు
ఈ తేడాలు మూల్యాంకనాన్ని కేంద్రీకరిస్తాయి. సరఫరాదారు ధర ఎందుకు నిర్ణయించాడో ప్రజలకు తెలియకపోయినా ఉత్పత్తి ఆకర్షణీయ ధరకు రావచ్చు. ఆశ్చర్యపరిచే విఫల ప్రదర్శన పునరావృతం చేయదగ్గ పరీక్షను సూచించవచ్చు; కానీ మోడల్ సాధారణంగా బలహీనమని నిరూపించదు. అందుబాటులో ఉన్న మోడల్, వ్యవస్థాపకుడి పాత అంచనాకు సరిపోకపోయినా ఉపయోగకరంగా ఉండవచ్చు.
ప్రాయోజకత్వానికీ ఒక హద్దు ఉంది. Berman వీడియోలో Zapier ప్రకటన ఉంటుంది. అది Grok పనితీరుకు స్వతంత్ర ఆధారం కాదు; ప్రకటనలోని వాదనలు BIG CHANGE సిఫారసులూ కావు.
మెరుగైన కొనుగోలు కొలమానం: ఆమోదిత పనికి అయ్యే ఖర్చు
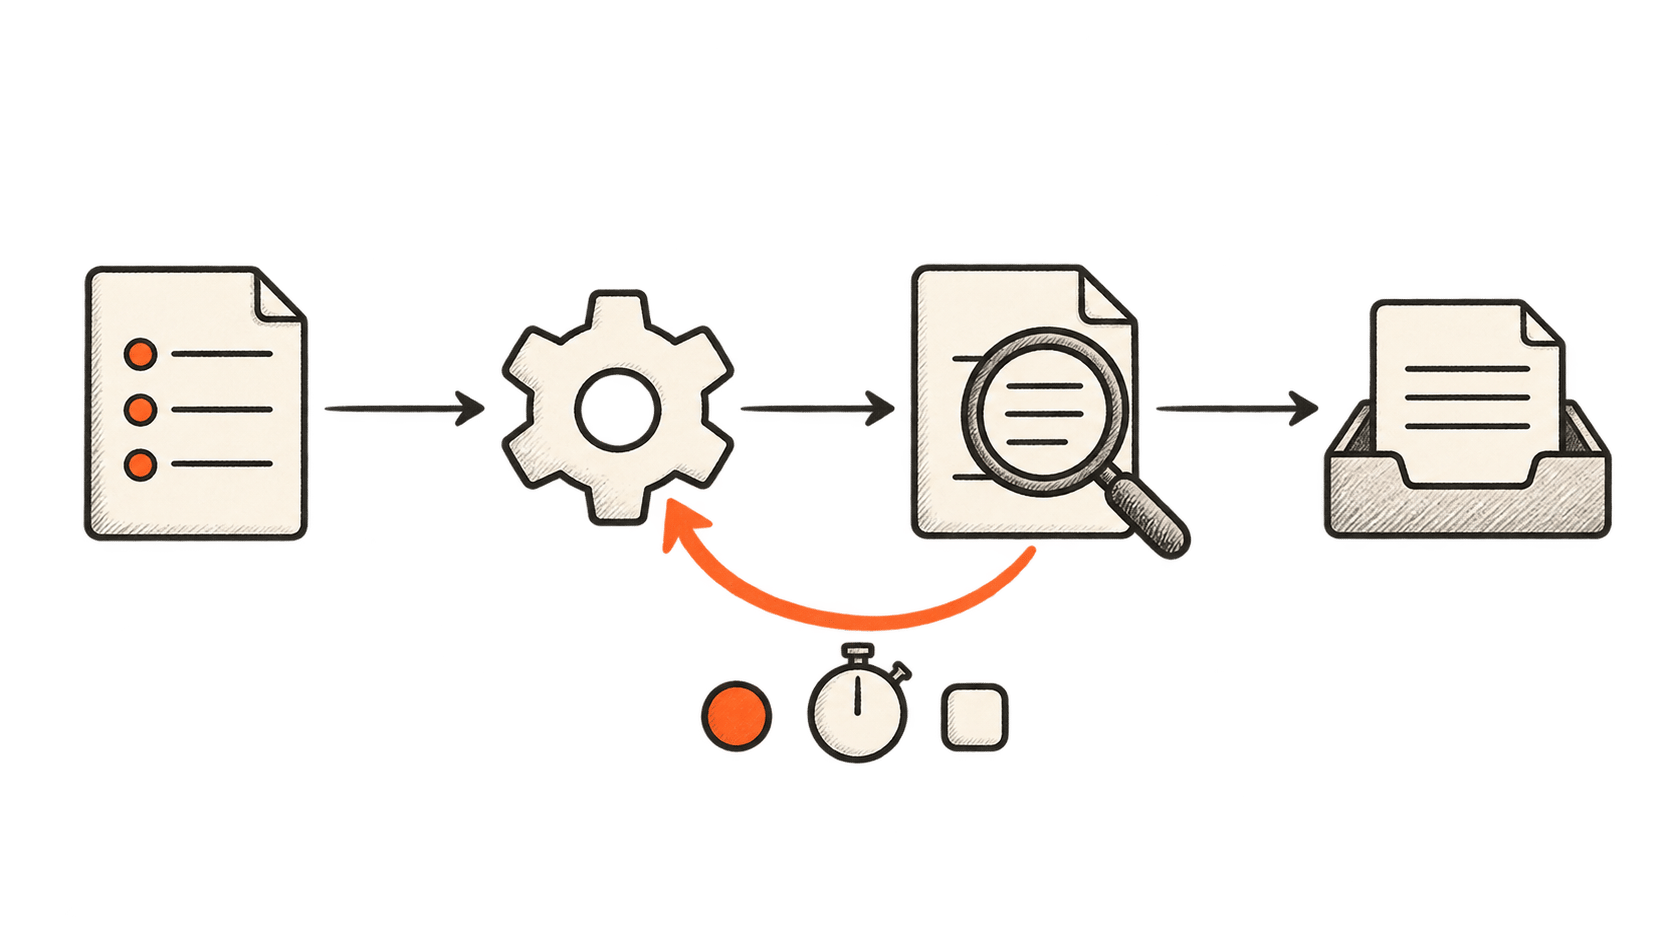
Grok 4.7ను పరిశీలించే బృందం, చిన్నదైనా ప్రతినిధి పనుల సమూహంలో దాన్ని ప్రస్తుత విధానంతో పోల్చాలి. ఫలితాలు చూడకముందే ఆమోద ప్రమాణాలను నిర్వచించాలి. కోడింగ్కు సంబంధిత పరీక్షలు, చదవగల మార్పు, సంబంధం లేని మార్పులు లేకపోవడం వాటిలో ఉండవచ్చు. విశ్లేషణకు సరైన లెక్కలు, ముఖ్యమైన వాదనలకు ఆధారాలు అవసరం కావచ్చు.
తర్వాత పూర్తి బిల్లును నమోదు చేయండి: ఇన్పుట్, అవుట్పుట్ వినియోగం, సాధనాలు, మళ్లీ చేసిన ప్రయత్నాలు, ఫలితాన్ని తనిఖీ చేయడానికి లేదా సరిచేయడానికి పట్టిన సమయం. విఫల ప్రయత్నాలనూ లెక్కించండి. ఆమోద ప్రమాణాలు అందుకున్న ఫలితాల సంఖ్యతో మొత్తం ఖర్చును భాగించండి.
ఈ తేడా ఎందుకు ముఖ్యమో ఒక ఉదాహరణ చూపుతుంది. ఒక అమరిక ఒక బ్యాచ్కు $20 ఖర్చుచేసి, ఆమోదిత 80 ఫలితాలు ఇచ్చిందనుకుందాం. మానవ శ్రమకు ముందు, ఒక్కో ఆమోదిత ఫలితానికి $0.25. మరొక అమరిక $12 ఖర్చుచేసి 30 ఫలితాలే ఇస్తే, ఒక్కో దానికి $0.40 అవుతుంది. చౌకైన బ్యాచ్, ఉపయోగించగల పని పరంగా ఖరీదైనదవుతుంది. ఇవి ఊహాత్మక సంఖ్యలు; Grok కొలతలు కావు.
ఈ ట్రయల్లో reasoning స్థాయినీ చేర్చాలి. కఠినమైన పనికి అధిక స్థాయి ఖర్చును సమర్థించవచ్చు; సాధారణ పనికి దానివల్ల పెద్దగా ప్రయోజనం లేకపోవచ్చు. ప్రతి అభ్యర్థనను xhighలో నడిపే బదులు, అవసరమైన వాటినే ఆ స్థాయికి పెంచడం చౌక కావచ్చు; అయితే ఏ పనిని పెంచాలనే నిర్ణయాన్నీ పరీక్షించాలి.
మోడళ్లన్నింటికీ సమీక్ష ప్రమాణాలను ఒకేలా ఉంచండి. చౌక మోడల్కు ప్రమాణం తగ్గిస్తే, నాసిరకం పనిని అంగీకరించడం ద్వారా వచ్చినట్టు కనిపించే పొదుపు మాత్రమే మిగులుతుంది. ప్రస్తుత మోడల్కే అధిక ప్రమాణం పెట్టడం కూడా పోలికను వక్రీకరిస్తుంది. ప్రజలు ఇంకా చేయాల్సిన పనిని స్పష్టంగా లెక్కపెట్టి, నమ్మదగిన ఫలితాన్ని కొనడమే లక్ష్యం.
గమనించాల్సిన మార్పు
Grok 4.7 బృందాలకు పరీక్షించేందుకు మరో ఎంపికను ఇస్తుంది. దాన్ని ఎంచుకునే ముందు మొత్తం పనిని చూడాలి: మోడల్ ఏమి ఉత్పత్తి చేస్తుంది, ఏమి వినియోగిస్తుంది, ఇంకా ఏమి మనిషి సరిచేయాలి.
దైనందిన పనిలో AIని మరింత ఎంపికగా ఉపయోగించడం విస్తృత ప్రభావం కావచ్చు. సాధారణ విశ్లేషణకు ఒక అమరిక, కఠినమైన కోడింగ్కు మరొకటి, తీర్పు లేదా జవాబుదారీతనాన్ని అప్పగించలేని సందర్భాలకు మనిషి—అని బృందం ఎంచుకోవచ్చు. పెరిగిన పోటీ పరీక్షించేందుకు మరో ఎంపిక ఇస్తుంది; ఏది గెలవాలో మాత్రం నిర్దేశించదు.
BIG CHANGE దృష్టిలో తదుపరి మైలురాయి, తక్కువ మొత్తం శ్రమతో కొలవగల పనిని పూర్తి చేయడం. Grok 4.7 ఆమోదిత ఫలితాల ఖర్చును తగ్గిస్తే, ఉపయోగకరమైన ఆటోమేషన్ను మరిన్ని సంస్థలకు అందుబాటులోకి తేవచ్చు. అదనపు reasoningతో టోకెన్ ధరలోని ఖర్చు ఎక్కువ వినియోగానికి మాత్రమే మారితే, ప్రకటనలోని ధర కొనుగోలుదారులకు పెద్దగా ఏమీ చెప్పదు. మొదట విఫలమైన ప్రయత్నాలతో సహా, పూర్తయిన పనులే దానికి సమాధానం ఇస్తాయి.