وصل Grok 4.7 في 21 سبتمبر 2026. ويطرح إصداره سؤالاً عملياً على الفرق التي تشتري الذكاء الاصطناعي لكتابة الشيفرات أو تحليل معلومات الأعمال: هل يجعل النموذج الأفضل العمل المنجز أرخص؟ لا تتوقف الإجابة على أسعار الرموز المعلنة وحدها. ملاحظات الإصدار الرسمية
وهذه الصورة المتباينة هي موضوع فيديو Matthew Berman الصادر في 22 سبتمبر، « لا أعرف كيف أشعر تجاه Grok 4.7…». فهو يشكك في اختيار المقارنات ويرى أن تكلفة المهمة المكتملة أهم من أسعار الرموز. ويقول أيضاً إنه لم يختبر النموذج اختباراً شاملاً. لذا يقدم الفيديو تقييماً أولياً للأدلة، لا تقييماً عملياً شاملاً. مقدمة Berman، 0:00
يستحق الإطلاق الاهتمام لأن النموذج المفيد لا يحتاج إلى الفوز بكل اختبار معياري ليغير ما تستطيع الشركات تحمّل أتمتته. لكنه يحتاج إلى إنجاز ما يكفي من العمل بدقة لتبرير تكلفته الإجمالية. وتكشف الاختبارات المستقلة هذا التوتر بالفعل: فقد تأتي نتائج Grok 4.7 الأفضل مع إنتاج قدر أكبر بكثير من النص.
لذلك فالقرار عملي للمطورين والشركات الصغيرة والفرق التي تبني الوكلاء: ما المهام التي يستطيع هذا النموذج إنجازها بجودة مقبولة؟ وما مقدار الجهد الذي يحتاج إليه؟ وكم من العمل يظل على عاتق الإنسان بعد أن يقول النموذج إنه انتهى؟
راجعنا التسميات التوضيحية الكاملة لفيديو Berman الذي تبلغ مدته نحو 17 دقيقة، وتحققنا من الإطلاق ووثائق المنتج وتقييم Artificial Analysis. ولا يتضمن التحليل أدناه اختباراً معيارياً أجرته BIG CHANGE أو ادعاءً بأننا اختبرنا Grok بأنفسنا.
ما الذي أُطلق وأين يتوفر؟
يتوفر النموذج القياسي عبر واجهة xAI البرمجية باسم grok-4.7، وكذلك في Cursor وGrok Build. وتقبل الواجهة النصوص والصور وتنتج نصاً. وتبلغ نافذة السياق الموثقة 500 ألف رمز، مع أربعة إعدادات للاستدلال: منخفض ومتوسط وعالٍ وفائق الارتفاع (xhigh). والإعداد الافتراضي هو العالي. ملاحظات الإصدار الرسمية
تعزو SpaceXAI التحسن إلى نموذج أساسي أكبر وتدريب تعزيزي أطول على مهام أصعب. وهذا تفسير المطور. نظرة تقنية على الإطلاق
وثمة أيضاً Grok 4.7 Fast. وتصفه الوثائق بأنه النموذج نفسه على بنية أسرع، بسعر يعادل ضعفي أسعار الرموز القياسية. وهو متاح عبر Cursor وGrok Build، ومستثنى من الفئة المجانية في Grok Build، وغير متاح عبر واجهة xAI البرمجية العامة. وثائق منتج Grok 4.7
تكتسب هذه الفروق أهمية عند مقارنة لقطات الشاشة والعروض والفواتير. فإصدار النموذج ومستوى الاستدلال وفئة تقديم الخدمة خيارات منفصلة. ولا يمثل عرض يعمل بإصدار Fast عند مستوى xhigh تقديراً لتجربة أو تكلفة استدعاء واجهة برمجية قياسية بمستوى جهد متوسط.
وينبغي أيضاً فصل مقارنة صفحة الإطلاق مع النماذج الأخرى عن المقارنة بين التحديثين. تقول SpaceXAI إن سعر Grok 4.7 القياسي وسرعته يماثلان Grok 4.6. لكنها لا تقول إن الترقية من الإصدار 4.6 ستخفض فاتورة العميل إلى النصف تلقائياً.
بطاقة الأسعار تتضمن عتبة للسياق الطويل
الأسعار المنشورة للواجهة القياسية هي:
- حتى 200 ألف رمز إدخال: دولاران للإدخال، و0.50 دولار للإدخال المخزن مؤقتاً، و6 دولارات للإخراج لكل مليون رمز.
- أكثر من 200 ألف رمز إدخال: 4 دولارات للإدخال، ودولار واحد للإدخال المخزن مؤقتاً، و12 دولاراً للإخراج لكل مليون رمز.
هذه أسعار للرموز، وليست تكلفة شاملة لوكيل ينجز مهمة. وتشير صفحة النموذج إلى أسعار أعلى للطلبات التي تتجاوز 200 ألف رمز، كما تحدد ملاحظات الإصدار الأسعار الأعلى. وتحققنا من الأسعار والإتاحة في 22 سبتمبر. أسعار النموذج و ملاحظات الإصدار
لذلك لا تعني نافذة السياق البالغة 500 ألف رمز أن كل طلب ضمنها يخضع لأدنى سعر. كما لا تثبت نافذة السياق الكبيرة أن النموذج سيعثر بانتظام على كل تفصيل ذي صلة في مجموعة كبيرة من الملفات.
وتضيف Cursor تمييزاً آخر على مستوى المنتج: إذ تسرد وثائقها نافذة قياسية من 256 ألف رمز وحداً أقصى قدره 500 ألف. وقد تختلف السعة المتاحة في المحرر عن مواصفات الواجهة البرمجية أو تتوقف على الوضع المختار. وثائق Grok 4.7 في Cursor
بالنسبة إلى فريق يعالج تقارير مطولة، يكون السؤال المباشر: هل يؤدي إرسال كل المواد إلى تحسين النتيجة بما يكفي لتبرير التكلفة؟ قد يكون استرجاع الأقسام ذات الصلة أرخص وأسهل للفحص. وأحياناً تكون الوثيقة كاملة ضرورية؛ وأحياناً يكون ذلك أسهل طريقة لصياغة الطلب فحسب. وينبغي ألا تُدرج الحالتان في الميزانية كما لو كانتا متماثلتين.
الأداء الأفضل قد يستهلك رموزاً أكثر
في تقييم Artificial Analysis الصادر في 21 سبتمبر، حصل Grok 4.7 بإعداد xhigh على 46 نقطة في مؤشر الذكاء، أي أعلى بنقطتين من Grok 4.6 عند إعداد الجهد العالي. ويذكر التقييم نحو 81 ألف رمز إخراج لكل مهمة، مقارنةً بـ36 ألفاً لـGrok 4.6 عند الجهد العالي. ويورد التقرير نفسه 38 ألف رمز لـGrok 4.6 بإعداد xhigh، ما يعني أن المقارنة حتى مع مستوى الجهد نفسه تظهر أكثر من ضعف عدد رموز الإخراج. تقييم الإطلاق من Artificial Analysis
وهذا سبب ملموس للفصل بين سعر الرمز وتكلفة المهمة. فاستخدام 81 ألف رمز إخراج بالسعر الأساسي، البالغ 6 دولارات لكل مليون، ينتج عنه رسم إرشادي قدره 0.486 دولار. أما 38 ألف رمز فتعادل 0.228 دولار. وتستبعد هذه الحسابات عمداً الإدخال وسلوك التخزين المؤقت ورسوم الأدوات والأسعار الأعلى للسياق والمحاولات الفاشلة. وهي عملية حسابية تستند إلى أعداد الرموز المذكورة، لا أسعاراً شاملة مقاسة لإنجاز مهمة.
ولا يعني الإخراج الأكبر هدراً تلقائياً. فقد يبذل النموذج جهداً إضافياً للتحقق من الإجابة ويتجنب إخفاقاً كان سيتطلب تدخلاً بشرياً. وقد يطيل أيضاً العمل على نهج خاطئ. ولا يكفي عدد الرموز وحده للتمييز بين المثابرة المفيدة والتكرار المكلف.
ويعود Berman إلى هذه المشكلة قرب نهاية الفيديو، حين يلاحظ ارتفاع استهلاك الرموز الذي أبلغت عنه Artificial Analysis. الفيديو، 15:43
والنتيجة المفيدة هي مخرج مقبول للتسليم. فتغيير في الشيفرة يجتاز الاختبارات والمراجعة المناسبة، أو جدول بيانات تتطابق معادلاته، أو تقرير تستند ادعاءاته إلى الأدلة، له قيمة تختلف عن إجابة تصل بسرعة فحسب.
الاختبارات المعيارية تُظهر نموذجاً قادراً لكن أداءه متفاوت
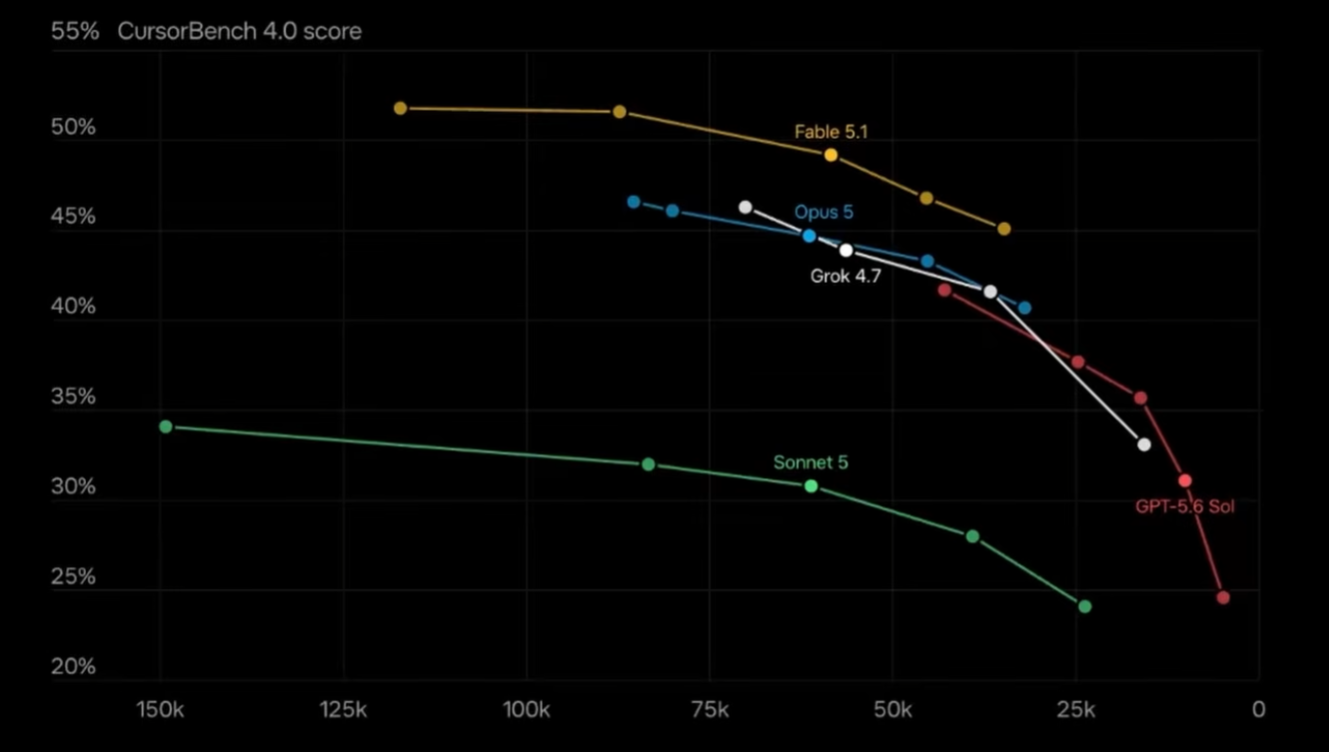
يعرض جدول الإطلاق نتيجة 46.3% لـGrok 4.7 عند إعداد xhigh في CursorBench 4.0، مقابل 51.8% لـFable 5.1 عند إعداد max. كما يتصدر Fable مقارنة Terminal-Bench. جدول اختبارات الشركة
ويرسم المخطط المصاحب درجة الاختبار مقابل رموز الإخراج، متجهاً إلى الأسفل نحو اليمين. وتقارن خطوطه إعدادات الاستدلال. المخطط التفاعلي الأصلي: اختر Tokens. افتح المخطط بالحجم الكامل.
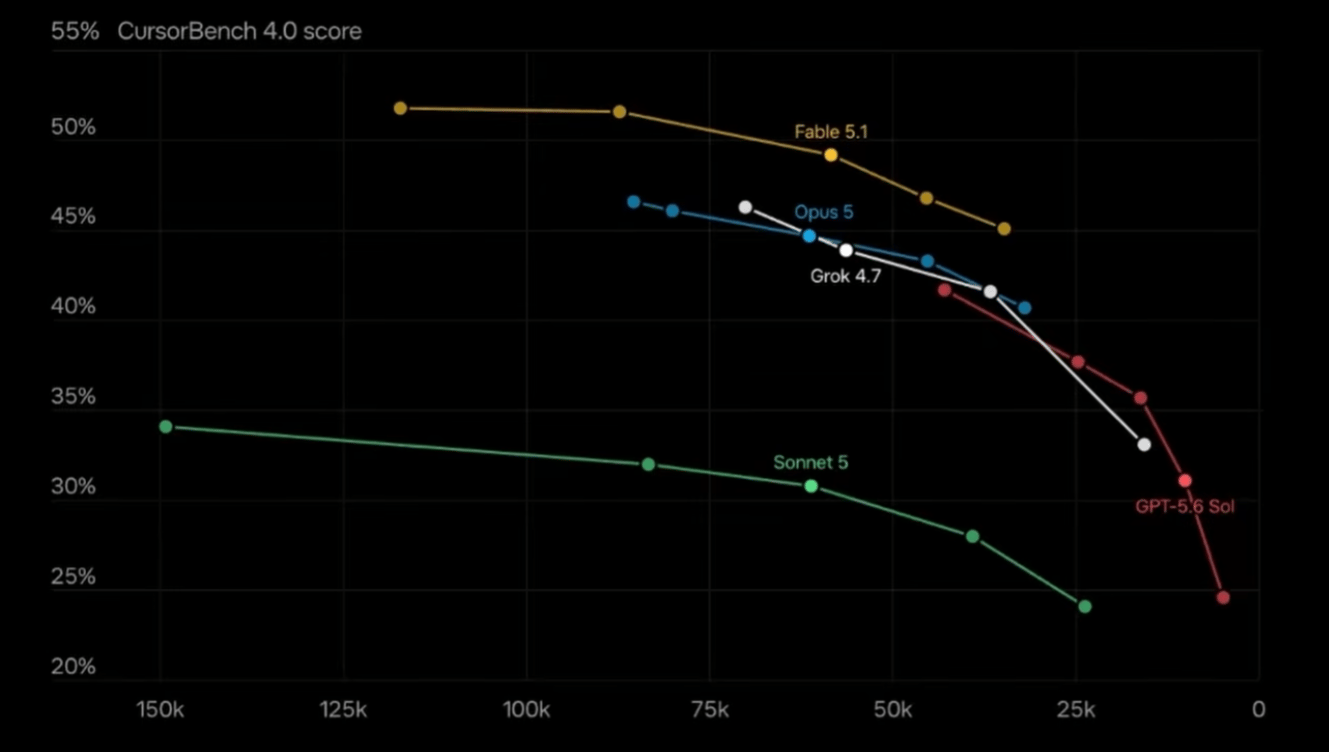
يعني التحرك إلى أعلى درجةً أعلى؛ ويعني التحرك إلى اليمين رموزاً مولدة أقل في هذا التقييم. لكنه لا يعني انخفاض التكلفة الإجمالية: فما زالت أسعار الرموز واستهلاك الإدخال والوكيل المحيط بالنموذج مهمة. وهذا أيضاً اختبار مختلف عن أرقام الرموز الصادرة عن Artificial Analysis أعلاه. ودمج أعدادها سيمحو اختلافات المهمة والمنهجية التي تجعل كل نتيجة قابلة للتفسير.
يكفي ذلك لرفض الادعاء المطلق بأن Grok 4.7 يتصدر كل أنواع أعمال البرمجة. كما يكفي لتبرير النظر عن قرب في أعباء عمل محددة. فحجم التحسن في تقييم واحد لا يحدد كيفية تعامل النموذج مع مستودع برمجي غير مألوف أو بلاغ عن خطأ ناقص أو بيئة أدوات غير اعتيادية.
وتقدم Artificial Analysis تمييزاً مستقلاً مفيداً. إذ يمنح تقريرها Grok 4.7 مع Grok Build درجة 56 في مؤشر وكيل البرمجة، ارتفاعاً من 47 لـGrok 4.6 مع الوكيل نفسه. ويفصل التقرير صراحةً نتائج الوكيل الأصلي عن إعداد مؤشر الذكاء المعياري. ملاحظات التقييم المستقل والمنهجية
الوكيل المحيط بالنموذج مهم أيضاً. فهو يزوده بالأدوات ويدير السياق ويقرر كيفية تنفيذ طلباته. وقد يؤدي تغيير البيئة إلى تغيير النتائج حتى مع بقاء اسم النموذج نفسه. وقد ينشئ دمج درجة طرفية من إعداد ودرجة هندسة برمجيات من إعداد آخر جدولاً مقنعاً لا يصف أي نظام اختبره أحد فعلياً.
يشير Berman إلى غياب GPT-6 Astra عن أحد جداول الإطلاق، ويستخدم إعادة بناء مولّدة بالذكاء الاصطناعي لإضافته. وهذا مفيد بوصفه دافعاً لفحص المقارنة، لكن إعادة البناء ليست مصدراً مستقلاً للاختبارات المعيارية. ولا نعتمد الأرقام المضافة من دون التحقق من التقييم الأساسي. الفيديو، 6:03
وثمة علاقة تجارية ينبغي أخذها في الحسبان أيضاً. يذكر إعلان Cursor للشركة بتاريخ 14 أغسطس أنها استُحوذ عليها من SpaceX. وتظل الاختبارات المنشورة ضمن عائلة المنتجات نفسها أدلة مفيدة، لكنها ليست تقييماً محايداً لمورد منافس. إعلان استحواذ Cursor
قد يكون العمل المكتبي الفرصة الأهم
يفيد التقييم المستقل بحصول Grok 4.7 بإعداد xhigh على 1,657 نقطة Elo في اختبار AA-Briefcase، أي أعلى بـ111 نقطة من Grok 4.6 عند إعداد الجهد العالي. وينسب معظم التحسن إلى جودة التحليل، بينما جاءت جودة العرض أقل بقليل من نتيجة النموذج السابق. نتائج العمل المعرفي من Artificial Analysis
يفيد هذا التمييز من يطلبون تقارير أو جداول بيانات أو عروضاً تقديمية. فقد تتضمن الإجابة تحليلاً أقوى وتظل بحاجة إلى تحرير أو إعادة تصميم. وعلى العكس، قد يخفي العرض المصقول استدلالاً سطحياً. والتقييم وفق الشكل النهائي الظاهر وحده قد يكافئ التحسن الخطأ.
يمكن لفريق عمليات اختبار النموذج على تقرير أداء متكرر. وينبغي لاختبار مفيد أن يتحقق من استخدام الفترة الصحيحة، ومطابقة الأرقام مع بيانات المصدر، والتمييز بين تغيير مرصود وتفسير مقترح. وعلى المراجع أن يسجل مقدار التصحيح المطلوب، لا أن يكتفي بما إذا كان التقرير يبدو مهنياً عند النظرة الأولى.
قد تهتم شركة أصغر بتحويل نوع من التحليل لا تستطيع تحمل تكلفته إلى إجراء روتيني، أكثر من اهتمامها بالفوز بأصعب اختبار معياري. وهذا مسار محتمل لتوسيع التبني. لكنه يصبح واقعاً عندما تكون النتيجة دقيقة بما يكفي، وتصل في موعدها، وتترك للمالك عملاً أقل مما لو أنجز المهمة يدوياً.
ولا ينبغي الخلط بين تسميات الاختبارات المهنية والمؤهلات المهنية. فنتيجة اختبار العمل القانوني أو الاستدلال السريري تصف الأداء في ذلك التقييم، ولا تثبت أن النموذج قادر على التعامل استقلالياً مع قضية قانونية لعميل أو اتخاذ قرار بشأن رعاية مريض. ولا يقدم هذا المقال توصية باستخدام Grok في تلك القرارات.
الضمانات ادعاء آخر ينبغي تقييمه في سياقه
تقول SpaceXAI إن Grok 4.7 يتضمن مجموعة ضمانات جديدة ومقاومة أقوى لمحاولات كسر الحماية. وهذا ادعاء عند الإطلاق، لا ضمان بأن كل تطبيق يستخدم النموذج سيكون آمناً. عرض المطور للسلامة
ويبقى على الأقل سؤالان لوكيل الأعمال: هل يستجيب النموذج على نحو ملائم للطلبات التي يتلقاها؟ وهل يحد التطبيق مما يستطيع النموذج فعله فعلياً؟
قد يفهم النموذج على نحو صحيح تعليمة تغيير سجل عميل، مع افتقاره إلى الإذن لتنفيذها. وقد يواجه أيضاً تعليمات خبيثة مضمنة في وثيقة كُلّف بتلخيصها. لذلك يجب أن تظل ضوابط الوصول وقواعد الموافقة جزءاً من النظام المحيط؛ فتحسن سلوك الرفض لا يحل محلها.
والنتيجة العملية هي اختبار سير العمل بأكمله. ضمّن طلبات مشروعة ينبغي تنفيذها، وإجراءات غير مسموح بها ينبغي حظرها، وحالات ملتبسة ينبغي إيقافها لطلب التوضيح. وقد يصبح المنتج غير قابل للاستخدام إذا رفض الأعمال البريئة كثيراً؛ وقد يكون أسوأ بكثير إذا نفذ إجراءات غير مصرح بها. ولا تقيس درجة رئيسية واحدة أياً من المشكلتين.
ما الذي لم يحسمه الفيديو؟
يثير تناول Berman عدة مسائل ينبغي أن تبقى أسئلة مفتوحة. فتفسيره للصلة بين الأسعار والحوسبة المتاحة هو قراءة للسوق، لا حساب منشور لتكلفة الوحدة. والتوقعات التي يناقشها على وسائل التواصل توقعات وليست دليلاً على أداء تحقق. كما أن مقارنة العرض التوضيحي في ختام الفيديو يرافقها إقراره بأنه لا يعرف الإعدادات المستخدمة. نقاش الأسعار، 8:44، التوقعات، 11:51 و نقاش العرض، 15:20
ويتناول الفيديو أيضاً النماذج مفتوحة الأوزان. لكن هذا التوجه التنافسي الأوسع ينبغي ألا يختلط بترخيص Grok 4.7: إذ تصنفه Artificial Analysis نموذجاً مملوكاً وتذكر أن أوزانه غير متاحة. ملف إصدار Grok 4.7
تحافظ هذه الفروق على تركيز التقييم. فقد يكون سعر المنتج جذاباً من دون أن يعرف الجمهور سبب اختيار المورد لذلك السعر. وقد يكشف عرض إخفاق لافت عن اختبار يستحق الإعادة من دون إثبات أن أداء النموذج ضعيف عموماً. وقد يكون النموذج المتاح مفيداً من دون أن يطابق توقعاً سابقاً لمؤسسه.
وثمة حد فاصل للرعاية التجارية أيضاً. يتضمن فيديو Berman إعلاناً لـZapier. وهذا ليس دليلاً مستقلاً على أداء Grok، كما أن الادعاءات الترويجية ليست توصيات من BIG CHANGE.
مقياس شراء أفضل: تكلفة المهمة المقبولة
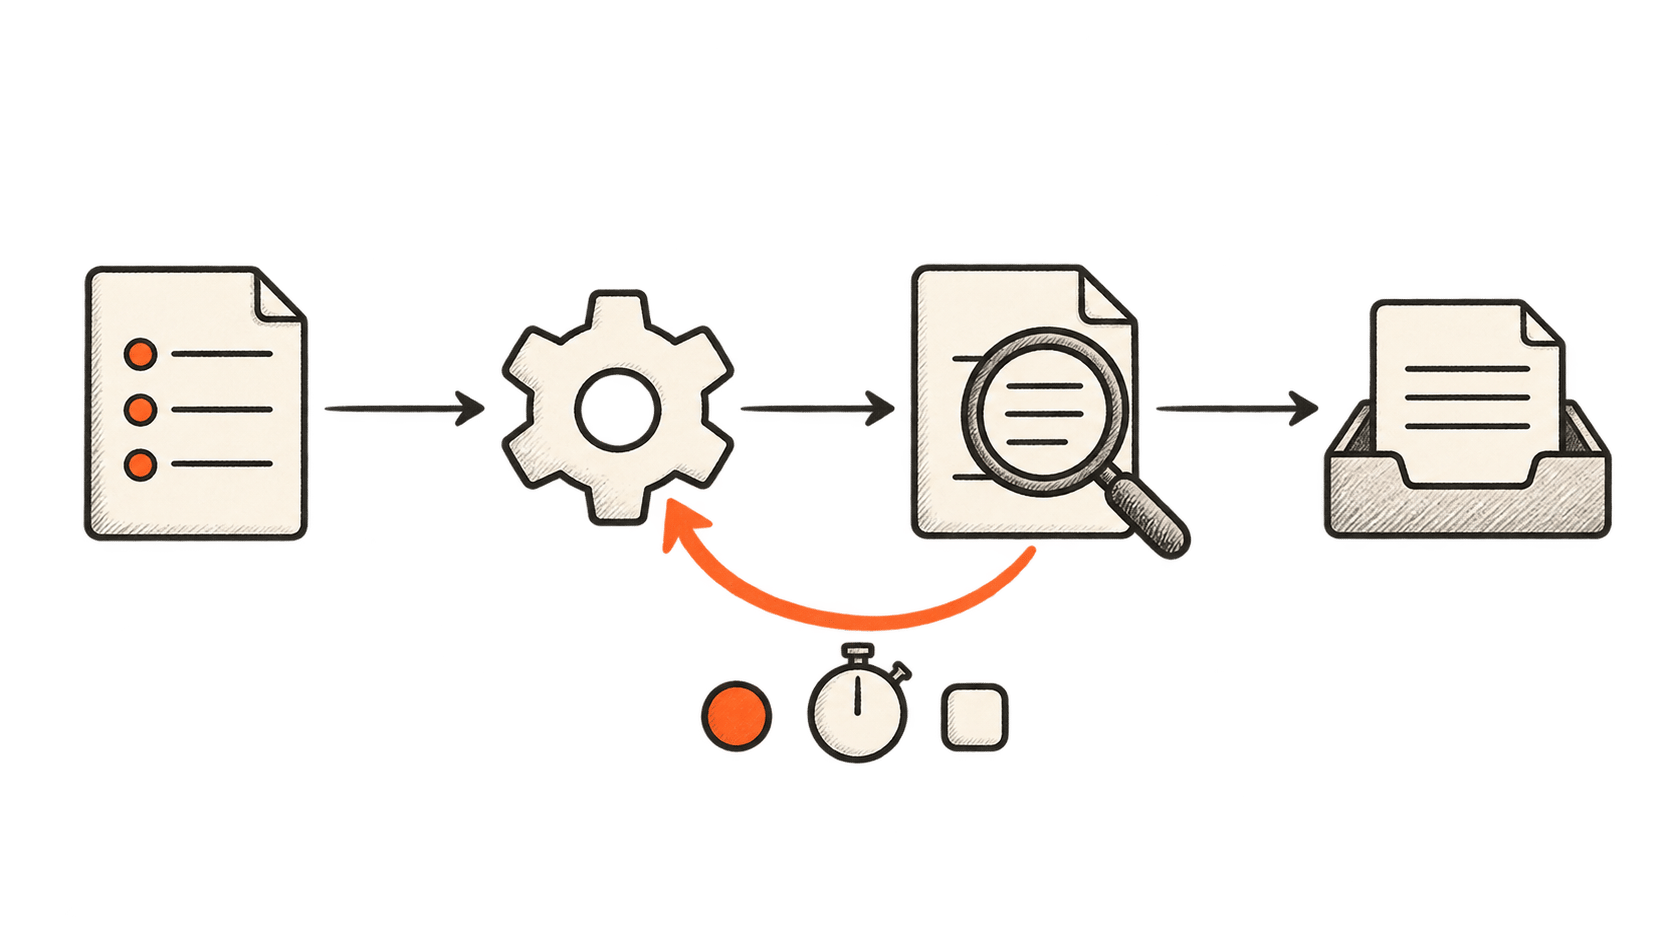
ينبغي للفريق الذي يفكر في Grok 4.7 مقارنته بعملية العمل الحالية على مجموعة صغيرة وممثلة من المهام. حدد معايير القبول قبل الاطلاع على النتائج. ففي البرمجة، قد تشمل الاختبارات الملائمة وتعديلاً واضحاً وعدم تغييرات لا صلة لها. وفي التحليل، قد تشمل الحسابات الصحيحة والأدلة على الادعاءات المهمة.
ثم سجّل الفاتورة كاملة: استخدام الإدخال والإخراج والأدوات والمحاولات المعادة والوقت المستغرق لمراجعة النتيجة أو إصلاحها. واحتسب المحاولات غير الناجحة أيضاً. واقسم التكلفة على عدد المخرجات التي تستوفي معايير القبول.
يوضح مثال توضيحي أهمية الفرق. لنفترض أن إعداداً ما كلف 20 دولاراً لدفعة وأنتج 80 نتيجة مقبولة. فتكلفته المقاسة 0.25 دولار لكل نتيجة مقبولة قبل احتساب العمل البشري. أما إعداد آخر فيكلف 12 دولاراً لكنه ينتج 30 نتيجة مقبولة فقط، أي 0.40 دولار لكل نتيجة. وهكذا تكون الدفعة الأرخص مصدراً أغلى للعمل القابل للاستخدام. وهذه أرقام افتراضية، وليست قياسات لـGrok.
وينبغي أن يكون مستوى جهد الاستدلال جزءاً من التجربة. فقد يبرر الإعداد عالي الجهد تكلفته في مهمة صعبة ولا يضيف الكثير في مهمة روتينية. وقد يكون تصعيد الإعداد للحالات التي تحتاج إليه فقط أوفر من تشغيل كل طلب عند مستوى xhigh، شرط تقييم قرار التوجيه نفسه.
أبقِ معايير المراجعة ثابتة بين النماذج. فخفض المعيار للنموذج الأرخص يصنع وفراً ظاهرياً بقبول عمل أسوأ. ورفع المعيار للنموذج الحالي وحده يخلق تشويهاً معاكساً. والغاية شراء نتيجة موثوقة، مع بيان واضح لما لا يزال على الناس إنجازه.
التغيير الذي يستحق المتابعة
يمنح Grok 4.7 الفرق خياراً آخر للاختبار. ويتطلب اختياره النظر إلى المهمة كاملة: ما ينتجه النموذج، وما يستهلكه، وما لا يزال على أحد إصلاحه.
وقد تكون النتيجة الأوسع استخدام الذكاء الاصطناعي في العمل اليومي بصورة أكثر انتقائية. فقد يختار الفريق إعداداً للتحليل الروتيني وآخر للبرمجة الصعبة، ويُبقي الحالات التي لا يمكن تفويض الحكم أو المساءلة فيها للإنسان. وتمنح المنافسة الأكبر ذلك الفريق خياراً آخر للاختبار، لكنها لا تحدد أي الخيارات ينبغي أن يفوز.
بالنسبة إلى BIG CHANGE، تتمثل المحطة التالية في إنجاز عمل قابل للقياس بجهد إجمالي أقل. فإذا خفّض Grok 4.7 تكلفة المخرجات المقبولة، فقد يجعل الأتمتة المفيدة متاحة لمؤسسات أكثر. وإذا نقل الاستدلال الإضافي التكلفة من سعر الرمز إلى حجم الاستهلاك فحسب، فلن يخبر السعر المعلن المشترين بالكثير. وستأتي الأدلة الحاسمة من المهام المكتملة، بما فيها تلك التي أخفقت أولاً.