O Grok 4.7 chegou a 21 de setembro de 2026. Para as equipas que compram IA para escrever código ou analisar informação empresarial, o lançamento levanta uma questão prática: um modelo melhor torna mais barato concluir o trabalho? A resposta depende de mais do que as tarifas por token anunciadas. Notas oficiais de lançamento
Esta imagem mista é o tema do vídeo de Matthew Berman de 22 de setembro, Ainda não sei o que pensar do Grok 4.7…. Berman questiona a escolha das comparações e argumenta que o custo por tarefa concluída é mais importante do que os preços por token. Diz também que ainda não testou o modelo a fundo. O vídeo é uma primeira avaliação das evidências, não uma análise prática abrangente. Introdução de Berman, 0:00
Vale a pena prestar atenção ao lançamento porque um modelo útil não tem de vencer todos os benchmarks para alterar o que as empresas podem automatizar. Tem, porém, de concluir trabalho suficiente com qualidade para justificar o custo total. Os testes independentes já revelam a tensão: os melhores resultados do Grok 4.7 podem exigir muito mais texto gerado.
Para programadores, pequenas empresas e equipas que criam agentes, a decisão é, portanto, prática. Que tarefas consegue este modelo concluir com qualidade aceitável? De quanto esforço precisa? E quanto trabalho fica para uma pessoa depois de o modelo dizer que terminou?
Revimos as legendas completas do vídeo de cerca de 17 minutos de Berman e verificámos o lançamento, a documentação do produto e a avaliação da Artificial Analysis. A análise abaixo não inclui qualquer benchmark da BIG CHANGE nem alegações de testes do Grok em primeira mão.
O que foi lançado e onde está disponível
O modelo normal está disponível na API da xAI como grok-4.7, bem como no Cursor e no Grok Build. A API aceita texto e imagens e produz texto. A janela de contexto documentada é de 500 000 tokens, com quatro níveis de esforço de raciocínio: baixo, médio, alto e extra-alto. O nível alto é o predefinido. Notas oficiais de lançamento
A SpaceXAI atribui a melhoria a um modelo-base maior e a um treino de aprendizagem por reforço mais prolongado em tarefas difíceis. Esta é a explicação do programador. Visão geral técnica do lançamento
Existe também o Grok 4.7 Fast. A documentação descreve-o como o mesmo modelo a funcionar numa infraestrutura mais rápida, cobrado ao dobro das tarifas normais por token. É disponibilizado através do Cursor e do Grok Build, está excluído do plano gratuito do Grok Build e não está disponível através da API pública da xAI. Documentação do produto Grok 4.7
Estas distinções são importantes ao comparar capturas de ecrã, demonstrações e faturas. A versão do modelo, o esforço de raciocínio e o nível de serviço são escolhas distintas. Uma demonstração com o Fast no nível extra-alto não estima a experiência nem o custo de uma chamada à API a velocidade normal e com esforço médio.
A comparação da página de lançamento com outros modelos também deve ser separada da comparação de atualização. A SpaceXAI afirma que o Grok 4.7 normal tem o mesmo preço e velocidade que o Grok 4.6. Não afirma que a atualização do 4.6 reduza automaticamente a fatura do cliente para metade.
A tabela de preços tem um limiar para contextos longos
As tarifas normais publicadas para a API são:
- Até 200 000 tokens de entrada: 2 $ por milhão de tokens de entrada, 0,50 $ por milhão de tokens de entrada em cache e 6 $ por milhão de tokens de saída.
- Acima de 200 000 tokens de entrada: 4 $ por milhão de tokens de entrada, 1 $ por milhão de tokens de entrada em cache e 12 $ por milhão de tokens de saída.
Estas são tarifas por token, não preços globais para um agente concluir um trabalho. A página do modelo assinala preços superiores para pedidos que excedam 200 000 tokens, e as notas de lançamento especificam as tarifas mais altas. Os preços e a disponibilidade foram verificados a 22 de setembro. Preços do modelo e notas de lançamento
Uma janela de contexto de 500 000 tokens não significa, portanto, que todos os pedidos abrangidos beneficiem da tarifa mais baixa. Uma janela de contexto ampla também não demonstra que o modelo encontrará sistematicamente todos os detalhes relevantes num grande conjunto de ficheiros.
A documentação do Cursor estabelece outra distinção ao nível do produto: indica uma janela normal de 256 000 tokens e um máximo de 500 000. A capacidade disponível num editor pode diferir da especificação da API ou depender do modo escolhido. Documentação do Cursor sobre o Grok 4.7
Para uma equipa que processa relatórios longos, a questão imediata é saber se enviar todo o material melhora suficientemente o resultado para justificar o custo. Recuperar as secções relevantes poderá ser mais barato e mais fácil de verificar. Por vezes, o documento completo é necessário; noutras, é simplesmente a forma mais fácil de construir um pedido. Estas situações não devem ser orçamentadas como se fossem idênticas.
Um melhor desempenho pode consumir mais tokens
A avaliação da Artificial Analysis, de 21 de setembro, atribui ao Grok 4.7 com esforço extra-alto uma pontuação de 46 no seu Intelligence Index, dois pontos acima do Grok 4.6 com esforço alto. Indica cerca de 81 000 tokens de saída por tarefa, face a 36 000 do Grok 4.6 com esforço alto. O mesmo relatório indica 38 000 para o Grok 4.6 com esforço extra-alto, pelo que até essa comparação com o mesmo esforço mostra mais do dobro de tokens de saída. Avaliação de lançamento da Artificial Analysis
Esta é uma razão concreta para separar o preço dos tokens do custo da tarefa. A utilização de 81 000 tokens de saída à tarifa-base de 6 $ por milhão resulta numa cobrança ilustrativa de 0,486 $. Com 38 000 tokens, seriam 0,228 $. Estes cálculos excluem deliberadamente os dados de entrada, o comportamento da cache, as ferramentas, as tarifas de contexto superiores e as tentativas falhadas. São cálculos aritméticos com base nas contagens de tokens divulgadas, não preços totais de trabalhos medidos.
Mais texto não é necessariamente desperdício. Um modelo poderá investir esforço adicional a verificar uma resposta e evitar uma falha que, de outro modo, exigiria a intervenção de uma pessoa. Também poderá passar mais tempo a insistir numa abordagem errada. A contagem de tokens, por si só, não permite distinguir persistência produtiva de repetição dispendiosa.
Berman volta a este problema perto do final do vídeo, onde menciona o maior consumo de tokens indicado pela Artificial Analysis. Vídeo, 15:43
O resultado útil é um produto final aceite. Uma alteração ao código que passe os testes adequados e a revisão, uma folha de cálculo cujas fórmulas coincidam com os dados ou um relatório cujas afirmações sejam sustentadas por provas têm um valor diferente de uma resposta que apenas chega depressa.
Os benchmarks revelam um modelo capaz, mas irregular
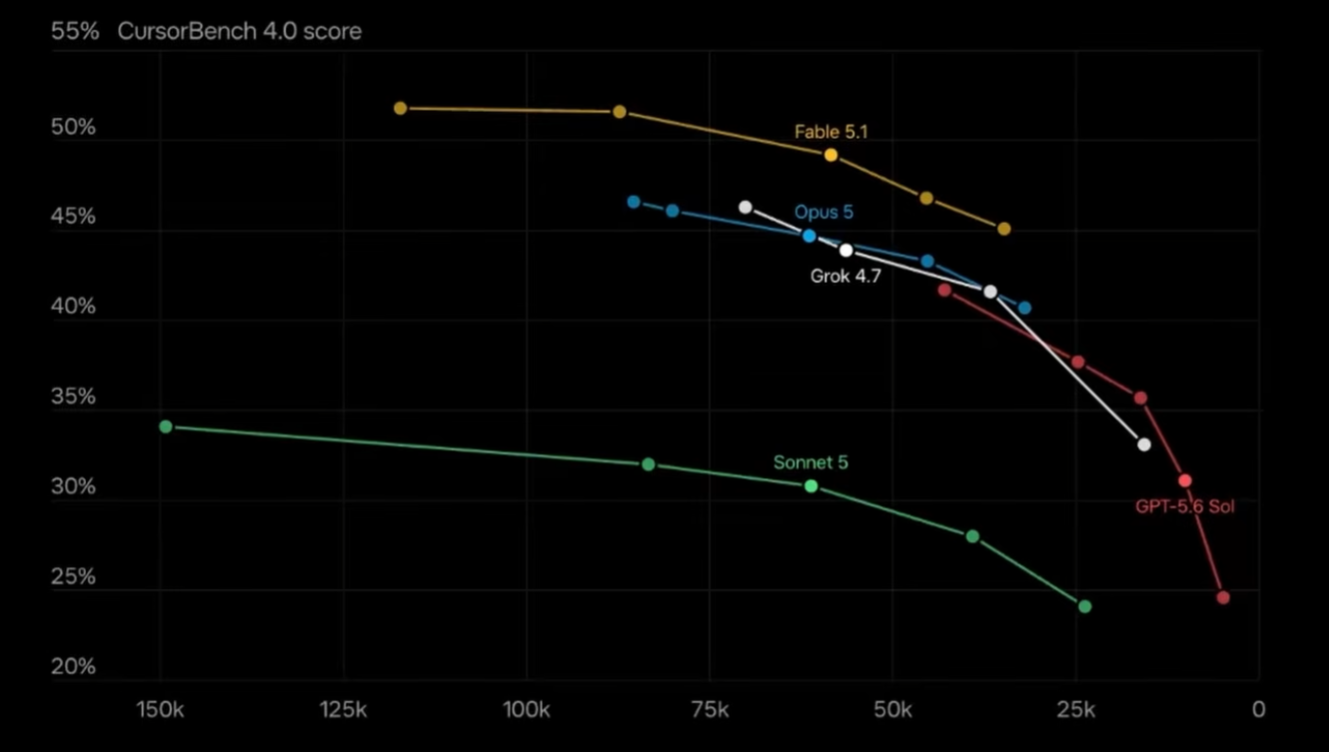
A tabela do lançamento atribui ao Grok 4.7 no nível extra-alto 46,3% no CursorBench 4.0, abaixo dos 51,8% do Fable 5.1 no nível máximo. O Fable também lidera na comparação do Terminal-Bench. Tabela de benchmarks do fornecedor
O gráfico que acompanha a tabela representa a pontuação do benchmark em função dos tokens de saída, diminuindo da esquerda para a direita. As linhas comparam os níveis de raciocínio. Gráfico interativo original: selecionar Tokens. Abrir o gráfico em tamanho real.
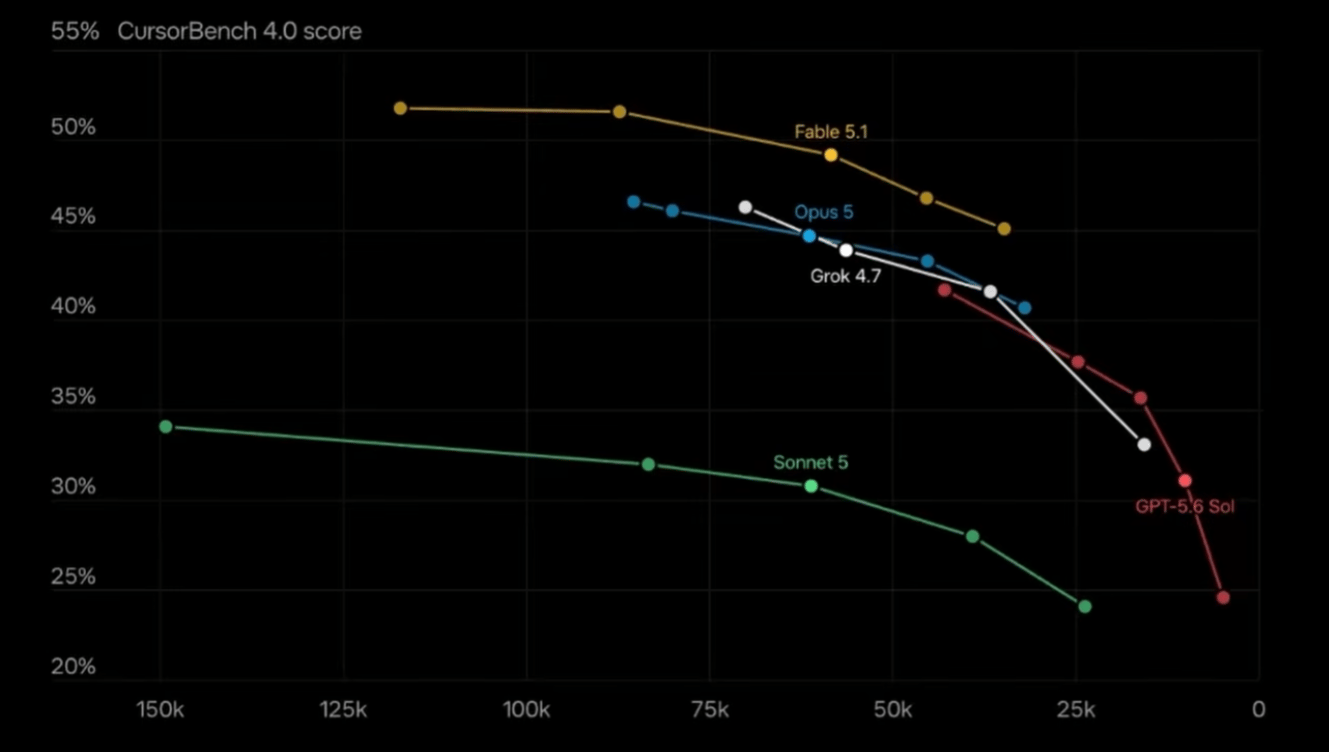
Subir no gráfico significa uma pontuação mais alta; avançar para a direita significa menos tokens gerados nesta avaliação. Não significa um custo total inferior: as tarifas por token, a utilização de dados de entrada e o agente envolvente continuam a contar. Trata-se também de um teste diferente das contagens de tokens da Artificial Analysis acima. Combinar as contagens apagaria as diferenças de tarefa e metodologia que permitem interpretar cada resultado.
Isto basta para rejeitar a afirmação generalizada de que o Grok 4.7 lidera todos os tipos de trabalho de programação. Também justifica uma análise mais atenta de certas cargas de trabalho. A dimensão da melhoria numa avaliação não determina como o modelo lidará com um repositório desconhecido, um relatório de erro incompleto ou um ambiente de ferramentas invulgar.
A Artificial Analysis oferece uma distinção independente útil. O relatório atribui ao Grok 4.7 com o Grok Build uma pontuação de 56 no Coding Agent Index, acima dos 47 do Grok 4.6 com esse agente. Distingue explicitamente estes resultados com agentes nativos da configuração normalizada do Intelligence Index. Avaliação independente e notas metodológicas
O agente envolvente é importante. Fornece ferramentas, gere o contexto e decide como executar os pedidos do modelo. Alterar esse ambiente pode alterar os resultados, mesmo que o nome do modelo se mantenha. Combinar uma pontuação de terminal de uma configuração com uma pontuação de engenharia de software de outra pode criar uma tabela convincente que não descreve nenhum sistema realmente testado.
Berman assinala a ausência do GPT-6 Astra numa das tabelas de lançamento e utiliza uma reconstrução gerada por IA para o acrescentar. É um incentivo útil para investigar a comparação; essa reconstrução não é uma fonte de benchmark independente. Não adotamos os valores adicionados sem verificar a avaliação subjacente. Vídeo, 6:03
Há também uma relação comercial a ter em conta. O anúncio da própria empresa de 14 de agosto afirma que a SpaceX adquiriu o Cursor. Um benchmark publicado no âmbito dessa família de produtos continua a ser prova útil, mas não é uma avaliação desinteressada de um fornecedor concorrente. Anúncio da aquisição do Cursor
O trabalho de escritório poderá ser a oportunidade mais interessante
A avaliação independente atribui ao Grok 4.7 no nível extra-alto 1 657 Elo no AA-Briefcase, mais 111 do que ao Grok 4.6 no nível alto. Atribui grande parte da melhoria à qualidade analítica, enquanto a qualidade da apresentação é ligeiramente inferior à do resultado do modelo anterior. Resultados de conhecimento profissional da Artificial Analysis
Esta diferença é útil para quem encomenda relatórios, folhas de cálculo ou apresentações. Uma resposta pode conter uma análise melhor e ainda assim precisar de edição ou reformulação visual. Inversamente, uma apresentação polida pode ocultar um raciocínio superficial. Avaliar apenas o acabamento visível arrisca-se a recompensar a melhoria errada.
Uma equipa de operações poderia testar o modelo num relatório de desempenho periódico. Um ensaio útil verificaria se utiliza o período correto, reconcilia os valores com os dados de origem e distingue uma alteração observada de uma explicação proposta. A pessoa que o revê deveria registar quanta correção foi necessária, não apenas se o relatório parecia profissional à primeira vista.
Uma empresa mais pequena poderá dar menos importância a vencer o benchmark mais difícil e mais importância a tornar rotineira uma análise que, de outro modo, seria incomportável. Essa é uma via plausível para uma adoção mais ampla. Torna-se real quando o resultado é suficientemente rigoroso, chega a tempo e deixa ao proprietário menos trabalho do que executar a tarefa manualmente.
Os nomes dos benchmarks profissionais não devem ser confundidos com qualificações profissionais. Um resultado em trabalho jurídico ou raciocínio clínico descreve o desempenho nessa avaliação. Não demonstra que o modelo consiga tratar autonomamente do processo jurídico de um cliente ou tomar uma decisão de cuidados de saúde. Este artigo não recomenda a utilização do Grok para essas decisões.
As salvaguardas também devem ser avaliadas no seu contexto
A SpaceXAI afirma que o Grok 4.7 possui uma nova camada de salvaguardas e maior resistência a tentativas de contornar as proteções. Trata-se de uma alegação de lançamento, não de uma garantia de que todas as aplicações que utilizem o modelo sejam seguras. Descrição de segurança do programador
No caso de um agente empresarial, permanecem pelo menos duas perguntas. O modelo responde adequadamente aos pedidos que recebe? E a aplicação limita aquilo que o modelo pode efetivamente fazer?
Um modelo pode compreender corretamente uma instrução para alterar o registo de um cliente sem ter autorização para o fazer. Também pode encontrar instruções maliciosas num documento que devia resumir. Os controlos de acesso e as regras de aprovação têm de continuar a fazer parte do sistema envolvente; um comportamento de recusa melhorado não os substitui.
A implicação prática é testar todo o fluxo de trabalho. Inclua pedidos legítimos que devem ser aceites, ações não permitidas que têm de ser bloqueadas e casos ambíguos que devem aguardar esclarecimentos. Um produto que recuse demasiadas vezes tarefas inofensivas pode ser inutilizável; um que execute ações não autorizadas pode ser muito pior. Nenhum dos problemas é captado por uma única pontuação de destaque.
O que o vídeo deixa por resolver
A análise de Berman levanta várias questões que devem continuar em aberto. A sua explicação que associa os preços à capacidade computacional disponível é uma interpretação do mercado, não uma contabilidade de custos unitários divulgada. As previsões nas redes sociais que aborda são expectativas, não provas de desempenho alcançado. A comparação de demonstrações no final é acompanhada pela própria admissão de que não sabe que definições foram usadas. Discussão de preços, 8:44, expectativas, 11:51 e discussão da demonstração, 15:20
O vídeo também aborda modelos de pesos abertos. Esta tendência concorrencial mais ampla não deve ser confundida com o licenciamento do Grok 4.7: a Artificial Analysis identifica este lançamento como proprietário e indica que os seus pesos não estão disponíveis. Perfil de lançamento do Grok 4.7
Estas distinções mantêm a avaliação focada. Um produto pode ter um preço atrativo sem que o público saiba por que motivo o fornecedor o definiu assim. Uma demonstração falhada surpreendente pode identificar um teste que vale a pena repetir sem provar que o modelo é, em geral, fraco. Um modelo disponível pode ser útil sem corresponder a uma previsão anterior do fundador.
Existe também uma fronteira entre conteúdo e patrocínio. O vídeo de Berman inclui um anúncio da Zapier. Não é uma prova independente do desempenho do Grok e as alegações promocionais não são recomendações da BIG CHANGE.
Uma métrica de compra melhor: custo por tarefa aceite
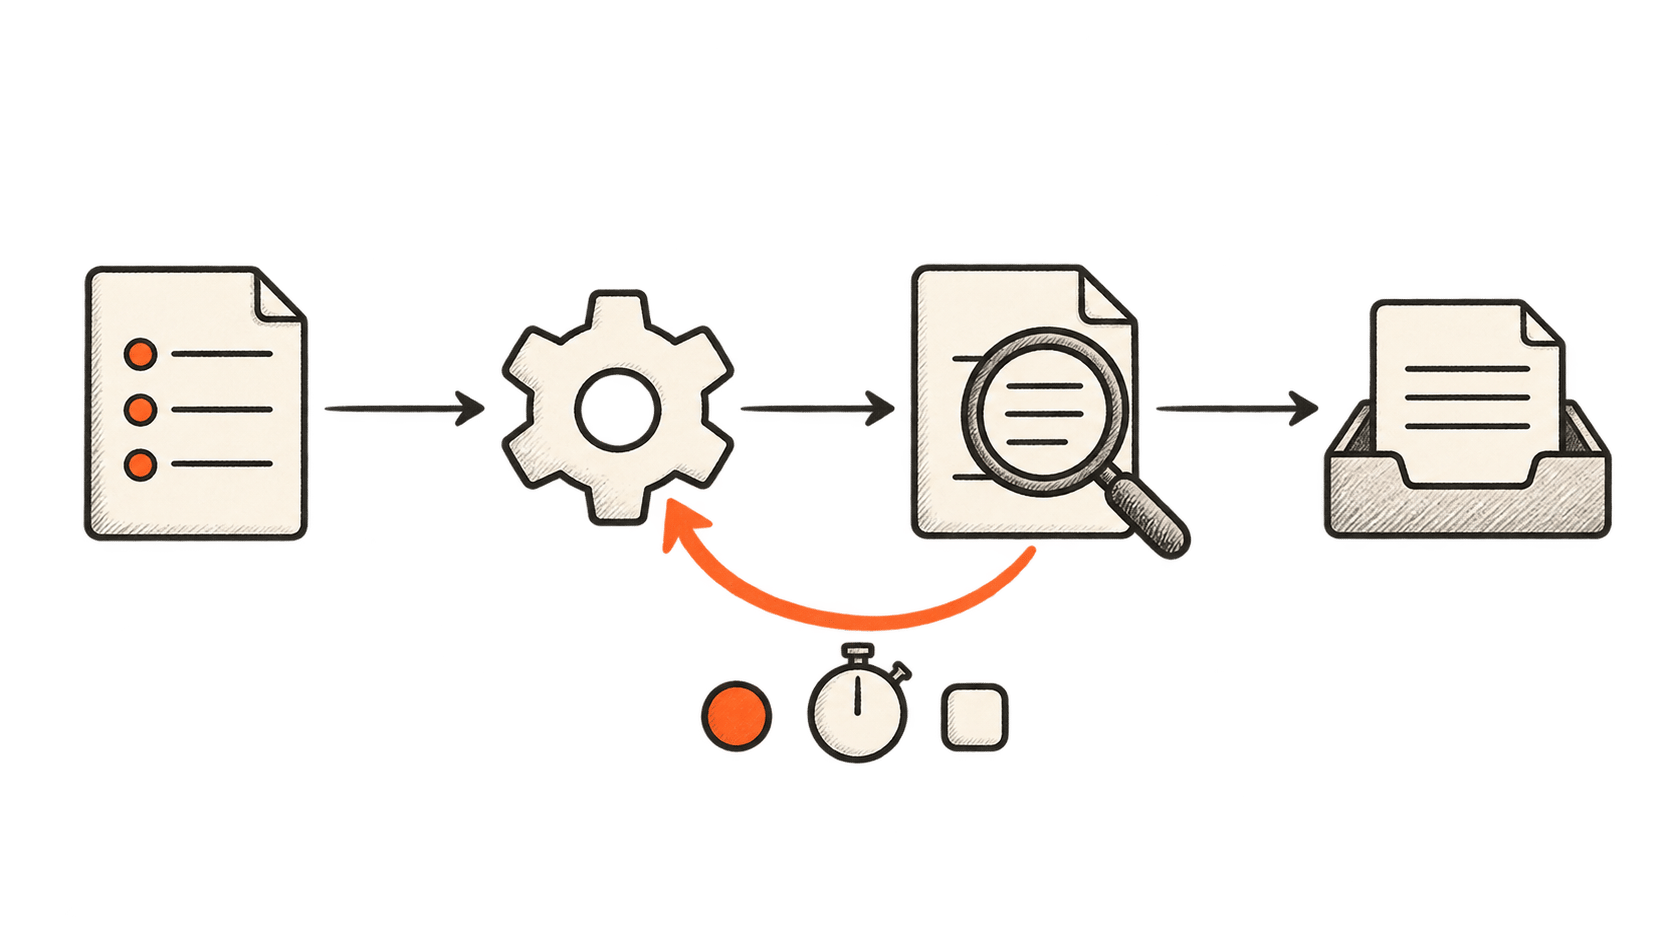
Uma equipa que esteja a considerar o Grok 4.7 deve compará-lo com o processo atual num conjunto pequeno e representativo de tarefas. Defina os critérios de aceitação antes de ver os resultados. Para programação, poderão incluir testes relevantes, uma correção legível e ausência de alterações alheias. Para análise, poderão incluir cálculos corretos e provas para afirmações importantes.
Em seguida, registe a fatura completa: utilização de dados de entrada e saída, ferramentas, novas tentativas e tempo dedicado a rever ou reparar o resultado. Conte também as tentativas sem êxito. Divida esse custo pelo número de produtos finais que cumprem os critérios de aceitação.
Um exemplo ilustrativo mostra por que motivo a distinção é importante. Suponhamos que uma configuração custa 20 $ num conjunto de tarefas e produz 80 resultados aceites. O custo medido é de 0,25 $ por resultado aceite, antes do trabalho humano. Outra custa 12 $, mas produz apenas 30 resultados aceites, o que corresponde a 0,40 $ por resultado aceite. O conjunto mais barato é a fonte mais dispendiosa de trabalho utilizável. São números hipotéticos, não medições do Grok.
O esforço de raciocínio também deve fazer parte desse ensaio. Uma configuração de esforço elevado poderá justificar o custo numa tarefa difícil e acrescentar pouco numa tarefa rotineira. Aumentar o esforço apenas nos casos que precisam dele poderá ser mais económico do que executar todos os pedidos no nível extra-alto, desde que a própria decisão de encaminhamento seja avaliada.
Mantenha os critérios de revisão iguais entre modelos. Baixar a fasquia para um modelo mais barato cria uma poupança aparente ao aceitar trabalho pior. Subi-la apenas para o modelo atual cria a distorção oposta. O objetivo é obter um resultado fiável, com uma descrição clara do trabalho que as pessoas ainda têm de fazer.
A mudança a acompanhar
O Grok 4.7 dá às equipas mais uma opção para testar. Escolhê-lo exige uma visão do trabalho completo: o que o modelo produz, o que consome e o que alguém ainda tem de reparar.
A consequência mais ampla poderá ser uma utilização mais seletiva da IA no trabalho quotidiano. Uma equipa poderá escolher uma configuração para análises rotineiras, outra para programação difícil e recorrer a uma pessoa nos casos em que não se possa delegar o discernimento ou a responsabilização. Mais concorrência dá à equipa outra opção para testar; não determina qual deve vencer.
Para a BIG CHANGE, o próximo marco é concluir trabalho mensurável com menos esforço total. Se o Grok 4.7 reduzir o custo dos produtos finais aceites, poderá tornar a automatização útil acessível a mais organizações. Se o raciocínio adicional apenas transferir a despesa do preço por token para o volume consumido, o preço de destaque dirá muito pouco aos compradores. A resposta virá dos trabalhos concluídos, incluindo aqueles que falharam à primeira.