Grok 4.7は2026年9月21日に登場した。コード作成や業務情報の分析にAIを導入するチームにとって、実務上の問いが生じる。より優れたモデルなら完成済みの作業をより安くできるのか。答えは公表されたトークン料金だけでは決まらない。公式リリースノート
この複雑な状況を取り上げたのが、Matthew Berman氏による9月22日の動画Grok 4.7をどう評価すればいいか分からない……である。同氏は比較の選び方に疑問を呈し、トークン価格よりタスク完了あたりのコストが重要だと論じる。また、モデルを十分にテストしていないとも述べる。この動画は証拠に対する初期評価であり、包括的な実地検証ではない。Berman氏の導入、0分00秒
この発表に注目する価値があるのは、事業の自動化にかかる費用を変えるのに、すべてのベンチマークで勝つ必要はないからだ。ただし総費用を正当化するには、十分な作業を正確に完了しなければならない。独立評価はすでに緊張関係を明らかにしている。Grok 4.7は成績を高める一方で、生成する文章量が大幅に増える場合がある。
開発者、中小企業、エージェントを構築するチームにとって、判断は実務的だ。このモデルは、どの作業を許容できる品質で完了できるのか。どれだけの手間が必要か。モデルが完了したと言った後、人にはどれほどの作業が残るのか。
Berman氏の約17分の動画の字幕全体を確認し、発表、製品文書、Artificial Analysisによる評価を照合した。以下の分析にはBIG CHANGE独自のベンチマークも、Grokを実地試験したという主張も含まれない。
何が発表され、どこで利用できるか
標準モデルはxAIのAPIで利用でき、grok-4.7CursorとGrok Buildでも提供される。APIはテキストと画像を受け取り、テキストを出力する。文書化されたコンテキストウィンドウは50万トークンで、推論設定はlow、medium、high、xhighの4段階である。初期設定はhigh。公式リリースノート
SpaceXAIは、より大きな基盤モデルと、より難しい課題に対する強化学習の延長が性能改善の理由だと説明する。これは開発者による説明である。発表の技術概要
Grok 4.7 Fastもある。文書では同じモデルをより高速な基盤で提供するものと説明し、標準料金の2倍を請求する。CursorとGrok Buildで提供され、Grok Buildの無料枠には含まれず、一般向けxAI APIでは利用できない。Grok 4.7の製品文書
こうした違いは、画面写真、実演、請求額を比較する際に重要だ。モデルの版、推論の強さ、提供速度の段階はそれぞれ別の選択肢である。xhigh設定のFastによる実演は、標準速度・medium設定のAPI利用時の体験や費用の推計にはならない。
発表ページにある他モデルとの比較と、アップグレード時の比較も分けて考えるべきだ。SpaceXAIによれば、標準のGrok 4.7はGrok 4.6と同じ価格・速度である。4.6からのアップグレードで顧客の請求額が自動的に半分になるとは述べていない。
料金表には長文脈のしきい値がある
公表された標準API料金は次の通りだ。
- 入力20万トークン以下:100万トークンあたり入力2ドル、キャッシュ済み入力0.50ドル、出力6ドル。
- 入力20万トークン超:100万トークンあたり入力4ドル、キャッシュ済み入力1ドル、出力12ドル。
これはトークン料金であり、エージェントが作業を完了するための総額ではない。モデルのページは入力が20万トークンを超えるリクエストの価格引き上げを示し、リリースノートには高い料金が明記されている。料金と提供状況は9月22日に確認した。モデル料金とリリースノートが該当する。
したがってコンテキストウィンドウが50万トークンあっても、その範囲内のすべてのリクエストに最低料金が適用されるわけではない。また、大きなコンテキストウィンドウがあっても、多数のファイルから関連情報を毎回見つけられるとは限らない。
Cursorの文書には、標準コンテキストウィンドウが25万6,000トークン、最大値が50万トークンと記されており、製品ごとの違いもある。エディター上の容量はAPI仕様と異なる場合や、選んだモードによって変わる場合がある。CursorによるGrok 4.7の説明
長い報告書を処理するチームがまず問うべきなのは、資料をすべて送ることで、その費用に見合うだけ結果が改善するかだ。関連部分を検索して送るほうが安く、確認もしやすいかもしれない。全文が必要な場合もあれば、プロンプトを作るのが簡単だから送る場合もある。両者を同じ費用として予算化すべきではない。
性能の改善がトークン数の増加を招く場合がある
Artificial Analysisによる9月21日の評価では、xhigh設定のGrok 4.7はIntelligence Indexで46点を獲得し、Grok 4.6を2点上回った。同評価は、1タスクあたりの出力を約8万1,000トークンと報告し、high設定のGrok 4.6では3万6,000トークンだった。Grok 4.6のxhigh設定では3万8,000トークンとされており、同じ推論設定で比べても出力が2倍以上になる。Artificial Analysisによる発表時の評価
これはトークン価格とタスク費用を分けて考える具体的な理由となる。基本の出力料金が100万トークンあたり6ドルなら、出力8万1,000トークンの例示的費用は0.486ドルとなる。3万8,000トークンなら0.228ドルだ。この計算では入力、キャッシュの扱い、ツール料金、長文脈料金、失敗した試行を意図的に除外している。報告されたトークン数を使った算術であり、実測した作業全体の価格ではない。
出力が増えることは、必ずしも無駄を意味しない。モデルが答えを確認するために追加の労力を使い、人の介入が必要な失敗を防ぐこともある。逆に、誤った方法を長く追い続けることもある。トークン数だけでは、役に立つ粘り強さと高価な繰り返しを区別できない。
Berman氏は動画の終盤でもこの問題に戻り、Artificial Analysisが報告したトークン使用量の高さに触れている。動画、15分43秒
有用な成果は、受け入れられる納品物だ。適切なテストとレビューを通過したコード変更、数式が整合する表計算、根拠へたどれる主張を含む報告書は、単に速く届く回答とは価値が異なる。
ベンチマークが示すのは、能力は高いが結果にばらつきがあるモデル
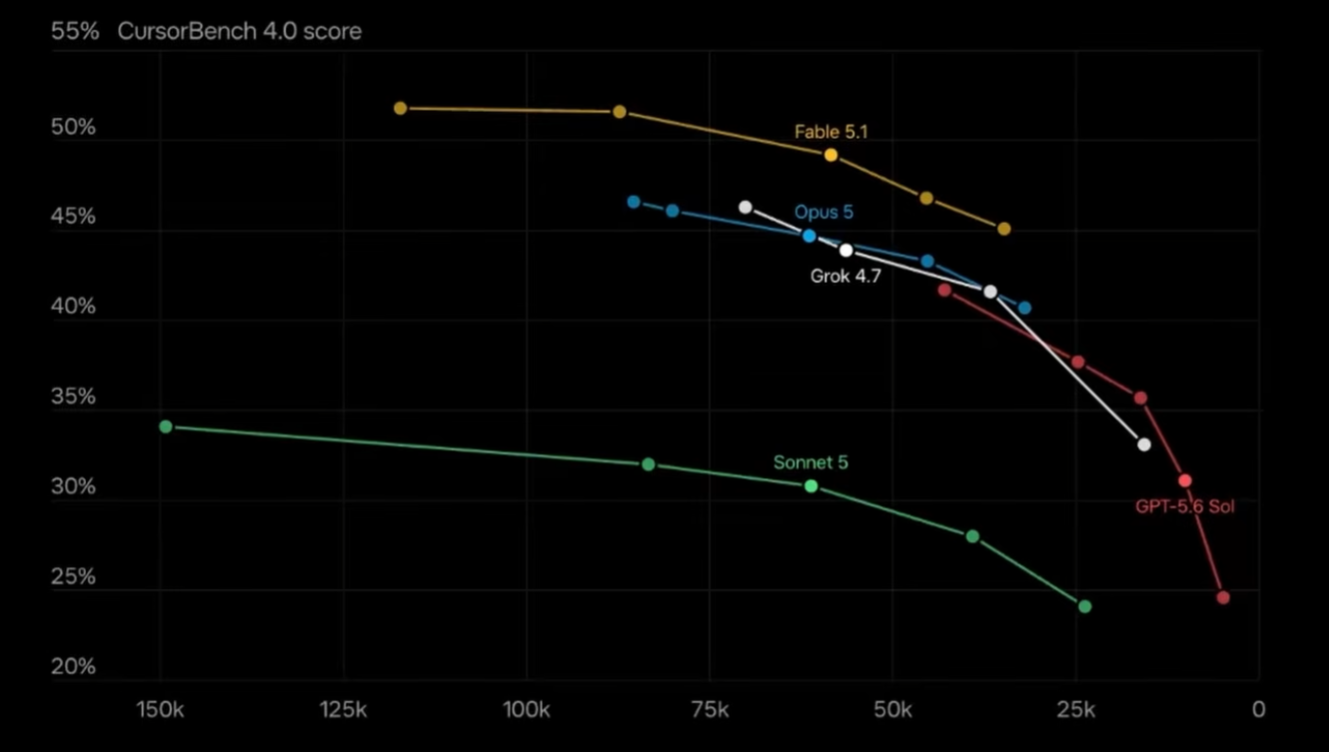
発表時の一覧では、Grok 4.7 xhighのCursorBench 4.0スコアは46.3%で、Fable 5.1 maxの51.8%を下回る。Terminal-Benchの比較でもFableが上回る。ベンダーのベンチマーク一覧
付属のグラフは、ベンチマークスコアを出力トークン数に対して右下がりに示す。推論設定別の線を比較する。元のインタラクティブ図:Tokensを選択。図を拡大して開く。
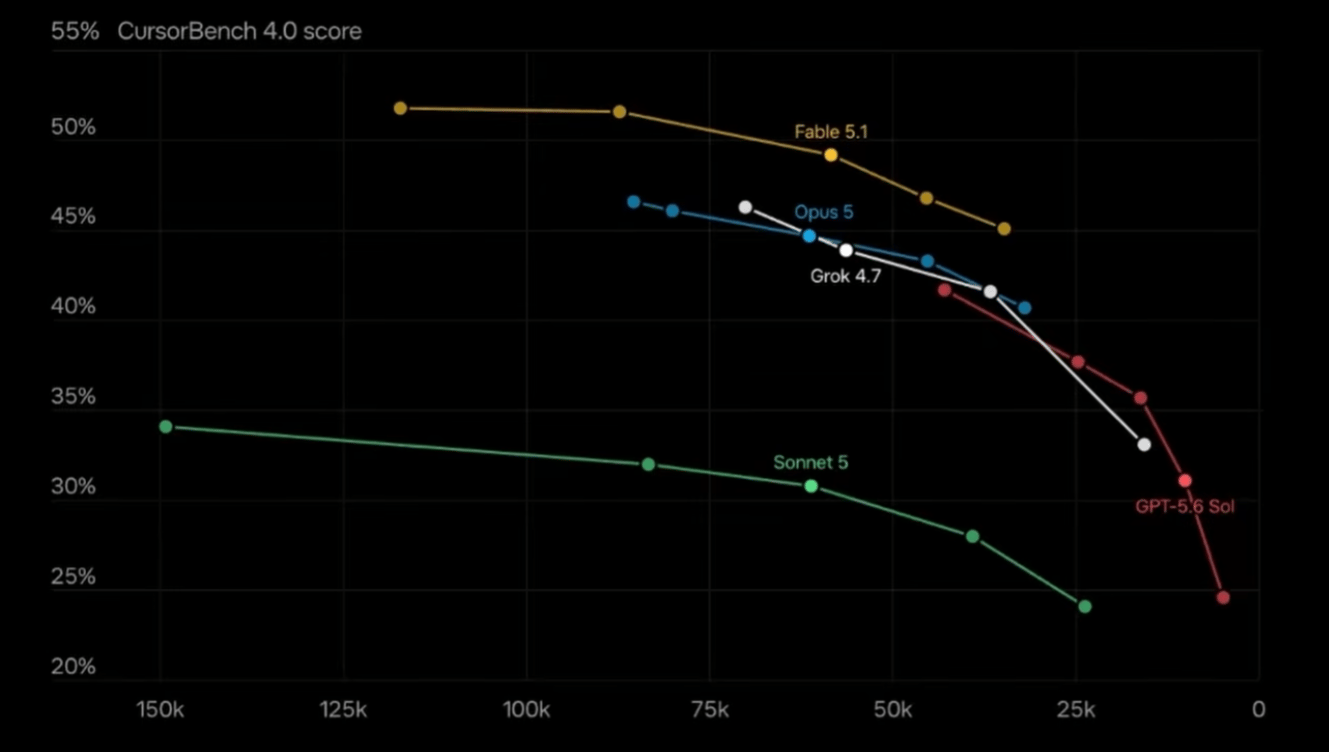
上に進むほどスコアは高く、右に進むほどこの評価で生成トークンは少ない。総額が下がるという意味ではない。トークン料金、入力使用量、周辺のエージェントも関係する。また、これは前述のArtificial Analysisによるトークン数とは別の試験だ。それぞれの結果を理解可能にしているタスクや手法の違いを消してしまうため、両者の数値を合算すべきではない。
これだけでも、あらゆるコーディング作業でGrok 4.7が首位だという包括的な主張は退けられる。同時に、個別の作業についてさらに詳しく調べる理由にもなる。ある評価での改善幅だけでは、未知のリポジトリ、不完全な不具合報告、珍しいツール環境にモデルがどう対応するかは決まらない。
Artificial Analysisは有用な独立評価上の区別も示す。同社の報告では、Grok Buildと組み合わせたGrok 4.7のCoding Agent Indexは56点で、同エージェントと組み合わせたGrok 4.6の47点から上昇した。これらのネイティブエージェント結果は、標準化されたIntelligence Indexの設定とは明確に区別されている。独立評価と手法に関する注記
周辺のエージェントも重要だ。ツールを提供し、文脈を管理し、モデルからの要求をどう実行するか決める。モデル名が同じでも環境が変われば結果は変わる。ある設定のターミナル評価と、別の設定のソフトウェア工学評価を組み合わせると、実際には誰も試していないシステムを説明する、説得力だけはある一覧を作れてしまう。
Berman氏は発表時の一覧にGPT-6 Astraがないと指摘し、AI生成の再構成を使って補っている。比較を調べるきっかけとしては役立つが、その再構成は独立したベンチマーク資料ではない。基礎となる評価を確認せずに、追加された数値は採用しない。動画、6分03秒
商業上の関係にも注意が必要だ。CursorがSpaceXに買収されたとするCursor社の8月14日の発表がある。同じ企業グループ内の製品で公表されたベンチマークも有用な根拠ではあるが、競合他社を利害関係なく評価したものではない。Cursorの買収発表
オフィス業務のほうが興味深い機会かもしれない
独立評価では、xhigh設定のGrok 4.7はAA-Briefcaseで1,657 Eloを獲得し、high設定のGrok 4.6を111上回る。改善の多くは分析の質によるとされる一方、提示の質は旧モデルの結果をわずかに下回る。Artificial Analysisによる知識業務の結果
この差は報告書、表計算、プレゼンテーションを依頼する人にとって有用だ。分析が強くても編集やデザイン修正が必要な場合がある。逆に、洗練されたスライドが浅い推論を覆い隠すこともある。見た目の完成度だけで評価すれば、望ましくない改善を報いる危険がある。
業務運営チームは、定期的な業績報告でモデルを試せる。有用な試験では、対象期間が正しいか、数値を元データと照合できるか、観察された変化と提案された説明を区別できるかを確認する。初見で報告書が専門的に見えたかだけでなく、確認者が必要とした修正量も記録すべきだ。
小規模企業にとって、最難関ベンチマークで勝つことよりも、従来は費用面で難しかった分析を日常業務にできることのほうが重要かもしれない。それは普及につながり得る道筋だ。出力が十分正確で、期限に間に合い、手作業より所有者の負担を減らしたときに現実の価値となる。
専門職のベンチマーク名を専門資格と取り違えてはならない。法律業務や臨床推論の成績は、その評価での能力を表す。それによって、モデルが依頼者の法的問題を単独で扱えることや、患者ケアに関する判断を下せることが立証されるわけではない。本稿は、そうした判断にGrokを使うよう勧めない。
安全策も文脈を踏まえて評価すべき主張だ
SpaceXAIは、Grok 4.7に新しい安全策一式が導入され、ジェイルブレイク耐性が高まったと述べる。これは発表時の主張であり、このモデルを使うすべてのアプリケーションが安全であるとの保証ではない。開発者の安全性に関する説明
事業エージェントについては、少なくとも二つの問いが残る。受け取った要求にモデルは適切に応答するか。アプリケーションはモデルが実際にできることを制限しているか。
モデルは顧客記録を変更する指示を正しく理解しつつ、その変更を行う権限は持たないかもしれない。また、要約するはずの文書に埋め込まれた悪意ある指示に遭遇する可能性もある。アクセス制御と承認規則は周辺システムに残す必要がある。拒否動作が改善しても、その代わりにはならない。
実務上の示唆は、業務フロー全体を試験することだ。成功すべき正当な要求、阻止すべき禁止行為、明確化のため停止すべき曖昧な事例を含める。無害な作業を何度も拒む製品は使い物にならず、無許可の行動を実行する製品はさらに危険だ。どちらも一つの見出しスコアには表れない。
動画で未解決のまま残る問い
Berman氏の解説が提起する問いには、答えが出ていないものもある。料金と利用可能な計算資源を結び付ける説明は市場に関する解釈であり、公開された単位費用の会計ではない。取り上げたソーシャルメディア上の予測は期待であり、実現した性能の証拠ではない。最後のデモ比較については、使用した設定が分からないと本人も認めている。料金の議論、8分44秒、期待について、11分51秒、デモに関する議論、15分20秒
動画ではオープンウェイトモデルも話題にしている。この広い競争動向とGrok 4.7のライセンスを混同すべきではない。Artificial Analysisは今回のリリースをプロプライエタリとし、重みは入手不可としている。Grok 4.7のリリース情報
こうした区別によって評価の焦点が定まる。製品価格が魅力的でも、供給者がなぜその価格を設定したか公開情報から分からない場合がある。印象的な失敗デモは、再試験すべき事柄を示しても、モデル全般の性能が低いと立証しない。モデルが入手可能でも、創業者の以前の予測と一致しなくても役立つことはある。
スポンサー表示にも留意すべきだ。Berman氏の動画にはZapierの広告が含まれる。これはGrokの性能に関する独立した証拠ではなく、広告上の主張はBIG CHANGEの推奨でもない。
より有用な購入指標:受け入れ可能なタスクあたりの費用
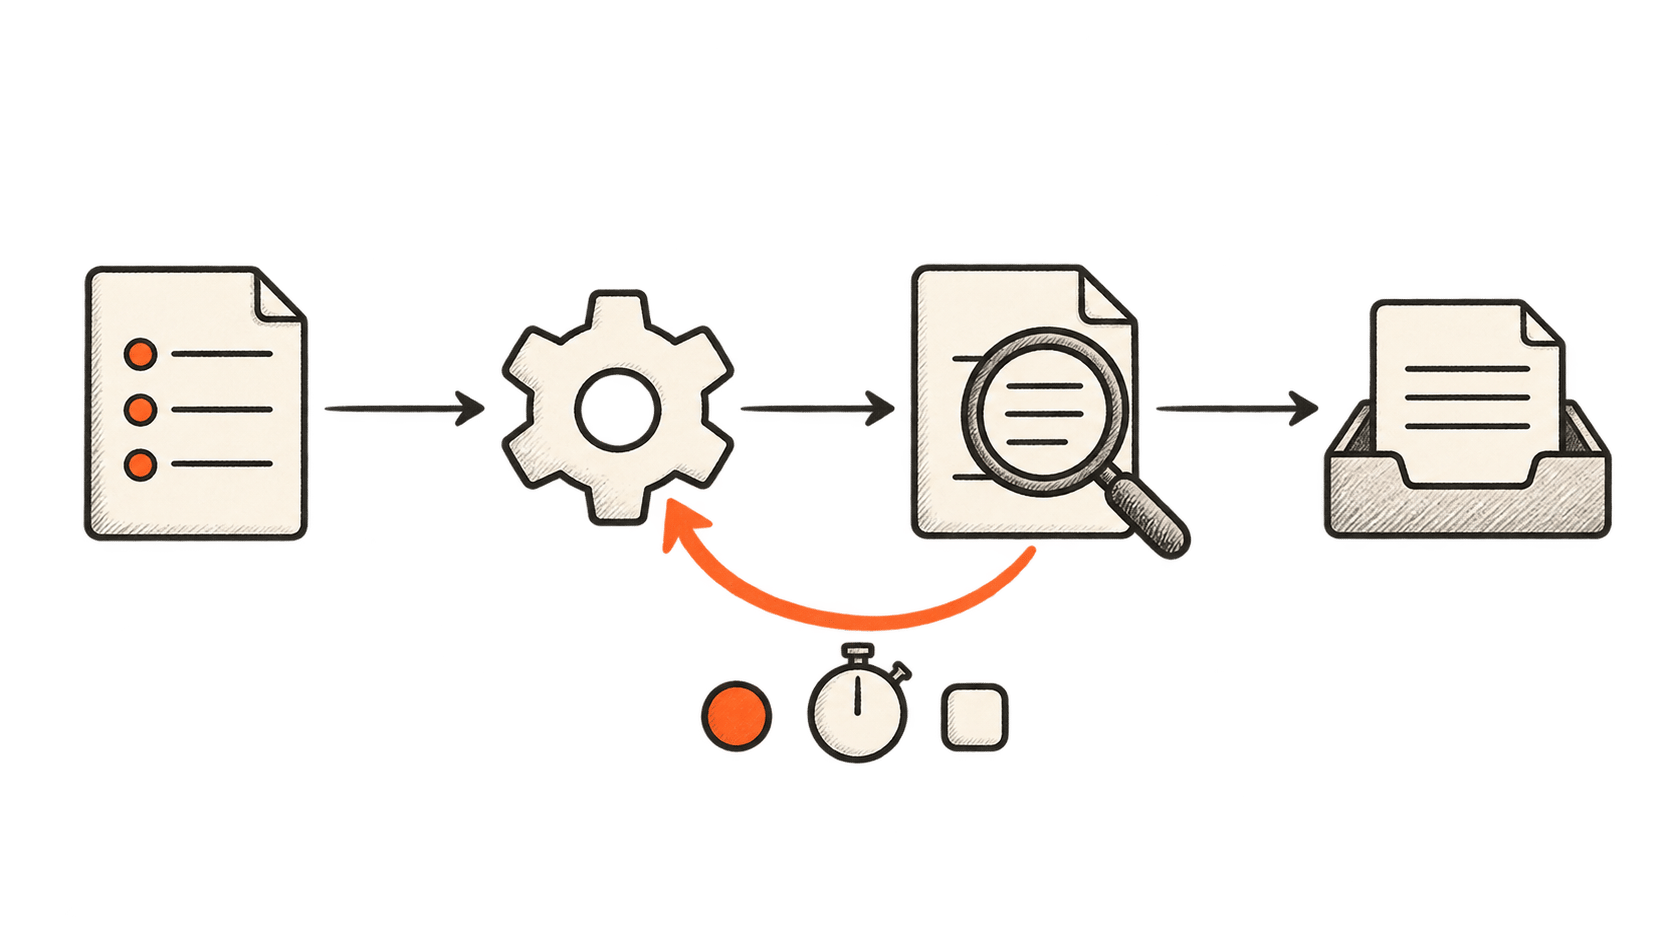
Grok 4.7の導入を検討するチームは、少数でも代表性のある作業群で現行の手順と比較すべきだ。出力を見る前に受け入れ基準を決める。コーディングなら、関連テストに合格し、読みやすいパッチで、無関係な変更がないことなどが基準になり得る。分析なら、正しい計算と、重要な主張の根拠が必要だ。
次に全費用を記録する。入力・出力の使用量、ツール、再試行、結果の確認や修正にかかる時間を含める。失敗した試行も数える。その費用を、基準を満たした納品物の数で割る。
例を挙げると、この違いが分かる。ある設定は一連の作業に20ドルかかり、受け入れ可能な成果を80件生む。人の作業費を除いた受け入れ1件あたりの実測費用は0.25ドルだ。別の設定は12ドルで30件しか生まず、1件あたり0.40ドルになる。より安い一括処理のほうが、利用可能な作業を得るには高くつく。これは仮定上の数字であり、Grokを測定したものではない。
推論の強さも試験に含めるべきだ。難しい作業ではhigh設定が費用に見合う一方、定型作業ではほとんど利点がないかもしれない。必要なケースだけを上位設定へ切り替えれば、切替判断自体を評価する限り、すべての依頼をxhighで実行するより経済的になり得る。
モデル間でレビュー基準を一定に保つ。安いモデルの基準を下げれば、より悪い仕事を受け入れることで節約に見せられる。現行モデルにだけ高い基準を課しても逆の歪みが生じる。目的は、信頼できる結果を購入し、人がなお行うべき作業を明確にすることだ。
注目すべき変化
Grok 4.7は、チームが試せる新たな選択肢である。導入には作業全体を把握することが必要だ。モデルが何を生み、何を消費し、なお誰かが何を修正する必要があるか。
より広い影響として、日常業務でAIをより選択的に使うようになる可能性がある。定型分析には一つの設定、難しいコーディングには別の設定を選び、判断力や説明責任を委任できない事例では人間に任せることもできる。競争の激化は試す選択肢を増やすが、どれを選ぶべきかまでは決めない。
BIG CHANGEにとって次の節目は、総労力を減らしながら完了した作業を測定できることだ。Grok 4.7によって受け入れ可能な納品物の費用が下がれば、有用な自動化をより多くの組織が利用できる。追加の推論が、費用をトークン単価から消費量へ移しただけなら、見出しの価格は購入者の判断材料として乏しい。失敗したものも含む完了済みの作業が、その問いに答える証拠となる。