Grok 4.7, 2026 செப்டம்பர் 21 அன்று அறிமுகமானது. குறியீடு எழுதவோ வணிகத் தகவலைப் பகுப்பாய்வு செய்யவோ AI-ஐ வாங்கும் குழுக்களுக்கு, மேம்பட்ட மாதிரி முடித்த வேலையை மலிவாக்குகிறதா என்ற நடைமுறைக் கேள்வியை அதன் வெளியீடு எழுப்புகிறது. பதில், விளம்பரப்படுத்தப்பட்ட டோக்கன் கட்டணத்தைவிட அதிகமானவற்றைப் பொறுத்தது. அதிகாரபூர்வ வெளியீட்டுக் குறிப்புகள்
இந்தக் கலவையான படமே செப்டம்பர் 22 அன்று வெளியான Matthew Berman-இன் காணொளியின் தலைப்பு: Grok 4.7 பற்றி என்ன நினைப்பது என்று தெரியவில்லை…. ஒப்பீட்டுத் தேர்வுகளை அவர் கேள்விக்குட்படுத்தி, டோக்கன் விலையைவிட முடிக்கப்பட்ட ஒரு பணிக்கான செலவே முக்கியம் என வாதிடுகிறார். மாதிரியை இன்னும் முழுமையாகச் சோதிக்கவில்லை என்றும் கூறுகிறார். ஆதாரங்களின் தொடக்கநிலை மதிப்பீடுதான் அவரது காணொளி; விரிவான நேரடி மதிப்பீடு அல்ல. Berman-இன் அறிமுகம், 0:00
பயனுள்ள மாதிரி ஒவ்வொரு அளவுகோலிலும் வெல்ல வேண்டியதில்லை; வணிகங்கள் தானியக்கமாக்கக்கூடிய பணிகளின் செலவை மாற்றினாலே கவனம் பெறும் என்பதற்காக இந்த அறிமுகம் முக்கியம். இருப்பினும், மொத்தச் செலவை நியாயப்படுத்த, போதுமான வேலையைச் சரியாக முடிக்க வேண்டும். சுயாதீனச் சோதனைகள் ஏற்கெனவே உள்ள பதற்றத்தை வெளிப்படுத்துகின்றன: Grok 4.7-இன் மேம்பட்ட முடிவுகளுக்கு மிகவும் அதிகமான வெளியீடு தேவைப்படலாம்.
உருவாக்குநர்கள், சிறு வணிகங்கள், முகவர்களை உருவாக்கும் குழுக்கள் ஆகியவற்றுக்கு முடிவு நடைமுறையானது. இந்த மாதிரி ஏற்றுக்கொள்ளத்தக்க தரத்தில் எந்தப் பணிகளை முடிக்க முடியும்? அதற்கு எவ்வளவு முயற்சி தேவை? முடித்துவிட்டதாக மாதிரி கூறிய பிறகும் ஒருவர் எவ்வளவு வேலை செய்ய வேண்டும்?
Berman-இன் சுமார் 17 நிமிடக் காணொளியின் முழு வசனங்களையும் மதிப்பாய்வு செய்து, அறிமுகம், தயாரிப்பு ஆவணம், Artificial Analysis-இன் மதிப்பீடு ஆகியவற்றைச் சரிபார்த்தோம். கீழேயுள்ள பகுப்பாய்வில் BIG CHANGE அளவுகோல்களோ Grok-ஐ நேரடியாகச் சோதித்தோம் என்ற கூற்றோ இல்லை.
என்ன அறிமுகமானது, எங்கே கிடைக்கிறது
தரநிலை மாதிரி xAI API-யில் கிடைக்கிறது; grok-4.7Cursor மற்றும் Grok Build-லும் கிடைக்கிறது. API உரையையும் படங்களையும் ஏற்று, உரையை வெளியிடுகிறது. ஆவணப்படுத்தப்பட்ட சூழல் சாளரம் 500,000 டோக்கன்கள்; குறைவு, நடுத்தரம், உயர்வு, xhigh என நான்கு பகுத்தறிவு அமைப்புகள் உள்ளன. உயர்வே இயல்புநிலை. அதிகாரபூர்வ வெளியீட்டுக் குறிப்புகள்
பெரிய அடிப்படை மாதிரியும் கடினமான பணிகளில் நீண்ட வலுவூட்டல் கற்றலும் மேம்பாட்டுக்குக் காரணம் என SpaceXAI கூறுகிறது. இது உருவாக்குநரின் விளக்கம். அறிமுகத்தின் தொழில்நுட்ப மேலோட்டம்
Grok 4.7 Fast என்ற பதிப்பும் உள்ளது. வேகமான உள்கட்டமைப்பில் இயங்கும் அதே மாதிரி என ஆவணம் விவரிக்கிறது; வழக்கமான டோக்கன் கட்டணத்தின் இருமடங்கு விலை நிர்ணயிக்கப்பட்டுள்ளது. Cursor மற்றும் Grok Build வழியாக வழங்கப்படுகிறது; Grok Build-இன் இலவசத் திட்டத்தில் சேர்க்கப்படவில்லை; பொதுவான xAI API வழியாகக் கிடைக்காது. Grok 4.7 தயாரிப்பு ஆவணம்
திரைப்பிடிப்புகள், செயல்விளக்கங்கள், கட்டணக் கணக்குகள் ஆகியவற்றை ஒப்பிடும்போது இந்த வேறுபாடுகள் முக்கியம். மாதிரிப் பதிப்பு, பகுத்தறிவு முயற்சி, வழங்கும் நிலை ஆகியவை தனித்தனி தேர்வுகள். xhigh-இல் இயங்கும் Fast செயல்விளக்கம், வழக்கமான வேகத்திலான நடுத்தர முயற்சி API அழைப்பின் அனுபவத்தையோ செலவையோ மதிப்பிடாது.
அறிமுகப் பக்கத்தில் உள்ள பிற மாதிரிகளுடனான ஒப்பீட்டையும் மேம்படுத்துப் பதிப்புடனான ஒப்பீட்டையும் தனித்தனியாகவே பார்க்க வேண்டும். தரநிலை Grok 4.7, Grok 4.6-இன் விலையும் வேகமும் கொண்டதே என SpaceXAI கூறுகிறது. 4.6-இலிருந்து மேம்படுத்தினால் வாடிக்கையாளரின் கட்டணம் தானாகப் பாதியாகும் என்று அது கூறவில்லை.
விலை அட்டையில் நீண்ட-சூழல் வரம்பு உள்ளது
வெளியிடப்பட்ட தரநிலை API கட்டணங்கள்:
- 200,000 கேள்வித் டோக்கன்கள் வரை: ஒரு மில்லியன் டோக்கனுக்கு உள்ளீடு $2, தற்காலிகச் சேமிப்பிலுள்ள உள்ளீடு $0.50, வெளியீடு $6.
- 200,000 கேள்வித் டோக்கன்களுக்கு மேல்: ஒரு மில்லியன் டோக்கனுக்கு உள்ளீடு $4, தற்காலிகச் சேமிப்பிலுள்ள உள்ளீடு $1, வெளியீடு $12.
ஒரு பணியை முடிக்கும் முகவருக்கான முழுச் செலவல்ல இவை; டோக்கன் கட்டணங்கள் மட்டுமே. 200,000 டோக்கன்களைத் தாண்டும் கோரிக்கைகளுக்கு அதிக விலை பொருந்தும் என மாதிரிப் பக்கம் குறிப்பிடுகிறது; உயர்ந்த கட்டணங்களை வெளியீட்டுக் குறிப்புகளும் தெரிவிக்கின்றன. விலையும் கிடைப்பும் செப்டம்பர் 22 அன்று சரிபார்க்கப்பட்டன. மாதிரி விலை நிர்ணயம் மற்றும் வெளியீட்டுக் குறிப்புகள்
எனவே, 500,000 டோக்கன் சூழல் சாளரம் இருந்தாலும், அதற்குள் வரும் ஒவ்வொரு கோரிக்கைக்கும் குறைந்த கட்டணமே பொருந்தும் என்று பொருளல்ல. பெருமளவிலான கோப்புகளில் தொடர்புடைய ஒவ்வொரு விவரத்தையும் மாதிரி தொடர்ந்து கண்டுபிடிக்கும் என்பதைப் பெரிய சூழல் சாளரமும் நிறுவாது.
Cursor-இல் தயாரிப்பு நிலை சார்ந்த இன்னொரு வேறுபாடு உள்ளது: தரநிலைச் சூழல் சாளரம் 256,000 டோக்கன்கள்; அதிகபட்சம் 500,000 என்று அதன் ஆவணம் குறிப்பிடுகிறது. தொகுப்பியில் கிடைக்கும் திறன் API விவரக்குறிப்பிலிருந்து வேறுபடலாம் அல்லது தேர்ந்தெடுத்த முறையைப் பொறுத்திருக்கலாம். Cursor-இன் Grok 4.7 ஆவணம்
நீண்ட அறிக்கைகளைச் செயலாக்கும் குழுவுக்கு, முழுப் பொருளையும் அனுப்புவது செலவை நியாயப்படுத்தும் அளவுக்கு முடிவை மேம்படுத்துகிறதா என்பதே உடனடிக் கேள்வி. தொடர்புடைய பகுதிகளை மட்டும் மீட்டெடுப்பது மலிவாகவும் ஆராய எளிதாகவும் இருக்கலாம். சில நேரங்களில் முழு ஆவணம் தேவை; வேறு நேரங்களில் அது கேள்வியை அமைப்பதற்கான எளிய வழி மட்டுமே. இவ்விரு நிலைகளையும் ஒரே வரவுசெலவாகக் கணக்கிடக் கூடாது.
சிறந்த செயல்திறனுக்கு அதிக டோக்கன்கள் தேவைப்படலாம்
செப்டம்பர் 21 அன்று வெளியான Artificial Analysis மதிப்பீட்டில், xhigh அமைப்பிலுள்ள Grok 4.7, அதன் Intelligence Index-இல் 46 மதிப்பெண் பெற்றுள்ளது; Grok 4.6-ஐவிட இரண்டு புள்ளிகள் அதிகம். ஒரு பணிக்குச் சுமார் 81,000 வெளியீட்டு டோக்கன்கள் தேவைப்பட்டதாகவும், உயர்ந்த முயற்சியில் Grok 4.6-க்கு 36,000 தேவைப்பட்டதாகவும் அது தெரிவிக்கிறது. அதே முயற்சி அளவிலான ஒப்பீட்டிலும், xhigh அமைப்பிலுள்ள Grok 4.6-க்கு 38,000 என அறிக்கை கூறுகிறது; அதாவது வெளியீட்டு டோக்கன்கள் இருமடங்குக்கும் அதிகம். Artificial Analysis-இன் அறிமுக மதிப்பீடு
டோக்கன் விலையையும் பணிச் செலவையும் தனித்தனியாகப் பார்ப்பதற்கான தெளிவான காரணம் இது. அடிப்படை மில்லியன்-டோக்கன் விலையான $6-இல் 81,000 வெளியீட்டுத் டோக்கன்கள் எடுத்துக்காட்டாக $0.486 செலவாகும். 38,000 டோக்கன்களுக்கு அது $0.228 ஆகும். உள்ளீடு, தற்காலிகச் சேமிப்பு முறை, கருவிக் கட்டணம், உயர்ந்த சூழல் விலை, தோல்வியடைந்த முயற்சிகள் ஆகியவற்றை இந்தக் கணக்குகள் நோக்கமுடன் விலக்குகின்றன. அறிவிக்கப்பட்ட டோக்கன் எண்ணிக்கையைப் பயன்படுத்திய கணிதம் இவை; பணிக்கான அளவிடப்பட்ட முழுச் செலவுகள் அல்ல.
அதிக வெளியீடு என்றாலே வீணாக்கம் என்று பொருளல்ல. கூடுதல் முயற்சியுடன் பதிலைச் சரிபார்த்து, இல்லாவிட்டால் ஒருவர் தலையிட வேண்டிய தோல்வியை மாதிரி தவிர்க்கலாம். தவறான அணுகுமுறையை நீண்ட நேரம் பின்தொடரவும் கூடும். பயனுள்ள விடாமுயற்சியையும் செலவான மீள்முயற்சியையும் டோக்கன் எண்ணிக்கை மட்டும் வேறுபடுத்தாது.
காணொளியின் இறுதிப் பகுதியில் Berman மீண்டும் இந்தப் பிரச்சினையைப் பேசுகிறார்; Artificial Analysis தெரிவித்த அதிக டோக்கன் பயன்பாட்டைக் குறிப்பிடுகிறார். காணொளி, 15:43
ஏற்றுக்கொள்ளப்பட்ட வழங்கப்பட வேண்டிய பொருளே பயனுள்ள முடிவு. பொருத்தமான சோதனைகளிலும் மதிப்பாய்விலும் தேறும் குறியீட்டு மாற்றம், சூத்திரங்கள் ஒன்றோடொன்று பொருந்தும் விரிதாள், ஆதாரத்துடன் தொடர்புபடுத்தக்கூடிய கூற்றுகளுள்ள அறிக்கை ஆகியவை, விரைவாக வந்த பதிலைவிட வேறுபட்ட மதிப்பைக் கொண்டவை.
அளவுகோல்கள் திறமையானதாயினும் சீரற்ற மாதிரியைக் காட்டுகின்றன
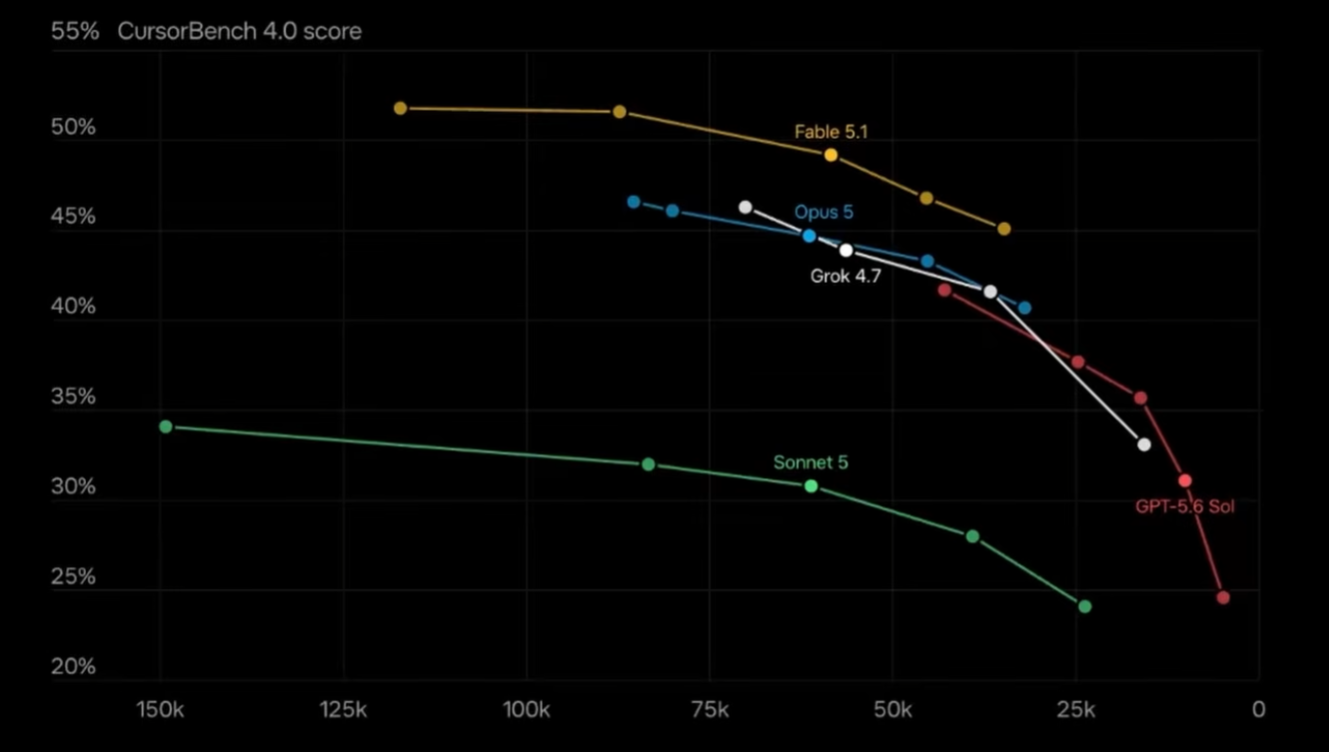
அறிமுக அட்டவணையில், CursorBench 4.0-இல் Grok 4.7 xhigh 46.3% பெற்றுள்ளது; Fable 5.1 max-இன் 51.8%-க்குக் கீழ். Terminal-Bench ஒப்பீட்டிலும் Fable முன்னிலை வகிக்கிறது. விற்பனையாளர் அளவுகோல் அட்டவணை
உடன் வந்த விளக்கப்படம், அளவுகோல் மதிப்பெண்ணையும் வெளியீட்டு டோக்கன்களையும் ஒப்பிடுகிறது; வலப்பக்கம் செல்லச் செல்ல டோக்கன்கள் குறைகின்றன. அதன் கோடுகள் பகுத்தறிவு அமைப்புகளை ஒப்பிடுகின்றன. அசல் ஊடாடும் விளக்கப்படம்: “Tokens” என்பதைத் தேர்ந்தெடுக்கவும். முழு அளவிலான விளக்கப்படத்தைத் திறக்கவும்.
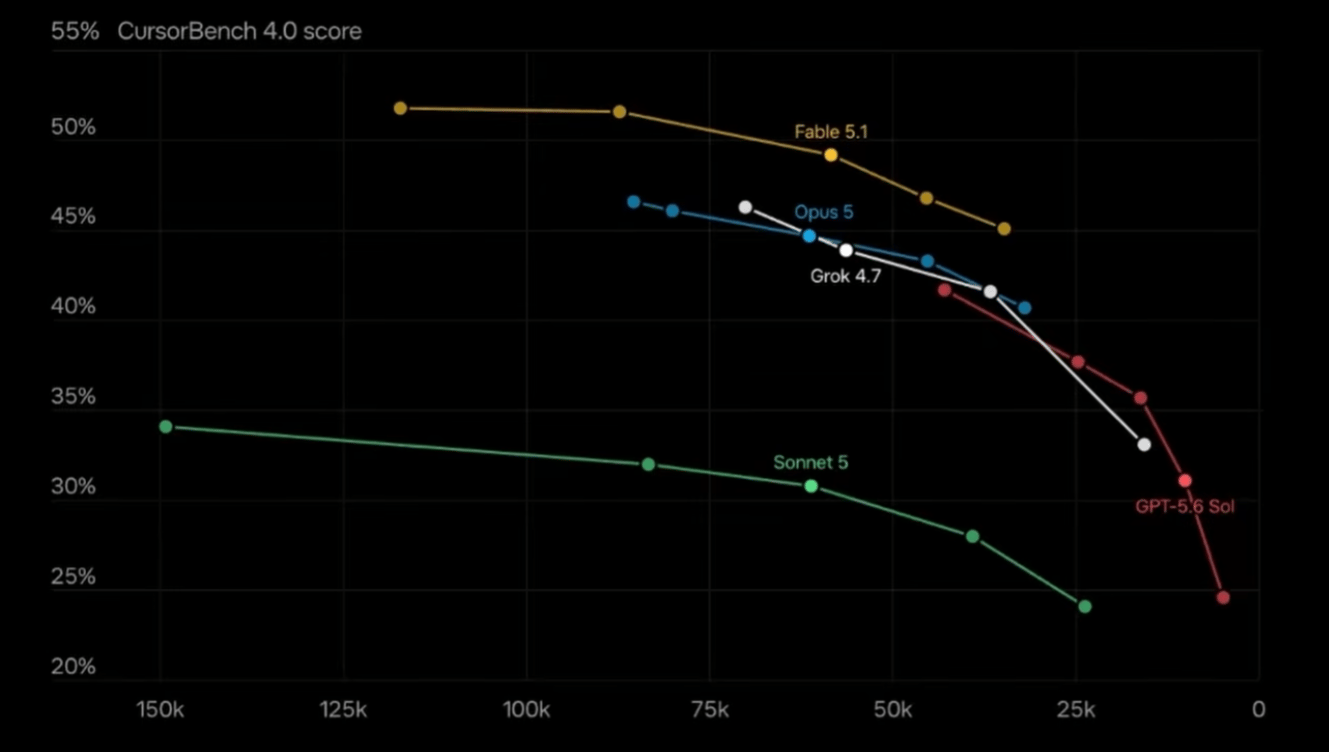
மேலே செல்வது அதிக மதிப்பெண்ணையும் வலப்புறம் செல்வது இந்த மதிப்பீட்டில் குறைவான உருவாக்கப்பட்ட டோக்கன்களையும் குறிக்கிறது. மொத்தக் கட்டணம் குறைவு என்று இதனால் பொருளல்ல: டோக்கன் கட்டணம், உள்ளீட்டுப் பயன்பாடு, சுற்றியுள்ள முகவர் ஆகியவையும் முக்கியம். மேலே கூறிய Artificial Analysis டோக்கன் எண்ணிக்கைகளிலிருந்து இதுவும் வேறுபட்ட சோதனை. இரண்டின் எண்ணிக்கைகளையும் ஒன்றாக்கினால், ஒவ்வொரு முடிவையும் புரிந்துகொள்ள உதவும் பணி மற்றும் முறையியல் வேறுபாடுகள் அழிந்துவிடும்.
எல்லா வகை குறியீட்டுப் பணிகளிலும் Grok 4.7 முன்னிலை வகிக்கிறது என்ற பொதுவான கூற்றை நிராகரிக்க இதுவே போதும். குறிப்பிட்ட பணிச்சுமைகளுக்கு நெருக்கமாக ஆராய்வதற்கான காரணமும் இதுவே. ஒரு மதிப்பீட்டில் கிடைத்த மேம்பாட்டின் அளவு, அறிமுகமில்லாத குறியீட்டுத் தொகுதி, முழுமையற்ற பிழை அறிக்கை அல்லது வழக்கத்திற்கு மாறான கருவிச் சூழலை மாதிரி எப்படிக் கையாளும் என்பதைத் தீர்மானிக்காது.
Artificial Analysis பயனுள்ள சுயாதீன வேறுபாட்டைக் காட்டுகிறது. Grok Build உடனான Grok 4.7-க்கு அதன் Coding Agent Index-இல் 56 மதிப்பெண் கிடைத்ததாகவும், அதே முகவருடன் Grok 4.6 பெற்ற 47-ஐவிட உயர்ந்ததாகவும் அறிக்கை கூறுகிறது. இந்தத் தனிப்பட்ட முகவர் முடிவுகளை, தரப்படுத்தப்பட்ட Intelligence Index அமைப்பிலிருந்து அது வெளிப்படையாகப் பிரிக்கிறது. சுயாதீன மதிப்பீடும் முறையியல் குறிப்புகளும்
சுற்றியுள்ள முகவரும் முக்கியம். அது கருவிகளை வழங்கி, சூழலை நிர்வகித்து, மாதிரியின் கோரிக்கைகள் எப்படிச் செயல்படுத்தப்படுகின்றன என்பதைத் தீர்மானிக்கிறது. மாதிரியின் பெயர் அதே இருந்தாலும் அந்தச் சூழலை மாற்றினால் முடிவுகளும் மாறலாம். ஒரு அமைப்பின் முனைய மதிப்பெண்ணையும் மற்றொரு அமைப்பின் மென்பொருள் பொறியியல் மதிப்பெண்ணையும் இணைத்தால், யாரும் உண்மையில் சோதிக்காத அமைப்பை விவரிக்கும் நம்பத்தகுந்த அட்டவணை உருவாகலாம்.
ஒரு வெளியீட்டு அட்டவணையில் GPT-6 Astra இல்லாததை Berman சுட்டிக்காட்டி, AI உருவாக்கிய மறுகட்டமைப்பைப் பயன்படுத்தி அதைச் சேர்க்கிறார். ஒப்பீட்டை ஆராய்வதற்கான தூண்டுதலாக இது பயனுள்ளது; அந்த மறுகட்டமைப்பு சுயாதீன அளவுகோல் ஆதாரமல்ல. அடிப்படை மதிப்பீட்டைச் சரிபார்க்காமல் சேர்க்கப்பட்ட எண்களை நாங்கள் ஏற்கவில்லை. காணொளி, 6:03
கவனத்தில் கொள்ள வேண்டிய வணிகத் தொடர்பும் உள்ளது. Cursor-ஐ SpaceX வாங்கியதாக ஆகஸ்ட் 14 நிறுவன அறிவிப்பு கூறுகிறது. அதே நிறுவனக் குடும்பத்துக்குள் வெளியிடப்பட்ட அளவுகோல் இன்னும் பயனுள்ள ஆதாரம்; ஆனால் போட்டியாளர் வழங்குநரைப் பற்றிய விருப்பமற்ற மதிப்பீடு அல்ல. Cursor கையகப்படுத்தல் அறிவிப்பு
அலுவலகப் பணி இன்னும் சுவாரசியமான வாய்ப்பாக இருக்கலாம்
Grok 4.7 xhigh-க்கு AA-Briefcase-இல் 1,657 Elo மதிப்பெண் கிடைத்ததாகவும், உயர்ந்த முயற்சியிலிருந்த Grok 4.6-ஐவிட 111 அதிகம் என்றும் சுயாதீன மதிப்பீடு தெரிவிக்கிறது. மேம்பாட்டின் பெரும்பகுதி பகுப்பாய்வுத் தரத்தால் ஏற்பட்டதாக அது கூறுகிறது; ஆனால் வழங்கல் தரம் முந்தைய மாதிரியின் முடிவைவிடச் சற்றுக் குறைவு. அறிவுசார் பணிகள் குறித்த Artificial Analysis முடிவுகள்
அறிக்கைகள், விரிதாள்கள், விளக்கக்காட்சிகளைப் பணியாக ஒப்படைக்கும் அனைவருக்கும் இந்தப் பிரிவு பயனுள்ளது. பதிலில் சிறந்த பகுப்பாய்வு இருந்தாலும், திருத்தமோ மறுவடிவமைப்போ தேவைப்படலாம். மெருகூட்டப்பட்ட விளக்கக்காட்சி ஆழமற்ற பகுத்தறிவை மறைக்கலாம். வெளியில் தெரியும் முடிவை மட்டும் மதிப்பிட்டால், தவறான மேம்பாட்டுக்குப் பரிசளிக்கும் அபாயம் உண்டு.
செயல்பாட்டுக் குழு, மீண்டும் மீண்டும் தயாரிக்கும் செயல்திறன் அறிக்கையில் மாதிரியைச் சோதிக்கலாம். அது சரியான காலப்பகுதியைப் பயன்படுத்துகிறதா, மூலத் தரவுடன் எண்களை ஒப்பிட்டு சரிபார்க்கிறதா, கவனிக்கப்பட்ட மாற்றத்தையும் முன்மொழியப்பட்ட விளக்கத்தையும் வேறுபடுத்துகிறதா என்பதைச் சோதனை பார்க்க வேண்டும். முதல் பார்வைக்கு அறிக்கை தொழில்முறையாகத் தெரிந்ததா என்பதோடு மட்டும் நிற்காமல், எவ்வளவு திருத்தம் தேவைப்பட்டது என்பதையும் மதிப்பாய்வாளர் பதிவு செய்ய வேண்டும்.
மிகக் கடினமான அளவுகோலில் வெல்வதைவிட, இல்லாவிட்டால் கட்டுப்படியாகாத பகுப்பாய்வை வழக்கமாகச் செய்வதே சிறு வணிகத்துக்கு முக்கியமாக இருக்கலாம். பரந்த தத்தெடுப்புக்கான சாத்தியமான பாதை அது. வெளியீடு துல்லியமாகவும் சரியான நேரத்திலும் வந்து, உரிமையாளர் கைமுறையாகச் செய்வதைவிடக் குறைந்த வேலையை விட்டுச் செல்லும்போது அது நனவாகிறது.
தொழில்முறை அளவுகோல் பெயர்களைத் தொழில்முறைத் தகுதிகளாகத் தவறாகக் கருதக்கூடாது. சட்டப் பணி அல்லது மருத்துவப் பகுத்தறிவு முடிவு, அந்த மதிப்பீட்டில் கிடைத்த செயல்திறனை விவரிக்கிறது. வாடிக்கையாளரின் சட்டச் சிக்கலைத் தன்னிச்சையாகக் கையாளவோ நோயாளிப் பராமரிப்பு முடிவெடுக்கவோ மாதிரி தகுதிபெற்றது என்பதை அது நிறுவாது. அத்தகைய முடிவுகளுக்கு Grok-ஐப் பயன்படுத்த இந்தக் கட்டுரை பரிந்துரைக்கவில்லை.
பாதுகாப்பு அம்சங்களையும் சூழலுடன் மதிப்பிட வேண்டும்
புதிய பாதுகாப்பு அடுக்குத் தொகுப்பும், ஜெயில்பிரேக் முயற்சிகளுக்கு மேம்பட்ட எதிர்ப்புத்திறனும் Grok 4.7-இல் உள்ளதாக SpaceXAI கூறுகிறது. இது அறிமுகக் கூற்று; அந்த மாதிரியைப் பயன்படுத்தும் ஒவ்வொரு செயலியும் பாதுகாப்பானது என்ற உத்தரவாதமல்ல. உருவாக்குநரின் பாதுகாப்பு விளக்கம்
வணிக முகவருக்கு குறைந்தது இரண்டு கேள்விகள் எஞ்சுகின்றன. பெறும் கோரிக்கைகளுக்கு மாதிரி பொருத்தமாகப் பதிலளிக்கிறதா? மாதிரியால் உண்மையில் என்ன செய்ய முடியும் என்பதைச் செயலி கட்டுப்படுத்துகிறதா?
வாடிக்கையாளர் பதிவை மாற்ற வேண்டும் என்ற அறிவுறுத்தலை மாதிரி சரியாகப் புரிந்துகொண்டாலும், அந்த மாற்றத்தைச் செய்ய அதற்கு அனுமதி இல்லாமல் இருக்கலாம். சுருக்கமளிக்க வேண்டிய ஆவணத்தில் பதிக்கப்பட்ட தீங்கிழைக்கும் அறிவுறுத்தல்களையும் அது சந்திக்கலாம். அணுகல் கட்டுப்பாடுகளும் ஒப்புதல் விதிகளும் சுற்றியுள்ள அமைப்பின் பகுதியாகவே இருக்க வேண்டும்; மறுப்பு நடத்தையில் ஏற்படும் மேம்பாடு அவற்றுக்குப் பதிலாகாது.
முழுப் பணிப்பாய்வையும் சோதிக்க வேண்டும் என்பதே நடைமுறை விளைவு. வெற்றிபெற வேண்டிய நியாயமான கோரிக்கைகள், தடுக்கப்பட வேண்டிய அனுமதியற்ற செயல்கள், விளக்கம் கேட்டு நிறுத்தப்பட வேண்டிய தெளிவற்ற நிலைகள் ஆகியவற்றைச் சேர்க்கவும். பாதிப்பில்லாத வேலையை அடிக்கடி மறுக்கும் தயாரிப்பு பயன்படுத்த முடியாததாகலாம்; அனுமதியற்ற செயல்களைச் செய்யும் ஒன்று அதைவிட மோசமாக இருக்கலாம். ஒற்றைத் தலைப்புச் செய்தி மதிப்பெண் இந்த இரு சிக்கல்களையும் காட்டாது.
காணொளி தீர்க்காமல் விட்டவை
கேள்விகளாகவே இருக்க வேண்டிய பல கேள்விகளை Berman-இன் கண்ணோட்டம் எழுப்புகிறது. விலையை கிடைக்கக்கூடிய கணினித் திறனுடன் இணைக்கும் அவரது விளக்கம் சந்தை குறித்த பொருளாக்கம்; வெளியிடப்பட்ட அலகுச் செலவுக் கணக்கல்ல. அவர் விவாதிக்கும் சமூக ஊடகக் கணிப்புகள், வழங்கப்பட்ட செயல்திறனுக்கான ஆதாரம் அல்ல; எதிர்பார்ப்புகளே. இறுதி செயல்விளக்க ஒப்பீட்டில் பயன்படுத்திய அமைப்புகள் என்னவென்று தனக்குத் தெரியாது என்பதையும் அவர் ஒப்புக்கொள்கிறார். விலை விவாதம், 8:44, எதிர்பார்ப்புகள், 11:51 மற்றும் செயல்விளக்க விவாதம், 15:20
திறந்த எடை மாதிரிகளையும் காணொளி விவாதிக்கிறது. அந்தப் பரந்த போட்டிப் போக்கை Grok 4.7-இன் உரிம நிபந்தனைகளுடன் குழப்பக் கூடாது: இந்த வெளியீடு தனியுரிமை கொண்டது என்றும் அதன் எடைகள் கிடைக்கவில்லை என்றும் Artificial Analysis குறிப்பிடுகிறது. Grok 4.7 வெளியீட்டுச் சுயவிவரம்
இந்த வேறுபாடுகள் மதிப்பீட்டை மையப்படுத்துகின்றன. வழங்குநர் ஏன் அந்த விலையைத் தேர்ந்தெடுத்தார் என்பதைப் பொதுமக்கள் அறியாவிட்டாலும், தயாரிப்புக்கு ஈர்க்கக்கூடிய விலை இருக்கலாம். தோல்வியடைந்த வியப்பூட்டும் செயல்விளக்கம், மீண்டும் செய்ய வேண்டிய ஒரு சோதனையைச் சுட்டலாம்; மாதிரி பொதுவாக மோசமானது என்பதை நிறுவாது. நிறுவனரின் முந்தைய கணிப்பை எட்டாவிட்டாலும் கிடைக்கும் மாதிரி பயனுள்ளதாக இருக்கலாம்.
விளம்பர ஆதரவுக்கும் ஒரு எல்லை உண்டு. Berman-இன் காணொளியில் Zapier விளம்பரம் இடம்பெறுகிறது. அது Grok செயல்திறனுக்கான சுயாதீன ஆதாரமல்ல; அதிலுள்ள விளம்பரக் கூற்றுகள் BIG CHANGE-இன் பரிந்துரைகளும் அல்ல.
சிறந்த கொள்முதல் அளவுகோல்: ஏற்றுக்கொள்ளப்பட்ட ஒவ்வொரு பணிக்கான செலவு
Grok 4.7-ஐப் பரிசீலிக்கும் குழு, சிறியதாயினும் வழக்கமான பணிகளைக் குறிக்கும் தொகுப்பில் தங்கள் தற்போதைய செயல்முறையுடன் ஒப்பிட வேண்டும். வெளியீடுகளைப் பார்ப்பதற்கு முன்பே ஏற்றுக்கொள்ளும் நிபந்தனைகளை வரையறுக்க வேண்டும். குறியீட்டுக்கு, பொருத்தமான சோதனைகள், வாசிக்கக்கூடிய திருத்தத் தொகுப்பு, தொடர்பற்ற மாற்றங்கள் இல்லாமை ஆகியவை அந்த நிபந்தனைகளாக இருக்கலாம். பகுப்பாய்வுக்கு, சரியான கணக்கீடுகளும் முக்கியமான கூற்றுகளுக்கான ஆதாரமும் தேவைப்படலாம்.
பிறகு முழுக் கட்டணத்தையும் பதிவு செய்யுங்கள்: உள்ளீடு, வெளியீட்டுப் பயன்பாடு, கருவிகள், மீண்டும் முயற்சிகள், முடிவை மதிப்பாய்வு செய்யவோ திருத்தவோ செலவிட்ட நேரம். தோல்வியடைந்த முயற்சிகளையும் எண்ணுங்கள். அந்தச் செலவை ஏற்றுக்கொள்ளும் நிபந்தனைகளைப் பூர்த்தி செய்த வழங்கல்களின் எண்ணிக்கையால் வகுக்கவும்.
இந்த வேறுபாடு ஏன் முக்கியம் என்பதை ஓர் எடுத்துக்காட்டு காட்டுகிறது. ஒரு அமைப்பு ஒரு தொகுதியில் $20 செலவிட்டு ஏற்றுக்கொள்ளப்பட்ட 80 முடிவுகளை வழங்குகிறது எனக் கொள்வோம். மனித உழைப்புக்கு முன், ஏற்றுக்கொள்ளப்பட்ட ஒவ்வொரு முடிவுக்கும் அளவிடப்பட்ட செலவு $0.25. மற்றொன்று $12 செலவிட்டும் 30 முடிவுகள் மட்டுமே ஏற்றுக்கொள்ளப்பட்டால், ஒவ்வொன்றுக்கும் $0.40 ஆகும். மலிவான தொகுப்பு, பயன்படுத்தக்கூடிய வேலையின் அதிகச் செலவுள்ள மூலமாகிறது. இவை கற்பனை எண்கள்; Grok அளவீடுகள் அல்ல.
பகுத்தறிவு முயற்சியையும் அந்தச் சோதனையில் சேர்க்க வேண்டும். உயர் முயற்சி அமைப்பு கடினமான பணியில் அதன் செலவுக்குரிய மதிப்பைத் தரலாம்; வழக்கமான பணியில் அதிகம் சேர்க்காமல் போகலாம். ஒவ்வொரு கோரிக்கையையும் xhigh-இல் இயக்குவதைவிட, தேவைப்படும் வழக்குகளுக்கு மட்டும் உயர்த்துவது சிக்கனமாக இருக்கலாம்; ஆனால் பணிகளை வழிமாற்றும் முடிவையும் மதிப்பிட வேண்டும்.
மாதிரிகளுக்கிடையில் மதிப்பாய்வு தரநிலைகளை ஒரே மாதிரியாக வைத்திருங்கள். மலிவான மாதிரிக்கான அளவுகோலைக் குறைப்பது மோசமான வேலையை ஏற்றுக்கொள்வதன் மூலம் போலியான சேமிப்பை உருவாக்கும். தற்போதைய மாதிரிக்கே அதிகத் தரநிலையை விதிப்பது எதிர்மறையான சாய்வை உருவாக்கும். நம்பகமான முடிவை வாங்குவதும், மக்கள் இன்னும் செய்ய வேண்டியதைத் தெளிவாகக் கணக்கிடுவதுமே நோக்கம்.
கவனிக்க வேண்டிய மாற்றம்
Grok 4.7 குழுக்களுக்கு இன்னொரு சோதனைத் தேர்வை வழங்குகிறது. அதைத் தேர்வுசெய்ய, முழுப் பணியையும் கவனிக்க வேண்டும்: மாதிரி எதை உருவாக்குகிறது, எதைப் பயன்படுத்துகிறது, ஒருவர் இன்னும் எதைச் சரிசெய்ய வேண்டும்.
அன்றாடப் பணிகளில் AI-யின் தேர்ந்தெடுத்த பயன்பாடு அதிகரிப்பதே பரந்த விளைவாக இருக்கலாம். வழக்கமான பகுப்பாய்வுக்கு ஒரு அமைப்பையும், கடினமான குறியீட்டுப் பணிக்கு மற்றொன்றையும், தீர்ப்பையோ பொறுப்பேற்பையோ ஒப்படைக்க முடியாத சந்தர்ப்பங்களில் மனிதரையும் குழு தேர்ந்தெடுக்கலாம். அதிகப் போட்டி அந்தக் குழுவுக்குச் சோதிக்க இன்னொரு தேர்வைத் தருகிறது; எது வெல்ல வேண்டும் என்று கட்டளையிடாது.
BIG CHANGE-க்கு அடுத்த மைல்கல், குறைந்த மொத்த முயற்சியுடன் அளவிடக்கூடிய வேலையை முடிப்பதே. ஏற்றுக்கொள்ளப்பட்ட வழங்கல்களின் செலவை Grok 4.7 குறைத்தால், பயனுள்ள தானியக்கத்தை மேலும் பல நிறுவனங்களுக்கு அணுகக்கூடியதாக்கும். கூடுதல் பகுத்தறிவு, டோக்கன் விலையிலிருந்த செலவைப் பயன்படுத்தப்படும் டோக்கன்களின் அளவுக்குள் மட்டும் நகர்த்தினால், தலைப்பில் உள்ள விலை வாங்குபவர்களுக்கு மிகக் குறைவாகவே தெரிவிக்கும். முதலில் தோல்வியடைந்த பணிகள் உட்பட முடிந்த பணிகளிலிருந்தே அந்தக் கேள்விக்கான தீர்மான ஆதாரம் வரும்.