Grok 4.7 hadir pada 21 September 2026. Bagi tim yang membeli AI untuk menulis kode atau menganalisis informasi bisnis, peluncurannya memunculkan pertanyaan praktis: apakah model yang lebih baik membuat pekerjaan yang selesai menjadi lebih murah? Jawabannya bergantung pada lebih dari sekadar tarif token yang diiklankan. Catatan rilis resmi
Gambaran yang beragam ini menjadi pokok video Matthew Berman pada 22 September, Saya tidak tahu harus merasa bagaimana tentang Grok 4.7…. Ia mempertanyakan pilihan pembanding dan berpendapat bahwa biaya per tugas yang selesai lebih penting daripada harga token. Ia juga mengatakan belum menguji model itu secara menyeluruh. Videonya merupakan penilaian awal atas bukti yang ada, bukan evaluasi langsung yang komprehensif. Pengantar Berman, 0:00
Peluncuran ini patut diperhatikan karena model yang berguna tidak harus unggul di setiap tolok ukur untuk mengubah jenis otomatisasi yang mampu dibeli bisnis. Namun, model itu harus menyelesaikan cukup banyak pekerjaan dengan benar agar sepadan dengan biaya totalnya. Pengujian independen sudah menunjukkan ketegangannya: hasil Grok 4.7 yang lebih baik dapat disertai jauh lebih banyak keluaran yang dihasilkan.
Karena itu, keputusan bagi pengembang, bisnis kecil, dan tim pembangun agen bersifat praktis. Tugas mana yang dapat diselesaikan model ini dengan mutu yang memadai? Berapa banyak upaya yang dibutuhkan? Dan berapa banyak pekerjaan yang masih harus dilakukan seseorang setelah model mengatakan tugasnya selesai?
Kami meninjau seluruh takarir video Berman yang berdurasi sekitar 17 menit dan memeriksa peluncuran, dokumentasi produk, serta evaluasi Artificial Analysis. Analisis berikut tidak memuat tolok ukur BIG CHANGE atau klaim bahwa kami menguji Grok secara langsung.
Apa yang diluncurkan dan di mana tersedia
Model standarnya tersedia melalui API xAI sebagai grok-4.7, juga di Cursor dan Grok Build. API menerima teks dan gambar serta menghasilkan teks. Jendela konteks yang didokumentasikan mencapai 500.000 token, dengan empat pengaturan penalaran: low, medium, high, dan xhigh. High adalah pengaturan bawaan. Catatan rilis resmi
SpaceXAI mengaitkan peningkatan ini dengan model dasar yang lebih besar dan pelatihan penguatan lebih lama pada tugas yang lebih sulit. Ini penjelasan pengembang. Ikhtisar teknis peluncuran
Ada pula Grok 4.7 Fast. Dokumentasi menggambarkannya sebagai model yang sama pada infrastruktur lebih cepat, dengan tarif token dua kali lipat dari standar. Model ini ditawarkan melalui Cursor dan Grok Build, tidak termasuk dalam tingkat gratis Grok Build, dan tidak tersedia melalui API xAI publik. Dokumentasi produk Grok 4.7
Pembedaan ini penting saat membandingkan tangkapan layar, demonstrasi, dan tagihan. Versi model, upaya penalaran, dan tingkat layanan merupakan pilihan terpisah. Demonstrasi yang menggunakan Fast pada xhigh bukan perkiraan pengalaman atau biaya panggilan API dengan kecepatan standar pada tingkat medium.
Perbandingan model pada halaman peluncuran juga perlu dipisahkan dari perbandingan peningkatan. SpaceXAI menyatakan bahwa Grok 4.7 standar memiliki harga dan kecepatan yang sama dengan Grok 4.6. Perusahaan tidak mengatakan bahwa peningkatan dari 4.6 otomatis mengurangi separuh tagihan pelanggan.
Kartu harga memiliki ambang batas untuk konteks panjang
Tarif standar API yang dipublikasikan adalah:
- Hingga 200.000 token prompt: $2 untuk input, $0,50 untuk input yang di-cache, dan $6 untuk output per satu juta token.
- Di atas 200.000 token prompt: $4 untuk input, $1 untuk input yang di-cache, dan $12 untuk output per satu juta token.
Ini tarif token, bukan harga lengkap untuk agen yang menyelesaikan tugas. Halaman model menandai harga lebih tinggi untuk permintaan yang melampaui 200.000 token, dan catatan rilis merinci tarif tersebut. Harga serta ketersediaan diperiksa pada 22 September. Harga model dan catatan rilis
Karena itu, jendela konteks 500.000 token tidak berarti setiap permintaan dalam batas tersebut dikenai tarif terendah. Jendela konteks yang besar juga tidak membuktikan bahwa model akan selalu menemukan setiap detail yang relevan dalam kumpulan berkas besar.
Dokumentasi Cursor menambahkan pembedaan lain pada tingkat produk: jendela standar yang tercantum adalah 256.000 token dan maksimumnya 500.000. Kapasitas yang tersedia di editor dapat berbeda dari spesifikasi API atau bergantung pada mode yang dipilih. Dokumentasi Grok 4.7 di Cursor
Bagi tim yang memproses laporan panjang, pertanyaan langsungnya adalah apakah mengirim semua materi meningkatkan hasil cukup besar untuk membenarkan biayanya. Mengambil bagian yang relevan bisa lebih murah dan lebih mudah diperiksa. Kadang dokumen lengkap memang diperlukan; kadang itu hanya cara termudah menyusun prompt. Situasi-situasi tersebut tidak seharusnya dianggarkan seolah-olah sama.
Kinerja yang lebih baik dapat menghabiskan lebih banyak token
Evaluasi Artificial Analysis pada 21 September memberi Grok 4.7 pada xhigh skor 46 di Intelligence Index, dua poin di atas Grok 4.6. Laporan itu mencatat sekitar 81.000 token output per tugas, dibandingkan 36.000 pada Grok 4.6 dengan upaya high. Laporan yang sama mencatat 38.000 untuk Grok 4.6 pada xhigh, sehingga perbandingan dengan tingkat upaya sama pun menunjukkan penggunaan token output lebih dari dua kali lipat. Evaluasi peluncuran Artificial Analysis
Ini alasan konkret untuk memisahkan harga token dari biaya tugas. Penggunaan 81.000 token output pada tarif dasar $6 per sejuta menghasilkan biaya output ilustratif sebesar $0,486. Untuk 38.000 token, biayanya $0,228. Perhitungan tersebut sengaja mengecualikan input, perilaku cache, biaya alat, harga konteks yang lebih tinggi, dan upaya yang gagal. Angkanya adalah perhitungan dari jumlah token yang dilaporkan, bukan harga pekerjaan lengkap yang diukur.
Output yang lebih banyak tidak selalu boros. Model mungkin mengerahkan upaya ekstra untuk memeriksa jawaban dan menghindari kegagalan yang jika tidak akan memerlukan campur tangan seseorang. Model juga mungkin menghabiskan waktu lebih lama untuk pendekatan yang keliru. Jumlah token saja tidak dapat membedakan ketekunan yang produktif dari pengulangan yang mahal.
Berman kembali membahas masalah ini mendekati akhir videonya, saat ia mencatat penggunaan token lebih tinggi yang dilaporkan Artificial Analysis. Video, 15:43
Hasil yang berguna adalah keluaran yang diterima. Perubahan kode yang lolos pengujian dan peninjauan yang sesuai, lembar kerja dengan rumus yang saling cocok, atau laporan dengan klaim yang dapat ditelusuri ke bukti memiliki nilai berbeda dari jawaban yang sekadar datang cepat.
Tolok ukur menunjukkan model yang cakap tetapi belum merata
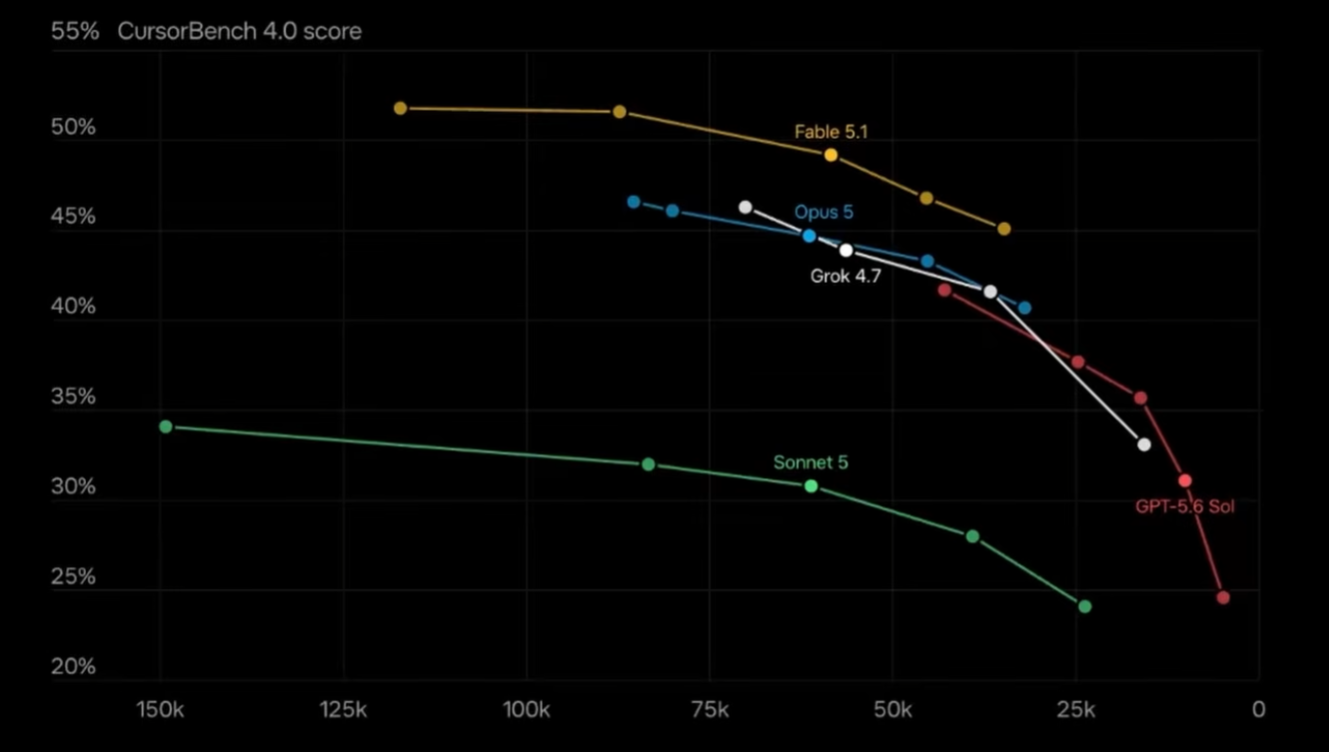
Tabel peluncuran memberi Grok 4.7 xhigh skor 46,3% di CursorBench 4.0, di bawah Fable 5.1 max yang mendapat 51,8%. Fable juga unggul dalam perbandingannya di Terminal-Bench. Tabel tolok ukur vendor
Grafik pendamping memetakan skor tolok ukur terhadap token output, dengan nilai yang menurun ke arah kanan. Garisnya membandingkan pengaturan penalaran. Grafik interaktif asli: pilih Tokens. Buka grafik ukuran penuh.
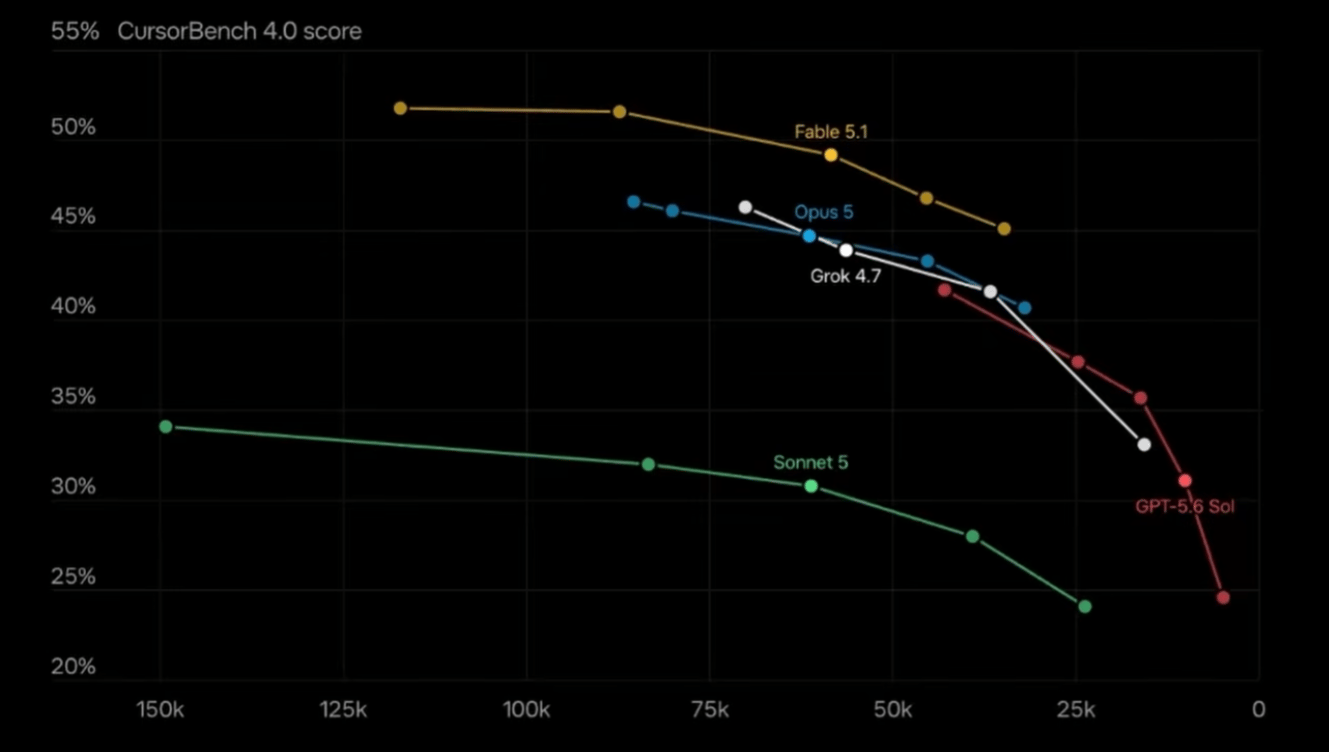
Bergerak ke atas berarti skor lebih tinggi; bergerak ke kanan berarti token yang dihasilkan dalam evaluasi ini lebih sedikit. Ini tidak berarti harga total lebih rendah: tarif token, penggunaan input, dan sistem agen di sekelilingnya tetap berpengaruh. Ini juga pengujian berbeda dari angka token Artificial Analysis di atas. Menggabungkan jumlah token dari keduanya akan menghapus perbedaan tugas dan metodologi yang membuat masing-masing hasil dapat ditafsirkan.
Itu cukup untuk menolak klaim menyeluruh bahwa Grok 4.7 memimpin semua jenis pekerjaan pemrograman. Bukti itu juga cukup untuk membenarkan penelaahan lebih dekat pada beban kerja tertentu. Besarnya peningkatan dalam satu evaluasi tidak menentukan bagaimana model akan menangani repositori yang belum dikenal, laporan bug yang tidak lengkap, atau lingkungan alat yang tidak biasa.
Artificial Analysis memberikan pembedaan independen yang berguna. Laporannya memberi skor Coding Agent Index 56 untuk Grok 4.7 dengan Grok Build, naik dari 47 untuk Grok 4.6 dengan agen tersebut. Laporan itu secara eksplisit memisahkan hasil agen bawaan ini dari pengaturan Intelligence Index yang terstandardisasi. Evaluasi independen dan catatan metodologi
Sistem agen di sekeliling model juga penting. Sistem itu menyediakan alat, mengelola konteks, dan memutuskan cara menjalankan permintaan model. Mengubah lingkungan tersebut dapat mengubah hasil meski nama model tetap sama. Menggabungkan skor terminal dari satu pengaturan dengan skor rekayasa perangkat lunak dari pengaturan lain dapat menghasilkan tabel meyakinkan yang sebenarnya tidak menggambarkan sistem apa pun yang pernah diuji seseorang.
Berman menyoroti ketiadaan GPT-6 Astra dari salah satu tabel peluncuran dan menggunakan rekonstruksi buatan AI untuk menambahkannya. Ini pengingat yang berguna untuk menyelidiki pembanding tersebut; rekonstruksi itu bukan sumber tolok ukur independen. Kami tidak memakai angka tambahannya tanpa memeriksa evaluasi yang mendasarinya. Video, 6:03
Ada pula hubungan komersial yang perlu diperhatikan. Pengumuman perusahaan Cursor pada 14 Agustus menyatakan bahwa perusahaan itu diakuisisi SpaceX. Tolok ukur yang diterbitkan dalam keluarga produk yang sama tetap merupakan bukti berguna, tetapi bukan penilaian tanpa kepentingan atas pemasok pesaing. Pengumuman akuisisi Cursor
Pekerjaan kantor mungkin merupakan peluang yang lebih menarik
Evaluasi independen tersebut melaporkan skor AA-Briefcase 1.657 Elo untuk Grok 4.7 pada xhigh, 111 poin di atas Grok 4.6 pada high. Sebagian besar peningkatan, menurut laporan itu, berasal dari mutu analisis, sementara mutu penyajian sedikit lebih rendah daripada hasil model sebelumnya. Hasil kerja berbasis pengetahuan dari Artificial Analysis
Pemisahan itu berguna bagi siapa pun yang meminta laporan, lembar kerja, atau presentasi. Jawaban dapat memuat analisis lebih kuat tetapi tetap memerlukan penyuntingan atau perancangan ulang. Sebaliknya, presentasi yang rapi dapat menyembunyikan penalaran dangkal. Menilai hanya hasil akhir yang terlihat berisiko memberi penghargaan pada peningkatan yang keliru.
Tim operasional dapat menguji model pada laporan kinerja berulang. Uji coba yang berguna akan memeriksa apakah model menggunakan periode yang benar, mencocokkan angka dengan data sumber, dan membedakan perubahan yang diamati dari penjelasan yang diusulkan. Peninjau perlu mencatat banyaknya koreksi yang diperlukan, bukan hanya apakah laporan tampak profesional saat pertama kali diperiksa.
Bisnis yang lebih kecil mungkin kurang peduli pada kemenangan di tolok ukur tersulit dan lebih peduli pada rutinitas analisis yang sebelumnya tak mampu dibeli. Ini jalur yang masuk akal menuju adopsi yang lebih luas. Jalur itu baru menjadi nyata ketika output cukup akurat, tiba tepat waktu, dan menyisakan lebih sedikit pekerjaan bagi pemiliknya dibandingkan jika tugas dilakukan manual.
Label tolok ukur profesional jangan disamakan dengan kualifikasi profesional. Hasil hukum atau penalaran klinis menggambarkan kinerja pada evaluasi tersebut. Hasil itu tidak membuktikan bahwa model dapat menangani perkara hukum klien atau mengambil keputusan perawatan pasien secara mandiri. Artikel ini tidak merekomendasikan penggunaan Grok untuk keputusan tersebut.
Klaim perlindungan juga harus dinilai dalam konteks
SpaceXAI menyatakan Grok 4.7 memiliki rangkaian perlindungan baru dan ketahanan yang lebih kuat terhadap jailbreak. Ini klaim peluncuran, bukan jaminan bahwa setiap aplikasi yang menggunakan model tersebut akan aman. Penjelasan keselamatan pengembang
Bagi agen bisnis, setidaknya ada dua pertanyaan yang belum terjawab. Apakah model merespons dengan tepat terhadap permintaan yang diterimanya? Dan apakah aplikasi membatasi tindakan yang benar-benar dapat dilakukan model?
Model dapat memahami dengan benar instruksi untuk mengubah catatan pelanggan, tetapi tidak memiliki izin untuk melakukannya. Model juga dapat menemukan instruksi berbahaya yang disisipkan dalam dokumen yang seharusnya diringkas. Kontrol akses dan aturan persetujuan harus tetap menjadi bagian dari sistem di sekelilingnya; kemampuan menolak yang lebih baik tidak menggantikan keduanya.
Implikasi praktisnya adalah menguji seluruh alur kerja. Sertakan permintaan sah yang seharusnya berhasil, tindakan terlarang yang harus diblokir, dan kasus ambigu yang perlu dijeda untuk meminta klarifikasi. Produk yang terlalu sering menolak pekerjaan yang tidak berbahaya bisa tidak berguna; produk yang melakukan tindakan tanpa izin bisa jauh lebih buruk. Tidak satu pun masalah ini tertangkap oleh satu skor utama.
Hal yang belum terjawab oleh video
Liputan Berman mengangkat beberapa pertanyaan yang sebaiknya tetap dianggap sebagai pertanyaan. Penjelasannya yang mengaitkan harga dengan kapasitas komputasi yang tersedia merupakan tafsir pasar, bukan perhitungan biaya per unit yang diungkap. Prediksi media sosial yang ia bahas adalah harapan, bukan bukti kinerja yang telah diberikan. Perbandingan demonstrasi di bagian akhir disertai pengakuannya sendiri bahwa ia tidak mengetahui pengaturan yang digunakan. Pembahasan harga, 8:44, harapan, 11:51 dan pembahasan demo, 15:20
Video tersebut juga membahas model open-weight. Tren persaingan yang lebih luas itu tidak boleh disamakan dengan lisensi Grok 4.7: Artificial Analysis mengidentifikasi rilis ini sebagai model proprietari dan mencatat bobotnya tidak tersedia. Profil rilis Grok 4.7
Pembedaan ini menjaga fokus evaluasi. Produk dapat memiliki harga menarik tanpa publik mengetahui alasan pemasok memilih harga itu. Demonstrasi gagal yang mencolok dapat menunjukkan pengujian yang patut diulangi tanpa membuktikan bahwa model umumnya buruk. Model yang tersedia dapat berguna tanpa memenuhi prakiraan pendiri sebelumnya.
Ada pula batas terkait sponsor. Video Berman memuat iklan Zapier. Iklan tersebut bukan bukti independen tentang kinerja Grok, dan klaim promosinya bukan rekomendasi dari BIG CHANGE.
Metrik pembelian yang lebih baik: biaya per tugas yang diterima
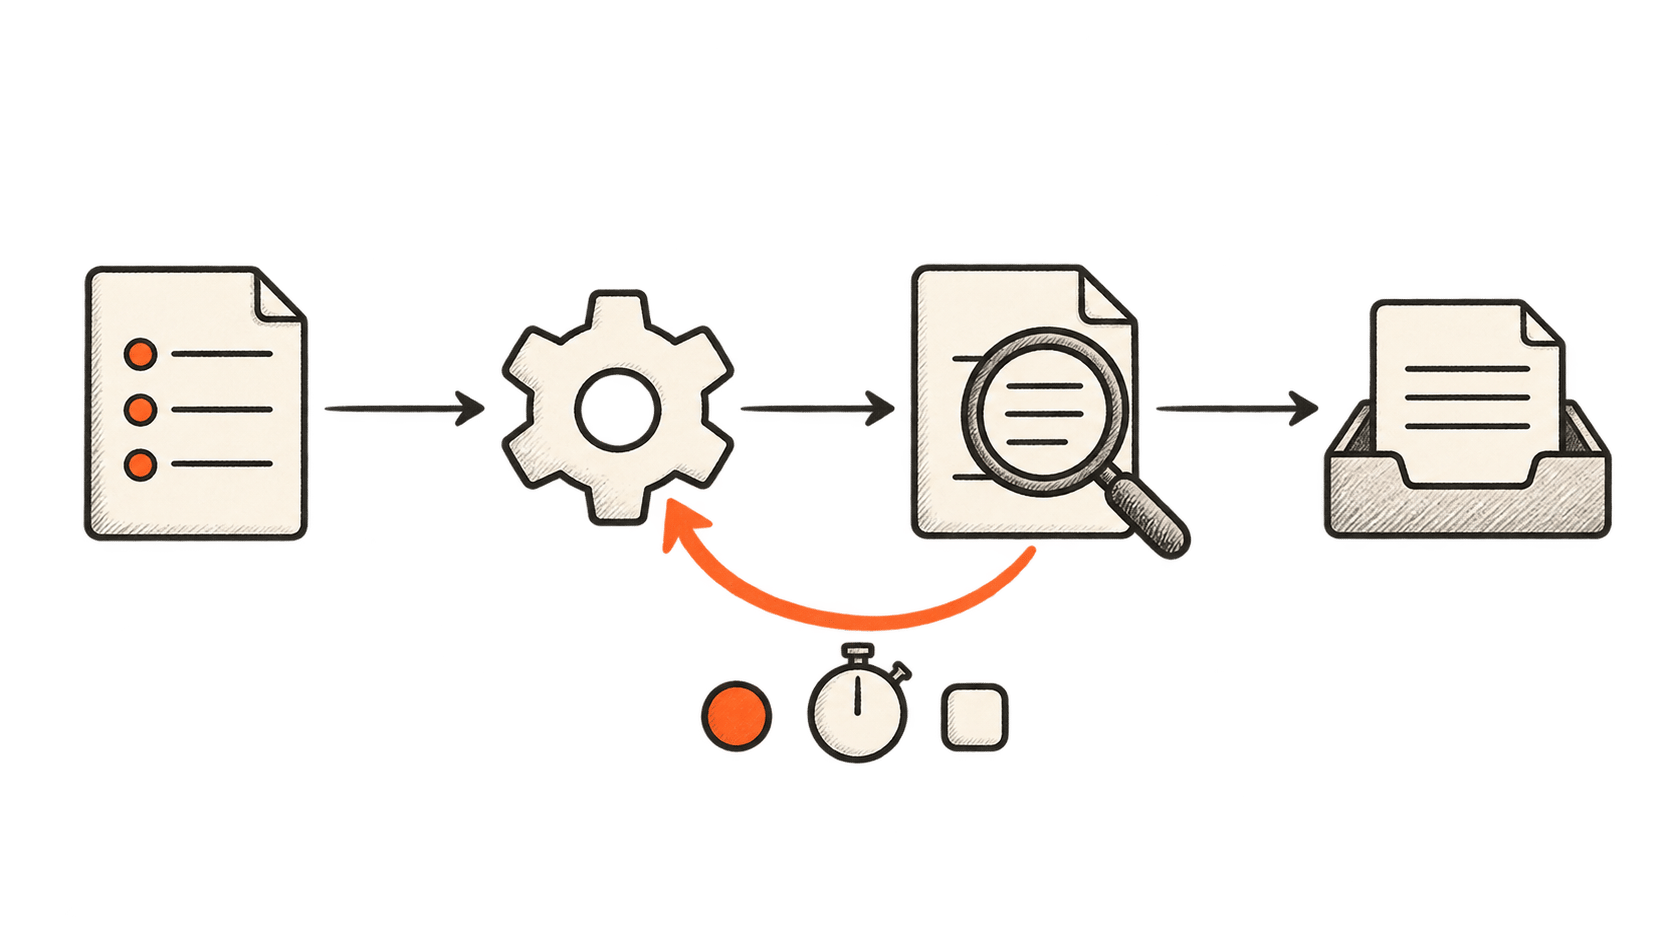
Tim yang mempertimbangkan Grok 4.7 sebaiknya membandingkannya dengan proses mereka saat ini menggunakan sekumpulan kecil tugas yang mewakili pekerjaan sebenarnya. Tetapkan kriteria penerimaan sebelum melihat output. Untuk pemrograman, kriteria itu dapat mencakup pengujian relevan, patch yang mudah dibaca, dan tidak adanya perubahan yang tidak terkait. Untuk analisis, kriteria dapat mencakup perhitungan yang benar serta bukti untuk klaim yang berkonsekuensi.
Kemudian catat seluruh biaya: penggunaan input dan output, alat, percobaan ulang, serta waktu yang dihabiskan untuk meninjau atau memperbaiki hasilnya. Hitung juga upaya yang gagal. Bagi biaya tersebut dengan jumlah keluaran yang memenuhi kriteria penerimaan.
Contoh ilustratif menunjukkan mengapa pembedaan ini penting. Misalkan satu konfigurasi berbiaya $20 untuk satu kelompok pekerjaan dan menghasilkan 80 keluaran yang diterima. Biaya terukurnya adalah $0,25 per hasil yang diterima, sebelum tenaga manusia dihitung. Konfigurasi lain berbiaya $12 tetapi hanya menghasilkan 30 keluaran yang diterima, sehingga biayanya $0,40 per hasil yang diterima. Kelompok yang lebih murah menjadi sumber pekerjaan berguna yang lebih mahal. Ini angka hipotetis, bukan pengukuran Grok.
Upaya penalaran sebaiknya menjadi bagian dari uji coba tersebut. Pengaturan upaya tinggi mungkin sepadan untuk tugas sulit, tetapi hanya memberi sedikit manfaat pada tugas rutin. Menaikkan tingkat upaya hanya pada kasus yang membutuhkannya bisa lebih hemat daripada menjalankan setiap permintaan pada xhigh, asalkan keputusan perutean itu sendiri juga dievaluasi.
Pertahankan standar peninjauan yang sama untuk setiap model. Menurunkan ambang bagi model yang lebih murah menimbulkan kesan hemat dengan menerima pekerjaan lebih buruk. Sebaliknya, menaikkan ambang hanya bagi model yang sedang digunakan menimbulkan distorsi yang berlawanan. Tujuannya adalah memperoleh hasil andal sambil menjelaskan dengan gamblang pekerjaan yang masih harus dilakukan orang.
Perubahan yang perlu dipantau
Grok 4.7 memberi tim satu opsi lain untuk diuji. Memilihnya memerlukan pandangan atas seluruh tugas: apa yang dihasilkan model, apa yang dikonsumsinya, dan apa yang masih harus diperbaiki seseorang.
Dampak yang lebih luas dapat berupa penggunaan AI yang lebih selektif dalam pekerjaan sehari-hari. Tim dapat memilih satu konfigurasi untuk analisis rutin, konfigurasi lain untuk pemrograman sulit, dan manusia untuk kasus ketika pertimbangan atau akuntabilitas tidak dapat didelegasikan. Persaingan yang lebih besar memberi tim opsi lain untuk diuji; persaingan itu tidak menentukan opsi mana yang harus menang.
Bagi BIG CHANGE, tonggak berikutnya adalah pekerjaan terukur yang selesai dengan upaya total lebih sedikit. Jika Grok 4.7 mengurangi biaya keluaran yang diterima, otomatisasi yang berguna dapat tersedia bagi lebih banyak organisasi. Jika penalaran tambahan hanya memindahkan biaya dari harga token ke jumlah token yang dikonsumsi, harga utama hanya sedikit memberi informasi kepada pembeli. Bukti untuk menjawab pertanyaan itu akan berasal dari pekerjaan yang selesai, termasuk yang sebelumnya gagal.