Grok 4.7 je predstavljen 21. septembra 2026. Timovima koji kupuju AI za pisanje koda ili analizu poslovnih podataka njegovo izdanje postavlja praktično pitanje: da li bolji model pojeftinjuje završen posao? Odgovor ne zavisi samo od oglašenih cena tokena. Zvanične napomene o izdanju
Mešovita slika tema je videa Metjua Bermana od 22. septembra, Ne znam šta da mislim o Groku 4.7…. Preispituje izbor poređenja i tvrdi da je trošak po završenom zadatku važniji od cena tokena. Kaže i da model nije temeljno testirao. Njegov video je rana procena dokaza, a ne sveobuhvatna praktična evaluacija. Bermanov uvod, 0:00
Pokretanje zaslužuje pažnju jer koristan model ne mora pobediti na svakom merilu da bi promenio koliko firme mogu da priušte automatizaciju. Ipak, mora dovoljno često tačno da završi posao kako bi opravdao ukupan trošak. Nezavisna ispitivanja već pokazuju napetost: bolji rezultati Groka 4.7 mogu zahtevati mnogo veći obim generisanog teksta.
Za programere, mala preduzeća i timove koji prave agente odluka je praktična. Koje zadatke ovaj model može da završi uz prihvatljiv kvalitet? Koliko mu rada treba? Koliko posla ostaje čoveku pošto model kaže da je završio?
Pregledali smo potpune titlove Bermanovog videa od oko 17 minuta i proverili predstavljanje, dokumentaciju proizvoda i evaluaciju Artificial Analysis-a. U analizi nema merila BIG CHANGE-a niti tvrdnje da smo lično testirali Grok.
Šta je predstavljeno i gde je dostupno
Standardni model dostupan je preko API-ja kompanije xAI kao grok-4.7, kao i u alatima Cursor i Grok Build. API prima tekst i slike, a generiše tekst. Dokumentovani kontekstni prozor iznosi 500.000 tokena, a dostupna su četiri nivoa rezonovanja: low, medium, high i xhigh. Podrazumevani nivo je high. Zvanične napomene o izdanju
SpaceXAI pripisuje poboljšanje većem osnovnom modelu i dužem učenju potkrepljenom povratnim informacijama za teže zadatke. To je objašnjenje proizvođača. Tehnički pregled pokretanja
Postoji i Grok 4.7 Fast. Dokumentacija ga opisuje kao isti model na bržoj infrastrukturi, uz dvostruku standardnu cenu tokena. Dostupan je preko Cursor-a i Grok Build-a, izuzet je iz besplatnog nivoa Grok Build-a i nije dostupan preko javnog API-ja xAI-ja. Dokumentacija proizvoda Grok 4.7
Te razlike su važne pri poređenju snimaka ekrana, demonstracija i računa. Verzija modela, nivo rezonovanja i način pružanja usluge odvojeni su izbori. Demonstracija koja koristi Fast uz xhigh nije procena iskustva ili troška standardnog API poziva sa nivoom medium.
Poređenje sa drugim modelima na stranici pokretanja treba razlikovati od poređenja nadogradnje. SpaceXAI navodi da standardni Grok 4.7 ima istu cenu i brzinu kao Grok 4.6. Ne tvrdi da će prelazak sa 4.6 automatski prepoloviti račun korisnika.
Cenovnik ima prag za dugačak kontekst
Objavljene standardne API cene su:
- Za najviše 200.000 ulaznih tokena: 2 dolara za ulaz, 0,50 dolara za keširane ulazne tokene i 6 dolara za izlaz, na milion tokena.
- Za više od 200.000 ulaznih tokena: 4 dolara za ulaz, 1 dolar za keširane ulazne tokene i 12 dolara za izlaz, na milion tokena.
To su cene tokena, a ne ukupni trošak agenta koji završava posao. Stranica modela upozorava na više cene za zahteve iznad 200.000 tokena, a napomene o izdanju navode konkretne više cene. Cene i dostupnost proverene su 22. septembra. Cene modela i napomene o izdanju
Zato kontekstni prozor od 500.000 tokena ne znači da će svaki zahtev u tom rasponu koristiti najnižu cenu. Ni veliki kontekstni prozor ne dokazuje da će model pouzdano pronaći svaki važan detalj u velikom skupu datoteka.
Dokumentacija Cursor-a navodi standardni kontekstni prozor od 256.000 tokena i maksimum od 500.000. Kapacitet dostupan u uređivaču može se razlikovati od specifikacije API-ja ili zavisiti od izabranog režima. Dokumentacija Cursor-a za Grok 4.7
Za tim koji obrađuje dugačke izveštaje, neposredno pitanje je da li slanje celog materijala dovoljno poboljšava rezultat da opravda cenu. Izdvajanje relevantnih odeljaka može biti jeftinije i lakše za proveru. Ponekad je potreban ceo dokument; ponekad je to samo najlakši način da se napravi upit. Takve situacije ne treba budžetirati kao da su iste.
Bolji učinak može potrošiti više tokena
Evaluacija Artificial Analysis-a od 21. septembra daje Groku 4.7 sa podešavanjem xhigh rezultat 46 na indeksu inteligencije, dva poena više nego Groku 4.6. Navodi oko 81.000 izlaznih tokena po zadatku, u poređenju sa 36.000 za Grok 4.6 uz high. Isti izveštaj navodi 38.000 za Grok 4.6 uz xhigh, pa i poređenje istog nivoa rezonovanja pokazuje više nego dvostruko više izlaznih tokena. Početna evaluacija Artificial Analysis-a
To je konkretan razlog da se cena tokena razlikuje od troška zadatka. Uz 81.000 izlaznih tokena i osnovnu cenu od 6 dolara za milion, ilustrativni trošak izlaza iznosi 0,486 dolara. Za 38.000 tokena iznosio bi 0,228 dolara. Ovi proračuni namerno ne obuhvataju ulazne tokene, keširanje, troškove alata, višu cenu za duži kontekst ni neuspele pokušaje. To je aritmetika zasnovana na prijavljenom broju tokena, a ne izmerena ukupna cena rada.
Veći broj izlaznih tokena ne znači automatski rasipanje. Model može da uloži dodatni napor u proveru odgovora i spreči grešku zbog koje bi čovek morao da interveniše. Može i duže da istrajava u pogrešnom pristupu. Sam broj tokena ne može da razlikuje korisnu upornost od skupog ponavljanja.
Berman se pred kraj snimka vraća na ovaj problem i pominje veću potrošnju tokena koju je zabeležio Artificial Analysis. Video, 15:43
Koristan rezultat je prihvaćen isporučeni posao. Izmena koda koja prolazi odgovarajuće testove i proveru, tabela čije se formule slažu ili izveštaj čije tvrdnje imaju potkrepljujuće dokaze vrede drugačije od odgovora koji samo brzo stigne.
Rezultati testova pokazuju sposoban, ali neujednačen model
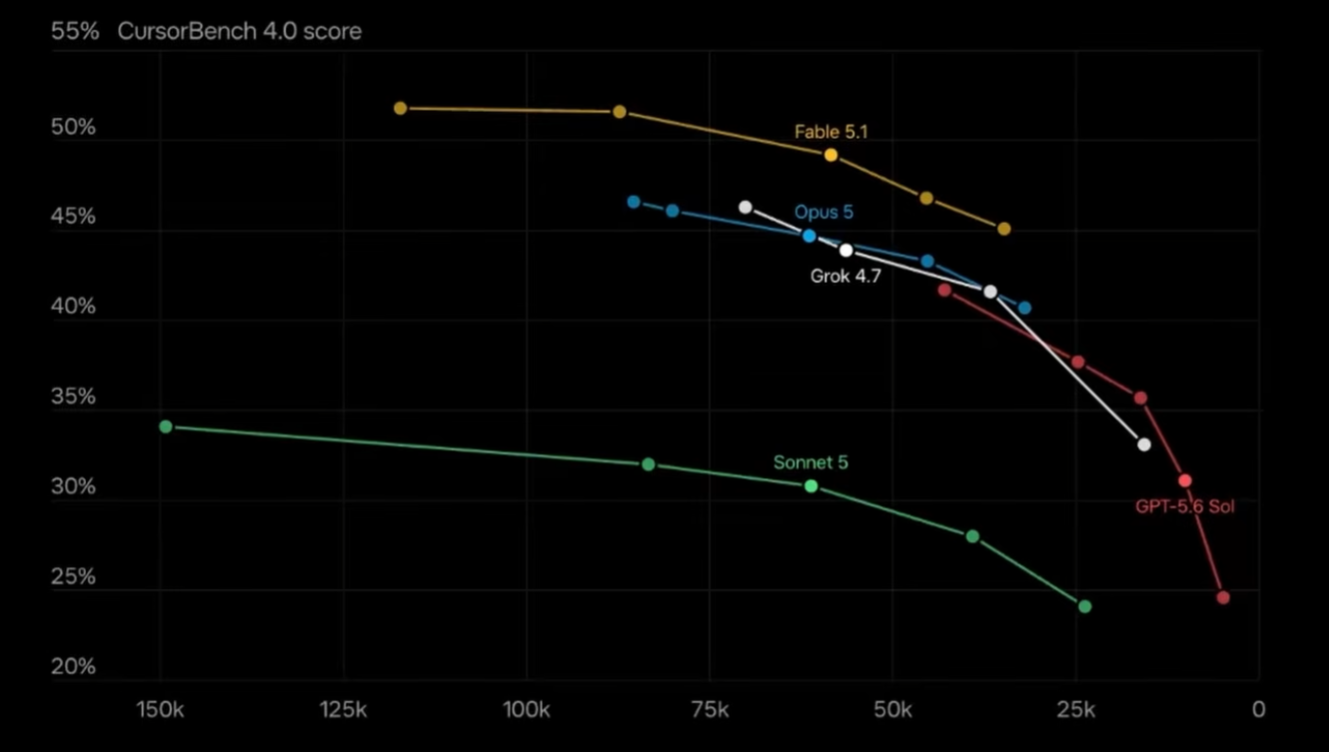
Tabela uz predstavljanje daje Groku 4.7 na xhigh nivou 46,3% na CursorBench 4.0, ispod Fable 5.1 na max nivou sa 51,8%. Fable je ispred i u poređenju na Terminal-Benchu. Tabela rezultata dobavljača
Prateći grafikon prikazuje rezultat na testu u odnosu na broj izlaznih tokena, koji opada udesno. Linije porede različita podešavanja rezonovanja. Originalni interaktivni grafikon: izaberite „Tokens“. Otvori grafikon u punoj veličini.
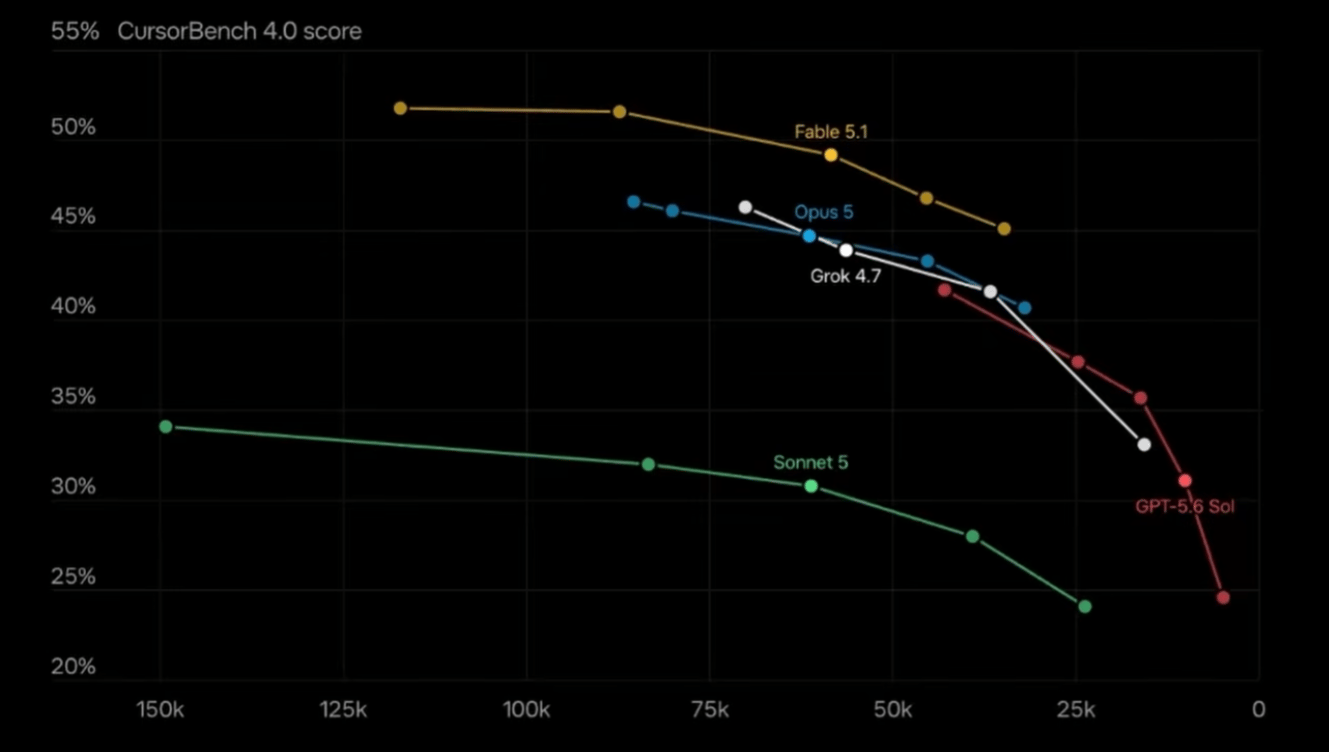
Kretanje nagore znači viši rezultat; kretanje udesno znači manje generisanih tokena u ovoj proceni. To ne znači nižu ukupnu cenu: i dalje su bitni tarife za tokene, njihova ulazna potrošnja i ostatak agentskog sistema. Ovo je i drugačiji test od podataka o tokenima koje je prethodno objavio Artificial Analysis. Spajanje njihovih rezultata prikrilo bi razlike u zadacima i metodologiji, zbog kojih je svaki nalaz moguće tumačiti.
To je dovoljno da odbacimo opštu tvrdnju da Grok 4.7 prednjači u svakoj vrsti programerskog rada. Dovoljno je i da opravda bliže ispitivanje pojedinih zadataka. Veličina napretka na jednoj proceni ne određuje kako će se model snaći u nepoznatom repozitorijumu, nepotpunom opisu greške ili neobičnom okruženju alata.
Artificial Analysis nudi korisno nezavisno poređenje. Njegov izveštaj daje Groku 4.7 sa Grok Buildom rezultat 56 na indeksu Coding Agent, naspram 47 za Grok 4.6 sa istim agentom. Izričito razlikuje ove rezultate u izvornom agentu od standardizovanog podešavanja Indeksa inteligencije. Nezavisna procena i napomene o metodologiji
Važno je i okruženje agenta. Ono obezbeđuje alate, upravlja kontekstom i određuje kako se izvršavaju zahtevi modela. Promena okruženja može promeniti rezultat čak i kada naziv modela ostane isti. Spajanje rezultata terminalskog testa iz jednog okruženja sa rezultatima softverskog inženjerstva iz drugog može proizvesti uverljivu tabelu koja ne opisuje nijedan sistem koji je iko zaista testirao.
Berman skreće pažnju na to da GPT-6 Astra nije uvršten u jednu tabelu za predstavljanje, pa ga dodaje pomoću rekonstrukcije generisane veštačkom inteligencijom. To je koristan povod da se ispita poređenje, ali rekonstrukcija nije nezavisan izvor rezultata. Ne preuzimamo njene dodatne brojke bez provere osnovne procene. Video, 6:03
Treba imati u vidu i poslovnu povezanost. Cursorovo saopštenje od 14. avgusta navodi da ga je preuzeo SpaceX. Test objavljen unutar te grupe proizvoda i dalje može biti koristan dokaz, ali nije nepristrasna procena konkurentskog dobavljača. Cursorovo saopštenje o preuzimanju
Kancelarijski posao možda krije zanimljiviju priliku
Nezavisna procena navodi 1.657 Elo poena za Grok 4.7 na xhigh nivou u testu AA-Briefcase, 111 više nego za Grok 4.6 na visokom nivou napora. Veći deo napretka pripisuje kvalitetu analize, dok je rezultat za kvalitet prezentacije neznatno niži nego kod prethodnog modela. Rezultati Artificial Analysisa za stručni rad
Ova razlika je korisna svima koji naručuju izveštaje, tabele ili prezentacije. Odgovor može sadržati bolju analizu, a ipak zahtevati uređivanje ili redizajn. Isto tako, lepo oblikovana prezentacija može prikriti površno rezonovanje. Procena samo na osnovu spoljašnjeg utiska može nagraditi pogrešno poboljšanje.
Operativni tim mogao bi da testira model na redovnom izveštaju o rezultatima. Koristan ogled proverio bi da li koristi odgovarajući period, usklađuje brojke sa izvornim podacima i razlikuje zabeleženu promenu od predloženog objašnjenja. Osoba koja proverava izveštaj trebalo bi da zabeleži koliko je ispravki bilo potrebno, a ne samo da li je na prvi pogled delovao profesionalno.
Manjem preduzeću možda je manje važno da pobedi na najtežem testu, a više da analizu koju inače ne može da priušti pretvori u rutinski posao. To je moguć put ka široj primeni. Postaje stvarnost kada je rezultat dovoljno tačan, stigne na vreme i vlasniku ostavi manje posla nego da zadatak obavi ručno.
Nazive profesionalnih testova ne treba mešati sa stručnim kvalifikacijama. Rezultat na testu pravnog rada ili kliničkog rezonovanja opisuje učinak na toj proceni. Ne dokazuje da model može samostalno da rešava pravne slučajeve klijenata ili donosi odluke o nezi pacijenata. Ovaj članak ne preporučuje upotrebu Groka za takve odluke.
I mere zaštite treba procenjivati u kontekstu
SpaceXAI tvrdi da Grok 4.7 ima novi skup zaštitnih mera i bolju otpornost na zaobilaženje bezbednosnih ograničenja. To je tvrdnja iz najave, a ne garancija da je svaka aplikacija koja koristi model bezbedna. Bezbednosni prikaz proizvođača
Za poslovnog agenta ostaju najmanje dva pitanja. Da li model primereno odgovara na zahteve koje dobija? I da li aplikacija ograničava ono što model zaista može da uradi?
Model može ispravno da razume zahtev za izmenu korisničkog zapisa, a da nema dozvolu da je izvrši. Može naići i na zlonamerna uputstva ugrađena u dokument koji treba da sažme. Kontrole pristupa i pravila za odobravanje moraju ostati deo sistema; bolje odbijanje zahteva ih ne zamenjuje.
Praktičan zaključak je da treba testirati čitav postupak. Uključite dozvoljene zahteve koji treba da uspeju, zabranjene radnje koje treba blokirati i nejasne slučajeve koji treba da sačekaju dodatno objašnjenje. Proizvod koji prečesto odbija bezazlen posao može biti neupotrebljiv; onaj koji izvršava nedozvoljene radnje može biti daleko gori. Nijedan problem ne obuhvata jedan naslovni rezultat.
Šta video ostavlja nerazjašnjenim
Bermanova obrada otvara nekoliko pitanja koja treba da ostanu otvorena. Njegovo objašnjenje veze između cena i dostupnih računarskih kapaciteta tumačenje je tržišta, a ne objavljen obračun troškova po jedinici. Predviđanja za društvene mreže koja pominje predstavljaju očekivanja, a ne dokaz ostvarenih rezultata. Završno poređenje u demonstraciji prati i njegovo priznanje da ne zna koja su podešavanja korišćena. Razgovor o cenama, 8:44, očekivanja, 11:51 i razgovor o demonstraciji, 15:20
Video govori i o modelima sa otvorenim težinama. Taj širi konkurentski trend ne treba mešati sa licencom za Grok 4.7: Artificial Analysis navodi da je ovo vlasnički model i da njegove težine nisu dostupne. Profil izdanja Groka 4.7
Ove razlike drže procenu usredsređenom. Proizvod može imati privlačnu cenu, a da javnost ne zna zašto je dobavljač izabrao baš tu cenu. Upečatljiv neuspeh na demonstraciji može ukazati na test koji vredi ponoviti, ali ne dokazuje da je model uopšteno loš. Dostupan model može biti koristan i bez ispunjavanja ranijeg obećanja osnivača.
Treba uzeti u obzir i granicu sponzorstva. Bermanov video sadrži reklamu za Zapier. Ona nije nezavisan dokaz o učinku Groka, a njene promotivne tvrdnje nisu preporuke BIG CHANGE-a.
Bolje merilo za kupovinu: trošak po prihvaćenom zadatku
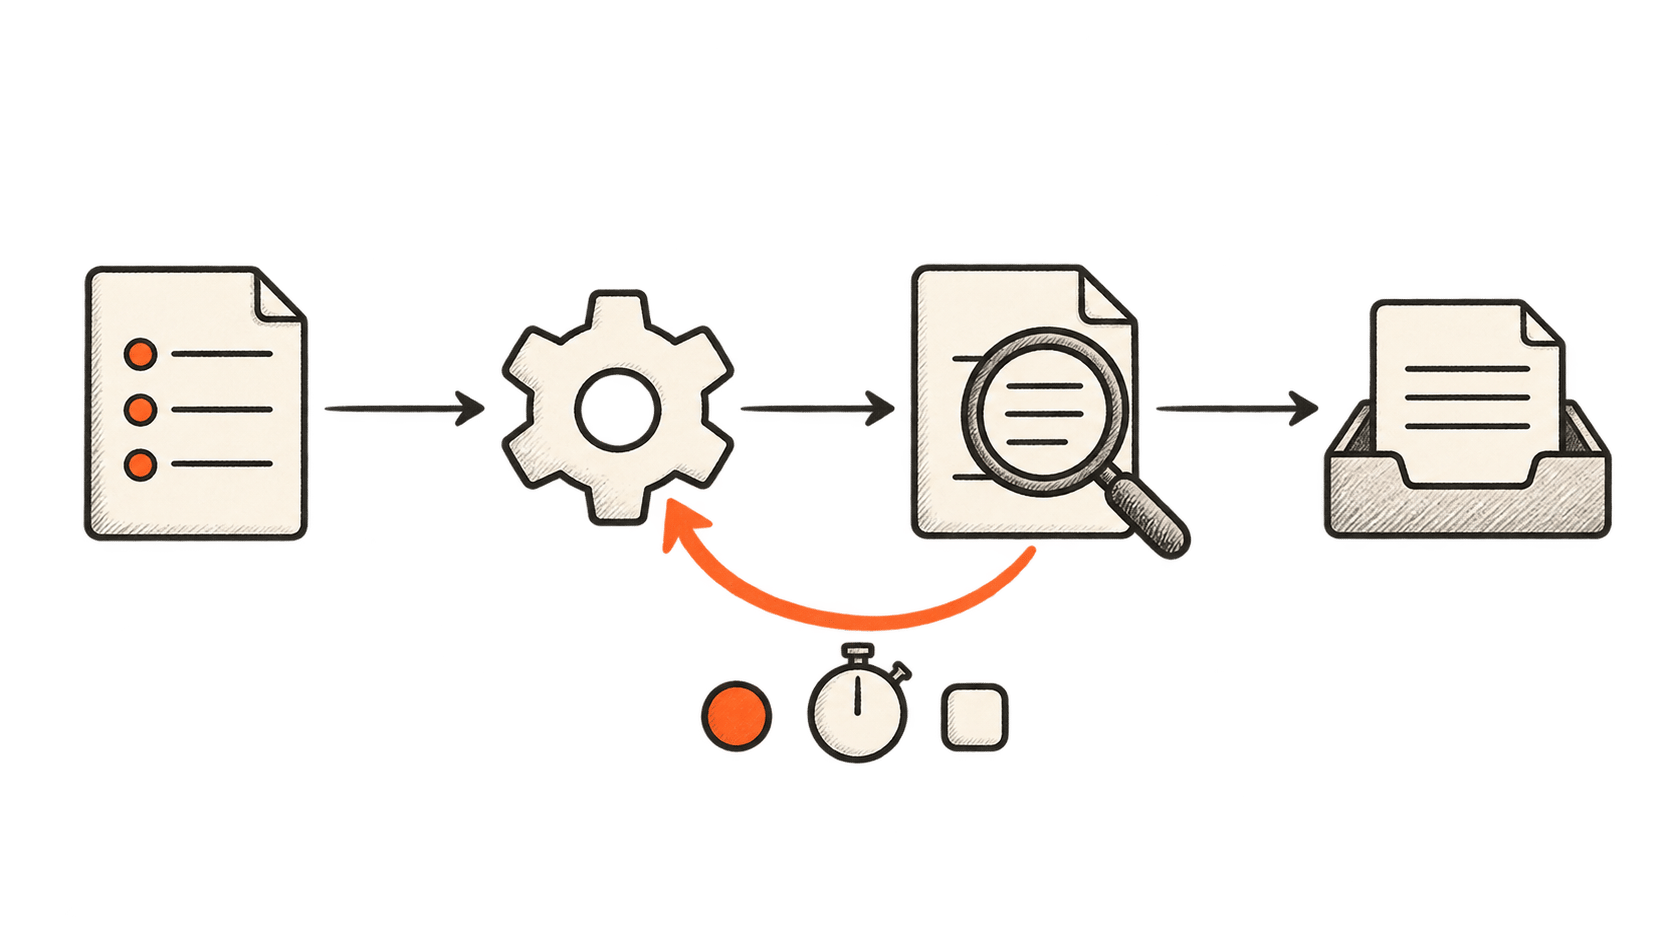
Tim koji razmatra Grok 4.7 trebalo bi da ga uporedi sa postojećim postupkom na malom, reprezentativnom skupu zadataka. Kriterijume prihvatanja treba utvrditi pre pregleda rezultata. Za programiranje to mogu biti relevantni testovi, čitljiva izmena i odsustvo nepovezanih promena. Za analizu to mogu biti tačni proračuni i dokazi za važne tvrdnje.
Zatim treba zabeležiti ceo trošak: potrošnju ulaznih i izlaznih tokena, alate, ponovljene pokušaje i vreme utrošeno na proveru ili ispravku rezultata. Uračunajte i neuspele pokušaje. Taj iznos podelite brojem isporučenih rezultata koji ispunjavaju kriterijume prihvatanja.
Ilustrativni primer pokazuje zašto je ova razlika važna. Pretpostavimo da jedno podešavanje košta 20 dolara za seriju i daje 80 prihvaćenih rezultata. Izmereni trošak iznosi 0,25 dolara po prihvaćenom rezultatu, bez ljudskog rada. Drugo košta 12 dolara, ali daje samo 30 prihvaćenih rezultata, pa je trošak 0,40 dolara po rezultatu. Jeftinija serija skuplji je izvor upotrebljivog rada. Ovo su hipotetičke brojke, a ne merenja za Grok.
U ogled treba uključiti i nivo napora rezonovanja. Visok nivo može opravdati cenu kod teškog zadatka, a malo doprineti rutinskom poslu. Ekonomičnije može biti da se na taj nivo prosleđuju samo slučajevi kojima je potreban, pod uslovom da se proceni i ta odluka o usmeravanju.
Standardi provere treba da budu isti za sve modele. Snižavanje kriterijuma za jeftiniji model stvara privid uštede prihvatanjem lošijeg rada. Podizanje kriterijuma samo za postojeći model proizvodi suprotnu pristrasnost. Cilj je pouzdan rezultat uz jasno evidentiranje posla koji ljudi i dalje moraju da obave.
Promena koju vredi pratiti
Grok 4.7 daje timovima još jednu mogućnost za testiranje. Odluka zahteva pregled celog zadatka: šta model proizvede, šta potroši i šta neko i dalje mora da popravi.
Šira posledica mogla bi biti selektivnija upotreba veštačke inteligencije u svakodnevnom radu. Tim može da izabere jedno podešavanje za rutinsku analizu, drugo za teško programiranje, a čoveka za slučajeve u kojima se prosuđivanje ili odgovornost ne mogu prepustiti drugome. Veća konkurencija pruža timu još jednu mogućnost za testiranje, ali ne određuje koja treba da pobedi.
Za BIG CHANGE je sledeća prekretnica merljiv obim završenog posla uz manji ukupan napor. Ako Grok 4.7 smanji trošak prihvaćenih rezultata, korisna automatizacija može postati dostupna većem broju organizacija. Ako dodatno rezonovanje samo premesti trošak sa cene tokena na njihovu potrošnju, istaknuta cena kupcima neće mnogo reći. Odgovor će dati završeni zadaci, uključujući i one koji su prvo podbacili.