Grok 4.7 21 सप्टेंबर 2026 रोजी उपलब्ध झाले. कोड लिहिण्यासाठी किंवा व्यावसायिक माहितीचे विश्लेषण करण्यासाठी AI खरेदी करणाऱ्या संघांसमोर त्याच्या प्रकाशनाने एक व्यावहारिक प्रश्न ठेवला आहे: अधिक सक्षम मॉडेलमुळे पूर्ण झालेल्या कामाचा खर्च कमी होतो का? उत्तर केवळ जाहीर केलेल्या टोकन दरांवर अवलंबून नाही. अधिकृत प्रकाशन नोंदी
या संमिश्र चित्रावर Matthew Bermanचा 22 सप्टेंबरचा व्हिडिओ भाष्य करतो: Grok 4.7बद्दल मला काय वाटते हे कळत नाही…. तो वापरलेल्या तुलनांवर प्रश्न उपस्थित करतो आणि टोकनच्या किमतीपेक्षा पूर्ण झालेल्या कामामागील खर्च महत्त्वाचा असल्याचे मांडतो. त्याने मॉडेलची सखोल चाचणी केलेली नाही, असेही तो सांगतो. त्याचा व्हिडिओ हा उपलब्ध पुराव्याचा प्राथमिक आढावा आहे; सर्वसमावेशक प्रत्यक्ष मूल्यमापन नव्हे. Bermanची प्रस्तावना, 0:00
उपयुक्त मॉडेलने प्रत्येक बेंचमार्क जिंकला नाही तरी व्यवसाय कोणते काम स्वयंचलित करू शकतात हे बदलू शकते, म्हणून या घोषणेकडे लक्ष देणे योग्य आहे. मात्र एकूण खर्चाचे समर्थन करण्यासाठी त्याने पुरेसे काम अचूकपणे पूर्ण केले पाहिजे. स्वतंत्र चाचण्या हा ताण आधीच दाखवतात: Grok 4.7चे चांगले निकाल अधिक मोठ्या प्रमाणात मजकूर तयार करून मिळू शकतात.
विकासक, लहान व्यवसाय आणि एजंट तयार करणाऱ्या संघांसाठी निर्णय व्यावहारिक आहे. हे मॉडेल कोणती कामे स्वीकारार्ह गुणवत्तेने पूर्ण करू शकते? त्यासाठी किती प्रयत्न लागतात? आणि मॉडेलने काम झाले असे म्हटल्यावर व्यक्तीला किती काम बाकी राहते?
आम्ही Bermanच्या सुमारे 17 मिनिटांच्या व्हिडिओची संपूर्ण शीर्षके तपासली आणि प्रकाशनाची माहिती, उत्पादन दस्तऐवजीकरण व Artificial Analysisचे मूल्यमापन पडताळले. खालील विश्लेषणात BIG CHANGEचा स्वतःचा बेंचमार्क किंवा Grokची प्रत्यक्ष चाचणी केल्याचा दावा नाही.
काय सुरू झाले आणि ते कुठे उपलब्ध आहे
मानक मॉडेल xAI APIवर grok-4.7, तसेच Cursor आणि Grok Buildमध्ये उपलब्ध आहे. API मजकूर व प्रतिमा स्वीकारतो आणि मजकूर तयार करतो. दस्तऐवजीकरणानुसार त्याची संदर्भ-क्षमता 500,000 टोकन आहे; कमी, मध्यम, उच्च आणि xhigh अशा चार विचार-स्तरांची सोय आहे. डीफॉल्ट स्तर उच्च आहे. अधिकृत प्रकाशन नोंदी
मोठे बेस मॉडेल आणि अधिक कठीण कामांवर दीर्घकाळ केलेले रीइन्फोर्समेंट लर्निंग यांमुळे सुधारणा झाली, असे SpaceXAI सांगते. हे विकासकाने दिलेले स्पष्टीकरण आहे. प्रकाशनाचा तांत्रिक आढावा
Grok 4.7 Fast ही आवृत्तीही आहे. दस्तऐवजीकरणानुसार तीच मॉडेल आवृत्ती जलद पायाभूत सुविधांवर चालते आणि मानक टोकन दरांच्या दुप्पट दराने बिल आकारते. ती Cursor आणि Grok Buildद्वारे दिली जाते, Grok Buildच्या मोफत स्तरात समाविष्ट नाही आणि सार्वजनिक xAI APIवर उपलब्ध नाही. Grok 4.7चे उत्पादन दस्तऐवजीकरण
स्क्रीनशॉट, प्रात्यक्षिके आणि बिलांची तुलना करताना हे फरक महत्त्वाचे ठरतात. मॉडेलची आवृत्ती, विचार-स्तर आणि सेवा-स्तर हे स्वतंत्र पर्याय आहेत. xhighवर चालणारे Fastचे प्रात्यक्षिक मानक वेगाच्या, मध्यम विचार-स्तराच्या API कॉलचा अनुभव किंवा खर्च दाखवत नाही.
इतर मॉडेल्सशी केलेली प्रकाशन-पानावरील तुलना अपग्रेडच्या तुलनेपासून वेगळी ठेवली पाहिजे. मानक Grok 4.7ची किंमत आणि वेग Grok 4.6इतकाच आहे, असे SpaceXAI सांगते. 4.6वरून अपग्रेड केल्याने ग्राहकाचे बिल आपोआप निम्मे होते, असे त्यात म्हटलेले नाही.
किंमतपत्रकात दीर्घ संदर्भासाठी वेगळी मर्यादा आहे
प्रकाशित मानक API दर असे आहेत:
- दोन लाखांपर्यंत प्रॉम्प्ट टोकन: प्रति दशलक्ष टोकनमागे इनपुटसाठी $2, कॅश केलेल्या इनपुटसाठी $0.50 आणि आउटपुटसाठी $6.
- दोन लाखांपेक्षा जास्त प्रॉम्प्ट टोकन: प्रति दशलक्ष टोकनमागे इनपुटसाठी $4, कॅश केलेल्या इनपुटसाठी $1 आणि आउटपुटसाठी $12.
हे टोकनचे दर आहेत; एजंटने एखादे काम पूर्ण करण्यासाठी लागणारी सर्वसमावेशक किंमत नाही. दोन लाखांहून अधिक टोकन असलेल्या विनंत्यांसाठी जास्त दर लागू होतात, असे मॉडेल पान सूचित करते आणि प्रकाशन नोंदी उच्च दर स्पष्ट करतात. किंमत व उपलब्धता 22 सप्टेंबर रोजी तपासली. मॉडेलची किंमत आणि प्रकाशन नोंदी
म्हणून 500,000 टोकनची संदर्भ-क्षमता असली, तरी त्या मर्यादेतील प्रत्येक विनंतीला सर्वात कमी दर लागू होतो असा अर्थ नाही. तसेच मोठ्या संदर्भ-क्षमतेवरून मोठ्या फाइल-संग्रहातील प्रत्येक संबंधित तपशील मॉडेल सातत्याने शोधेल याची खात्री मिळत नाही.
Cursorमधील उत्पादन-स्तराचा आणखी एक फरक असा: त्याच्या दस्तऐवजीकरणात मानक संदर्भ-क्षमता 256,000 टोकन आणि कमाल क्षमता 500,000 टोकन दिली आहे. संपादकात उपलब्ध क्षमता API तपशीलापेक्षा वेगळी असू शकते किंवा निवडलेल्या मोडवर अवलंबून असू शकते. Cursorचे Grok 4.7विषयक दस्तऐवजीकरण
दीर्घ अहवालांवर काम करणाऱ्या संघांसाठी, सर्व सामग्री पाठवल्याने खर्चाचे समर्थन होईल इतका चांगला निकाल मिळतो का, हा तातडीचा प्रश्न आहे. संबंधित विभाग शोधून काढणे स्वस्त आणि तपासायला सोपे असू शकते. कधी पूर्ण दस्तऐवज आवश्यक असतो; तर कधी प्रॉम्प्ट बनवण्याचा तो फक्त सोपा मार्ग असतो. या परिस्थितींचे अंदाजपत्रक एकसारखे धरू नये.
चांगल्या कामगिरीसाठी अधिक टोकन लागू शकतात
Artificial Analysisच्या 21 सप्टेंबरच्या मूल्यमापनात xhighवरच्या Grok 4.7ला Intelligence Indexमध्ये 46 गुण मिळतात—Grok 4.6पेक्षा दोन अधिक. प्रत्येक कामासाठी सुमारे 81,000 आउटपुट टोकन लागल्याचे त्यात आहे; उच्च विचार-स्तरावरील Grok 4.6साठी हा आकडा 36,000 आहे. त्याच अहवालात xhighवरील Grok 4.6साठी 38,000 टोकन दिले आहेत. त्यामुळे समान विचार-स्तराची तुलना केली तरी आउटपुट टोकन दुपटीहून अधिक आहेत. Artificial Analysisचे प्रकाशन-मूल्यमापन
टोकनची किंमत आणि कामाचा खर्च वेगळा ठेवण्याचे हे ठोस कारण आहे. मूलभूत सहा डॉलर प्रति-दशलक्ष दराने 81,000 आउटपुट टोकन वापरल्यास उदाहरणार्थ आउटपुट शुल्क $0.486 येते. 38,000 टोकनसाठी ते $0.228 होईल. या गणनेत इनपुट, कॅशचा परिणाम, टूल शुल्क, उच्च संदर्भ दर आणि अयशस्वी प्रयत्न मुद्दाम वगळले आहेत. हे नोंदवलेल्या टोकन संख्यांवरचे अंकगणित आहे; पूर्ण झालेल्या कामाची मोजलेली सर्वसमावेशक किंमत नाही.
अधिक आउटपुट म्हणजे आपोआप अपव्यय नव्हे. मॉडेल उत्तर तपासण्यासाठी अधिक मेहनत घेऊन अन्यथा व्यक्तीला हस्तक्षेप करावा लागेल अशी चूक टाळू शकते. ते चुकीच्या मार्गावर अधिक काळ घालवू शकते. केवळ टोकनसंख्येवरून उपयुक्त चिकाटी आणि खर्चिक पुनरावृत्ती यांत फरक कळत नाही.
व्हिडिओच्या शेवटी Berman पुन्हा या प्रश्नाकडे येतो आणि Artificial Analysisने नोंदवलेल्या अधिक टोकन वापराचा उल्लेख करतो. व्हिडिओ, 15:43
उपयोगी निकाल म्हणजे स्वीकारार्ह ठरलेले काम. योग्य चाचण्या व पुनरावलोकन पार करणारा कोडबदल, सूत्रे जुळणारी स्प्रेडशीट किंवा पुराव्याशी जोडलेले दावे असलेला अहवाल—यांचे मूल्य केवळ पटकन आलेल्या उत्तरापेक्षा वेगळे आहे.
बेंचमार्क सक्षम, पण असमान मॉडेल दाखवतात
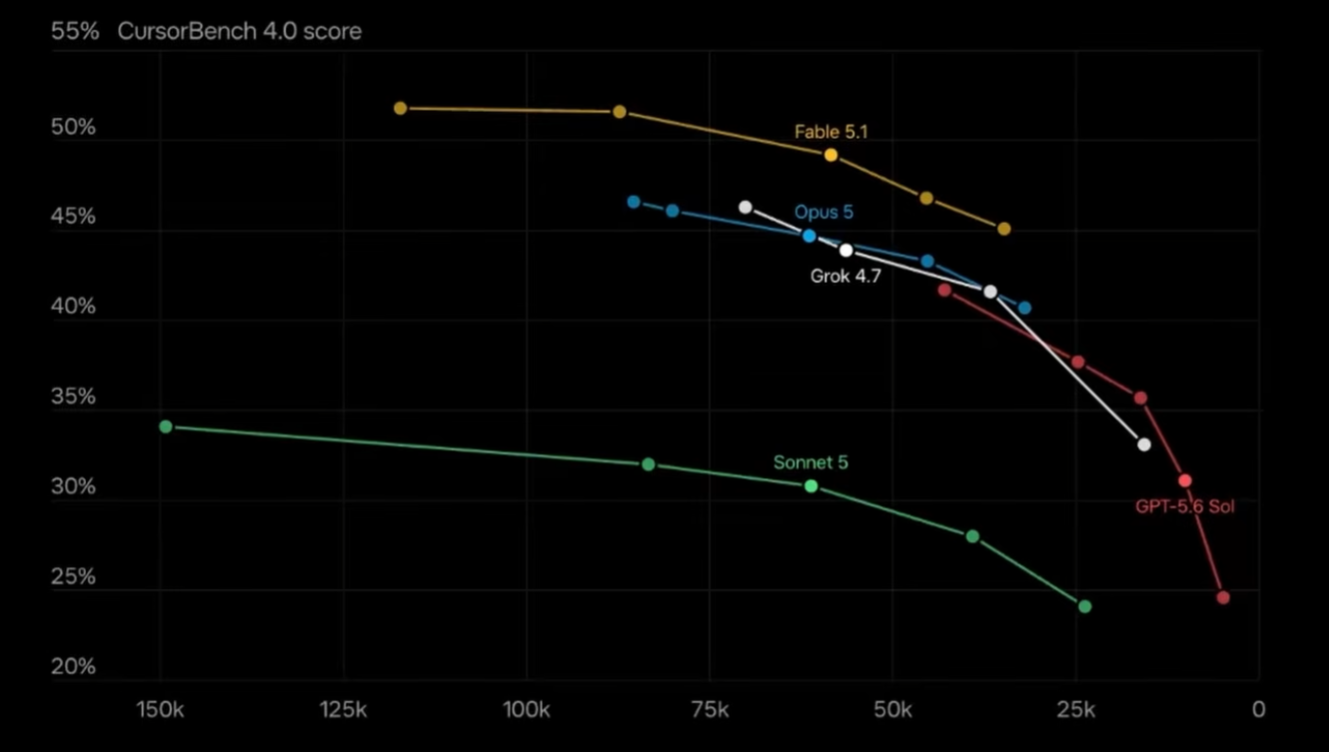
प्रकाशनातील तक्त्यानुसार CursorBench 4.0मध्ये Grok 4.7 xhighला 46.3% गुण मिळतात, तर Fable 5.1 maxचे 51.8% आहेत. Terminal-Benchच्या तुलनेतही Fable आघाडीवर आहे. विक्रेत्याचा बेंचमार्क तक्ता
सोबतच्या आलेखात बेंचमार्क गुण आणि आउटपुट टोकन यांची तुलना आहे; उजवीकडे जाताना टोकन कमी होतात. त्यातील रेषा वेगवेगळ्या विचार-स्तरांची तुलना करतात. मूळ परस्परसंवादी आलेख: Tokens निवडा. पूर्ण आकाराचा आलेख उघडा.
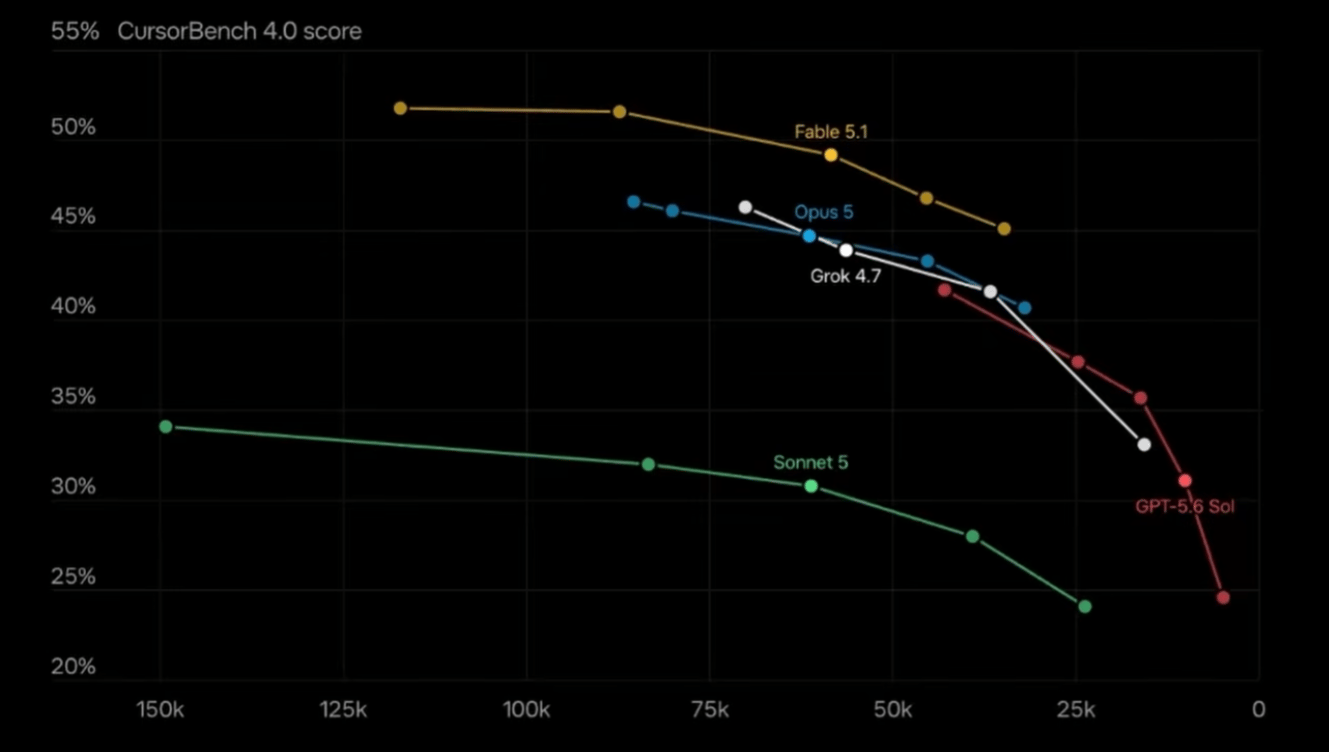
वर जाणे म्हणजे अधिक गुण; उजवीकडे जाणे म्हणजे या मूल्यमापनात कमी मजकूर तयार होणे. याचा अर्थ सर्वसमावेशक किंमत कमी असा नाही: टोकन दर, इनपुट वापर आणि भोवतालचा एजंटही महत्त्वाचा आहे. Artificial Analysisच्या वरील टोकन आकड्यांपेक्षा ही वेगळी चाचणी आहे. या दोन्हींचे आकडे एकत्र केल्यास प्रत्येक निकाल समजण्यास आवश्यक असलेले काम आणि पद्धतीतील फरक पुसले जातील.
यावरून Grok 4.7 प्रत्येक प्रकारच्या कोडिंग कामात आघाडीवर आहे असा सरसकट दावा फेटाळण्यास पुरेशी माहिती मिळते. विशिष्ट कामांसाठी अधिक बारकाईने तपासणी करण्याचे समर्थनही मिळते. एका मूल्यमापनातील सुधारणा किती मोठी आहे यावरून अपरिचित कोड-संग्रह, अपूर्ण बग अहवाल किंवा वेगळ्या टूल वातावरणात मॉडेल कसे काम करेल हे ठरत नाही.
Artificial Analysis आणखी एक उपयुक्त स्वतंत्र फरक दाखवते. Grok Buildसह Grok 4.7ला Coding Agent Indexमध्ये 56 गुण मिळतात; त्याच एजंटसह Grok 4.6ला 47 होते. हे नेटिव्ह एजंटचे निकाल त्यांच्या प्रमाणित Intelligence Index मांडणीपासून स्पष्टपणे वेगळे असल्याचे अहवाल सांगतो. स्वतंत्र मूल्यमापन आणि पद्धतीविषयक नोंदी
भोवतालचा एजंटही महत्त्वाचा असतो. तो टूल पुरवतो, संदर्भ सांभाळतो आणि मॉडेलच्या विनंत्या कशा राबवायच्या ते ठरवतो. मॉडेलचे नाव तेच असले तरी हे वातावरण बदलल्यास निकाल बदलू शकतात. एका मांडणीतील टर्मिनल गुण आणि दुसऱ्या मांडणीतील सॉफ्टवेअर अभियांत्रिकी गुण एकत्र केल्यास असा प्रभावी तक्ता तयार होऊ शकतो, जो प्रत्यक्षात कोणीही तपासलेल्या प्रणालीचे वर्णन करत नाही.
एका प्रकाशन तक्त्यात GPT-6 Astra नसल्याकडे Berman लक्ष वेधतो आणि AIने तयार केलेली पुनर्रचना करून तो समाविष्ट करतो. तुलना तपासण्याची सूचना म्हणून ते उपयुक्त आहे; मात्र ही पुनर्रचना स्वतंत्र बेंचमार्कचा स्रोत नाही. मूळ मूल्यमापन तपासल्याशिवाय त्यातील भर घातलेले आकडे आम्ही स्वीकारत नाही. व्हिडिओ, 6:03
लक्षात ठेवण्यासारखा व्यावसायिक संबंधही आहे. Cursorच्या 14 ऑगस्टच्या कंपनी घोषणेनुसार SpaceXने Cursorचे अधिग्रहण केले. त्या कंपनीसमूहात प्रसिद्ध केलेला बेंचमार्क उपयुक्त पुरावा असू शकतो, पण प्रतिस्पर्धी पुरवठादाराचे निःपक्ष मूल्यमापन नव्हे. Cursorची अधिग्रहण घोषणा
कार्यालयीन कामात कदाचित अधिक रंजक संधी आहे
स्वतंत्र मूल्यमापनात xhighवरील Grok 4.7ला AA-Briefcaseमध्ये 1,657 Elo गुण मिळतात—उच्च विचार-स्तरावरील Grok 4.6पेक्षा 111 अधिक. विश्लेषणाच्या गुणवत्तेमुळे सुधारणा झाल्याचे त्यात नमूद आहे; सादरीकरणाची गुणवत्ता मात्र आधीच्या मॉडेलच्या निकालापेक्षा किंचित कमी आहे. Artificial Analysisचे ज्ञानाधारित कामाचे निकाल
अहवाल, स्प्रेडशीट किंवा सादरीकरणे तयार करून घेणाऱ्यांसाठी हा फरक उपयुक्त आहे. उत्तरात अधिक चांगले विश्लेषण असले तरी संपादन किंवा नव्याने मांडणी करावी लागू शकते. उलट, आकर्षक स्लाइडमागे वरवरचा तर्क लपलेला असू शकतो. फक्त दिसणाऱ्या अंतिम रूपाचे मूल्यमापन केल्यास चुकीच्या सुधारणेला बक्षीस मिळण्याचा धोका आहे.
कामगिरीचा आवर्ती अहवाल तयार करण्यासाठी संचालन संघ या मॉडेलची चाचणी घेऊ शकतो. योग्य कालावधी वापरला आहे का, स्रोत आकड्यांशी जुळवणी केली आहे का आणि दिसलेला बदल व त्याचे सुचवलेले स्पष्टीकरण वेगळे ठेवले आहे का हे तपासणे उपयुक्त ठरेल. पहिल्या नजरेत अहवाल व्यावसायिक दिसतो का एवढेच न पाहता, परीक्षण करणाऱ्याने किती दुरुस्ती करावी लागली याची नोंद ठेवावी.
सर्वात कठीण बेंचमार्क जिंकण्यापेक्षा, अन्यथा परवडले नसते असे विश्लेषण नियमित करता येणे लहान व्यवसायाला अधिक महत्त्वाचे वाटू शकते. व्यापक स्वीकारासाठी हा एक संभाव्य मार्ग आहे. निकाल पुरेसा अचूक असेल, वेळेत मिळेल आणि तेच काम हाताने करण्यापेक्षा मालकाचे कमी श्रम घेईल तेव्हाच ती शक्यता प्रत्यक्षात येईल.
व्यावसायिक बेंचमार्कची नावे ही व्यावसायिक पात्रतेची खात्री समजू नयेत. कायदेविषयक काम किंवा वैद्यकीय तर्काच्या निकालातून त्या विशिष्ट मूल्यमापनातील कामगिरी दिसते. ग्राहकाच्या कायदेशीर प्रकरणाची किंवा रुग्णसेवेच्या निर्णयाची स्वतंत्रपणे जबाबदारी मॉडेल घेऊ शकते हे त्यावरून सिद्ध होत नाही. अशा निर्णयांसाठी Grok वापरण्याची शिफारस हा लेख करत नाही.
सुरक्षाविषयक दाव्यांचेही संदर्भासह मूल्यमापन हवे
नवी संरक्षण-व्यवस्था आणि जेलब्रेकविरोधातील अधिक भक्कम प्रतिकारशक्ती Grok 4.7मध्ये आहे, असे SpaceXAI सांगते. हा प्रकाशनावेळचा दावा आहे; मॉडेल वापरणारे प्रत्येक ॲप सुरक्षित असेल याची हमी नाही. विकसकाचे सुरक्षा-विषयक निवेदन
व्यावसायिक एजंटसाठी किमान दोन प्रश्न उरतात. त्याला मिळालेल्या विनंत्यांना मॉडेल योग्य प्रतिसाद देते का? आणि मॉडेल प्रत्यक्षात काय करू शकते यावर ॲप मर्यादा घालते का?
ग्राहकाची नोंद बदलण्याची सूचना मॉडेलला योग्यरीत्या समजू शकते, पण तो बदल करण्याची परवानगी त्याच्याकडे नसेल. सारांश तयार करण्यासाठी दिलेल्या दस्तऐवजात एम्बेड केलेल्या दुर्भावनापूर्ण सूचनाही त्याला दिसू शकतात. प्रवेश-नियंत्रणे आणि मंजुरीचे नियम भोवतालच्या प्रणालीचा भाग राहिलेच पाहिजेत; सुधारित नकार-वर्तन त्यांची जागा घेत नाही.
व्यावहारिक निष्कर्ष म्हणजे संपूर्ण कार्यप्रवाह तपासणे. यशस्वी व्हायला हव्यात अशा वैध विनंत्या, रोखल्या पाहिजेत अशा निषिद्ध कृती आणि स्पष्टीकरण मिळेपर्यंत थांबायला हव्यात अशा संदिग्ध बाबी समाविष्ट करा. निरुपद्रवी कामाला वारंवार नकार देणारे उत्पादन वापरण्यायोग्य राहत नाही; अनधिकृत कृती करणारे उत्पादन त्याहून गंभीर ठरू शकते. एका मथळ्यातील गुणांकात यांपैकी कोणताही प्रश्न सामावत नाही.
व्हिडिओत अनुत्तरित राहिलेले प्रश्न
Bermanच्या व्हिडिओत काही प्रश्न उपस्थित होतात; ते प्रश्नच राहिले पाहिजेत. उपलब्ध संगणकीय क्षमतेशी किंमत जोडणारे त्याचे स्पष्टीकरण हे बाजाराविषयीचे आकलन आहे; जाहीर केलेले प्रति-युनिट खर्चाचे हिशेब नाहीत. त्याने चर्चिलेली समाजमाध्यमांवरील भाकिते ही अपेक्षा आहेत, प्रत्यक्ष कामगिरीचा पुरावा नव्हे. समारोपातील प्रात्यक्षिकांच्या तुलनेत कोणती सेटिंग वापरली होती हे माहित नसल्याचे तो स्वतः मान्य करतो. किंमतीची चर्चा, 8:44, अपेक्षा, 11:51 आणि प्रात्यक्षिकावरील चर्चा, 15:20
व्हिडिओत ओपन-वेट मॉडेल्सचीही चर्चा आहे. या व्यापक स्पर्धेला Grok 4.7च्या परवानापद्धतीशी गोंधळू नये: Artificial Analysisनुसार ही आवृत्ती मालकी हक्काधीन असून तिचे वेट्स उपलब्ध नाहीत. Grok 4.7ची प्रकाशन-रूपरेषा
हे फरक लक्षात घेतल्यास मूल्यमापन मुद्द्यावर राहते. पुरवठादाराने किंमत का ठरवली हे जनतेला माहीत नसतानाही उत्पादन आकर्षक दराने मिळू शकते. धक्कादायक अपयशी प्रात्यक्षिक पुन्हा करून पाहण्यासारखी चाचणी सुचवू शकते; पण त्यावरून मॉडेल सर्वसाधारणपणे निकृष्ट ठरते असे नाही. संस्थापकाच्या पूर्वीच्या अंदाजाशी न जुळताही उपलब्ध मॉडेल उपयोगी असू शकते.
प्रायोजकत्वाबाबतही स्पष्ट सीमारेषा आहे. Bermanच्या व्हिडिओत Zapierची जाहिरात आहे. ती Grokच्या कामगिरीचा स्वतंत्र पुरावा नाही आणि जाहिरातीतील दावे BIG CHANGEच्या शिफारसी नाहीत.
खरेदीसाठी अधिक चांगला निकष: स्वीकारलेल्या कामामागील खर्च
Grok 4.7चा विचार करणाऱ्या संघाने प्रतिनिधिक कामांच्या छोट्या संचावर सध्याच्या प्रक्रियेशी तुलना करावी. निकाल पाहण्यापूर्वीच स्वीकाराचे निकष ठरवा. कोडिंगसाठी संबंधित चाचण्या उत्तीर्ण होणे, वाचनीय बदल-संच आणि असंबंधित बदल नसणे हे निकष असू शकतात. विश्लेषणासाठी अचूक गणना आणि महत्त्वाच्या दाव्यांना पुरावा असणे आवश्यक ठरू शकते.
त्यानंतर संपूर्ण खर्च नोंदवा: इनपुट आणि आउटपुटचा वापर, टूल्स, पुन्हा केलेले प्रयत्न आणि निकाल तपासण्यासाठी किंवा दुरुस्त करण्यासाठी लागलेला वेळ. अयशस्वी प्रयत्नही मोजा. स्वीकार निकष पूर्ण करणाऱ्या कामांच्या संख्येने तो खर्च भागा.
उदाहरणातून हा फरक का महत्त्वाचा आहे ते दिसते. एका संरचनेला कामांच्या संचासाठी $20 खर्च येतो आणि 80 स्वीकारार्ह निकाल मिळतात, असे समजा. मानवी श्रम वगळता प्रत्येक स्वीकारार्ह निकालामागील मोजलेला खर्च $0.25 होतो. दुसरीकडे $12 खर्चून फक्त 30 स्वीकारार्ह निकाल मिळाले तर प्रत्येकामागे $0.40 पडतात. स्वस्त बॅचमधून वापरण्यायोग्य काम मिळवणे अधिक महाग पडते. हे काल्पनिक आकडे आहेत; Grokच्या मोजमापावर आधारित नाहीत.
विचार-स्तरही या चाचणीचा भाग असावा. कठीण कामात उच्च विचार-स्तराचा खर्च सार्थ ठरू शकतो, पण नेहमीच्या कामात त्याचा फारसा फायदा नसेल. xhighवर प्रत्येक विनंती चालवण्याऐवजी गरज असलेल्या प्रकरणांनाच उच्च स्तरावर पाठवणे अधिक किफायतशीर ठरू शकते—मात्र कोणत्या प्रकरणांना पाठवायचे हा निर्णयही तपासला पाहिजे.
सर्व मॉडेल्ससाठी परीक्षणाचे निकष समान ठेवा. स्वस्त मॉडेलसाठी निकष सैल केल्यास निकृष्ट काम स्वीकारून बचत झाल्याचा भास निर्माण होतो. विद्यमान मॉडेलसाठीच निकष अधिक कठोर केल्यास उलटा पक्षपात होतो. विश्वासार्ह निकाल खरेदी करणे हे उद्दिष्ट आहे; त्यानंतर लोकांना अजून काय करावे लागते याचाही स्पष्ट हिशेब हवा.
लक्ष ठेवण्यासारखा बदल
Grok 4.7मुळे संघांना तपासण्यासाठी आणखी एक पर्याय मिळतो. तो निवडताना संपूर्ण कामाचा विचार हवा: मॉडेल काय तयार करते, किती साधने वापरते आणि व्यक्तीला काय दुरुस्त करावे लागते.
व्यापक परिणाम असा होऊ शकतो की रोजच्या कामात AIचा अधिक निवडक वापर होईल. नेहमीच्या विश्लेषणासाठी संघ एक संरचना, कठीण कोडिंगसाठी दुसरी आणि जिथे निर्णयक्षमता किंवा जबाबदारी सोपवता येत नाही तिथे व्यक्तीची मदत निवडू शकतो. वाढती स्पर्धा संघाला तपासण्यासाठी आणखी पर्याय देते; कोणता पर्याय जिंकला पाहिजे हे ठरवत नाही.
BIG CHANGEच्या दृष्टीने पुढचा टप्पा म्हणजे कमी एकूण श्रमात पूर्ण झालेले आणि मोजता येणारे काम. Grok 4.7 स्वीकारार्ह निकालांचा खर्च कमी करत असेल तर अधिक संस्थांना उपयुक्त स्वयंचलन उपलब्ध होऊ शकते. अतिरिक्त तर्कामुळे खर्च टोकन-दरातून वापरलेल्या टोकनच्या मोठ्या संख्येकडेच सरकत असेल, तर मथळ्यातील किंमत खरेदीदाराला फारशी माहिती देणार नाही. या प्रश्नाचे उत्तर पूर्ण झालेल्या कामांतून—त्यात आधी अयशस्वी झालेली कामे धरून—मिळेल.