Grok 4.7 представили 21 сентября 2026 года. Для команд, которые покупают ИИ для написания кода или анализа деловой информации, релиз ставит практический вопрос: делает ли более совершенная модель готовую работу дешевле? Ответ зависит не только от заявленных тарифов за токены. официальных примечаниях к выпуску
Эта неоднозначная картина — тема видео Мэттью Бермана от 22 сентября, Не знаю, что думать о Grok 4.7…. Он ставит под сомнение выбор сравниваемых моделей и утверждает, что важнее цена выполненной задачи, а не стоимость токенов. Он также говорит, что ещё не проверил модель как следует. Его видео — предварительная оценка имеющихся данных, а не всестороннее практическое тестирование. Вступление Бермана, 0:00
На релиз стоит обратить внимание: полезной модели необязательно побеждать во всех бенчмарках, чтобы изменить то, какие задачи бизнесу по силам автоматизировать. Но она должна достаточно часто выполнять работу правильно, чтобы оправдать общие затраты. Независимые тесты уже показывают противоречие: лучшие результаты Grok 4.7 могут сопровождаться гораздо большим объёмом сгенерированного текста.
Поэтому для разработчиков, малого бизнеса и команд, создающих агентов, решение носит практический характер. Какие задачи эта модель может выполнять с приемлемым качеством? Сколько усилий ей для этого нужно? И сколько работы останется человеку после того, как модель объявит задачу завершённой?
Мы изучили полную расшифровку субтитров примерно 17-минутного видео Бермана и сверили сведения о запуске, документацию продукта и оценку Artificial Analysis. В приведённом ниже анализе нет ни бенчмарка BIG CHANGE, ни заявления о собственном тестировании Grok.
Что выпустили и где это доступно
Стандартная модель доступна через API xAI под названием grok-4.7, а также в Cursor и Grok Build. API принимает текст и изображения и генерирует текст. Заявленное в документации контекстное окно — 500 000 токенов; предусмотрены четыре режима рассуждения: низкий, средний, высокий и сверхвысокий. По умолчанию выбран высокий. официальных примечаниях к выпуску
SpaceXAI объясняет улучшение более крупной базовой моделью и более длительным обучением с подкреплением на сложных задачах. Это объяснение разработчика. техническом обзоре запуска
Есть и Grok 4.7 Fast. Согласно документации, это та же модель на более быстрой инфраструктуре, но тарификация токенов вдвое выше стандартной. Версия доступна в Cursor и Grok Build, исключена из бесплатного тарифа Grok Build и не предлагается через общедоступный API xAI. документации продукта Grok 4.7
Эти различия важны при сравнении скриншотов, демонстраций и счетов. Версия модели, уровень рассуждения и вариант обслуживания — отдельные параметры. Демонстрация Fast с режимом сверхвысокого рассуждения не показывает ни опыт использования, ни стоимость стандартного API-вызова с умеренным уровнем рассуждения.
Сравнение с другими моделями на странице запуска следует также отделять от сравнения обновлений. По словам SpaceXAI, стандартная Grok 4.7 стоит столько же и работает с той же скоростью, что и Grok 4.6. Это не означает, что переход с версии 4.6 автоматически вдвое снизит счёт клиента.
В тарифной таблице есть порог для длинного контекста
Опубликованные стандартные тарифы API таковы:
- До 200 000 токенов в запросе: 2 доллара за ввод, 0,50 доллара за кэшированный ввод и 6 долларов за вывод на миллион токенов.
- Свыше 200 000 токенов в запросе: 4 доллара за ввод, 1 доллар за кэшированный ввод и 12 долларов за вывод на миллион токенов.
Это тарифы за токены, а не полная цена выполнения задачи агентом. На странице модели указаны повышенные цены для запросов длиннее 200 000 токенов, а в примечаниях к выпуску приведены сами повышенные тарифы. Цены и доступность проверены 22 сентября. тарифах модели и примечаниях к выпуску
Таким образом, контекстное окно на 500 000 токенов не означает, что каждый запрос в его пределах оплачивается по минимальному тарифу. И большой контекст сам по себе не гарантирует, что модель будет стабильно находить все нужные детали в большой подборке файлов.
В документации Cursor есть ещё одно продуктовое различие: стандартное окно на 256 000 токенов и максимальное — на 500 000. Доступная в редакторе ёмкость может отличаться от спецификации API или зависеть от выбранного режима. документации Cursor о Grok 4.7
Для команды, обрабатывающей большие отчёты, главный вопрос — настолько ли отправка всех материалов улучшает результат, чтобы оправдать затраты. Извлечение нужных разделов может быть дешевле, а результат — проще проверить. Иногда нужен весь документ; иногда так просто легче составить запрос. Планировать бюджет для этих ситуаций одинаково не следует.
Лучшие результаты могут требовать больше токенов
В оценке Artificial Analysis от 21 сентября Grok 4.7 в режиме сверхвысокого рассуждения получила 46 баллов по индексу Intelligence Index — на два балла больше, чем Grok 4.6. По оценке отчёта, на задачу приходится около 81 000 выходных токенов против 36 000 у Grok 4.6 с высоким уровнем рассуждения. В том же отчёте для Grok 4.6 в режиме сверхвысокого рассуждения указано 38 000 токенов; значит, даже при сравнении одинакового уровня новая модель использовала более чем вдвое больше выходных токенов. оценке запуска от Artificial Analysis
Это наглядная причина отделять цену токена от стоимости задачи. Использование 81 000 выходных токенов по базовому тарифу 6 долларов за миллион даёт примерную плату за вывод 0,486 доллара. Для 38 000 токенов она составила бы 0,228 доллара. В этих расчётах намеренно не учтены ввод, кэширование, плата за инструменты, повышенный тариф для длинного контекста и неудачные попытки. Это арифметика на основе опубликованного числа токенов, а не замер полной стоимости задачи.
Больше текста — не обязательно пустая трата. Модель может потратить дополнительные усилия на проверку ответа и избежать ошибки, из-за которой пришлось бы вмешаться человеку. Но она может и дольше следовать ошибочному плану. Одного числа токенов недостаточно, чтобы отличить полезную настойчивость от дорогостоящих повторов.
Ближе к концу видео Берман возвращается к этой проблеме и отмечает более высокий расход токенов, указанный Artificial Analysis. Видео, 15:43
Полезный результат — это работа, которую приняли. Изменение кода, прошедшее необходимые тесты и проверку, таблица со сходящимися формулами или отчёт, в котором утверждения подтверждаются источниками, ценнее ответа, который просто пришёл быстро.
Бенчмарки показывают способную, но неоднородную модель
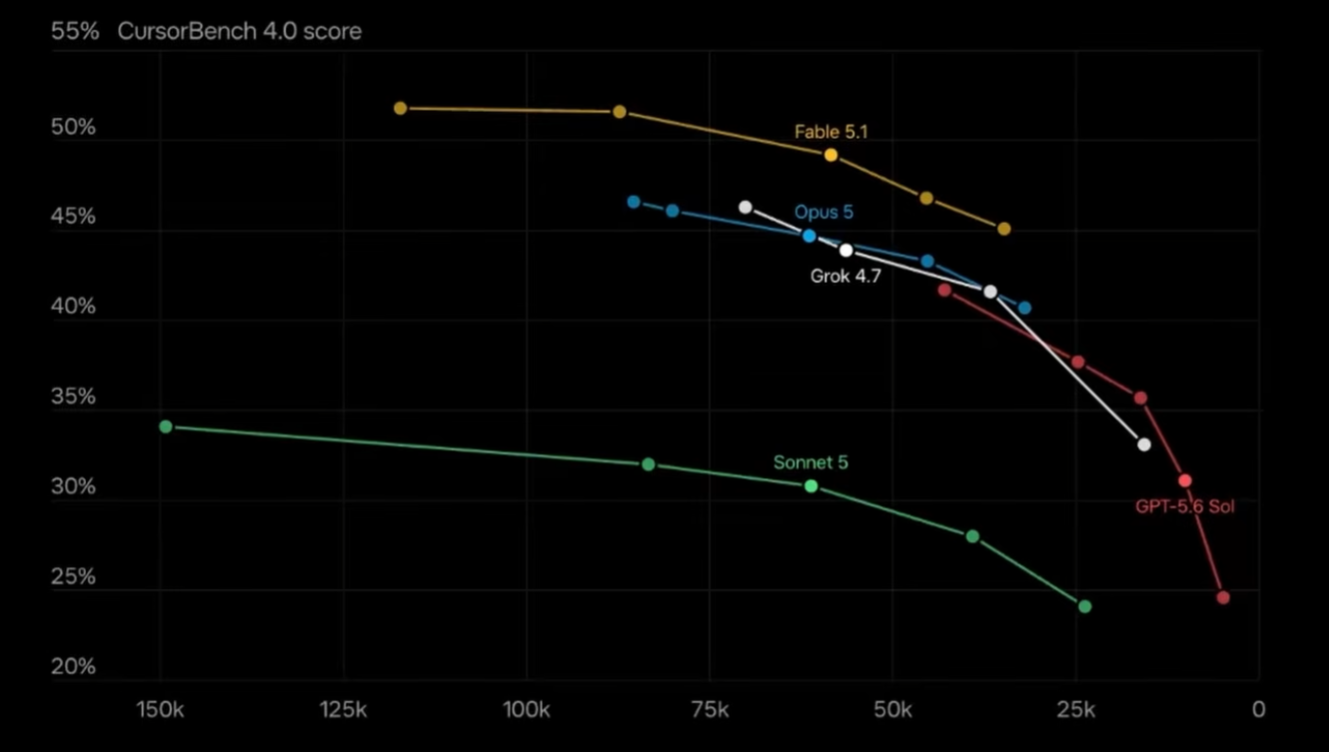
В таблице запуска Grok 4.7 в режиме сверхвысокого рассуждения набрала 46,3% в CursorBench 4.0 — меньше, чем Fable 5.1 в максимальном режиме с результатом 51,8%. Fable также лидирует в сравнении Terminal-Bench. таблице бенчмарков разработчика
На графике рядом сопоставлены результат бенчмарка и количество выходных токенов; кривая снижается вправо. Линии показывают разные уровни рассуждения. Оригинальный интерактивный график: выберите Tokens. Откройте график в полном размере.
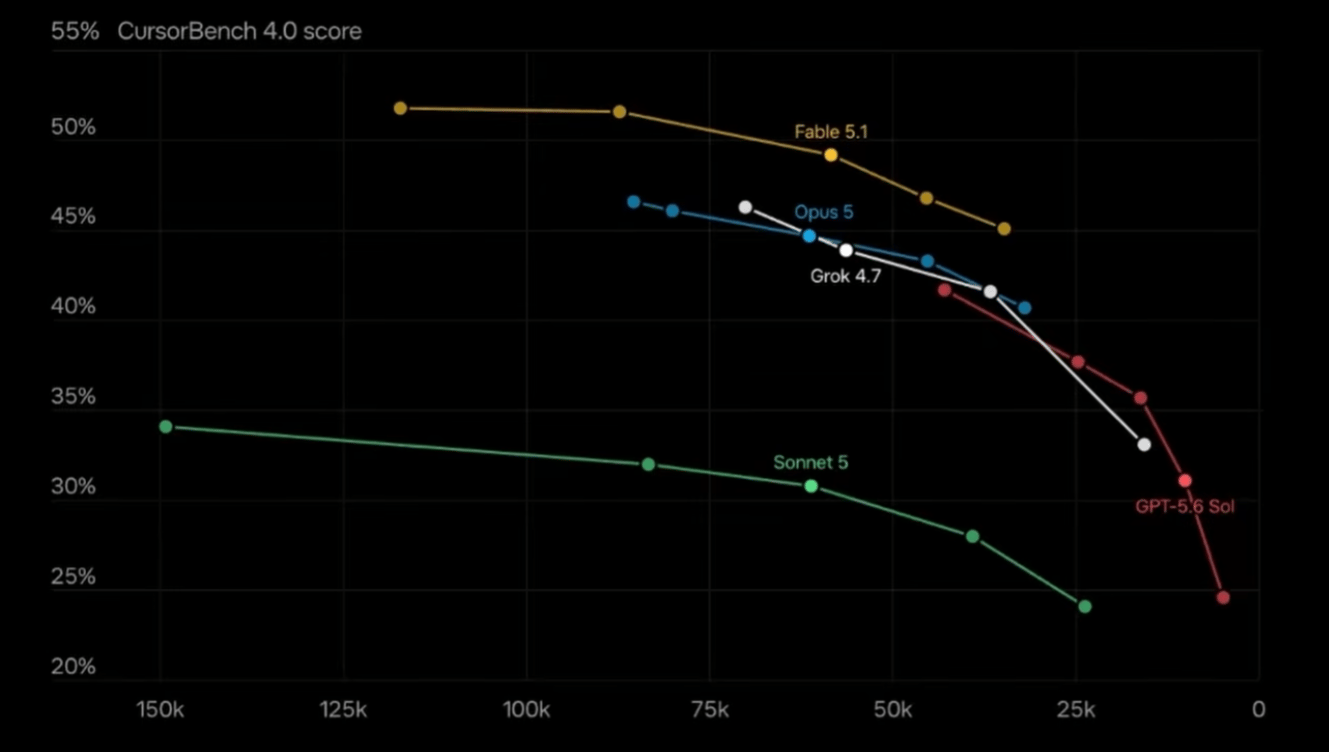
Движение вверх означает более высокий балл; движение вправо — меньше сгенерированных токенов в этой оценке. Это не значит, что полная стоимость ниже: имеют значение тарифы на токены, объём ввода и работа окружающего агента. Это также другой тест, не тот, по которому выше приведено число токенов от Artificial Analysis. Если объединить эти значения, исчезнут различия задач и методик, необходимые для осмысленной интерпретации каждого результата.
Этого достаточно, чтобы отвергнуть общее утверждение, будто Grok 4.7 лидирует во всех видах программирования. Но этого достаточно и для более пристального изучения конкретных рабочих нагрузок. Масштаб улучшения в одной оценке не определяет, как модель справится с незнакомым репозиторием, неполным описанием ошибки или необычной средой инструментов.
Artificial Analysis выделяет ещё одно полезное различие. В отчёте оценка Coding Agent Index для Grok 4.7 с Grok Build составляет 56 против 47 у Grok 4.6 с тем же агентом. Эти результаты с родным агентом отдельно сопоставлены со стандартизированной методикой Intelligence Index. независимой оценке и заметках о методике
Окружающий агент имеет значение: он предоставляет инструменты, управляет контекстом и решает, как исполнять запросы модели. Изменение этой среды может поменять результат, даже если название модели остаётся прежним. Если поставить рядом результат терминального теста из одной конфигурации и результат проверки программной инженерии из другой, получится убедительная таблица, которая не описывает ни одну реально проверенную систему.
Берман отмечает, что в одной таблице запуска нет GPT-6 Astra, и использует реконструкцию, созданную ИИ, чтобы добавить её. Это может побудить внимательнее проверить сравнение, однако реконструкция не является независимым источником бенчмарка. Мы не используем добавленные в ней цифры, не сверив лежащую в их основе оценку. Видео, 6:03
Следует учитывать и коммерческую связь. В объявлении Cursor от 14 августа компания сообщает о приобретении SpaceX. Бенчмарк, опубликованный внутри семейства этого продукта, остаётся полезным свидетельством, но не является беспристрастной оценкой конкурирующего поставщика. объявлении о приобретении Cursor
Возможно, офисная работа — более интересная возможность
По независимой оценке Artificial Analysis, Grok 4.7 в режиме сверхвысокого рассуждения набрала 1657 Elo в AA-Briefcase — на 111 больше, чем Grok 4.6 с высоким уровнем рассуждения. Значительную часть улучшения отчёт связывает с качеством аналитики; качество презентации немного ниже результата прежней модели. результатах Artificial Analysis по интеллектуальной работе
Это различие важно для всех, кто заказывает отчёты, таблицы или презентации. Ответ может содержать более глубокий анализ, но всё равно требовать редактуры или нового оформления. И наоборот, за эффектной презентацией могут скрываться поверхностные рассуждения. Оценка только по видимому оформлению рискует поощрить не то улучшение.
Операционная команда могла бы проверить модель на регулярном отчёте о результатах работы. В ходе теста стоит выяснить, правильно ли выбраны отчётный период и исходные данные, сходятся ли с ними цифры и отличает ли модель наблюдаемое изменение от его возможного объяснения. Проверяющему следует записать, сколько исправлений понадобилось, а не только отметить, профессионально ли выглядел первый вариант.
Для небольшой компании может быть важнее превратить прежде недоступный анализ в рутинную задачу, чем выиграть сложнейший бенчмарк. Это возможный путь к более широкому внедрению. Он станет реальностью, если результат будет достаточно точным, будет готов вовремя и оставит владельцу меньше работы, чем ручное выполнение задачи.
Профессиональные названия бенчмарков не следует путать с профессиональной квалификацией. Результат оценки юридических задач или клинических рассуждений описывает работу на конкретном тесте. Он не доказывает, что модель самостоятельно справится с юридическим делом клиента или примет решение о лечении пациента. Эта статья не рекомендует поручать Grok такие решения.
Меры защиты тоже нужно оценивать с учётом контекста
SpaceXAI заявляет, что в Grok 4.7 появился новый комплекс мер защиты и повысилась устойчивость к обходу ограничений. Это заявление при запуске, а не гарантия безопасности каждого приложения, использующего модель. описании безопасности от разработчика
Для бизнес-агента остаются как минимум два вопроса. Правильно ли модель реагирует на полученные запросы? И ограничивает ли приложение то, что модель действительно может сделать?
Модель может правильно понять просьбу изменить запись о клиенте, не имея разрешения вносить это изменение. Кроме того, в документе для пересказа могут встретиться вредоносные инструкции. Контроль доступа и правила согласования должны оставаться частью окружающей системы; более надёжный отказ от опасных запросов их не заменяет.
На практике нужно проверять весь рабочий процесс. Включите допустимые запросы, которые должны выполняться, запрещённые действия, которые нужно блокировать, и неоднозначные случаи, требующие уточнения. Продукт, слишком часто отказывающийся от безвредной работы, может оказаться бесполезным; система, выполняющая несанкционированные действия, способна нанести гораздо больший вред. Ни одну из этих проблем не отражает один заголовочный балл.
Что осталось без ответа в видео
В обзоре Бермана подняты вопросы, которые пока и должны оставаться вопросами. Связь, которую он проводит между ценами и доступными вычислительными ресурсами, — рыночная интерпретация, а не опубликованный расчёт себестоимости. Обсуждаемые им прогнозы из соцсетей — ожидания, а не доказательства достигнутой производительности. В заключительном сравнении демонстраций он сам признаёт, что не знает использованных настроек. Обсуждение цен, 8:44, прогнозы, 11:51 и демонстрация, 15:20
В видео также обсуждаются модели с открытыми весами. Эту общую тенденцию конкуренции не следует путать с лицензией Grok 4.7: Artificial Analysis указывает, что релиз является проприетарным и его веса недоступны. профиле выпуска Grok 4.7
Эти различия помогают сосредоточиться на оценке. Продукт может иметь привлекательную цену, даже если общественности неизвестно, почему поставщик выбрал именно её. Неудачная эффектная демонстрация может подсказать тест, который стоит повторить, но не доказывает, что модель в целом плоха. Доступная модель может быть полезной, даже если она не оправдывает прежний прогноз основателя.
Следует учитывать и границы спонсорства. В видео Бермана есть реклама Zapier. Она не служит независимым свидетельством возможностей Grok, а рекламные заявления не являются рекомендациями BIG CHANGE.
Более полезный показатель для покупателя: стоимость принятой задачи
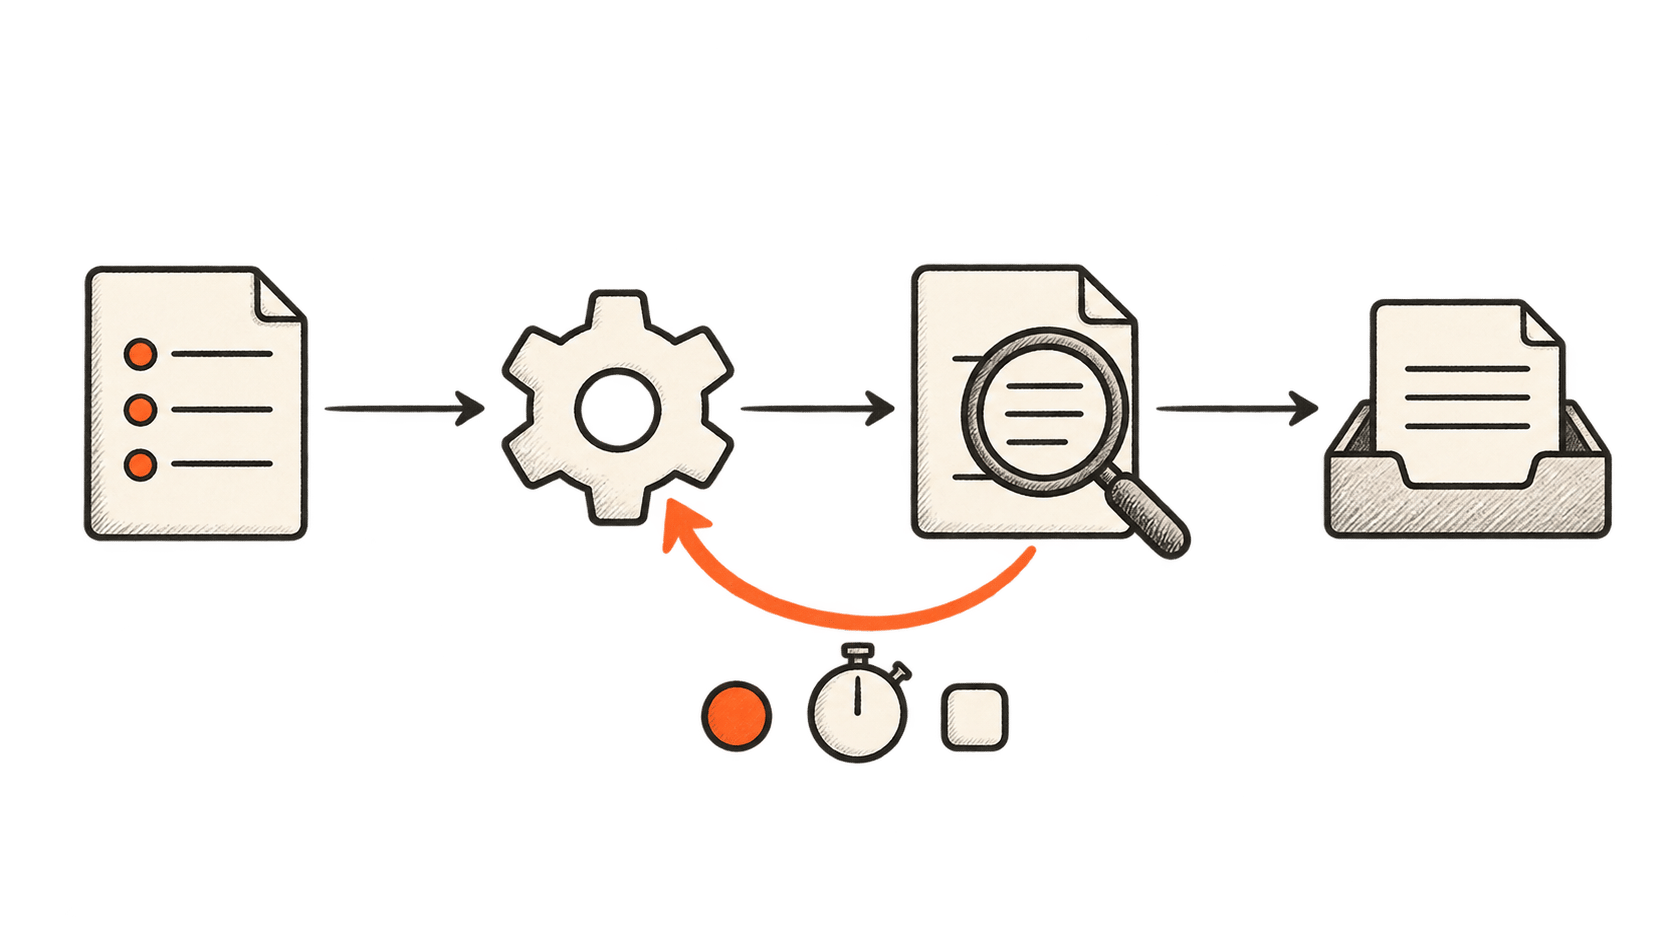
Команде, рассматривающей Grok 4.7, следует сравнить её с текущим процессом на небольшом, но репрезентативном наборе задач. Критерии приёмки нужно определить до просмотра результатов. Для программирования это могут быть нужные тесты, понятный патч и отсутствие несвязанных изменений. Для анализа — правильные расчёты и подтверждения для существенных утверждений.
Затем посчитайте все затраты: токены ввода и вывода, инструменты, повторные попытки и время на проверку или исправление результата. Учитывайте и неудачные попытки. Разделите эту сумму на количество результатов, прошедших критерии приёмки.
Пример показывает, почему это различие важно. Допустим, один вариант стоит 20 долларов за партию и даёт 80 принятых результатов. Его измеренная стоимость — 0,25 доллара за принятый результат без учёта труда людей. Другой вариант стоит 12 долларов, но даёт лишь 30 принятых результатов, то есть 0,40 доллара за результат. Более дешёвая партия обходится дороже, если считать пригодную к использованию работу. Это условные числа, а не результаты измерений Grok.
Уровень рассуждения тоже следует включить в тест. Высокий уровень может оправдать свою стоимость на сложной задаче, но почти ничего не добавить к рутинной. Экономичнее может оказаться повышать его только в нужных случаях, а не запускать каждый запрос в режиме сверхвысокого рассуждения, если при этом отдельно проверяется качество самого выбора режима.
Сохраняйте одинаковые стандарты проверки для всех моделей. Если снизить требования к более дешёвой модели, экономия будет мнимой: за неё примут худшую работу. Если повысить планку только для действующей модели, искажение будет обратным. Цель — получить надёжный результат и ясно понимать, что ещё должны сделать люди.
За каким изменением стоит следить
Grok 4.7 даёт командам ещё один вариант для проверки. Выбирая его, нужно оценивать задачу целиком: что модель выдаёт, сколько ресурсов потребляет и что человеку всё ещё приходится исправлять.
В более широком плане это может привести к более избирательному применению ИИ в повседневной работе. Команда может выбрать одну конфигурацию для рутинного анализа, другую — для сложного программирования, а в случаях, когда нельзя передать машине суждение или ответственность, оставить задачу человеку. Усиление конкуренции даёт команде ещё один вариант для проверки, но не предопределяет победителя.
Для BIG CHANGE следующий рубеж — измеримый объём выполненной работы при меньших общих затратах усилий. Если Grok 4.7 снизит стоимость принятых результатов, полезная автоматизация станет доступна большему числу организаций. Если дополнительные рассуждения лишь перенесут расходы с цены токена на объём его потребления, заголовочная цена мало что скажет покупателю. Ответ дадут завершённые задачи, в том числе те, которые сначала не удались.