Grok 4.7 llegó el 21 de septiembre de 2026. Para los equipos que compran IA para escribir código o analizar información empresarial, su lanzamiento plantea una pregunta práctica: ¿un modelo mejor abarata el trabajo terminado? La respuesta depende de más factores que las tarifas por token anunciadas. Notas oficiales de lanzamiento
El vídeo de Matthew Berman del 22 de septiembre, No sé qué pensar de Grok 4.7…. cuestiona la elección de las comparaciones y sostiene que importa más el coste por tarea completada que el precio de los tokens. También afirma que todavía no ha probado el modelo a fondo. Su vídeo es una primera evaluación de las pruebas, no un análisis exhaustivo de primera mano. Introducción de Berman, 0:00
El lanzamiento merece atención porque un modelo útil no tiene que ganar todas las pruebas comparativas para cambiar lo que las empresas pueden permitirse automatizar. Sin embargo, sí debe completar suficiente trabajo correctamente para justificar el coste total. Las pruebas independientes ya revelan la tensión: los mejores resultados de Grok 4.7 pueden requerir generar mucho más contenido.
Para desarrolladores, pequeñas empresas y equipos que crean agentes, la decisión es práctica. ¿Qué tareas puede completar este modelo con una calidad aceptable? ¿Cuánto esfuerzo necesita? ¿Y cuánto trabajo le queda a una persona después de que el modelo diga que ha terminado?
Revisamos los subtítulos completos del vídeo de Berman, de unos 17 minutos, y comprobamos la información del lanzamiento, la documentación del producto y la evaluación de Artificial Analysis. El análisis siguiente no incluye pruebas comparativas de BIG CHANGE ni afirmaciones basadas en nuestras propias pruebas de Grok.
Qué se lanzó y dónde está disponible
El modelo estándar está disponible en la API de xAI con el nombre grok-4.7, además de en Cursor y Grok Build. La API acepta texto e imágenes y genera texto. Su ventana de contexto documentada es de 500.000 tokens y ofrece cuatro niveles de razonamiento: bajo, medio, alto y extralto. El nivel predeterminado es alto. Notas oficiales de lanzamiento
SpaceXAI atribuye la mejora a un modelo base más grande y a un entrenamiento por refuerzo más prolongado con tareas difíciles. Esta es la explicación del desarrollador. Resumen técnico del lanzamiento
También existe Grok 4.7 Fast. La documentación lo describe como el mismo modelo, pero ejecutado en una infraestructura más rápida, con el doble de las tarifas estándar por token. Se ofrece a través de Cursor y Grok Build, está excluido del nivel gratuito de Grok Build y no está disponible en la API pública de xAI. Documentación del producto Grok 4.7
Estas diferencias importan al comparar capturas de pantalla, demostraciones y facturas. La versión del modelo, el nivel de razonamiento y el tipo de servicio son opciones distintas. Una demostración con Fast en xhigh no permite estimar la experiencia ni el coste de una llamada a la API estándar con esfuerzo medio.
La comparación de la página de lanzamiento con otros modelos también debe distinguirse de la comparación con la versión anterior. SpaceXAI afirma que Grok 4.7 estándar cuesta y funciona a la misma velocidad que Grok 4.6. No afirma que actualizar desde la versión 4.6 reduzca automáticamente a la mitad la factura del cliente.
La tarjeta de precios incluye un umbral para contextos largos
Las tarifas publicadas para la API estándar son:
- Hasta 200.000 tokens de entrada: 2 dólares por millón de tokens; 0,50 dólares por millón para entrada en caché, y 6 dólares por millón de tokens de salida.
- Más de 200.000 tokens de entrada: 4 dólares por millón de tokens; 1 dólar por millón para entrada en caché, y 12 dólares por millón de tokens de salida.
Estas son tarifas por token, no el precio total de que un agente complete un trabajo. La página del modelo señala que las solicitudes de más de 200.000 tokens tienen un precio superior, y las notas de lanzamiento especifican esas tarifas. Los precios y la disponibilidad se comprobaron el 22 de septiembre. Precios del modelo y notas de lanzamiento
Por tanto, una ventana de contexto de 500.000 tokens no significa que todas las solicitudes que quepan en ella se facturen a la tarifa más baja. Tampoco demuestra que el modelo vaya a encontrar sistemáticamente todos los detalles pertinentes en una gran colección de archivos.
La documentación de Cursor introduce otra diferencia entre productos: indica una ventana estándar de 256.000 tokens y un máximo de 500.000. La capacidad disponible en un editor puede diferir de la especificación de la API o depender del modo elegido. Documentación de Cursor sobre Grok 4.7
Para un equipo que procesa informes largos, la pregunta inmediata es si enviar todo el material mejora el resultado lo suficiente como para justificar el coste. Recuperar las secciones pertinentes quizá sea más barato y más fácil de revisar. A veces hace falta el documento completo; otras, simplemente es la forma más fácil de preparar una solicitud. Esas situaciones no deberían presupuestarse como si fueran idénticas.
Un mejor rendimiento puede consumir más tokens
La evaluación de Artificial Analysis del 21 de septiembre otorga a Grok 4.7 en xhigh una puntuación de 46 en su índice de inteligencia, dos puntos por encima de Grok 4.6. Informa de unos 81.000 tokens de salida por tarea, frente a 36.000 de Grok 4.6 en el nivel alto. El mismo informe registra 38.000 para Grok 4.6 en xhigh, así que incluso esa comparación con el mismo nivel de esfuerzo supone más del doble de tokens de salida. Evaluación de lanzamiento de Artificial Analysis
Esta es una razón concreta para distinguir el precio por token del coste de una tarea. Usar 81.000 tokens de salida a la tarifa base de 6 dólares por millón supone un coste ilustrativo de 0,486 dólares. Con 38.000 tokens, serían 0,228 dólares. Estos cálculos excluyen deliberadamente la entrada, el uso de caché, los cargos de herramientas, las tarifas para contextos largos y los intentos fallidos. Son operaciones aritméticas basadas en el uso de tokens publicado, no precios totales medidos por trabajo.
Generar más texto no es un desperdicio automáticamente. Quizá un modelo dedique más esfuerzo a comprobar una respuesta y evite un fallo que, de otro modo, exigiría la intervención de una persona. También podría tardar más en seguir una estrategia equivocada. El número de tokens, por sí solo, no permite distinguir la persistencia productiva de la repetición costosa.
Berman vuelve a este problema hacia el final de su vídeo, cuando señala el mayor consumo de tokens que informa Artificial Analysis. Vídeo, 15:43
El resultado útil es un producto de trabajo aceptado. Un cambio de código que supera las pruebas y la revisión adecuadas, una hoja de cálculo cuyas fórmulas cuadran o un informe cuyas afirmaciones se apoyan en pruebas tienen un valor distinto de una respuesta que simplemente llega rápido.
Las pruebas comparativas muestran un modelo capaz, pero irregular
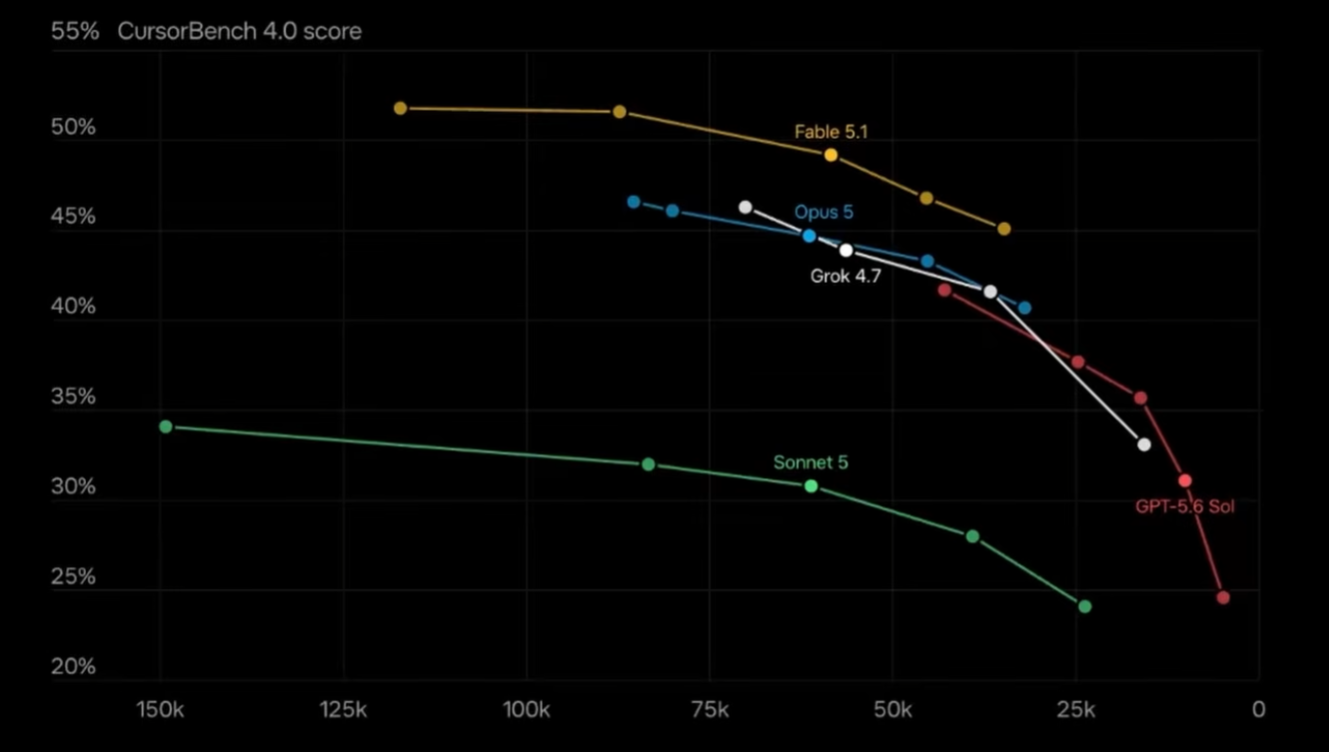
La tabla del lanzamiento otorga a Grok 4.7 xhigh un 46,3 % en CursorBench 4.0, por debajo del 51,8 % de Fable 5.1 max. Fable también lidera la comparación en Terminal-Bench. Tabla comparativa del proveedor
El gráfico que acompaña la tabla representa la puntuación frente a los tokens de salida, que disminuyen hacia la derecha. Sus líneas comparan los niveles de razonamiento. Gráfico interactivo original: seleccionar «Tokens». Abrir el gráfico a tamaño completo.
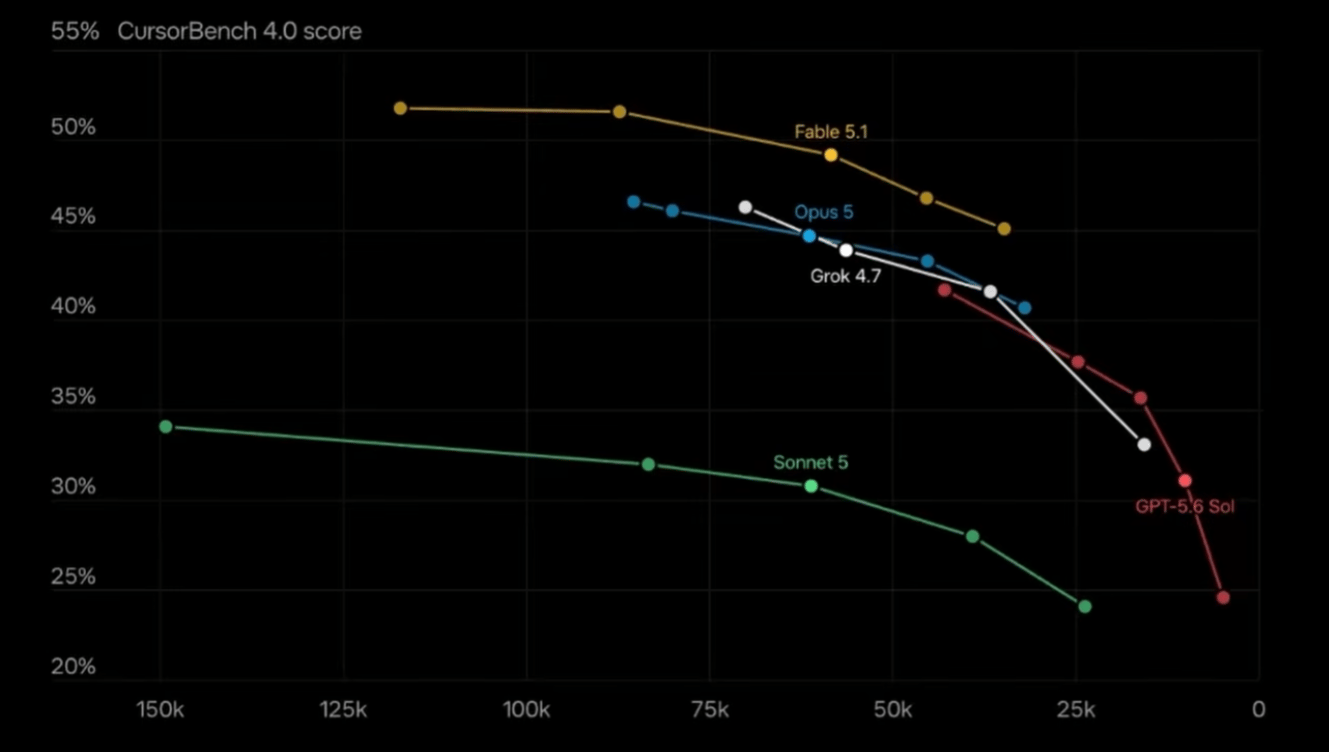
Subir significa obtener una puntuación mayor; avanzar hacia la derecha significa generar menos tokens en esta evaluación. No significa que el coste total sea menor: también importan las tarifas por token, el uso de entrada y el resto del agente. Además, esta prueba es distinta de las cifras de tokens de Artificial Analysis mencionadas antes. Combinar sus recuentos borraría las diferencias de tarea y metodología que permiten interpretar cada resultado.
Esto basta para rechazar la afirmación general de que Grok 4.7 lidera en todas las clases de programación. También justifica examinarlo con más detalle para determinadas cargas de trabajo. La magnitud de la mejora en una evaluación no determina cómo responderá el modelo ante un repositorio desconocido, un informe de error incompleto o un entorno de herramientas inusual.
Artificial Analysis aporta una distinción independiente útil. Su informe asigna a Grok 4.7 con Grok Build una puntuación de 56 en el índice Coding Agent, frente a 47 de Grok 4.6 con ese mismo agente. Separa explícitamente estos resultados del agente nativo de la configuración estandarizada de su índice de inteligencia. Evaluación independiente y notas sobre la metodología
El agente que rodea al modelo importa. Proporciona herramientas, gestiona el contexto y decide cómo ejecutar las solicitudes del modelo. Cambiar ese entorno puede alterar los resultados aunque el nombre del modelo siga siendo el mismo. Combinar una puntuación de terminal obtenida con una configuración y otra de ingeniería de software obtenida con otra puede producir una tabla convincente que no describe ningún sistema que se haya probado realmente.
Berman señala que una de las tablas del lanzamiento no incluye GPT-6 Astra e incorpora una reconstrucción generada con IA. Es una pista útil para investigar la comparación, pero la reconstrucción no es una fuente independiente de resultados comparativos. No adoptamos las cifras añadidas sin comprobar la evaluación subyacente. Vídeo, 6:03
También hay que tener en cuenta una relación comercial. El anuncio corporativo de Cursor del 14 de agosto indica que SpaceX adquirió la empresa. Un análisis comparativo publicado dentro de esa familia empresarial sigue siendo una prueba útil, pero no una evaluación desinteresada de un proveedor competidor. Anuncio de adquisición de Cursor
El trabajo de oficina podría ser la oportunidad más interesante
La evaluación independiente informa de 1.657 puntos Elo para Grok 4.7 xhigh en AA-Briefcase, 111 por encima de Grok 4.6 en el nivel alto. Atribuye gran parte de la mejora a la calidad analítica, mientras que la calidad de presentación queda ligeramente por debajo del resultado del modelo anterior. Resultados de trabajo intelectual de Artificial Analysis
Esa diferencia es útil para quienes encargan informes, hojas de cálculo o presentaciones. Una respuesta puede contener un análisis más sólido y aun así necesitar edición o rediseño. A la inversa, una presentación pulida puede ocultar un razonamiento superficial. Evaluar solo el acabado visible puede premiar la mejora equivocada.
Un equipo de operaciones podría probar el modelo con un informe periódico de rendimiento. Una prueba útil comprobaría si utiliza el período correcto, concilia las cifras con los datos de origen y distingue un cambio observado de una explicación propuesta. Quien lo revise debería registrar cuánta corrección hizo falta, no limitarse a comprobar si el informe parecía profesional a primera vista.
A una pequeña empresa quizá le importe menos ganar la prueba comparativa más difícil y más poder convertir en rutinario un análisis que hasta ahora no podía costear. Esa es una vía plausible para ampliar la adopción. Se materializa cuando el resultado es suficientemente preciso, llega a tiempo y deja al propietario menos trabajo que si lo hiciera manualmente.
Las etiquetas de evaluaciones profesionales no deben confundirse con cualificaciones profesionales. Un resultado de trabajo jurídico o razonamiento clínico describe el desempeño en esa prueba. No demuestra que un modelo pueda gestionar por sí solo el asunto jurídico de un cliente ni tomar una decisión asistencial sobre un paciente. Este artículo no recomienda utilizar Grok para tomar esas decisiones.
Las salvaguardas también deben evaluarse en contexto
SpaceXAI afirma que Grok 4.7 tiene una nueva capa de salvaguardas y una mayor resistencia a los intentos de eludirlas. Es una afirmación de lanzamiento, no una garantía de que todas las aplicaciones que usen el modelo sean seguras. Información de seguridad del desarrollador
Para un agente empresarial siguen pendientes al menos dos preguntas. ¿Responde el modelo de forma adecuada a las solicitudes que recibe? ¿Y limita la aplicación lo que realmente puede hacer el modelo?
Un modelo puede entender correctamente una instrucción para modificar los datos de un cliente y, aun así, carecer de permiso para hacerlo. También puede encontrar instrucciones maliciosas incrustadas en un documento que debía resumir. Los controles de acceso y las reglas de aprobación deben seguir formando parte del sistema circundante; una mejor conducta al rechazar solicitudes no los sustituye.
La consecuencia práctica es probar todo el flujo de trabajo. Hay que incluir solicitudes legítimas que deban aceptarse, acciones no permitidas que deban bloquearse y casos ambiguos que deban detenerse para pedir aclaraciones. Un producto que rechaza demasiado a menudo el trabajo inocuo puede resultar inutilizable; uno que ejecuta acciones no autorizadas puede ser mucho peor. Ninguno de esos problemas se refleja en una sola puntuación de portada.
Qué cuestiones deja abiertas el vídeo
La cobertura de Berman plantea varias preguntas que deberían seguir abiertas. Su explicación sobre la relación entre los precios y la capacidad de cómputo disponible es una interpretación del mercado, no una contabilidad publicada de costes unitarios. Las predicciones sobre redes sociales que comenta son expectativas, no pruebas de rendimiento demostrado. Su comparación de demostraciones al final del vídeo viene acompañada de su propia admisión de que desconoce los ajustes utilizados. Debate sobre precios, 8:44, predicciones, 11:51 y debate sobre la demostración, 15:20
El vídeo también aborda los modelos de pesos abiertos. Esa tendencia competitiva más amplia no debe confundirse con la licencia de Grok 4.7: Artificial Analysis identifica esta versión como propietaria e indica que sus pesos no están disponibles. Ficha de lanzamiento de Grok 4.7
Estas distinciones mantienen el foco de la evaluación. Un producto puede tener un precio atractivo sin que el público sepa por qué su proveedor eligió ese precio. Una demostración fallida llamativa puede sugerir una prueba que conviene repetir, sin demostrar que el modelo sea malo en general. Un modelo disponible puede ser útil aunque no cumpla una predicción anterior de su fundador.
También hay un límite relacionado con los patrocinios. El vídeo de Berman incluye un anuncio de Zapier. No es una prueba independiente del rendimiento de Grok, y BIG CHANGE no respalda las afirmaciones promocionales.
Una mejor métrica de compra: coste por tarea aceptada
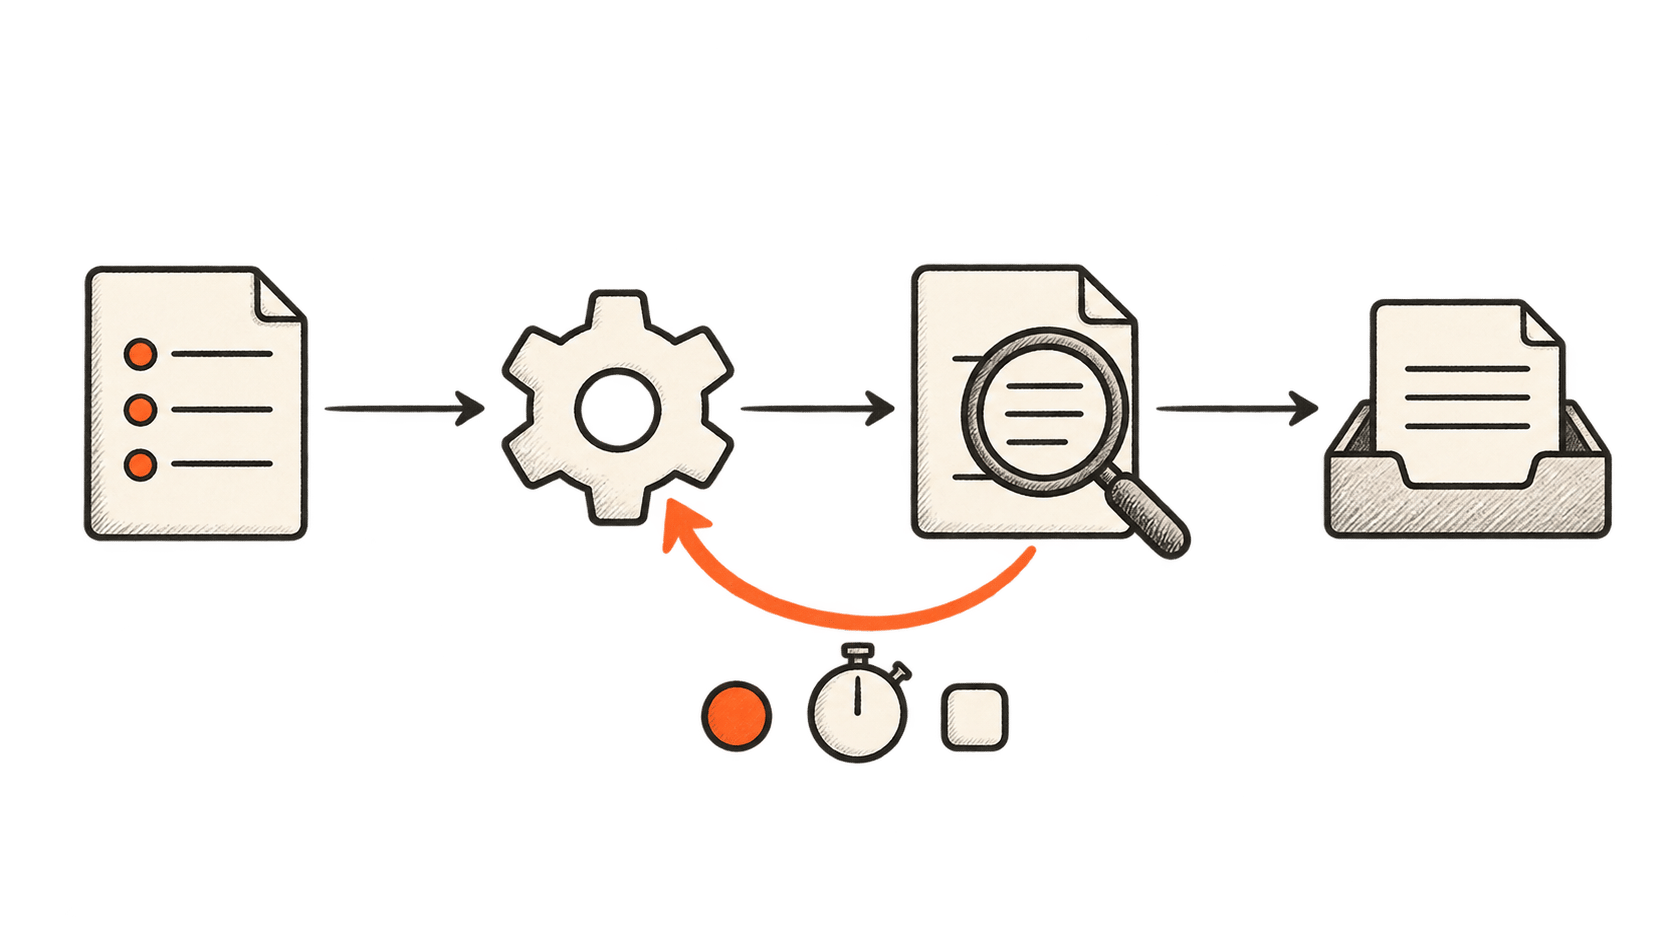
Un equipo que considere Grok 4.7 debería compararlo con su proceso actual usando un conjunto pequeño y representativo de tareas. Hay que definir los criterios de aceptación antes de ver los resultados. En programación, podrían incluir pruebas pertinentes, un parche legible y ausencia de cambios ajenos a la tarea. En análisis, podrían exigir cálculos correctos y pruebas para las afirmaciones importantes.
Después, hay que registrar el coste completo: uso de entrada y salida, herramientas, reintentos y tiempo dedicado a revisar o reparar el resultado. También se cuentan los intentos fallidos. Se divide ese coste por el número de entregables que cumplen los criterios de aceptación.
Un ejemplo ilustrativo muestra por qué importa la diferencia. Supongamos que una configuración cuesta 20 dólares para un lote y produce 80 resultados aceptados. El coste medido es de 0,25 dólares por resultado aceptado antes de contar el trabajo humano. Otra cuesta 12 dólares, pero solo produce 30 resultados aceptados, es decir, 0,40 dólares por resultado aceptado. El lote más barato es la fuente más cara de trabajo utilizable. Estas cifras son hipotéticas, no mediciones de Grok.
El nivel de razonamiento también debería formar parte de la prueba. Un ajuste de esfuerzo alto puede justificar su coste en una tarea difícil y aportar poco en una rutinaria. Escalar solo los casos que lo necesiten podría ser más económico que ejecutar todas las solicitudes en xhigh, siempre que también se evalúe la decisión de enrutamiento.
Hay que mantener constantes los criterios de revisión entre modelos. Rebajar el listón para un modelo más barato aparenta un ahorro al aceptar un trabajo peor. Elevarlo solo para el modelo actual produce la distorsión opuesta. El objetivo es comprar un resultado fiable y dejar claro qué tareas siguen correspondiendo a las personas.
El cambio que conviene seguir
Grok 4.7 ofrece a los equipos otra opción que probar. Elegirla requiere considerar el trabajo completo: qué produce el modelo, qué recursos consume y qué tendrá que reparar una persona.
La consecuencia más amplia podría ser un uso más selectivo de la IA en las tareas cotidianas. Un equipo quizá elija una configuración para análisis rutinarios, otra para programación difícil y una persona para los casos en que no se puedan delegar el juicio o la responsabilidad. Una competencia mayor da al equipo otra opción que probar; no decide por sí sola cuál debería ganar.
Para BIG CHANGE, el próximo hito es completar trabajo medible con menos esfuerzo total. Si Grok 4.7 reduce el coste de los entregables aceptados, puede poner la automatización útil al alcance de más organizaciones. Si el razonamiento adicional solo traslada el gasto del precio por token al volumen consumido, el precio de portada les dirá muy poco a los compradores. La respuesta dependerá de trabajos completados, incluidos aquellos que primero fallaron.