பெரிய மாற்றம்
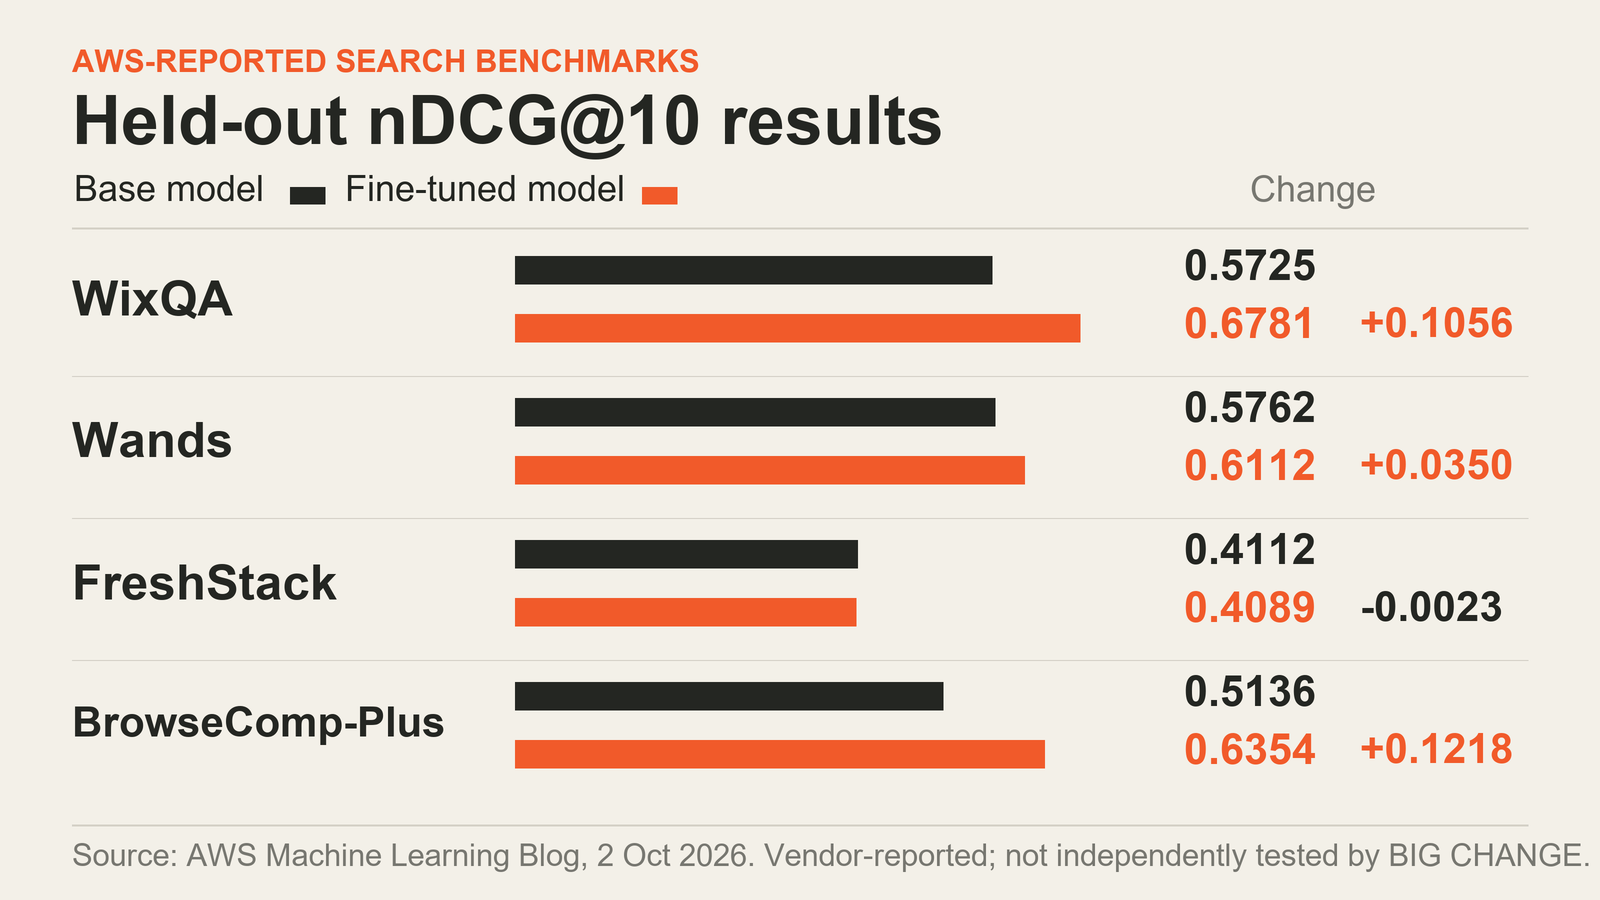
தமது அக்டோபர் 2 வழிகாட்டியில், SageMaker AI-இல் பல-சுற்று வலுவூட்டல் கற்றல் (MTRL) மூலம் Qwen3.6-27B தேடல் முகவரை fine-tune செய்வது குறித்து AWS விளக்குகிறது. மேலுள்ள விளக்கப்படம் AWS தெரிவித்த holdout nDCG@10 மதிப்பெண்களைக் காட்டுகிறது: WixQA, Wands, BrowseComp-Plus ஆகியவற்றில் அவை உயர்ந்தன; FreshStack-இல் சிறிதளவு குறைந்தன. AWS-இன் எண்ணிக்கைகளைப் பயன்படுத்தி BIG CHANGE விளக்கப்படத்தை உருவாக்கியது; முகவரை நாங்கள் தனியாகச் சோதிக்கவோ முடிவுகளை மீண்டும் உருவாக்கவோ இல்லை. கருவிகளைப் பயன்படுத்தும் முடிவுகளின் தொடரின் விளைவைக் கொண்டு இந்த முறை மாதிரியைப் பயிற்றுவிக்கிறது.
ஒரு job-ஐ சமர்ப்பிப்பதற்கு முன், மாதிரியும் பிராந்தியமும் ஆதரிக்கப்படுகிறதா, SageMaker rollout loop-இல் முகவர் பங்கேற்க முடியுமா, prompts மற்றும் rewards எதிர்பார்க்கப்படும் தேடல் பணியை பிரதிபலிக்கிறதா, தனி மதிப்பீட்டுத் தொகுப்பு செயல்திறன் குறைவைக் கண்டறியுமா என்பதை machine-learning பொறியாளர் உறுதிப்படுத்த வேண்டும். இந்த வழிகாட்டி AWS ஆவணங்களை அடிப்படையாகக் கொண்டது; BIG CHANGE AWS job-ஐ இயக்கவோ அதன் API-களை அழைக்கவோ இல்லை.
பயிற்சி சுழற்சியில் MTRL எதை மாற்றுகிறது
Supervised fine-tuning-க்கு விரும்பிய நடத்தையைக் காட்டும் எடுத்துக்காட்டு trajectories தேவை. AWS-இன் MTRL விளக்கத்தில், SageMaker அதற்குப் பதிலாக முகவருக்கு prompts அனுப்புகிறது; பல கட்டங்களில் முகவர் policy model மற்றும் அதன் கருவிகளை அழைக்கிறது, rollout முடிந்ததும் reward-ஐ தெரிவிக்கிறது. அந்த feedback-ஐ வைத்து மாதிரி புதுப்பிக்கப்படுகிறது. தேடலில் reward இறுதி வரிசையை மதிப்பிடலாம்; இதனால் தொடக்க query தேர்வுகள் முழு தேடல் அமர்வின் சூழலில் மேம்படுத்தப்படுகின்றன.
கருவி அழைப்புகள் முந்தைய முடிவுகளைச் சார்ந்திருக்கும்போது இந்த வேறுபாடு முக்கியம். மாதிரி முதல் query-ஐ தவறாக அமைத்து, பலவீனமான முடிவுகளைப் பெற்று, அதை மறுவடிவமைக்க வேண்டியிருந்தால், பணி முடிவில் தரப்படும் reward அந்தக் கட்டங்களின் தொடர் இறுதியில் தொடர்புடைய ஆவணங்களை மீட்டதா என்பதைக் காட்டலாம். இருந்தாலும் ‘தொடர்புடையது’ என்றால் என்ன என்பதை வரையறுத்து, குழுவின் தேடல் கருவிகளை அழைக்கக்கூடிய முகவரை உருவாக்க வேண்டும்.
அணுகல், மாதிரி, பிராந்தியத்தை முதலில் சரிபார்க்கவும்
அக்டோபர் 2 எடுத்துக்காட்டு US West (Oregon) பிராந்தியத்தில் இயக்கப்பட்டது, us-west-2, மேலும் அதில் Qwen3.6-27B fine-tune செய்யப்பட்டது. SageMaker MTRL ஆதரிக்கும் மாதிரி அட்டவணை, 2026 அக்டோபர் 4 அன்று சரிபார்க்கப்பட்டதில், நான்கு மாதிரிகளுக்கான ஆறு மாதிரி-பிராந்திய இணைகள் உள்ளன: Nova Lite 2.0, GPT-OSS-20B ஆகியவை US East (N. Virginia)-இல், us-east-1, மேலும் US West (Oregon)-இல், us-west-2; Gemma-4-31B-it மற்றும் Qwen 3.6 27B Oregon-இல் மட்டுமே ஆதரிக்கப்படுகின்றன. job உருவாக்கத் திட்டமிட்டுள்ள பிராந்தியத்தின் தற்போதைய அட்டவணையைப் பாருங்கள்; பட்டியலில் மாதிரி இருப்பது வேறு பிராந்தியத்திலும் கிடைக்கும் என்பதற்குச் சான்றல்ல.
Studio இடைமுகத்தைப் பயன்படுத்தினால், குழுவுக்கு AWS கணக்கும் SageMaker Studio domain-உம் தேவை. dataset மற்றும் வெளியீடுகளுக்கான S3 அணுகலும், புதிய MTRL job மற்றும் runtime அழைப்புகளுக்கான IAM role அமைப்பும் வேண்டும். AWS முன்நிபந்தனை ஆவணத்தின்படி, அழைப்பவருக்கு CreateJob மற்றும் தொடர்புடைய job செயல்களுக்கான அனுமதியுடன், execution role-ஐ job.sagemaker.amazonaws.com-க்கு அனுப்பும் அனுமதியும் வேண்டும். Execution role-க்கு AmazonSageMakerJobFullAccess policy-யும் அதன் trust policy-யில் அந்த service principal-உம் தேவை. முகவர் runtime role-க்கு AmazonSageMakerJobRuntimeAccess தேவை; AgentCore runtime-க்கும் தனியான trust relationship வேண்டும். Studio runtime picker-க்கு AgentCore-ஐ பட்டியலிடும் அனுமதி அவசியம். ஏற்கெனவே உள்ள விரிவான SageMaker அணுகலில் இந்த புதிய job செயல்கள் அனைத்தும் தானாக அடங்காது என AWS கூறுகிறது.
ஆவணங்கள் முகவருக்கான இரண்டு வழிகளை விளக்குகின்றன. நிர்வகிக்கப்படும் hosting-க்கு Bedrock AgentCore-இல் deploy செய்யலாம்; Strands கொண்டு உருவாக்கிய முகவர்களுடன் இது சிறப்பாகச் செயல்படும் என AWS கூறுகிறது. அல்லது தனிப்பயன் முகவரை host செய்து Lambda forwarder மூலம் இணைக்கலாம். முகவர் rollout prompts-ஐப் பெற்று, SageMaker job runtime வழியாக policy model-ஐ அழைத்து, தேடல் கருவிகளைப் பயன்படுத்தி, ஒவ்வொரு rollout-ஐ முடித்து reward-ஐத் தெரிவிக்கிறது. இந்த ஒருங்கிணைப்பின் பெரும்பகுதியை AWS SDK decorator கையாள்கிறது; தனிப்பயன் framework-கள் runtime API-களை நேரடியாக அழைக்கலாம். Lambda function-க்கு வழக்கமற்ற பெயர் இருந்தால் அதன் ARN-ஐ permission policy-யில் வெளிப்படையாகச் சேர்க்க வேண்டியிருக்கலாம் என AWS கூறுகிறது. வாடிக்கையாளர் நிர்வகிக்கும் VPC அல்லது KMS key கூடுதல் அமைப்பைக் கோரும்.
உண்மையான தேடல் பணிக்கான prompts மற்றும் reward-ஐத் தயாரிக்கவும்
SageMaker asset வழிகாட்டி Parquet, JSON Lines, JSON அல்லது CSV-ஐ ஏற்கிறது. அது prompt என்ற column-ஐத் தேடுகிறது; அது இல்லையெனில் முதல் column-ஐப் பயன்படுத்தி அதன் மதிப்பை மாற்றமின்றி முகவருக்கு அனுப்புகிறது. சேவை prompt உள்ளடக்கத்தை parse, validate அல்லது transform செய்யாது. கருவிகளைப் பயன்படுத்தும் தேடலில் prompt-இல் உரையாடல் செய்திகள், பணி metadata, reward specification, முகவர் எதிர்பார்க்கும் வடிவிலான tool configuration ஆகியவை இருக்கலாம். prompts எந்த ஆய்வுமின்றி அனுப்பப்படுகின்றன என AWS எச்சரிக்கிறது; ஆகவே ரகசியத் தரவைப் பாதுகாப்பது குழுவின் பொறுப்பு. சேமிப்பிலும் முகவருக்குச் செல்லும் பாதையிலும் encryption அல்லது வேறு பொருத்தமான பாதுகாப்பை அமைக்கவும்.
மாதிரி மேம்படுத்தும் குறிக்கோளே reward. AWS எடுத்துக்காட்டில் இறுதியாக மீட்ட ஆவணங்களுக்கு nDCG@10 பயன்படுத்தப்படுகிறது; முகவர் turn அல்லது sampling-token வரம்பை எட்டினால் -1 reward அளிக்கப்படுகிறது. வரிசைப்படுத்தப்பட்ட retrieval பணிக்கு இது தெளிவான தொடக்கம்; ஆனால் மதிப்பீட்டு முடிவுகள் முக்கியமாகின்றன: நம்பகமான relevance labels அல்லது மதிப்பிடுவதற்கான வேறு நியாயப்படுத்தக்கூடிய முறை தேவை. மேற்பரப்பான ranking மேம்பாட்டை ஊக்குவித்து பதில் தரம், latency அல்லது கருவிச் செலவைப் பாதிக்காதபடி reward-ஐச் சரிபார்க்கவும்.
பயிற்சி கலவையில் FRAMES, BRIGHT, Enterprise RAG, ESCI, Musique, MLQA ஆகியவை இருந்ததாகவும், ஒவ்வொரு dataset-இன் பயிற்சி எடுத்துக்காட்டுகளில் ஐந்து சதவீதம் validation-க்காக ஒதுக்கப்பட்டதாகவும் blog கூறுகிறது. holdout test set-இல் FreshStack, WixQA, BrowseComp-Plus, Wands இருந்தன. குழு சேவையளிக்கத் திட்டமிடும் தனிப்பட்ட corpus மற்றும் query விநியோகத்தில் செய்யும் மதிப்பீட்டுக்கு இந்தப் பொது அல்லது synthetic dataset-கள் மாற்றாகாது.
சிறிய, ஆய்வு செய்யக்கூடிய job-ஐ சமர்ப்பிக்கவும்
அந்த அக்டோபர் 2 AWS வலைப்பதிவு code snippet-இல் வேறு SDK import மற்றும் argument பெயர்களைப் பயன்படுத்துகிறது. தற்போதைய SageMaker training-job reference Bedrock AgentCore runtime-க்கான API வடிவத்தைக் காட்டுகிறது. இந்த எடுத்துக்காட்டு AWS ஆவணங்களில் உள்ள தற்போதைய GPT-OSS-20B model identifier-ஐப் பயன்படுத்துகிறது. இலக்கு பிராந்தியத்தில் கிடைக்கும் மாதிரியைத் தேர்ந்தெடுத்து, எடுத்துக்காட்டை மாற்றுவதற்கு முன் தற்போதைய ஆதரவு அட்டவணையைப் பாருங்கள். தற்போதைய எடுத்துக்காட்டுக்கு MLflow app ARN, role ARN மற்றும் EULA ஒப்புதல் ஆகியவையும் தேவை.
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer

trainer = MultiTurnRLTrainer(
    model="openai-reasoning-gpt-oss-20b",
    agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
    training_dataset="s3://my-bucket/prompts/prompts.parquet",
    mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
    s3_output_path="s3://my-bucket/output/",
    role="arn:aws:iam::123456789012:role/SageMakerRole",
    accept_eula=True,
)

trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
இது AWS-இன் தற்போதைய ஆவண எடுத்துக்காட்டு; BIG CHANGE சோதித்த command அல்ல. அக்டோபர் 2 AWS வலைப்பதிவு வேறு sagemaker.modules.train import, model_id, agent_endpoint, training_dataset_s3_uri மற்றும் output_s3_uri arguments-ஐக் காட்டுகிறது. இவை தற்போதைய job வழிகாட்டியிலிருந்து வேறுபடுவதால், புதிய செயலாக்கத்திற்கு தற்போதைய reference-ஐப் பின்பற்றி உங்கள் சூழலில் SDK பதிப்பையும் மாதிரித் தேவைகளையும் சரிபார்க்கவும்; blog எடுத்துக்காட்டு பழைய SDK பதிப்பையா அல்லது ஆவண முரண்பாட்டையா பிரதிபலிக்கிறது என்று நாங்கள் முடிவு செய்யவில்லை. Studio UI-யும் ஆவணப்படுத்தப்பட்ட சமர்ப்பிப்பு வழி: ஆதரிக்கப்படும் JumpStart model-ஐத் தேர்ந்தெடுத்து, Multi-Turn Reinforcement Learning-ஐத் தேர்வு செய்து, AgentCore runtime அல்லது Lambda forwarder-ஐ அமைத்து, பயிற்சித் தரவை வழங்கி சமர்ப்பிக்கவும்.
முதல் ஓட்டத்தில் மாதிரி, பிராந்தியம், dataset பதிப்பு, reward, வரம்புகள், hyperparameters, வெளியீட்டுப் பாதை ஆகியவற்றைப் பதிவு செய்யுங்கள்; பின்னர் அதே baseline-உடன் ஒப்பிடலாம். வாடிக்கையாளர் நிர்வகிக்கும் VPC பயன்படுத்தினால் AWS-இன் தனி VPC வழிகாட்டி இரண்டு Availability Zone-களில் private subnet-கள், S3 மற்றும் CloudWatch Logs-க்கான VPC endpoint-கள், தேவைக்கேற்ப AgentCore அல்லது Lambda endpoint ஆகியவற்றைக் குறிப்பிடுகிறது; பயன்படுத்தினால் MLflow-க்கும் endpoint தேவை. Execution role-க்கு ENI நிர்வாக அனுமதி வேண்டும். விருப்பமான customer-managed KMS முறைக்கு அழைப்பவர், execution role, runtime ஆகியவற்றுக்கான கூடுதல் அனுமதிகளும் key-policy அமைப்பும் தேவை; இயல்பாக ஓய்விலுள்ள தரவு AWS-க்குச் சொந்தமான KMS key மூலம் encrypt செய்யப்படுகிறது. இவ்வமைப்புகளில் ஒன்றைப் பயன்படுத்தும் முன் VPC மற்றும் encryption வழிகாட்டிகளைப் படிக்கவும். சமர்ப்பிப்புக்கு முன் கணக்கு quotas-ஐப் பாருங்கள்: இயல்பாக ஒரே நேரத்தில் ஒரு MTRL fine-tuning job மற்றும் ஒரு evaluation job என AWS குறிப்பிடுகிறது; Service Quotas மூலம் இரண்டையும் மாற்றலாம். Job-management API throttling வரம்புகளை மாற்ற இயலாது.
deploy செய்வதற்கு முன் holdout prompts மூலம் மதிப்பிடுங்கள்
evaluation prompts-ஐ பயிற்சியிலிருந்து விலக்கி வைக்கவும், அதே prompt format-ஐப் பயன்படுத்தவும், முக்கியமான கருவிகளையும் அவற்றின் சேர்க்கைகளையும் உள்ளடக்கவும், முன்பு தோல்வியடைந்த வழக்குகளைச் சேர்க்கவும், ரகசியத் தகவலைப் பாதுகாக்கவும் என AWS மதிப்பீட்டு ஆவணங்கள் கூறுகின்றன. SageMaker evaluator prompt set-இல் candidate-ஐ இயக்கி reward, pass@k, trajectory metrics ஆகியவற்றைத் தரலாம். fine-tuned model-ஐ மதிப்பிடுவதையும், அதே comparison pipeline-இல் base model-ஐ விருப்பமாக மதிப்பிடுவதையும் ஆவணங்கள் காட்டுகின்றன.
பயிற்சிக்கு முன் evaluation protocol-ஐ நிர்ணயிக்கவும். live agent சந்திக்கும் queries, permissions, ஆவண மாற்றங்களைப் பிரதிபலிக்கும் நிலையான holdout set வைத்திருக்கவும். அதே கருவிகள், வரம்புகள், scoring code கொண்டு base மற்றும் fine-tuned model-களை ஒப்பிடவும். சராசரி retrieval score மட்டும் அல்லாமல் task failure, turn எண்ணிக்கை, latency, token பயன்பாடு, தொடர்புடைய ஆவணங்கள் உயர்ந்த முடிவுகளிலிருந்து மறையும் நிகழ்வுகளையும் ஆராயவும். AWS evaluation job-ஐ எவ்வாறு சமர்ப்பிப்பது என்பதை ஆவணங்கள் விளக்குகின்றன; ஒரே metric production தேடல் தரத்தை முழுமையாக அளக்கும் என்று அவை நிரூபிக்கவில்லை.
AWS இடுகை இந்த holdout முடிவுகளைத் தெரிவிக்கிறது:
Dataset (கேள்விகள்) | Base nDCG@10 | Fine-tuned nDCG@10 | Base தோல்வி விகிதம் | Fine-tuned தோல்வி விகிதம் |
|---|---|---|---|---|
WixQA (400) | 0.5725 | 0.6781 | 0.67% | 0.17% |
Wands (147) | 0.5762 | 0.6112 | 0.00% | 0.00% |
FreshStack (672) | 0.4112 | 0.4089 | 0.20% | 0.05% |
BrowseComp-Plus (830) | 0.5136 | 0.6354 | 22.89% | 0.68% |
அட்டவணையில் nDCG@10 மூன்று இடங்களில் உயர்ந்தும் FreshStack-இல் சிறிது குறைந்தும் உள்ளது. turn அல்லது token வரம்பை எட்டுவதற்கான penalty காரணமாக BrowseComp-Plus தோல்வி விகிதம் குறைந்ததாக AWS கூறுகிறது. இந்த எண்ணிக்கைகளுடன் confidence interval அல்லது statistical significance analysis-ஐ blog வழங்கவில்லை. fine-tuned model WixQA-வில் சராசரியாக 4.5 vs 4.3 turns, Wands-இல் 2.9 vs 2.2 turns பயன்படுத்தியதாகவும் தெரிவிக்கிறது; ஆகவே எல்லா இடங்களிலும் turns குறையவில்லை. இதை vendor தெரிவித்த பரிசோதனையாகப் பாருங்கள்; சுயாதீன சரிபார்ப்பாகவோ வேறு corpus-லும் முன்னேற்றம் ஏற்படும் என்பதற்கான சான்றாகவோ அல்ல.
முழுச் சோதனைக்கான செலவை கணக்கிடுங்கள்
AWS MTRL ஆவணம் பயிற்சிக்கான மூன்று billing கூறுகளைக் குறிப்பிடுகிறது: input ஆக process செய்யப்பட்ட prefill tokens, rollout-களில் உருவான sampled tokens, training updates. விலைப் பக்கம் மாதிரிவாரியான கட்டணங்களைத் தருகிறது; அந்தக் கட்டணங்களுடன் rollout அளவு, sequence lengths, epochs, runtime ஆகியவை மதிப்பீட்டை நிர்ணயிக்கின்றன. எடுத்துக்காட்டு கட்டுரையில் மொத்த bill இல்லை; ஆவணங்களும் எல்லா இடத்திற்குமான ஒரே trial விலையைத் தரவில்லை. தேர்ந்தெடுத்த மாதிரி மற்றும் பிராந்தியத்திற்கான தற்போதைய கட்டணத்தைப் பார்த்து, நிலையான செலவை ஊகிக்காமல் எதிர்பார்க்கப்படும் job பயன்பாட்டின் அடிப்படையில் கணக்கிடுங்கள்.
மதிப்பீட்டில் தொடர்புடைய செலவுகளையும் சேர்க்கவும்: training, validation, checkpoints, output artifacts-க்கான S3 storage மற்றும் requests; rollout நேரத்தில் AgentCore runtime அல்லது Lambda மற்றும் துணைத் தேடல் அமைப்பு; logging மற்றும் MLflow; holdout evaluation; பயிற்சிக்குப் பிறகு பயன்படுத்தப்படும் endpoint அல்லது Bedrock deployment. தொடர்ந்து கட்டணம் வராமல் இருக்க இயங்கும் MTRL job-ஐ நிறுத்தவோ நீக்கவோ, தேவையற்ற S3 model artifact-களை அகற்றவோ, evaluation endpoint-களை நீக்கவோ AWS இடுகை குறிப்பாகப் பரிந்துரைக்கிறது. Endpoint deployment என்பது பயிற்சியிலிருந்து வேறான முடிவும் செலவுப் பிரிவும் ஆகும்.
தொடர வேண்டுமா என முடிவெடுக்கவும்
பல சார்ந்த tool call-கள் தேவைப்படும், இறுதி முடிவை குழு மதிப்பிடக்கூடிய தேடல் பணிக்கு இந்த workflow அதிகம் பொருந்தும். ஆதரிக்கப்படும் model-region இணை, செயல்படும் agent integration, பிரதிநிதித்துவ prompt data, பணியை பிரதிபலிக்கும் reward, holdout ஒப்பீடு, துணைச் சேவைகளையும் உள்ளடக்கிய செலவுக் கணக்கு இருந்தால்தான் சோதனை முடிவெடுக்க உதவும். AWS-இன் நான்கு benchmark-களில் நல்ல முடிவு வந்தது இந்த முறையை ஆராய்வதற்கான காரணம்; வேறு index, query mix அல்லது permission எல்லையிலும் அதே விளைவு வரும் என ஊகிப்பதற்கல்ல.
ஆதாரங்களும் மேலும் வாசிப்பும்
- AWS Machine Learning Blog: “Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI” (2026 அக்டோபர் 2) — வழங்குநரின் வழிகாட்டி, அமைப்பு, dataset தேர்வுகள், தெரிவிக்கப்பட்ட மதிப்பீட்டு முடிவுகள்.
- Amazon SageMaker AI: Multi-turn reinforcement learning — தற்போதைய ஆதரவு மாதிரிகள், பிராந்தியங்கள், workflow சுருக்கம், பயிற்சி billing கூறுகள்.
- முன்நிபந்தனைகள், உங்கள் முகவரைத் தயாரித்தல், VPC அமைப்பு மற்றும் ஓய்விலுள்ள தரவின் encryption — அனுமதிகள், runtime தேர்வுகள், integration, விருப்பமான network மற்றும் encryption அமைப்பு.
- assets உருவாக்கம், training job சமர்ப்பிப்பு, மதிப்பீடு, hyperparameters மற்றும் quotas — செயலாக்கத்திற்கான தற்போதைய குறிப்புகள்.
- SageMaker AI விலை — மாதிரி தனிப்பயனாக்கத்தின் தற்போதைய கட்டண விவரங்கள்; மாதிரி மற்றும் பிராந்தியத்தைப் பொறுத்து கட்டணங்கள் மாறும்.
அறிக்கை குறிப்பு: ஆவண மதிப்பாய்வு மட்டுமே செய்யப்பட்டது. BIG CHANGE AWS கணக்கை அணுகவில்லை, SageMaker job சமர்ப்பிக்கவோ ஆய்வு செய்யவோ இல்லை, AWS API-களை அழைக்கவில்லை, அறிக்கையிடப்பட்ட metrics-ஐ சுயாதீனமாக மீண்டும் உருவாக்கவில்லை. செயலாக்க வழிகாட்டியையும் பரிசோதனை முடிவுகளையும் AWS தானே வழங்கியது.