Perubahan besar
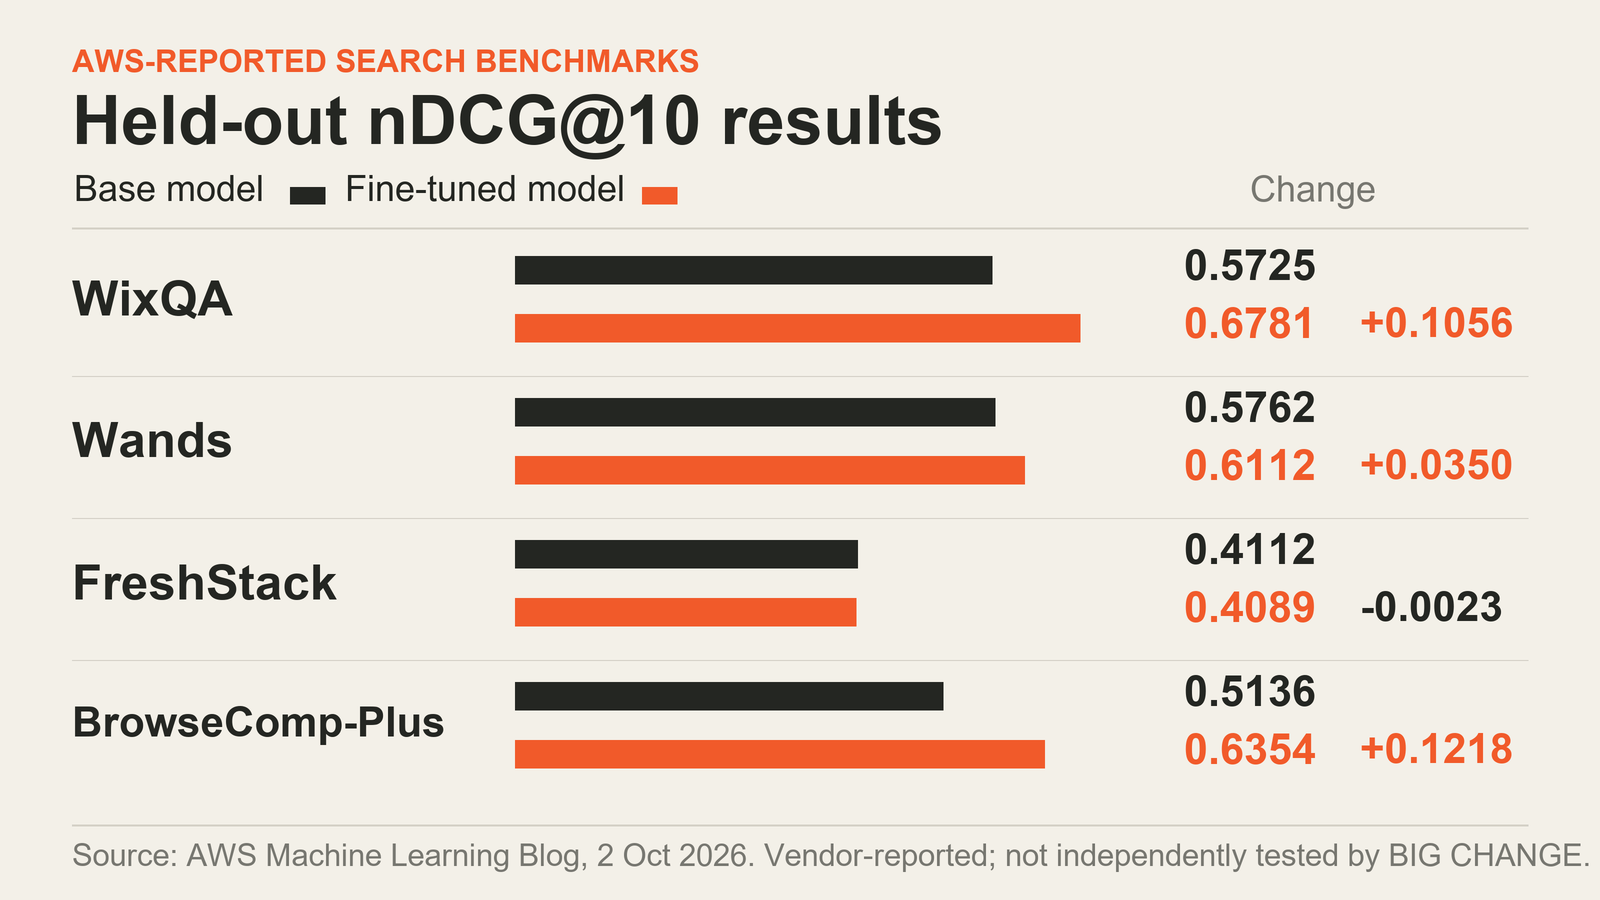
Dalam panduan 2 Oktober, AWS menjelaskan fine-tuning agen pencarian Qwen3.6-27B dengan pembelajaran penguatan multi-giliran (MTRL) di SageMaker AI. Bagan di atas memuat skor nDCG@10 pada set uji yang disisihkan menurut laporan AWS: skornya naik pada WixQA, Wands, dan BrowseComp-Plus, tetapi sedikit turun pada FreshStack. BIG CHANGE membuat bagan dari angka AWS; kami tidak menguji agen secara mandiri atau mereproduksi hasilnya. Teknik ini melatih model berdasarkan hasil rangkaian keputusan yang menggunakan alat.
Sebelum mengirimkan job, engineer machine learning perlu memastikan model dan Region-nya didukung, agen dapat berpartisipasi dalam rollout loop SageMaker, prompt dan reward mewakili tugas pencarian yang dituju, serta set evaluasi terpisah dapat mengungkap penurunan kinerja. Panduan ini merujuk pada dokumentasi AWS; BIG CHANGE tidak menjalankan job AWS atau memanggil API-nya.
Perubahan MTRL pada loop pelatihan
Dalam supervised fine-tuning, tim memerlukan contoh trajectory yang menunjukkan perilaku yang diinginkan. Dalam penjelasan AWS tentang MTRL, SageMaker justru mengirim prompt ke agen; dalam beberapa giliran, agen memanggil policy model dan alatnya, lalu melaporkan reward setelah rollout selesai. Model diperbarui berdasarkan umpan balik tersebut. Untuk pencarian, reward dapat menilai peringkat akhir sehingga pilihan kueri awal dioptimalkan dalam konteks keseluruhan sesi pencarian.
Perbedaan ini penting ketika pemanggilan alat bergantung pada hasil sebelumnya. Jika model membuat kueri pertama yang buruk, menerima hasil lemah, lalu perlu merumuskannya ulang, reward di akhir tugas dapat menunjukkan apakah rangkaian langkah tersebut akhirnya menemukan dokumen yang relevan. Namun, tim tetap harus mendefinisikan arti ‘relevan’ dan membuat agen yang dapat memanggil alat pencariannya.
Periksa akses, model, dan Region terlebih dahulu
Contoh 2 Oktober dijalankan di Region US West (Oregon), us-west-2, dan menggunakan fine-tuning Qwen3.6-27B. Tabel model MTRL SageMaker yang didukung, yang diperiksa pada 4 Oktober 2026, mencantumkan empat model dalam enam pasangan model-Region: Nova Lite 2.0 dan GPT-OSS-20B di US East (N. Virginia), us-east-1, serta US West (Oregon), us-west-2; Gemma-4-31B-it dan Qwen 3.6 27B hanya didukung di Oregon. Periksa tabel terkini di Region tempat Anda akan membuat job; tercantumnya model tidak membuktikan bahwa model tersedia di Region lain.
Tim juga memerlukan akun AWS dan domain SageMaker Studio jika menggunakan antarmuka Studio, akses S3 untuk dataset dan output, serta IAM role yang dikonfigurasi untuk job MTRL terbaru dan pemanggilan runtime. Dokumen prasyarat AWS menyebut pemanggil memerlukan CreateJob dan tindakan job terkait, serta izin untuk meneruskan execution role ke job.sagemaker.amazonaws.com. Execution role memerlukan kebijakan AmazonSageMakerJobFullAccess dan service principal tersebut di trust policy-nya. Role runtime agen memerlukan AmazonSageMakerJobRuntimeAccess; runtime AgentCore juga memerlukan hubungan kepercayaannya sendiri. Pemilih runtime di Studio memerlukan izin untuk mencantumkan AgentCore. Menurut AWS, akses SageMaker luas yang sudah dimiliki belum mencakup semua tindakan job baru ini.
Dokumentasi menjelaskan dua jalur agen. Deploy ke Bedrock AgentCore untuk hosting terkelola—AWS menyebut jalur ini paling sesuai bagi agen yang dibuat dengan Strands—atau host agen khusus dan hubungkan melalui Lambda forwarder. Agen menerima prompt rollout, memanggil policy model melalui runtime job SageMaker, menggunakan alat pencariannya, menyelesaikan setiap rollout, lalu melaporkan reward. Dekorator SDK AWS menangani sebagian besar integrasi ini; framework khusus dapat memanggil API runtime secara langsung. Jika nama fungsi Lambda tidak mengikuti pola standar, AWS menyebut ARN-nya mungkin perlu ditambahkan secara eksplisit ke kebijakan izin. VPC atau kunci KMS yang dikelola pelanggan menambah kebutuhan penyiapan.
Siapkan prompt dan reward untuk tugas pencarian yang sebenarnya
Panduan aset SageMaker menerima Parquet, JSON Lines, JSON, atau CSV. Panduan ini mencari kolom bernama prompt; jika kolom itu tidak ada, kolom pertama digunakan dan nilainya diteruskan ke agen apa adanya. Layanan tidak mengurai, memvalidasi, atau mengubah konten prompt. Untuk pencarian yang menggunakan alat, prompt dapat memuat pesan percakapan, metadata tugas, spesifikasi reward, dan konfigurasi alat dalam format yang diharapkan agen. AWS memperingatkan bahwa prompt diteruskan tanpa pemeriksaan, sehingga perlindungan data sensitif tetap menjadi tanggung jawab tim; terapkan enkripsi atau perlindungan lain yang sesuai pada penyimpanan dan jalur menuju agen.
Reward adalah sasaran yang akan dioptimalkan model. Contoh AWS menggunakan nDCG@10 pada dokumen hasil pencarian akhir dan memberikan reward -1 ketika agen mencapai batas giliran atau token sampling. Ini titik awal konkret untuk tugas retrieval berperingkat, tetapi membuat pilihan evaluasi menjadi penting: tim memerlukan label relevansi yang andal atau metode penilaian lain yang dapat dipertanggungjawabkan. Pastikan juga reward tidak mendorong peningkatan peringkat yang dangkal hingga mengorbankan kualitas jawaban, latensi, atau biaya alat.
Tulisan blog menyebut campuran pelatihannya mencakup FRAMES, BRIGHT, Enterprise RAG, ESCI, Musique, dan MLQA; lima persen instans pelatihan dari setiap dataset disisihkan untuk validasi. Set uji yang disisihkan terdiri atas FreshStack, WixQA, BrowseComp-Plus, dan Wands. Dataset publik atau sintetis tersebut tidak menggantikan evaluasi pada korpus privat dan distribusi kueri yang akan dilayani tim.
Kirim job kecil yang mudah diperiksa
Tulisan blog AWS tanggal 2 Oktober menggunakan import SDK dan nama argumen yang berbeda dalam cuplikan kodenya. Referensi job pelatihan SageMaker yang berlaku menunjukkan bentuk API berikut untuk runtime Bedrock AgentCore. Contoh ini menggunakan identifier model GPT-OSS-20B terkini yang tercantum dalam dokumentasi AWS. Pilih model yang tersedia di Region sasaran dan periksa tabel model yang didukung saat ini sebelum menyesuaikan contoh. Contoh terbaru juga memerlukan ARN aplikasi MLflow, ARN role, dan persetujuan EULA.
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer

trainer = MultiTurnRLTrainer(
    model="openai-reasoning-gpt-oss-20b",
    agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
    training_dataset="s3://my-bucket/prompts/prompts.parquet",
    mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
    s3_output_path="s3://my-bucket/output/",
    role="arn:aws:iam::123456789012:role/SageMakerRole",
    accept_eula=True,
)

trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
Ini contoh dari dokumentasi AWS terkini, bukan perintah yang diuji BIG CHANGE. Blog AWS 2 Oktober menggunakan sagemaker.modules.train import, model_id, agent_endpoint, training_dataset_s3_uri dan output_s3_uri sebagai argumen. Karena berbeda dari panduan job terkini, gunakan referensi terkini untuk implementasi baru dan periksa versi SDK serta persyaratan model di lingkungan Anda sendiri; kami belum memastikan apakah contoh blog itu memakai revisi SDK yang lebih lama atau mencerminkan ketidakkonsistenan dokumentasi. UI Studio juga merupakan jalur pengiriman yang didokumentasikan: pilih model JumpStart yang didukung, pilih Multi-Turn Reinforcement Learning, atur runtime AgentCore atau Lambda forwarder, berikan data pelatihan, lalu kirimkan job.
Untuk percobaan pertama, catat model, Region, versi dataset, reward, batas, hyperparameter, dan lokasi output agar evaluasi berikutnya dapat dibandingkan dengan baseline yang sama. Jika menggunakan VPC yang dikelola pelanggan, panduan VPC AWS yang terpisah menetapkan subnet privat di dua Availability Zone, VPC endpoint untuk S3 dan CloudWatch Logs, serta endpoint AgentCore atau Lambda bila diperlukan; MLflow juga membutuhkan endpoint jika digunakan. Execution role memerlukan izin pengelolaan ENI. Jalur KMS yang dikelola pelanggan bersifat opsional dan memerlukan izin tambahan serta penyiapan key policy bagi pemanggil, execution role, dan runtime; secara default, data saat tidak digunakan dienkripsi dengan kunci KMS milik AWS. Baca panduan VPC dan enkripsi sebelum menggunakan konfigurasi tersebut. Sebelum mengirim, periksa kuota akun: secara default AWS mencantumkan satu job fine-tuning MTRL serentak dan satu job evaluasi serentak; keduanya dapat diubah melalui Service Quotas. Batas throttling API pengelolaan job tidak dapat diubah.
Evaluasi dengan prompt yang disisihkan sebelum deployment
Dokumentasi evaluasi AWS menyarankan agar prompt evaluasi tidak digunakan dalam pelatihan, format prompt tetap sama, alat penting dan kombinasinya tercakup, kasus yang sebelumnya gagal disertakan, dan konten sensitif dilindungi. Evaluator SageMaker dapat menjalankan kandidat pada kumpulan prompt dan melaporkan reward, pass@k, serta metrik trajectory. Dokumentasinya menunjukkan evaluasi model yang telah di-fine-tune dan, secara opsional, evaluasi model dasar dalam pipeline perbandingan yang sama.
Tetapkan protokol evaluasi sebelum pelatihan. Gunakan set uji tetap yang disisihkan dan mewakili kueri, izin, serta perubahan dokumen yang akan dihadapi agen aktif. Bandingkan model dasar dan model yang di-fine-tune dengan alat, batas, dan kode penilaian yang sama. Periksa bukan hanya skor retrieval rata-rata, tetapi juga kegagalan tugas, jumlah giliran, latensi, penggunaan token, dan kasus ketika dokumen relevan tidak lagi muncul pada peringkat teratas. Dokumentasi menjelaskan cara mengirim job evaluasi AWS; dokumentasi itu tidak membuktikan bahwa satu metrik saja cukup untuk menggambarkan kualitas pencarian di produksi.
Tulisan AWS melaporkan hasil berikut pada set uji yang disisihkan:
Dataset (pertanyaan) | nDCG@10 dasar | nDCG@10 setelah fine-tuning | Tingkat kegagalan dasar | Tingkat kegagalan setelah fine-tuning |
|---|---|---|---|---|
WixQA (400) | 0.5725 | 0.6781 | 0.67% | 0.17% |
Wands (147) | 0.5762 | 0.6112 | 0.00% | 0.00% |
FreshStack (672) | 0.4112 | 0.4089 | 0.20% | 0.05% |
BrowseComp-Plus (830) | 0.5136 | 0.6354 | 22.89% | 0.68% |
Tabel menunjukkan tiga kenaikan nDCG@10 dan satu penurunan kecil pada FreshStack. AWS mengaitkan tingkat kegagalan BrowseComp-Plus yang lebih rendah dengan penalti saat agen mencapai batas giliran atau token. Blog tersebut tidak menyertakan interval kepercayaan atau analisis signifikansi statistik untuk angka-angka ini. Blog juga melaporkan bahwa model yang di-fine-tune menggunakan rata-rata 4.5 dibanding 4.3 giliran pada WixQA dan 2.9 dibanding 2.2 pada Wands; jadi, jumlah giliran tidak selalu berkurang. Perlakukan hasil ini sebagai eksperimen yang dilaporkan vendor, bukan validasi independen atau bukti bahwa korpus lain juga akan meningkat.
Perhitungkan seluruh biaya uji coba
Dokumentasi MTRL AWS menyebut tiga komponen biaya pelatihan: token prefill yang diproses sebagai input, token sampling yang dihasilkan selama rollout, dan pembaruan pelatihan. Halaman harga mencantumkan tarif untuk tiap model; tarif tersebut serta volume rollout, panjang urutan, epoch, dan runtime menentukan estimasinya. Artikel contoh tidak mencantumkan total tagihan dan dokumentasi tidak memberikan satu harga uji coba yang berlaku umum. Periksa tarif terkini untuk model dan Region yang dipilih, lalu buat estimasi berdasarkan penggunaan job yang diperkirakan, bukan asumsi biaya tetap.
Masukkan juga biaya terkait ke dalam estimasi: penyimpanan dan permintaan S3 untuk pelatihan, validasi, checkpoint, dan artefak output; runtime AgentCore atau Lambda beserta infrastruktur pencarian pendukung selama rollout; logging dan MLflow; evaluasi pada data yang disisihkan; serta endpoint atau deployment Bedrock setelah pelatihan. Tulisan AWS secara khusus menyarankan untuk menghentikan atau menghapus job MTRL yang masih berjalan, menghapus artefak model S3 yang tidak diperlukan, dan membuang endpoint evaluasi agar biaya tidak terus berjalan. Deployment endpoint merupakan keputusan dan kategori biaya terpisah dari pelatihan.
Putuskan apakah akan melanjutkan
Alur ini paling relevan ketika tugas pencarian memerlukan beberapa pemanggilan alat yang saling bergantung dan tim dapat menilai hasil akhirnya. Uji coba baru berguna untuk mengambil keputusan jika pasangan model-Region didukung, integrasi agen berfungsi, data prompt representatif, reward mencerminkan tugas, tersedia perbandingan dengan set uji yang disisihkan, dan estimasi biaya mencakup layanan pendukung. Hasil yang kuat pada empat benchmark AWS menjadi alasan untuk mengkaji metodenya, bukan untuk mengasumsikan dampak yang sama pada indeks, campuran kueri, atau batas izin yang berbeda.
Sumber dan bacaan lanjutan
- AWS Machine Learning Blog: “Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI” (2 Oktober 2026) — panduan vendor, penyiapan, pilihan dataset, dan hasil evaluasi yang dilaporkan.
- Amazon SageMaker AI: Multi-turn reinforcement learning — model dan Region yang saat ini didukung, gambaran alur kerja, dan komponen tagihan.
- Prasyarat, Menyiapkan agen, Konfigurasi VPC dan enkripsi saat tidak digunakan — izin, pilihan runtime, integrasi, serta penyiapan jaringan dan enkripsi opsional.
- Membuat aset, mengirim job pelatihan, evaluasi, hyperparameter dan kuota — referensi implementasi terkini.
- Harga SageMaker AI — rincian harga kustomisasi model saat ini; tarif berubah dan berbeda menurut model serta Region.
Catatan pelaporan: Hanya dokumentasi yang ditinjau. BIG CHANGE tidak mengakses akun AWS, mengirim atau memeriksa job SageMaker, memanggil API AWS, ataupun mereproduksi metrik yang dilaporkan secara mandiri. AWS menulis panduan implementasi dan melaporkan eksperimennya sendiri.