大きな変化
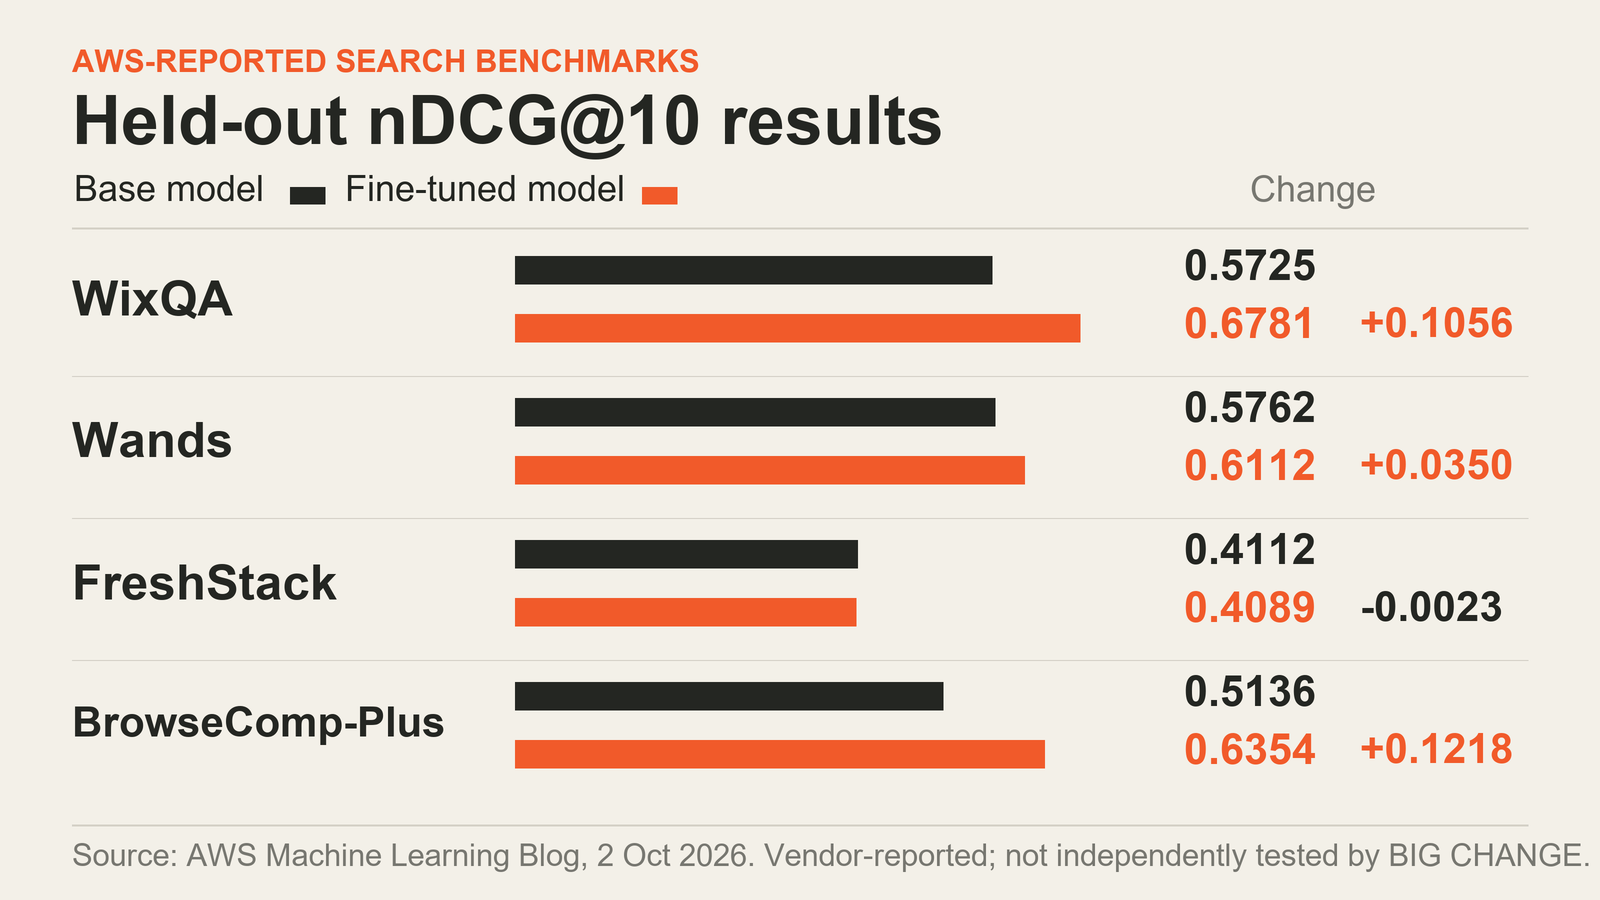
AWSは10月2日の解説記事で、SageMaker AI上のマルチターン強化学習(MTRL)を使ってQwen3.6-27B検索エージェントをファインチューニングする方法を説明しています。上のグラフは、AWSが報告した学習に使っていないデータでのnDCG@10スコアを示しています。WixQA、Wands、BrowseComp-Plusでは上昇し、FreshStackではわずかに低下しました。BIG CHANGEはAWSの数値からグラフを作成しました。エージェントを独自にテストしたり、結果を再現したりはしていません。この手法では、ツールを使う一連の判断の結果に基づいてモデルを学習させます。
ジョブを送信する前に、機械学習エンジニアはモデルとリージョンが対応していること、エージェントがSageMakerのロールアウトループに参加できること、プロンプトと報酬が想定する検索タスクを表していること、そして別個の評価セットで性能低下を検出できることを確認する必要があります。本ガイドはAWSのドキュメントに基づいています。BIG CHANGEはAWSのジョブを実行しておらず、APIも呼び出していません。
MTRLが学習ループをどう変えるか
教師ありファインチューニングでは、目標の挙動を示す軌跡の例をチームが用意する必要があります。一方、AWSのMTRLの説明では、SageMakerがエージェントにプロンプトを送り、エージェントが複数のターンにわたってポリシーモデルやツールを呼び出し、ロールアウト完了後に報酬を返します。モデルはそのフィードバックを使って更新されます。検索の場合、最終的なランキングを報酬で評価できるため、初期のクエリ選択も検索エピソード全体を踏まえて最適化されます。
先行する結果にツール呼び出しが依存する場合、この違いが重要になります。モデルが最初のクエリをうまく作れず、検索結果も乏しいためにクエリを練り直すべき場合、タスク終了時の報酬によって、一連の処理が最終的に関連文書を取得できたかを評価できます。ただし、「関連性」の意味を定義する必要は残りますし、チームの検索ツールを呼び出せるエージェントも別途構築しなければなりません。
まずアクセス権、モデル、リージョンを確認する
10月2日の例は米国西部(オレゴン)で実行され、us-west-2、Qwen3.6-27Bをファインチューニングしました。SageMaker MTRLの対応モデル一覧(2026年10月4日確認)には、6つのモデルとリージョンの組み合わせに4モデルが掲載されています。Nova Lite 2.0とGPT-OSS-20Bは米国東部(バージニア北部)、us-east-1および米国西部(オレゴン)に対応し、us-west-2Gemma-4-31B-itとQwen 3.6 27Bはオレゴンのみです。ジョブを作成する予定のリージョンで最新の一覧を確認してください。モデルが一覧に載っていても、他の地域で利用できるとは限りません。
チームにはAWSアカウントが必要です。Studioのインターフェースを使う場合はSageMaker Studioドメインも必要です。また、データセットと出力用のS3アクセスに加え、新しいMTRLジョブやランタイム呼び出しに対応したIAMロールを設定する必要があります。AWSの前提条件ドキュメントによると、呼び出し側にはCreateJobおよび関連するジョブ操作の権限と、実行ロールをjob.sagemaker.amazonaws.comに渡す権限が必要です。実行ロールにはAmazonSageMakerJobFullAccessポリシーが必要で、信頼ポリシーにサービスプリンシパルを含めなければなりません。エージェントのランタイムロールにはAmazonSageMakerJobRuntimeAccessが必要です。AgentCoreランタイムにも独自の信頼関係設定が必要です。Studioのランタイム選択にはAgentCoreの一覧表示権限が必要です。AWSによれば、従来の広範なSageMakerアクセス権だけでは、これらの新しいジョブ操作は許可されません。
ドキュメントには、エージェントの接続方法が2つ記載されています。Bedrock AgentCoreでデプロイしてマネージドホスティングを使う方法は、Strandsで構築したエージェントに最適だとAWSは説明しています。もう1つは、カスタムエージェントをホストし、Lambdaフォワーダーを介して接続する方法です。エージェントはロールアウト用プロンプトを受け取り、ジョブのランタイムを介してポリシーモデルを呼び出し、検索ツールを実行し、各ロールアウトを完了して報酬を返します。AWSのSDKデコレーターが連携処理の多くを担いますが、独自フレームワークからランタイムAPIを直接呼び出すこともできます。Lambda関数に標準以外の名前を使う場合、権限ポリシーにARNを明示的に追加する必要があるとAWSは説明しています。カスタマーマネージドVPCやKMSキーを使う場合は、追加の設定も必要です。
実際の検索タスクに合わせてプロンプトと報酬を準備する
SageMakerのアセットガイドはParquet、JSON Lines、JSON、CSVを受け付けます。名前がpromptの列を探し、見つからなければ先頭の列にフォールバックして、その値をそのままエージェントに渡します。サービスはプロンプトの内容を解析、検証、変換しません。ツールを使う検索の場合、プロンプトには会話メッセージ、タスクのメタデータ、報酬の仕様、ツール設定などを、エージェントが想定する形式で含められます。AWSはプロンプトを検査せずに受け渡すと警告しています。そのため、機密データの保護はチームの責任です。ストレージとエージェントへの経路に、暗号化など適切な保護策を設計してください。
報酬は、モデルが最適化する目標です。AWSの例では、最終的に取得した文書をnDCG@10で評価し、エージェントがターン数またはサンプリングトークンの上限に達した場合は-1の報酬を与えます。ランキング検索タスクに使える具体的な出発点ですが、評価方法は重要な影響を及ぼします。チームには信頼できる関連性ラベルなど、妥当な採点方法が必要です。また、ランキングの表面的な改善を優先するあまり、回答品質、遅延、ツールのコストを損なう報酬になっていないか確認してください。
ブログによると、学習データにはFRAMES、BRIGHT、Enterprise RAG、ESCI、Musique、MLQAが含まれ、各データセットの学習用インスタンスの5%を検証用に確保しました。学習に使っていないテストセットはFreshStack、WixQA、BrowseComp-Plus、Wandsで構成されていました。こうした公開データや合成データは、チームが実際にサービスを提供する予定の非公開コーパスとクエリ分布での評価に代わるものではありません。
小さく、検証しやすいジョブを送信する
AWSのでは、コード例で異なるSDKのインポート方法と引数名を使っています。現在ののコード例では、SDKのインポート方法と引数名が異なります。現在のSageMakerトレーニングジョブのリファレンスには、Bedrock AgentCoreランタイム向けのAPI形式が掲載されています。次の例は、AWSの現行ドキュメントに記載されたGPT-OSS-20Bのモデル識別子を使用しています。対象リージョンで利用できるモデルを選び、例を変更する前に最新の対応モデル一覧を確認してください。現行の例では、MLflowアプリケーションARN、ロールARN、EULAへの同意も必要です。
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer

trainer = MultiTurnRLTrainer(
    model="openai-reasoning-gpt-oss-20b",
    agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
    training_dataset="s3://my-bucket/prompts/prompts.parquet",
    mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
    s3_output_path="s3://my-bucket/output/",
    role="arn:aws:iam::123456789012:role/SageMakerRole",
    accept_eula=True,
)

trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
これはAWSの現行ドキュメントの例であり、BIG CHANGEがテストしたコマンドではありません。AWSの10月2日のブログでは、異なるsagemaker.modules.trainインポート文、model_id、agent_endpoint、training_dataset_s3_uri、output_s3_uriの各引数が使われています。現行のジョブガイドと異なるため、新たに実装する場合は現行のリファレンスに従い、自分の環境でSDKのバージョンとモデル要件を確認してください。ブログの例が旧バージョンのSDKを反映しているのか、ドキュメント間の不整合なのかは確認できていません。StudioのUIもドキュメントに記載された別の送信方法です。対応するJumpStartモデルを選択し、「Multi-Turn Reinforcement Learning」を指定してAgentCoreランタイムかLambdaフォワーダーを設定し、学習データを渡して送信します。
初回の実行では、モデル、リージョン、データセットのバージョン、報酬、制限、ハイパーパラメーター、出力先を記録し、後の評価を同じベースラインと比較できるようにしてください。カスタマーマネージドVPCを使う場合、AWSのVPCガイドでは2つのアベイラビリティーゾーンにまたがるプライベートサブネット、S3とCloudWatch LogsのVPCエンドポイント、および必要に応じたAgentCoreまたはLambdaのエンドポイントが指定されています。MLflowを使用する場合は、そのエンドポイントも必要です。実行ロールにはENI管理権限が必要です。任意のカスタマーマネージドKMSを使う場合、呼び出し側、実行ロール、ランタイムの追加権限とキーのポリシー設定が必要です。保存データはデフォルトでAWS所有のKMSキーにより暗号化されます。いずれかの構成を使う前にVPCと暗号化のガイドを確認してください。送信前にはアカウントのクォータも確認します。AWSではデフォルトでMTRLのファインチューニングジョブと評価ジョブを同時に1件ずつ実行でき、どちらもService Quotasから変更できます。ジョブ管理APIのスロットリング上限は変更できません。
デプロイ前に、学習に使っていないプロンプトで評価する
AWSの評価ドキュメントは、評価用プロンプトを学習に使わないこと、同じプロンプト形式を使うこと、重要なツールやツールの組み合わせを網羅すること、以前失敗したケースを含めること、機密情報を保護することを推奨しています。SageMakerの評価機能では、候補モデルに一連のプロンプトを実行し、報酬、pass@k、軌跡の指標をレポートできます。ドキュメントには、ファインチューニング済みモデルを評価する手順に加え、同じ比較パイプラインでベースモデルも任意で評価する方法が記載されています。
学習前に評価方法を決めてください。実運用のエージェントが直面するクエリ、権限、文書の変更を代表する、固定の未使用データセットを用意します。同じツール、制限、採点コードでベースモデルと微調整モデルを比較します。平均検索スコアだけでなく、タスク失敗、ターン数、遅延、トークン使用量、関連文書が上位から消えるケースも調べてください。AWSの評価ジョブを送信する方法はドキュメントで確認できますが、単一の指標だけで本番検索の品質を十分に把握できるとは示されていません。
AWSの記事では、学習に使っていないデータで次の結果が報告されています。
データセット(質問数) | ベースモデル nDCG@10 | 微調整モデル nDCG@10 | ベースモデルの失敗率 | 微調整モデルの失敗率 |
|---|---|---|---|---|
WixQA(400) | 0.5725 | 0.6781 | 0.67% | 0.17% |
Wands(147) | 0.5762 | 0.6112 | 0.00% | 0.00% |
FreshStack(672) | 0.4112 | 0.4089 | 0.20% | 0.05% |
BrowseComp-Plus(830) | 0.5136 | 0.6354 | 22.89% | 0.68% |
表では、nDCG@10が3つのデータセットで上昇し、FreshStackではわずかに低下しています。AWSは、BrowseComp-Plusの失敗率低下について、ターン数またはトークン上限に達した場合のペナルティによるものと説明しています。ブログには、この数値の信頼区間や統計的有意性の分析は示されていません。また、微調整モデルの平均ターン数は、WixQAで4.5回(ベースモデルは4.3回)、Wandsで2.9回(ベースモデルは2.2回)だったと報告されています。したがって、ターン数が常に減ったわけではありません。これはベンダーが報告した実験と捉えるべきで、独立した検証ではなく、別のコーパスでも改善する証拠でもありません。
試用全体の予算を立てる
AWSのMTRLドキュメントには、学習費用の内訳が3つ記載されています。入力として処理されるプレフィル・トークン、ロールアウトで生成されるサンプリング・トークン、そして学習の更新です。料金ページにはモデル別の単価が掲載されています。実際の見積もりは単価に加えて、ロールアウト量、シーケンス長、エポック数、実行時間によって決まります。記事の例では総費用が公表されておらず、ドキュメントにも一律の試用価格はありません。選んだモデルとリージョンの現在の単価を確認し、固定価格を想定せず、予想されるジョブの使用量から見積もってください。
見積もりには周辺コストも含めます。学習、検証、チェックポイント、出力アーティファクト用のS3ストレージとリクエスト、ロールアウト中のAgentCoreランタイムまたはLambda、および検索基盤などの関連サービス、ログとMLflow、未使用データでの評価、学習後に使うエンドポイントやBedrockのデプロイ費用です。AWSの記事は、継続課金を防ぐため、実行中のMTRLジョブを停止または削除し、不要なS3モデルアーティファクトを削除し、評価用エンドポイントも削除するよう特に勧めています。エンドポイントのデプロイは、学習とは別の判断であり、別のコスト区分です。
進めるかどうかを判断する
このワークフローは、検索タスクで複数の依存するツール呼び出しが必要で、チームが最終結果を採点できる場合に特に適しています。対応モデルとリージョンの組み合わせが利用可能で、エージェント連携が機能し、プロンプトデータが代表性を備え、報酬がタスクを正しく反映し、学習に使っていないデータとの比較ができ、周辺サービスも含む費用見積もりがある場合に限り、試用結果は判断材料になります。AWSの4つのベンチマークで良好な結果が出たことは手法を詳しく調べる理由にはなりますが、別のインデックス、クエリ構成、権限境界でも同じ効果があると想定する根拠にはなりません。
出典・参考資料
- AWS Machine Learning Blog:「Amazon SageMaker AIでマルチターン強化学習を使って検索エージェントをファインチューニング」(2026年10月2日) — ベンダーによる手順、設定、データセットの選択、報告された評価結果。
- Amazon SageMaker AI:マルチターン強化学習 — 現在の対応モデル、リージョン、課金項目。
- 前提条件、エージェントの準備、VPCの設定、保存データの暗号化 — 権限、ランタイムの選択、連携、任意のネットワークと暗号化の設定。
- アセットの作成、学習ジョブの送信、評価、ハイパーパラメーター、クォータ — 現行の実装リファレンス。
- SageMaker AIの料金 — モデルカスタマイズの現行価格。料金は変動し、モデルやリージョンによって異なります。
報告に関する注記:本稿はドキュメントのみを確認しています。BIG CHANGEはAWSアカウントにアクセスしておらず、SageMakerジョブを送信・確認したり、AWS APIを呼び出したり、報告された指標を独自に再現したりしていません。実装ガイドはAWSが作成し、実験結果もAWSが自ら報告しています。