Le grand changement
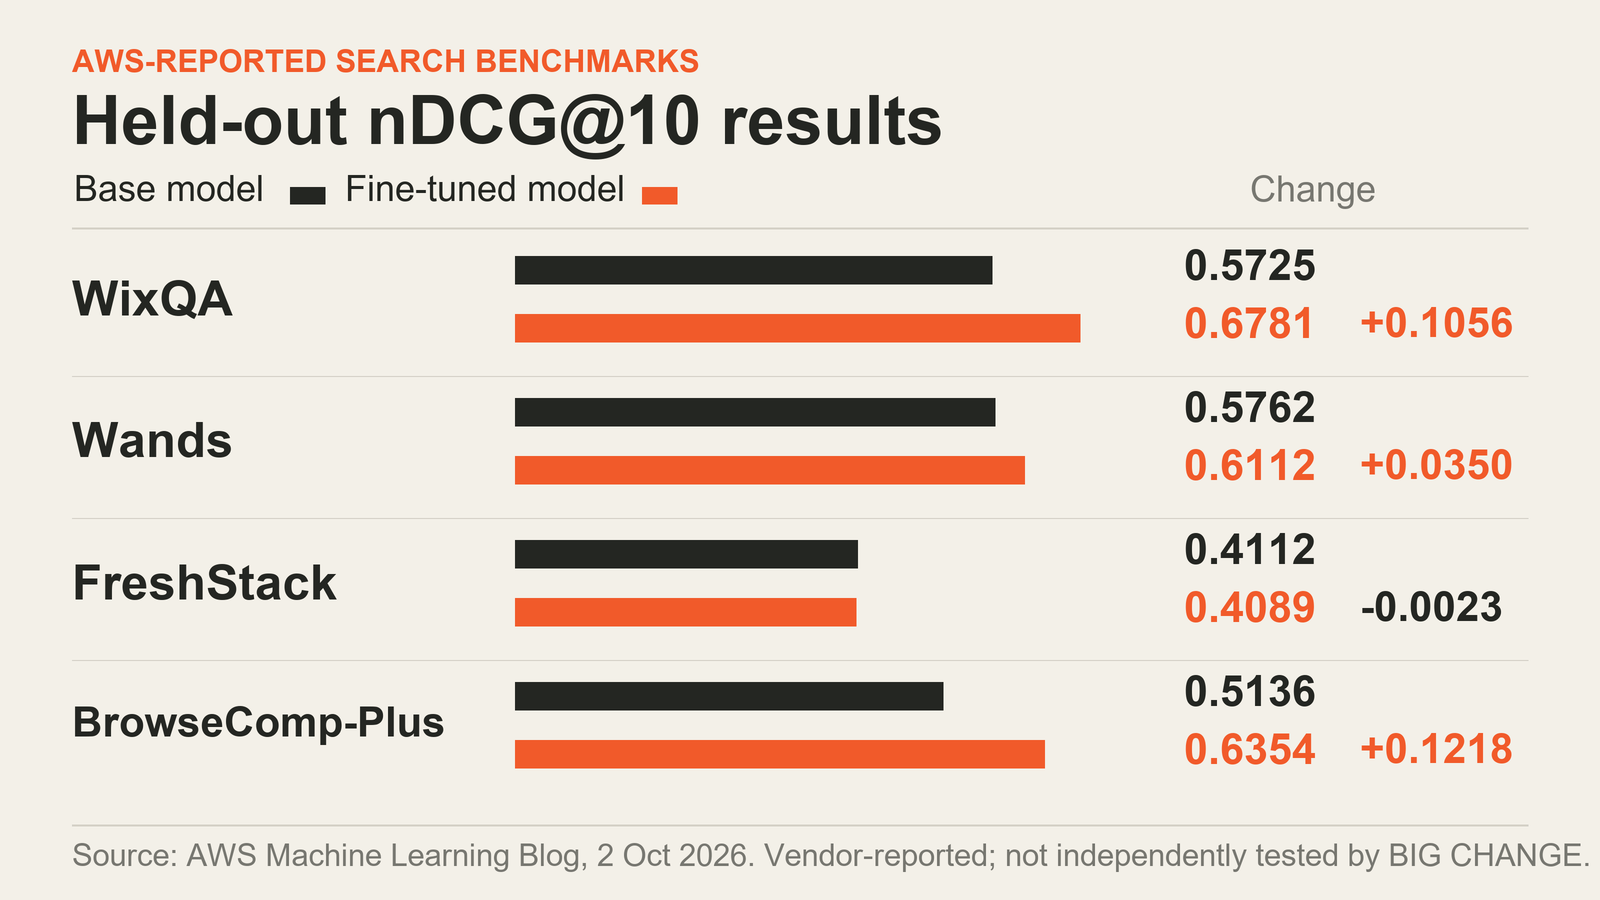
Dans son guide du 2 octobre, AWS décrit l’affinage d’un agent de recherche Qwen3.6-27B au moyen de l’apprentissage par renforcement multi-tours (MTRL) dans SageMaker AI. Le graphique ci-dessus représente les scores nDCG@10 en jeu de test rapportés par AWS : ils ont augmenté sur WixQA, Wands et BrowseComp-Plus, et légèrement baissé sur FreshStack. BIG CHANGE a réalisé ce graphique à partir des chiffres d’AWS ; nous n’avons ni testé l’agent de manière indépendante ni reproduit les résultats. Cette technique entraîne un modèle à partir du résultat d’une séquence de décisions faisant appel à des outils.
Avant de soumettre une tâche, un ingénieur en apprentissage automatique doit vérifier que le modèle et la région sont pris en charge, que l’agent peut participer à la boucle de rollout de SageMaker, que les invites et les récompenses correspondent à la tâche de recherche visée, et qu’un jeu d’évaluation distinct permet de détecter les régressions. Ce guide s’appuie sur la documentation d’AWS ; BIG CHANGE n’a exécuté aucune tâche AWS ni appelé ses API.
Ce que le MTRL change dans la boucle d’entraînement
Avec l’affinage supervisé, l’équipe doit fournir des trajectoires d’exemple illustrant le comportement souhaité. Dans la description du MTRL par AWS, SageMaker envoie plutôt des invites à un agent ; celui-ci appelle le modèle de politique et ses outils au fil de plusieurs tours, puis transmet une récompense une fois le rollout terminé. Le modèle est mis à jour à partir de ce retour. Pour la recherche, une récompense peut évaluer le classement final : les premières décisions de requête sont ainsi optimisées en tenant compte de l’ensemble de l’épisode de recherche.
Cette différence compte lorsque les appels aux outils dépendent des résultats précédents. Si le modèle lance une première requête peu pertinente, obtient de mauvais résultats et doit la reformuler, une récompense attribuée à la fin de la tâche peut tenir compte de la pertinence des documents finalement trouvés par toute la séquence. Cela ne dispense pas de définir ce que signifie « pertinent » ni de créer un agent capable d’appeler les outils de recherche de l’équipe.
Vérifier d’abord les accès, le modèle et la région
L’exemple du 2 octobre a été exécuté dans l’Ouest des États-Unis (Oregon), us-west-2, et a affiné Qwen3.6-27B. Le tableau des modèles pris en charge par SageMaker MTRL, consulté le 4 octobre 2026, répertorie quatre modèles pour six combinaisons modèle-région : Nova Lite 2.0 et GPT-OSS-20B dans l’Est des États-Unis (Virginie du Nord), us-east-1, et dans l’Ouest des États-Unis (Oregon), us-west-2 ; Gemma-4-31B-it et Qwen 3.6 27B sont disponibles uniquement dans l’Oregon. Consultez le tableau à jour dans la région où vous comptez créer la tâche : la présence d’un modèle dans la liste ne prouve pas qu’il est disponible ailleurs.
L’équipe a également besoin d’un compte AWS et, si elle utilise l’interface Studio, d’un domaine SageMaker Studio, d’un accès à S3 pour les jeux de données et les sorties, ainsi que de rôles IAM configurés pour la nouvelle tâche MTRL et les appels d’exécution. Le document des prérequis d’AWS indique que l’appelant doit disposer des autorisations CreateJob et des actions associées, ainsi que du droit de transmettre le rôle d’exécution à job.sagemaker.amazonaws.com. Le rôle d’exécution doit disposer de la politique AmazonSageMakerJobFullAccess et inclure ce principal de service dans sa politique d’approbation. Le rôle d’exécution de l’agent doit disposer de AmazonSageMakerJobRuntimeAccess ; un environnement d’exécution AgentCore nécessite aussi sa propre relation d’approbation. Le sélecteur d’environnement d’exécution de Studio requiert les autorisations permettant de répertorier les environnements AgentCore. Selon AWS, les autorisations SageMaker étendues déjà en place ne couvrent pas à elles seules toutes ces nouvelles actions de tâche.
Deux méthodes d’intégration de l’agent sont documentées. Déployez-le avec Bedrock AgentCore pour un hébergement géré — AWS indique que cette méthode convient particulièrement aux agents conçus avec Strands — ou hébergez un agent personnalisé et reliez-le au service à l’aide d’un relais Lambda. L’agent reçoit les invites de rollout, appelle le modèle de politique via l’environnement d’exécution des tâches SageMaker, utilise ses outils de recherche, termine chaque rollout et transmet une récompense. Le décorateur du SDK d’AWS prend en charge une grande partie de cette intégration ; les frameworks personnalisés peuvent appeler directement les API d’exécution. Si le nom de la fonction Lambda n’est pas standard, AWS indique qu’il peut être nécessaire d’ajouter explicitement son ARN à la politique d’autorisations. Un VPC géré par le client ou une clé KMS ajoute d’autres exigences de configuration.
Préparer les invites et la récompense pour la véritable tâche de recherche
Le guide des ressources SageMaker accepte les formats Parquet, JSON Lines, JSON ou CSV. Il recherche une colonne nommée prompt, et utilise la première colonne si elle est absente ; il transmet ensuite cette valeur telle quelle à l’agent. Le service n’analyse, ne valide et ne transforme pas le contenu des invites. Pour une recherche avec utilisation d’outils, l’invite peut contenir les messages de conversation, les métadonnées de la tâche, une spécification de récompense et la configuration des outils au format attendu par l’agent. AWS précise que les invites sont transmises sans inspection : les équipes doivent donc protéger les données sensibles. Le chiffrement ou une autre protection adaptée doit être prévu pour le stockage et le parcours de l’agent.
La récompense définit l’objectif que le modèle cherchera à optimiser. Dans son exemple, AWS utilise le nDCG@10 des documents récupérés à la fin et attribue une récompense de -1 lorsque l’agent atteint sa limite de tours ou de jetons d’échantillonnage. C’est un point de départ concret pour une tâche de recherche classée, mais les choix d’évaluation ont alors des conséquences importantes : l’équipe doit disposer d’annotations de pertinence fiables ou d’une autre méthode de notation défendable, et vérifier que la récompense ne privilégie pas de modestes gains de classement au détriment de la qualité des réponses, de la latence ou du coût des outils.
L’article de blog indique que le mélange d’entraînement comprenait FRAMES, BRIGHT, Enterprise RAG, ESCI, Musique et MLQA, avec cinq pour cent des instances de chaque jeu réservées à la validation. Le jeu de test indépendant comprenait FreshStack, WixQA, BrowseComp-Plus et Wands. Ces jeux de données publics ou synthétiques ne remplacent pas une évaluation sur le corpus privé et la distribution de requêtes que l’équipe prévoit de traiter.
Soumettre une tâche modeste et inspectable
Le billet AWS du 2 octobre utilise un import du SDK et des noms d’arguments différents dans son extrait de code. La référence actuelle des tâches d’entraînement SageMaker présente la forme d’API suivante pour un environnement d’exécution Bedrock AgentCore. Cet exemple utilise l’identifiant de modèle GPT-OSS-20B actuellement documenté par AWS ; choisissez un modèle disponible dans votre région cible et consultez le tableau à jour des modèles pris en charge avant de l’adapter. L’exemple actuel exige également un ARN d’application MLflow, un ARN de rôle et l’acceptation du contrat de licence (EULA).
from sagemaker.train.multi_turn_rl_trainer import MultiTurnRLTrainer

trainer = MultiTurnRLTrainer(
    model="openai-reasoning-gpt-oss-20b",
    agent_env="arn:aws:bedrock-agentcore:us-west-2:123456789012:runtime/my-agent-runtime",
    training_dataset="s3://my-bucket/prompts/prompts.parquet",
    mlflow_app_arn="arn:aws:sagemaker:us-west-2:123456789012:mlflow-app/mlflow-app-id",
    s3_output_path="s3://my-bucket/output/",
    role="arn:aws:iam::123456789012:role/SageMakerRole",
    accept_eula=True,
)

trainer.hyperparameters.max_epochs = 1
trainer.hyperparameters.global_batch_size = 32
trainer.hyperparameters.max_steps = 12
job = trainer.train(wait=True)
Le billet d’AWS du 2 octobre présente une autre instruction d’importation : sagemaker.modules.train ; les noms des arguments sont model_id, agent_endpoint, training_dataset_s3_uri et output_s3_uri . Comme ces noms diffèrent de ceux du guide actuel des tâches, suivez la référence à jour pour toute nouvelle mise en œuvre et vérifiez la version du SDK ainsi que les exigences du modèle dans votre environnement. Nous n’avons pas établi si l’exemple du billet s’appuie sur une ancienne version du SDK ou révèle une incohérence documentaire. L’interface Studio est une autre méthode de soumission documentée : choisissez un modèle JumpStart pris en charge, sélectionnez l’apprentissage par renforcement multi-tours, configurez l’environnement AgentCore ou le relais Lambda, fournissez les données d’entraînement et soumettez la tâche.
Pour un premier essai, consignez le modèle, la région, la version du jeu de données, la récompense, les limites, les hyperparamètres et le chemin de sortie afin de pouvoir comparer une évaluation ultérieure au même niveau de référence. Si vous utilisez un VPC géré par le client, le guide VPC distinct d’AWS précise qu’il faut des sous-réseaux privés dans deux zones de disponibilité, des points de terminaison VPC pour S3 et CloudWatch Logs, ainsi qu’un point de terminaison AgentCore ou Lambda selon le cas ; MLflow a également besoin d’un point de terminaison lorsqu’il est utilisé. Le rôle d’exécution doit disposer des autorisations de gestion des interfaces réseau élastiques (ENI). La configuration facultative d’une clé KMS gérée par le client exige des autorisations et une configuration de la politique de clé supplémentaires pour l’appelant, le rôle d’exécution et l’environnement d’exécution ; le chiffrement au repos avec une clé gérée par AWS est activé par défaut. Consultez les guides sur le VPC et le chiffrement avant d’utiliser l’une ou l’autre configuration. Avant de soumettre la tâche, vérifiez les quotas du compte : AWS indique par défaut une seule tâche MTRL d’affinage et une seule tâche d’évaluation simultanées ; les deux limites peuvent être modifiées via Service Quotas. Les limites de régulation des API de gestion des tâches ne sont pas modifiables.
Évaluer sur des invites de test indépendantes avant le déploiement
La documentation d’évaluation d’AWS recommande de garder les invites d’évaluation hors de l’entraînement, d’utiliser le même format d’invite, de couvrir les outils importants et leurs combinaisons, d’inclure les cas ayant échoué auparavant et de protéger le contenu sensible. L’évaluateur SageMaker peut exécuter un modèle candidat sur un jeu d’invites et communiquer la récompense, le pass@k et des métriques de trajectoire. La documentation montre comment évaluer un modèle affiné et, en option, évaluer le modèle de base dans le même pipeline de comparaison.
Définissez le protocole d’évaluation avant l’entraînement. Conservez un jeu fixe et indépendant, représentatif des requêtes, des autorisations et des évolutions documentaires auxquelles l’agent sera confronté en production. Comparez les modèles de base et affiné avec les mêmes outils, limites et code de notation. Examinez non seulement le score moyen de recherche, mais aussi les échecs des tâches, le nombre de tours, la latence, l’utilisation de jetons et les cas où des documents pertinents disparaissent des premiers résultats. La documentation explique comment soumettre une tâche d’évaluation AWS ; elle ne démontre pas qu’une seule métrique suffit à mesurer la qualité d’une recherche en production.
L’article d’AWS rapporte les résultats suivants sur le jeu de test indépendant :
Jeu de données (questions) | nDCG@10 de base | nDCG@10 après affinage | Taux d’échec de base | Taux d’échec après affinage |
|---|---|---|---|---|
WixQA (400) | 0,5725 | 0,6781 | 0,67 % | 0,17 % |
Wands (147) | 0,5762 | 0,6112 | 0,00 % | 0,00 % |
FreshStack (672) | 0,4112 | 0,4089 | 0,20 % | 0,05 % |
BrowseComp-Plus (830) | 0,5136 | 0,6354 | 22,89 % | 0,68 % |
Le tableau montre une hausse du nDCG@10 sur trois jeux de données et une légère baisse sur FreshStack. AWS attribue la diminution du taux d’échec sur BrowseComp-Plus à la pénalité appliquée lorsque l’agent atteint ses limites de tours ou de jetons. L’article de blog ne fournit ni intervalles de confiance ni analyse de significativité statistique pour ces chiffres. Il indique également que le modèle affiné a effectué en moyenne 4,5 tours contre 4,3 sur WixQA, et 2,9 contre 2,2 sur Wands : le nombre de tours n’a donc pas toujours diminué. Il s’agit d’une expérience rapportée par le fournisseur, et non d’une validation indépendante ni d’une preuve qu’un autre corpus obtiendra de meilleurs résultats.
Budgéter l’ensemble de l’essai
La documentation MTRL d’AWS décrit trois composantes de facturation pour l’entraînement : les jetons de préremplissage traités en entrée, les jetons échantillonnés générés pendant les rollouts et les mises à jour de l’entraînement. La page tarifaire indique les prix propres à chaque modèle ; ces tarifs et le volume de rollouts, la longueur des séquences, le nombre d’époques et l’environnement d’exécution déterminent l’estimation. L’article d’exemple ne publie pas le coût total de son essai, et la documentation ne fournit pas de tarif universel. Vérifiez le tarif en vigueur pour le modèle et la région choisis, puis estimez le coût à partir de l’utilisation prévue de la tâche au lieu de supposer un prix fixe.
Intégrez aussi les coûts associés à l’estimation : stockage et requêtes S3 pour les données d’entraînement et de validation, les checkpoints et les artefacts de sortie ; environnement d’exécution AgentCore ou Lambda et infrastructure de recherche utilisée pendant les rollouts ; journalisation et MLflow ; évaluation indépendante ; ainsi que tout point de terminaison ou déploiement Bedrock utilisé après l’entraînement. Dans son article, AWS recommande expressément d’arrêter ou de supprimer les tâches MTRL en cours, de supprimer les artefacts de modèle S3 inutiles et de retirer les points de terminaison d’évaluation afin d’éviter des frais récurrents. Le déploiement d’un point de terminaison constitue une décision et un poste de dépense distincts de l’entraînement.
Décider s’il faut poursuivre
Ce processus est surtout pertinent lorsque la tâche de recherche nécessite plusieurs appels d’outils dépendants et que l’équipe peut noter le résultat final. Un essai n’apporte des éléments utiles à la décision que si le couple modèle-région est pris en charge, l’intégration de l’agent fonctionne, les données d’invite sont représentatives, la récompense reflète la tâche, une comparaison indépendante est prévue et l’estimation inclut les services associés. Un résultat solide sur les quatre benchmarks d’AWS justifie d’examiner la méthode, mais pas de supposer qu’elle produira le même effet sur un autre index, un autre ensemble de requêtes ou d’autres règles d’autorisation.
Sources et lectures complémentaires
- Blog AWS Machine Learning : « Fine-tune a search agent with multi-turn RL on Amazon SageMaker AI » (2 octobre 2026) — le guide pratique du fournisseur, la configuration, les choix de jeux de données et les résultats d’évaluation rapportés.
- Amazon SageMaker AI : apprentissage par renforcement multi-tours — modèles, régions et composantes de facturation actuellement pris en charge.
- Prérequis, Préparer votre agent, Configuration du VPC et chiffrement au repos — autorisations, choix de l’environnement d’exécution, intégration et configuration réseau ou de chiffrement facultative.
- Créer des ressources, soumettre une tâche d’entraînement, évaluation, hyperparamètres et quotas — références actuelles de mise en œuvre.
- Tarification de SageMaker AI — détails tarifaires actuels pour l’adaptation des modèles ; les tarifs peuvent évoluer et varient selon le modèle et la région.
Note méthodologique : examen de la documentation uniquement. BIG CHANGE n’a accédé à aucun compte AWS, n’a ni soumis ni inspecté de tâche SageMaker, n’a appelé aucune API AWS et n’a pas reproduit indépendamment les métriques rapportées. AWS est l’auteur du guide de mise en œuvre et rapporte sa propre expérience.